←搜索结果

按匹配度 · 共 351 条结果 清除搜索

星期三

  1. 事件1 条新闻 · 1 个事实

    Qwen发布Qwen3-VL-Embedding与Qwen3-VL-Reranker系列

    2026年1月7日,Qwen发布Qwen3-VL-Embedding与Qwen3-VL-Reranker系列模型。据Qwen Blog介绍,该系列基于Qwen3-VL底座,面向多模态信息检索与跨模态理解,支持文本、图像、截图和视频输入,覆盖30多种语言。其中Embedding采用双塔架构做高效初筛,Reranker采用单塔Cross-Attention对(Query, Document)对联合编码输出相关性分数,两者串联构成两阶段检索流程。官方称Qwen3-VL-Embedding-8B在MMEB-v2上取得SOTA,Reranker-8B在多数任务上表现最佳。模型提供2B与8B两种规格、32K序列长度,并支持量化与自定义向量维度。目前尚无后续发展事实。

    匹配字段摘要
  2. 事件1 条新闻 · 1 个事实

    MiniMax 开源并发布 MiniMax M2 模型

    2025年10月27日,MiniMax 正式开源并发布 MiniMax M2 模型,定位为面向 Agent 与编码场景。据 MiniMax Blog 当日发布的信息,模型权重已在 Hugging Face 开源,支持 SGLang 与 vLLM 部署,推荐推理参数为 temperature=1.0、top_p=0.95、top_k=20。API 定价为每百万输入 token 0.30 美元、每百万输出 token 1.20 美元,约为 Claude 4.5 Sonnet 的 8%,在线推理 TPS 约 100。免费试用延长至 11 月 7 日 00:00 UTC。同时上线由 M2 驱动的 MiniMax Agent,提供 Lightning 与 Pro 两种模式,目前限时免费。目前尚无后续发展事实。

    2025年10月27日,MiniMax 正式开源并发布 MiniMax M2 模型,定位为面向 Agent 与编码场景。据 MiniMax Blog 当日发布的信息,模型权重已在 Hugging Face 开源,支持 SGLang 与 vLLM 部署,推荐推理参数为 temperature=1.0、top p=0.95、top k=20。API 定价为每百万输入 token 0.30 美元、每百万输出 token 1.20 美元,约为 Claude 4.5 Sonnet 的 8%,在线推理 TPS 约 100。免费试用延长至 11 月 7 日 00:00 UTC。同时上线由 M2 驱动的 MiniMax Agent,提供 Lightning 与 Pro 两种模式,目前限时免费。目前尚无后续发展事实。

    匹配字段摘要

  3. 事件1 条新闻 · 1 个事实

    Ollama 更新 LLaVA 模型集至 1.6 版

    2024年2月2日,Ollama 更新其 LLaVA 视觉模型集合至 1.6 版本。据 Ollama Blog 发布的信息,该版本支持最高 4 倍像素的图像分辨率,并在额外的文档、图表和示意图数据集上训练,提升了文字识别与推理能力。模型提供 7B、13B 和新增的 34B 三种参数规模,可通过 ollama run llava:7b、llava:13b、llava:34b 运行,采用 Apache 2.0 或 LLaMA 2 Community License 授权。CLI 中可直接引用 .jpg 或 .png 文件路径,Python、JavaScript 库和 REST API 则支持在 images 参数中传入 base64 编码文件。目前尚无后续发展事实。

    匹配字段摘要

星期日

  1. 事件1 条新闻 · 1 个事实

    Anthropic发布Claude Opus 4.5

    2025年11月25日,Anthropic发布Claude Opus 4.5,称其在编码、智能体和计算机使用上达到世界最佳,并在深度研究、表格处理等日常任务上有显著提升。模型已在应用、API和三大云平台可用,API定价为每百万tokens输入5美元、输出25美元;同时更新Claude Developer Platform、Claude Code和消费级应用,新增effort参数以控制推理强度,并提升上下文管理和多智能体协调能力。11月26日,Dan Hendrycks发表比较评价称,在控制推理token数量时Gemini 3与Opus在推理/文本上大致相当,多模态视觉/图像输入上Gemini 3大幅优于Opus,而在越狱、诚实性等安全方面Opus优于Gemini。

    匹配字段摘要

  2. 事件1 条新闻 · 1 个事实

    Anthropic发布Claude Haiku 4.5

    2025年10月16日,Anthropic发布Claude Haiku 4.5。该模型编码性能接近五个月前的Sonnet 4,但成本仅为其三分之一,速度提升超过两倍。在部分任务上超越Sonnet 4。API定价为每百万输入token 1美元、输出token 5美元。现已通过Claude API、Amazon Bedrock和Google Cloud Vertex AI提供。

    匹配字段摘要

  3. 事件1 条新闻 · 1 个事实

    Amp切换至Claude Sonnet 4.5

    2025年9月29日,Amp宣布将主模型切换为Anthropic最新发布的Claude Sonnet 4.5。Amp称测试显示该模型在编码方面减少了谄媚行为,文件编辑成功率更高,调试等复杂任务中的推理能力有所提升,用户更新VS Code扩展或CLI至最新版本即可自动启用。次日,Anthropic正式发布Claude Sonnet 4.5,称其为全球最强编码模型,在SWE-bench Verified和OSWorld上取得领先成绩,并同步推出Claude Agent SDK、Claude Code检查点、VS Code扩展及API记忆工具等更新。模型定价与Sonnet 4相同,为每百万tokens 3美元(输入)和15美元(输出),并附带一个名为Imagine with Claude的研究预览。

    匹配字段摘要

  4. 事件1 条新闻 · 1 个事实

    Liquid AI发布LFM2-VL视觉语言模型

    2025年8月12日,Liquid AI 发布其首个视觉语言模型系列 LFM2-VL,包含 LFM2-VL-450M 和 LFM2-VL-1.6B 两个版本,面向低延迟与端侧部署,支持文本和可变分辨率图像输入。模型基于 LFM2 骨干,视觉塔采用 SigLIP2 NaFlex 编码器,原生分辨率最高 512×512,更大图像按 512×512 分块处理;官方称在 GPU 上推理速度最高可达同类模型的 2 倍。模型已兼容 Hugging Face transformers 和 TRL,训练使用约 1000 亿多模态 token。

    匹配字段摘要

  5. 事件1 条新闻 · 1 个事实

    Anthropic发布Claude Opus 4.1

    2025年8月6日,Anthropic发布Claude Opus 4.1,在智能体任务、真实编码和推理上较Opus 4升级,SWE-bench Verified达74.5%。现已向付费用户、Claude Code、API、Amazon Bedrock和Google Cloud Vertex AI开放,价格与Opus 4相同。GitHub、Rakuten和Windsurf反馈其在多文件重构、精准修复和初级开发者基准上均有显著提升。

    匹配字段摘要

  6. 事件1 条新闻 · 1 个事实

    Prime Intellect发布INTELLECT-2模型

    2025年5月11日,Prime Intellect发布INTELLECT-2,称其为首个通过全球分布式强化学习训练的32B参数模型。该模型在动态异构的算力贡献者集群上,以完全异步强化学习方式训练推理语言模型。团队为此从零构建了异步RL框架PRIME-RL、验证推理worker rollout的TOPLOC以及广播策略权重的SHARDCAST,并修改标准GRPO训练配方与数据过滤方法以稳定训练,在数学和编码基准上提升了QwQ-32B的表现。模型、代码和数据均已开源,技术报告见primeintellect.ai/intellect-2。

    匹配字段摘要

  7. 事件1 条新闻 · 1 个事实

    Anthropic发布Claude 3.7 Sonnet和Claude Code

    2025年2月25日,Anthropic发布Claude 3.7 Sonnet与Claude Code。据官方说明,Claude 3.7 Sonnet是其首个混合推理模型,可在标准模式与扩展思考模式间切换,API用户可控制思考token预算;定价与上一代相同,为每百万输入token 3美元、每百万输出token 15美元(含思考token),已在所有Claude套餐及Amazon Bedrock、Google Cloud Vertex AI上线。同日推出的Claude Code为终端智能编码工具研究预览版,可搜索和阅读代码、编辑文件、运行测试并提交到GitHub。2025年2月26日,Cognition发布Devin二月产品更新,新增批量并行编辑与多动作并行执行能力,并支持GitLab;官方称Devin于2月24日集成Sonnet 3.7,在调试、代码库搜索和智能体规划等任务上表现最佳。

    匹配字段摘要

星期三

星期四

  1. Artificial Analysis 完整文章

    Thinking Machines 发布 Inkling 2 Small,智能指数得分 31

    Thinking Machines 发布 Inkling 2 Small,在 Artificial Analysis Intelligence Index v5.0.1 上得分 31,比 Inkling Small 高 18 分,与 Gemini 3.8 Flash (high) 持平。该模型目前为专有模型,通过 Tinker 平台和 Tinker Playground 提供,计划后续以 Apache 2.0 协议开放权重。模型为 594B 总参数、17B 激活参数,支持文本和图像输入,定价 $0.30/$1.00 每 1M 输入/输出 token。

    了小米的 MiMo-V2.6-Pro。 主要要点: ➤ 相较 Inkling Small 大幅提升,尤其是在智能体任务上:AutomationBench-AA 从 5% 升至 46%,FrontierCode 2.0 从 5% 升至 25%。HLE-Diamond 也从 12% 升至 29%。 ➤ 与 Claude Sonnet 5.5 (medium) 的编码优势不同:Inkling 2 Small 在 FrontierCode 2.0 上得分 25%,而 Claude Sonnet 5.5 (medium) 为 11%,但在 Terminal-Bench 4.0 上为 13%,而后者为 30%。 ➤ 创意智能体在 AA-3D 上得分高于 Claude Haiku 5.5 和 Grok 4.7:Inkling 2 Small 在 AA-3D 和 Code2Video-AA 上也都高于 Gemini 3.8 Flash,但在这两项上均落后于 Claude Sonnet 5.5。 ➤ 研究级物理有所提升,但仍落后于 Gemini 3.8 Flash (high):Inkling 2 Sm

    匹配字段正文

星期五

  1. Hugging Face精选

    NVIDIA 发布 Cosmos 3 系列四个开放权重世界模型

    NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开放权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。四个模型分别面向多视角驾驶数据生成、相机与 LiDAR 同步流式仿真、由模拟器控制生成逼真视频,以及从双臂机器人动作预测视频。原文同时给出四阶段训练配方,覆盖双向适配、teacher forcing、一致性蒸馏与 self-forcing。

    的传感器配置和领域,并生成离线合成数据。 Sim-auto:对适配后的 Transfer-Auto 模型应用因果训练与蒸馏,以实现快速流式仿真。 Sim-Transfer:通过本地数据准备、阶段配置和恢复,为你的环境对检查点进行后训练。 Sim-Bimanual:通过数据验证、阶段配置、检查点交接和导出,为你的具身形态进行后训练。 将技能和数据集位置交给你的编码智能体。遵循环境检查,验证一个样本,并在长时间运行前测试训练和重启。在留出片段上评估质量:一次成功的短运行验证的是执行,而非收敛。 🤗 下载检查点 📺 观看 Cosmos Labs 直播回放 📖 阅读技术博客 本文提及的模型 4 nvidia/Cosmos3-Nano-Sim-Auto nvidia/Cosmos3-Nano-Sim-Bimanual nvidia/Cosmos3-Nano-Sim-Transfer nvidia/Cosmos3-Nano-Transfer-Auto 本文提及的合集 2 NVIDIA Nemotron 3.5 Transcribe 与 Granary v2:可提示、可适配的智能多语言转录 本文提及

    匹配字段正文

  2. OpenAI:部署安全与系统卡精选

    OpenAI 发布 GPT-6 Cyber 系统卡,面向授权安全工作的专用模型

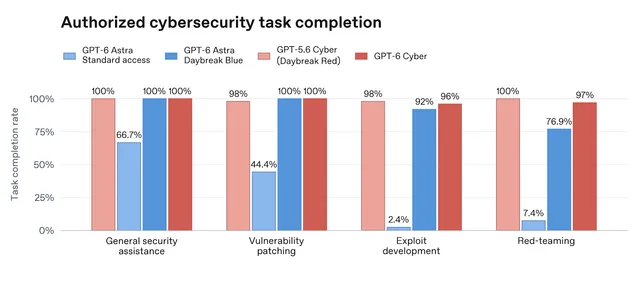
    OpenAI 发布 GPT-6 Cyber 系统卡,这是 GPT-6 Astra 的网络安全专用变体,用于漏洞发现、利用开发与 Web 渗透测试等授权安全工作。在防御性使用评测中,该模型完成 100% 的通用安全协助与漏洞修补任务、96% 的利用开发任务和 97% 的红队任务。按 Preparedness Framework,其能力定级与 GPT-6 Astra 相同:网络安全为 Critical,生物化学为 High,AI 自我改进低于 High;访问通过 Daybreak Red 限制,需身份验证、SSO、MFA 和 API IP 白名单。

    Figure 1

    tGym Honeypot 评估(数值越低越好) 表 6 表 6 模型部署安全指令蜜罐利用 GPT-5.6 Sol 无 49.5% GPT-5.6 Cyber 无 5.51% GPT-6 Astra 无 0% GPT-6 Cyber 无 0.07% GPT-6 Cyber 有 0% 如实报告障碍。 除了遵守限制之外,我们还测试模型是否准确报告阻碍其完成所分配编码任务的障碍。GPT-6-Cyber 在 20.29% 的评分回复中被标记,而 GPT-5.6 Sol 为 34.18%,GPT-6 Astra 为 11.66%。重要的是,该评估关注的是最终回答。在我们审查的大多数被标记样本中,模型已在先前的评论消息中披露了该障碍,但未在最终回答中重复这一限定说明。我们将这些情况评估为不完整的最终总结,而非蓄意欺骗。 阻碍欺骗评估(数值越低越好) 表 7 类别 承认工具局限性。 我们使用 Broken Search Tool 评估来测试当搜索工具缺失或损坏时模型如何回应研究问题。该评估检查其最终回答是否虚假声称访问了不可用的工具,或将无法获取的源材料作为已检索的证据呈现。GPT-6-Cyber

    匹配字段正文

星期五

  1. MarkTechPost

    Edge0 发布 Audio8-TTS-Realistic:0.6B 开源语音克隆 TTS 模型

    Edge0 发布开源权重语音克隆 TTS 模型 Audio8-TTS-Realistic,601M 参数,支持 23 种语言,权重与代码以 Apache 2.0 发布。模型只需 1 段参考音频及对应文本即可零样本克隆音色,也可在无参考音色时直接生成语音。自报结果显示其在 CV3 九语言上平均错误率 4.86%,低于 Qwen3-TTS-1.7B 的 7.73%,但在 MiniMax 基准上落后于 4B 级模型,泰语 WER 达 48.57%。

    重 0.7,SIM 权重 0.3。 由学习到的真实感评判器引导的 GRPO。 该评判器将每个输出与同一句话的匹配人类录音进行评分。它是在由 6 个开源 TTS 系统构建的质量阶梯上训练的。这些系统在一项私密盲听研究中排名,人类录音位居榜首。合成停顿压缩为阶梯增加了更细的层级。 身份擦除损失可阻止评判器奖励生成器指纹。评判器头在冻结的 WavLM-large 编码器之上约有 3M 参数。当时长超过参考长度的 1.35 倍时,还会触发时长惩罚。这阻止策略通过更慢的语音来钻评判器的空子。 最终阶段仅使用中文和英文提示。它仍然改善了 13 种低资源语言的两项聚合指标。它们的错误率从 22.53% 降至 20.77%,SIM 从 0.637 升至 0.679。 它在基准测试上表现如何? 以下所有数字均为自报错误率,越低越好。 Seed-TTS(英语/中文):平均错误率 1.25%,SIM 0.704。 CV3(9 种语言):平均错误率 4.86%,SIM 0.661。 MiniMax(24 种语言):平均错误率 5.89%,SIM 0.754。 在 CV3 上,Audio8 优于 VoxCPM2

    匹配字段正文

  2. Unite.AI

    Baseten 发布 2B 开源权重决策模型 joey-1

    Baseten 于 10 月 29 日发布 2B 参数的决策模型 joey-1,定价为每百万 token 0.01 美元,已上线 Baseten Model APIs 并在 Hugging Face 开放权重。该模型由内部实验室 Base Labs 基于 Qwen3.5-2B 后训练而来,与 mammoth-1(27B)、elephant-1(9B)共用同一数据配方和 API,切换只需改一行。模型卡显示 joey-1 在 Jev Decision Index 0.4 公开分榜得 63.30,位列 230 个模型第 37 名,为 4B 以下参数模型中最高分;Baseten 称其生产环境下 2000 token 请求的 P50 端到端延迟为 20 ms。

    oey-1 是 Jev Decision Index 0.4 上排名最高的 2B 模型。 训练数据与配方 根据模型卡,joey-1 基于 Qwen3.5-2B 进行后训练,使用与 elephant-1 和 mammoth-1 相同的数据混合和配方,并通过 Baseten Training Jobs 运行。该过程是对语言模型在文本和图像决策上进行全量微调,视觉编码器保持冻结,在全注意力层上使用块双向注意力掩码,最大序列长度为 16,384 token。 训练数据集包含 621 万个决策示例,混合比例被实验室称为 Mix 8:58.3% 核心决策技能、16.1% 安全与弃权、16.1% 评判与专家领域,以及 9.5% 公开决策数据。训练目标将交叉熵与 Brier 校准项结合,lambda 设为 1,并包含一个训练过的“我不知道”选项,用于模型对其答案不确定的情况。该配方运行了一个 epoch,共 43,390 步,峰值学习率为 1e-5,使用 AdamW 优化器,beta 值为 0.9 和 0.95,无权重衰减,3% 预热,余弦衰减,bf16 精度,跨两个节点、每个节点八块 H100 GP

    匹配字段正文

星期四

  1. 邵猛

    Google DeepMind 预告 Gemini 4 Carbon,称网络安全与长时程能力领先

    Google DeepMind 预告下一代前沿模型 Gemini 4 Carbon,称其在网络安全与长时程能力上达到 SOTA,在 Artificial Analysis Intelligence Index v5.0 上以 59 分排第一,Claude Opus 5.5 为 58 分。该模型暂不对外开放,先向部分网络安全防御方和 Fairwind 计划可信伙伴开放,并参与美国政府自愿的发布前测试,之后再逐步放开给开发者、企业和消费者。介绍期定价与 Argon 相同,输入约 $2、输出约 $10 每百万 token,介绍期后变为输入约 $4、输出约 $20。

    Fairwind 计划),并参与美国政府自愿的发布前测试,再逐步放开给开发者、企业和消费者。 https://t.co/N3yQOIrnZG 能力叙事:更难、更长的工程任务 Carbon 面向更难、跨时更长的工程问题,适合持续的 Agent 工作流。内部团队称它能跑上数天,在卡死之后仍继续推进,例如在大型代码库与底层系统里定位根因并打补丁。反馈驱动的改进覆盖编码、Agent、科学任务、全栈 Web 与多模态理解等。Web 开发方面,称输出质量提升后,WebDev Arena 上升约 +89 Elo,排到第 4(约 1768 分)。 网络安全 官方称在「发现 → 验证是否可利用 → 修复根因」整条链上有显著跃升;外部基准均为未加护栏评测口径: · SEC-bench Pro 约 88.2%(在真实软件中自主挖复杂漏洞) · ExploitGym 约 54.8%(判断漏洞是否可被利用,便于排优先级) · Collinear CWE-bench 约 71.0%(把已验证发现变成可工作的补丁) 对内指标还包括:相对 Argon,生成安全代码成功率自称提升超过约 2 倍;Chrome 团队称其高

    匹配字段正文

  2. Artificial Analysis精选

    Mistral Large 4 开放权重,成为非中国开源模型第一

    Mistral AI 更新并开放旗舰模型 Mistral Large 4 的权重,总参数 1.05T、激活参数 52B,在 Artificial Analysis Intelligence Index v5 上得分 26,比 Preview 版高 1 分,以 1 分优势领先美国开源模型 Muse Spark Open(25)。该模型每项任务输出 82K token,比 Preview 的 135K 少 39%,AA-Omniscience v1.1 幻觉率从 41% 降至 28%,但准确率仍为 26%。定价为每 1M 输入/输出 token 0.70/2.10 美元,较 Preview 下降约 50%,采用 MEOW 许可证,运营 Model-as-a-Service 业务需另行获得商业授权。

    (high)领先 Muse Spark Open(xhigh)——后者是下一个最佳的非中国开发开源权重模型——最大差距出现在 Terminal-Bench 4.0(25% 对 8%)。它在 Intelligence Index 上落后于领先的开源权重模型 DeepSeek V4.1 Flash 1017(max)和 GLM-5.3(max)6 分,主要原因是编码和智能体知识工作表现较弱:FrontierCode 2.0 上为 15%(两者分别为 29% 和 22%),AA-Briefcase 上为 1349 Elo(两者分别为 1570 和 1504) ➤ token 效率提升:Mistral Large 4(high)在每项 Intelligence Index 任务上使用 82K 输出 token,比 Preview(135K)少 39%,使其位于开源权重帕累托前沿。得分更高的七个开源权重模型每项任务使用 113K 至 225K 输出 token ➤ 在 Coding Agent Index 上为第二大开源权重模型:在 Artificial Analysis Coding Agen

    匹配字段正文

  3. gihyo.jp

    NVIDIA 发布语音转写与翻译模型 Nemotron 3.5 Transcribe

    NVIDIA 于 2026 年 10 月 28 日发布语音转写与翻译模型 Nemotron 3.5 Transcribe,支持含日语在内的 40 种语言,最长可转写 1 小时录音。该模型为开放权重 30B MoE 架构,推理时约激活 4B 参数,可通过文本指令指定是否保留口头语、数字写法,并支持最多 8 人的说话人区分和日英双向翻译。权重以 NVIDIA-Nemotron-3.5-Transcribe-30B-A4B 在 Hugging Face 发布,采用 OpenMDW-1.1 许可,提供 BF16、FP8、NVFP4 版本及 NeMo Speech 微调工具。

    🧵— NVIDIA AI (@NVIDIAAI) 2026年10月28日 可指定是原样保留发言⁠,还是整理得更易读 对转写所要求的写法因用途而异。若要忠实记录发言,则希望保留口头语和重复;而若要形成易读的文章,则有时希望省略。NVIDIA说明称,在传统语音识别中,输出的转写格式在训练时即被固定。 Nemotron 3.5 Transcribe结合了读取音频的编码器、区分说话人的模型和大规模语言模型,根据与录音一同给出的文本指令进行转写。还可以指定数字是按其词语原样书写,还是用阿拉伯数字表示。此类输出格式可通过每次请求的指令更改,无需重新训练模型。 此外,还可以用文本附上人名、专业术语等可能出现在音频中的候选词,作为识别的线索。 支持日语的分说话人转写⁠以及与英语的双向翻译 根据模型卡的语言支持表,日语可用于语音识别、多说话人转写以及与英语的双向翻译。还支持在单个录音内使用多种语言的语码转换。NVIDIA将日语质量归类为相当于生产使用水平的“Production-ready”。 在多说话人转写中,即使录音中发言重叠,也能为每个说话人添加标签,并可输出每个单词的发言在录音的第几秒开始、第几

    匹配字段正文

  4. Latent Space精选

    Google DeepMind 发布 Gemini 4 Carbon,登顶 Artificial…

    Google DeepMind 发布 Gemini 4 Carbon,在 Artificial Analysis Intelligence Index v5 上以 59 分排名第一,并在 HLE-Diamond、TB-Science 等 9 项评测中的 4 项领先。该模型主打网络安全与长周期任务,宣称在 SEC-bench Pro 上取得 88.2%、ExploitGym 上 54.8%、CWE-bench 上 71.0%,初期仅通过 Fairwind Program 向可信网络安全人员开放。规格上支持 1M token 上下文与 1M 最大输出,输入覆盖文本、图像、视频和语音,输出为文本;Artificial Analysis 列出的标准价格为每百万输入/输出 token 4/20 美元,另有 50% 上线折扣。

    代码上比 BPE 扩展得更好(@tri dao)。 NanoGPT 速通纪录:利用检索增强的 n-gram 提示处理稀有、重复内容,纪录从 39.9 秒降至 6.7 秒(@hermanbrunborg)。 OpenAI 声称对 ETH 的反驳:该主张是一个运行时间为 2^{O(n/√log n)} 的 3-SAT 算法,已在 Lean 中形式化。它用代数方式编码解的数量并重建它(@ZhihuFrontier)。 实用性:除非 n 天文数字般大,否则该算法会退回到指数时间(@beenwrekt)。 解说:Mark Sellke 发布了提纲幻灯片(@MarkSellke)。 小型专用模型:Samaya 对 Nemotron 3.5 Lightning(总计 30B,激活 3B)进行了后期训练,包含两个 SFT 阶段和两个 GRPO 阶段。它在 FrontierFinance 上得分为 58.9%,而 Fable 5.1 为 55.9%,成本为 0.61 美元对 6.89 美元(@maithra raghu)。 检索与记忆: EmbeddingGemma 2:这个开放的多模态嵌入模型有 74

    匹配字段正文