Robbyant 蚂蚁灵波模型发布
AI 评分67蚂蚁灵波 4 天发布 6 款 LingBot 2.0 模型
#产品更新#具身智能#多模态
#产品更新#具身智能#多模态
Cognition 发布 SWE-1.7,称其在更低成本下达到前沿级智能,并已在 Devin(Web、Desktop、CLI)中通过 Cerebras 以 1000 TPS 提供。该模型基于 Kimi K2.7 训练,Cognition 表示其额外训练收益挑战了后训练天花板的说法。文章还介绍了熵保持与训练稳定、跨三大洲多集群训练、数据质量筛选以及自压缩等训练方法。
#模型发布#编码#Agent
Mistral AI 发布 Robostral Navigate,这是其首个面向具身导航的 8B 模型,仅用单个普通 RGB 相机和自然语言指令即可让机器人自主导航,在 R2R-CE validation unseen 上达到 76.6% 成功率,比最佳单相机方案高 9.7 个百分点,比使用深度或多相机的最佳系统高 4.5 个百分点。模型完全自研、不依赖现有开源 VLM,训练数据全部来自仿真,约 240 万条轨迹覆盖 35 万个场景,并采用基于 prefix-caching 的训练算法将训练 token 减少 22 倍。在监督训练后,模型通过 CISPO 在线强化学习进一步提升,成功率提高 3.2%。

#模型发布#具身智能#端侧
Anthropic 发布 Claude Sonnet 5,称其为迄今最具智能体能力的 Sonnet 模型,在推理、工具使用、编码和知识工作方面较 Sonnet 4.6 有显著提升,性能接近 Opus 4.8 但价格更低。该模型现已在所有套餐中可用,定价为每百万输入 token 2 美元、每百万输出 token 10 美元,开发者可通过 Claude API 使用 claude-sonnet-5。
#模型发布#Agent#编码
Google 发布 TabFM,一个面向表格数据分类与回归的零样本基础模型,将表格预测重构为上下文学习问题,无需手动训练、超参数调优和复杂特征工程,单次前向传播即可对未见过的表格生成预测。模型完全基于数亿个由结构因果模型生成的合成数据集训练,采用融合 TabPFN 与 TabICL 的混合架构。TabFM 已在 Hugging Face 和 GitHub 开源,并上线 Google Cloud BigQuery;在 TabArena 的 38 个分类和 13 个回归数据集上评测。
#模型发布#数据/训练#Google
Google DeepMind 发布 Nano Banana 2 Lite(gemini-3.1-flash-lite-image)和 Gemini Omni Flash(gemini-omni-flash-preview)两款模型。Nano Banana 2 Lite 主打速度与成本,官方建议用它替换第一版 Nano Banana(gemini-2.5-flash-image),并将登陆 Search 的 AI Mode、Gemini app、NotebookLM、Google Photos 等消费端产品。Gemini Omni Flash 通过 Gemini API 和 Google AI Studio 开放,支持文本、图像、视频输入的高质量视频生成与对话式编辑,定价为每秒视频输出 $0.10,与 Veo 3.1 Fast 相同。
#模型发布#多模态#视频
Liquid AI 发布目前最小的模型 LFM2.5-230M,基于 LFM2 架构,预训练 19T tokens 并含 32K 上下文扩展阶段,Base 与后训练版本已在 Hugging Face 开放。官方称其在 Galaxy S25 Ultra 上解码速度 213 tok/s、Raspberry Pi 5 上 42 tok/s,并在 GPQA Diamond、MMLU-Pro、IFEval、BFCLv3/v4 等十项基准上与参数量两倍以上的模型竞争。该模型已适配 llama.cpp、MLX、vLLM、SGLang 和 ONNX,官方同时提示不适合高级数学、代码生成和创意写作等重推理任务。
#模型发布#端侧#开源生态
Mistral 发布 OCR 4,在提取文本之外返回边界框、块类型分类和逐页逐词置信度分数,支持 170 种语言、10 个语系,可运行在单个容器中实现完全自托管。官方称独立标注者在对比测试中平均 72% 的情况下更偏好 OCR 4,其在 OlmOCRBench 上取得 85.20 分,OmniDocBench 为 93.07 分,但官方也指出这两个基准在评分方式上存在已知局限。API 定价为每 1000 页 4 美元,Batch API 五折后为 2 美元,Document AI 为每 1000 页 5 美元,已通过 Mistral Studio、Amazon SageMaker、Microsoft Foundry 提供。
#产品更新#多模态#RAG
Qwen 团队发布 Qwen-AgentWorld,一个原生语言世界模型,在单一模型中模拟 MCP、Search、Terminal、SWE、Web、OS、Android 七个智能体交互域,训练流程为 CPT → SFT → RL,使用超过 10M 条真实环境交互轨迹。团队同时发布七域评测基准 AgentWorldBench,Qwen-AgentWorld-397B-A17B 在该基准上取得最高综合分 58.71,超过 GPT-5.4 的 58.25。已开源 Qwen-AgentWorld-35B-A3B(MoE,35B 总参数 / 3B 激活参数,256K 上下文窗口),可在 Hugging Face 和 ModelScope 获取,并给出 SGLang 与 vLLM 部署命令。
#模型发布#Agent#数据/训练
Sakana AI 发布 Sakana Fugu,把多智能体编排系统做成一个基础模型,通过单一 OpenAI 兼容 API 调用,内部自行完成模型选择、任务委派、验证与结果整合。首发包含 Fugu 和 Fugu Ultra 两个版本,前者兼顾性能与低延迟,后者面向多步难题;官方称 Fugu Ultra 在工程、科学与推理基准上可与 Fable 5、Mythos Preview 比肩。其智能体池可替换,官方表示若某家供应商限制访问,Fugu 会动态绕开,并计划后续纳入开放模型与自家模型。
#产品更新#Agent#MCP/工具调用
Qwen 团队发布 Qwen-Robot Suite,包含 Qwen-RobotNav、Qwen-RobotManip 和 Qwen-RobotWorld 三款面向物理世界智能的基础模型。Qwen-RobotNav 基于 Qwen3-VL,用 1560 万样本统一指令跟随、目标导航、目标跟踪与自动驾驶五类任务,在 VLN-CE RxR 上达 76.5% SR,并零样本部署到 Unitree Go2 四足机器人。Qwen-RobotManip 基于 Qwen3.5-4B VL 与 flow-matching DiT 动作头,用超过 38,100 小时开源数据训练,在 RoboChallenge Table30 v1 通用赛道取得第一。Qwen-RobotWorld 以自然语言作为统一动作接口,在 8.6M 视频文本对上联合训练 20 多种本体,在 EWMBench 等基准排名第一。
#模型发布#具身智能#多模态
xAI 宣布 Grok Imagine Video 1.5 在 Imagine API 正式可用,模型名为 grok-imagine-video-1.5,同时 Video 1.5 Fast 已上线 grok.com/imagine 及 iOS、Android 应用。官方称这是其目前最好的图生视频模型,音效、环境音与对白在同一次生成中完成,语音更清晰、同步更好,画面运动与物理表现更稳定。Video 1.5 Fast 生成 6 秒 720p 视频约需 25 秒,此前模型需 40 秒以上;未来几天还将上线 Projects、多智能体并行和素材库搜索等功能。
#产品更新#视频#xAI
Zyphra 发布 ZONOS2,一个 Apache 2.0 许可的实时文本转语音模型,具备高保真声音克隆能力,采用 9 亿激活参数、80 亿总参数的稀疏 MoE 架构,是首个开源 MoE TTS 模型。相比 Zonos-v0.1,训练数据从约 20 万小时扩展到超 600 万小时,模型规模从 1.6B 增至 8B,实时吞吐提升 4 倍,并支持最长一分钟的多语言与语码转换音频生成。模型权重已在 Hugging Face 发布,基于 SGLang 的推理代码在 GitHub 开源,同时上线 Zyphra Cloud 并提供 API,发布后促销期内免费。Zyphra 还提出新的 ZTTS1-Eval 评测基准,覆盖 9 种语言的 Clean 集与 17 种语言的 In-The-Wild 集。

#模型发布#语音#开源生态
Google DeepMind 发布 DiffusionGemma,一个采用 Apache 2.0 许可的 26B MoE 实验性开源模型,探索文本扩散生成,在 GPU 上文本生成速度最高提升 4 倍。该模型不再逐 token 顺序生成,而是同时生成整块文本,面向内联编辑、快速迭代等速度敏感的本地交互工作流。其加速优势主要体现在单加速器、低到中等批大小的本地低并发推理场景,高 QPS 云端服务下并行解码收益递减。
#模型发布#开源生态#推理
Anthropic 发布 Claude Fable 5,一款面向一般用途的 Mythos 级模型,在软件工程、知识工作、视觉、科学研究等基准上表现领先。同时推出 Claude Mythos 5,为同一底层模型但放宽部分安全限制,初期通过 Project Glasswing 向美国政府和网络安全伙伴开放。两款模型定价均为每百万输入 token 10 美元、每百万输出 token 50 美元,低于 Claude Mythos Preview 的一半。
#模型发布#Anthropic#安全/对齐
Cohere 开源发布其首款智能体编码模型 North Mini Code,采用 MoE 架构,拥有 30B 总参数、3B 激活参数,并使用 Apache 2.0 许可证。Cohere 测试显示,其输出吞吐量最高为 Devstral Small 2 的 2.8x,inter-token latency 优势为 30%,Artificial Analysis Coding Index 得分为 33.4。模型权重已在 Hugging Face 提供 bf16、fp8 和 w4a16 版本,也可通过 OpenRouter、Model Vault 或 Cohere API 使用。
#模型发布#编码#Agent
Google DeepMind 发布 Gemini 3.5 Live Translate,可自动识别 70 多种语言并持续生成近实时译音,同时保留说话者的语调、节奏和音高。该模型仅落后说话者数秒,支持嘈杂环境和多语言输入。它正向 Android、iOS 版 Google Translate 全球推送,Google Meet 将于本月面向部分企业 Workspace 客户开启私密预览。
#模型发布#语音#Google DeepMind
#模型发布#开源生态#推理
#模型发布#推理#部署/工程
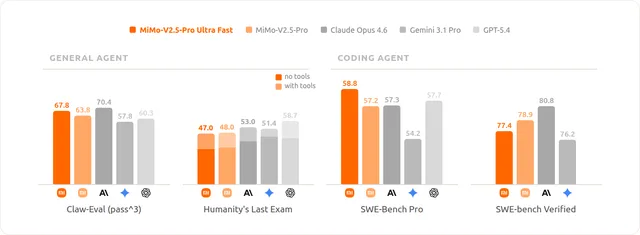
小米与 TileRT 合作发布 MiMo-V2.5-Pro-UltraSpeed,首次在 1 万亿参数模型上把解码速度突破 1000 tokens/s,仅用单台标准 8 卡通用 GPU 节点实现。该 API 按申请制限时开放,价格为 MiMo-V2.5-Pro 的 3 倍、生成速度约 10 倍,试用窗口为 6 月 9 日至 6 月 23 日。团队对 MoE Experts 做 FP4 量化并采用 DFlash 块级掩码并行预测投机解码,编码场景平均接受长度 6.30,同时已在 Hugging Face 开源 MiMo-V2.5-Pro-FP4-DFlash 权重。
#产品更新#推理#部署/工程