Ollama Blog一手模型发布
AI 评分75NVIDIA Nemotron 3 Ultra 上线 Ollama 云
NVIDIA Nemotron 3 Ultra 已在 Ollama 云上线,这是一个 550B 参数(55B 激活)的开源模型,面向长时运行的智能体工作流。它支持 1M token 上下文,针对 NVFP4 格式优化,官方称在智能体生产力、指令遵循和长上下文任务上准确率领先,成本较其他领先开源模型最多节省 30%。
#产品更新#Agent#推理
NVIDIA Nemotron 3 Ultra 已在 Ollama 云上线,这是一个 550B 参数(55B 激活)的开源模型,面向长时运行的智能体工作流。它支持 1M token 上下文,针对 NVFP4 格式优化,官方称在智能体生产力、指令遵循和长上下文任务上准确率领先,成本较其他领先开源模型最多节省 30%。
#产品更新#Agent#推理
LMSYS 宣布 SGLang 与 Miles 在 Day 0 支持 NVIDIA Nemotron 3 Ultra,这是一款面向长时自主智能体的开源前沿推理模型,总参数 550B、激活参数 55B,上下文最长 1M tokens,支持 NVFP4 与 BF16。SGLang 提供高性能推理服务,Miles 支持在 128 张 H200 上以 GRPO 进行强化学习训练,并已验证 dapo-math-17k 上的端到端流程。官方称该模型在智能体生产力、指令遵循和长上下文任务上领先,成本最多节省 30%。
#开源/仓库#部署/工程#数据/训练
Google DeepMind 推出 Gemma 4 12B,将智能体式多模态能力带到笔记本电脑,并首次在其中型模型中支持原生音频输入。该模型在标准评测中的表现接近 26B MoE,内存占用不到后者一半,可在配备 16GB RAM 的消费级笔记本上本地运行。其无编码器架构可直接整合音频与视觉输入,以减少延迟和内存用量。
#模型发布#多模态#推理
xAI 通过 API 以预览形式开放图生视频模型 grok-imagine-video-1.5-preview,输入一张静态图和描述运动的提示词即可生成视频。模型支持最高 720p 分辨率,可用自然语言控制镜头运动、节奏和声音设计,并保持输入帧的细节与光照。它还能逐帧生成后串联成更长场景,保持整个项目视觉一致。
#产品更新#视频#多模态
微软 AI 发布文本转语音模型 MAI-Voice-2,从仅支持英语扩展到 15 种语言,并新增 sad、whispered、excited 等情感标签控制。该模型支持用 5-60 秒参考音频做零样本声音克隆,在对比测试中被 72% 的偏好选择优于前代 MAI-Voice-1,现已上线 Microsoft Foundry,并正在集成进 VSCode 和 Dynamics 365 Contact Center。
#模型发布#语音#Microsoft
微软发布 MAI-Image-2.5 和 MAI-Image-2.5-Flash 两款图像模型,前者在 Arena 图像编辑榜排名第 2、文生图排名第 3,超过 GPT-Image-1.5 和 Nano Banana Pro 2K。两款模型已在 Foundry 面向开发者开放,MAI-Image-2.5 定价为每 1M 文本输入 token 5 美元、每 1M 图像输入 token 8 美元、每 1M 图像输出 token 47 美元,Flash 版分别为 1.75、1.75 和 19.50 美元。MAI-Image-2.5 已上线 PowerPoint 并正在向 OneDrive 推送,OpenRouter 也将提供该模型。

#模型发布#图像生成#多模态
微软 MAI 在 Build 2026 主题演讲中发布七款新模型,覆盖图像、语音、转录、推理和编码。首个推理模型 MAI-Thinking-1 为 35B 激活参数 MoE,256K 上下文窗口,AIME 25 得分 97%,SWE Bench Pro 53%,官方称未做知识蒸馏。编码模型 MAI-Code-1-Flash 仅 5B 参数,SWE Bench Pro 51%,今日起在 VS Code 中逐步向约 10% 个人用户推送。
#模型发布#多模态#语音
Microsoft 发布 MAI-Transcribe-1.5 多语言语音转写模型,语言覆盖从 25 种扩展到 43 种,在 FLEURS 基准上取得 43 种语言的最佳词错误率,Artificial Analysis 榜单 WER 为 2.4%、排名第 3。该模型一小时音频转写耗时不到 15 秒,长音频速度最高为 Gemini 3.1、Scribe v2、GPT-4o-Transcribe 的 5 倍,并新增关键词偏置功能,在 FLEURS 上可将 WER 最多降低 30%。模型已接入 Copilot、Teams、GitHub 和 Dynamics 365 Contact Centre,并在 Foundry 与 MAI Playground 提供。

#模型发布#语音#Microsoft
微软 AI 发布七款自研 MAI 模型,覆盖图像、语音、转录、编码与推理,包括旗舰推理模型 MAI-Thinking-1、面向 GitHub Copilot 的 MAI-Code-1-Flash、MAI-Image-2.5、MAI Transcribe-1.5 和 MAI-Voice-2。MAI-Thinking-1 在盲测人工对比中优于 Sonnet 4.6,MAI Transcribe-1.5 支持 43 种语言且速度是竞品的五倍,MAI-Image-2.5 的 Arena 分数超过 Nano Banana Pro。模型将在 Foundry、OpenRouter、Fireworks 和 Baseten 上提供,开发者首次可以自行微调模型权重;微软同时宣布与 Mayo Clinic 合作共建医疗前沿模型。
#模型发布#多模态#推理
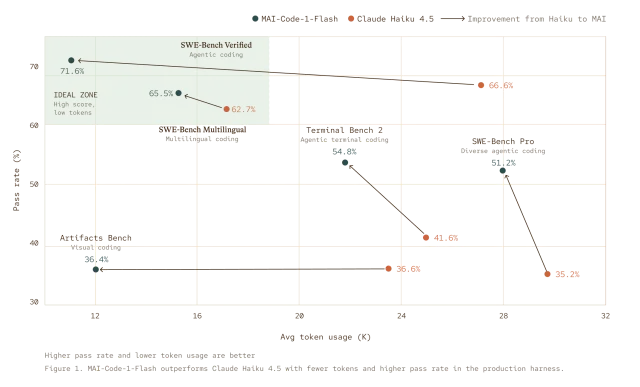
微软发布编码模型 MAI-Code-1-Flash,基于自有企业级数据从头训练,未使用第三方模型蒸馏,正面向 VS Code 中的 GitHub Copilot 个人用户推送,出现在模型选择器和默认 Auto 选择器中。该模型针对 GitHub Copilot 生产环境训练,支持智能体编码和自适应思考,官方称在 SWE-Bench Verified、SWE-Bench Pro、SWE-Bench Multilingual 和 Terminal Bench 2 上均超过 Claude Haiku 4.5,其中 SWE-Bench Pro 为 51.2% 对 35.2%,并在 SWE-Bench Verified 上以最多减少 60% token 解决更难问题。
#模型发布#编码#Agent
Zyphra 发布 Zamba2-VL 系列开源视觉语言模型,基于 Zamba2 混合 SSM–Transformer 主干,提供 1.2B、2.7B 和 7B 三个参数规模,采用 Apache 2.0 许可并开放权重。官方称其在 14 项基准上与同规模最强开源 Transformer VLM 大致相当,在计数、文档和图表类任务上表现突出,且首 token 延迟约低一个数量级。模型沿用 LLaVA 式结构,视觉编码器取自 Qwen2.5-VL,通过两层 MLP 适配器接入 LLM。

#模型发布#多模态#开源生态
#模型发布#具身智能
阿里千问发布 Qwen3.7-Plus,一款把视觉与语言统一到单一智能体底座的多模态模型,已在阿里云百炼上线。它可在同一智能体循环中混合执行 GUI 与 CLI 操作,支持屏幕读取、视觉参考写代码、移动应用端到端操作,并适配 Claude Code、OpenClaw、Qwen Code 等框架。官方基准显示其在 Terminal Bench 2.0-Terminus 得 70.3、ScreenSpot Pro 得 79.0、AndroidWorld 得 81.0,同时支持 preserve_thinking 保留历史思考内容。
#模型发布#多模态#Agent
xAI 在 Grok Build 中上线 Composer 2.5,官方称其是一款快速且达到 SOTA 的模型,擅长长时间运行任务和遵循复杂指令。用户可在 Grok Build 中输入 /model 并在菜单中选择 Composer 2.5 使用。
#产品更新#xAI#模型发布
MiniMax 正式发布 M3,采用自研 MSA 稀疏注意力架构,支持最高 1M token 上下文,并原生支持图像与视频输入、可操作桌面电脑。官方称 M3 是目前首个同时具备这三项能力的开源权重模型,在 SWE-Bench Pro 得分 59.0%、Terminal-Bench 2.1 得分 66.0%、MCP Atlas 得分 74.2%。M3 已通过 MiniMax Code、Token Plan 和 API 开放使用,官方表示将在未来 10 天内发布技术报告并开源模型权重。

#模型发布#开源生态#多模态
xAI 通过 xAI API 公测发布编码模型 grok-build.0.1,该模型专为智能体编码任务训练,覆盖 Web 开发、调试和 MCP 支持,也是 Grok Build 背后的同一模型。它提供 100+ tokens/秒的推理速度,定价为输入 $1/m tokens、输出 $2/m tokens,也可用于通用智能体与工具调用场景,并已在 OpenRouter 和 Vercel AI Gateway 上线。
#产品更新#编码#Agent
Anthropic 发布 Claude Opus 4.8,在编码、智能体、推理等基准上较 Opus 4.7 有所提升,价格不变。同时推出 claude.ai 上的努力程度控制、Claude Code 的动态工作流功能,以及快模式降价三倍。
#产品更新#Anthropic#多模态
Liquid AI 发布端侧 MoE 模型 LFM2.5-8B-A1B,面向消费级硬件上的工具调用,上下文窗口从 32,768 扩展到 128,000 tokens,预训练规模从 12T 提升到 38T tokens,词表从 65,536 扩至 128,000。该模型为纯推理模型,在 M5 Max 上解码 253 tokens/s、Ryzen AI Max+ 395 上 146 tokens/s,占用低于 6 GB,单张 H100 高并发下输出吞吐达 18.5K tokens/s。基础版与后训练版已在 Hugging Face 和 Playground 上线,首日支持 llama.cpp、MLX、vLLM、SGLang 和 ONNX。
#模型发布#端侧#Agent
Mistral 发布 Mistral Medium 3.5,这是一个 128B 稠密模型,统一指令跟随、推理与编码,上下文窗口 256k,以修改版 MIT 许可开放权重,可在少至四块 GPU 上自托管。该模型在 SWE-Bench Verified 上得分 77.6%,τ³-Telecom 得分 91.4,并成为 Mistral Vibe 与 Le Chat 的默认模型。同时 Mistral 将编码智能体搬到云端,Vibe 远程智能体可从 CLI 或 Le Chat 启动、并行异步运行,本地会话可迁移上云,完成后可开 PR 并通知;Le Chat 新增 Work 模式(预览),由新智能体驱动多步任务与跨工具流程,敏感操作需人工批准。API 定价为每百万输入 token 1.5 美元、每百万输出 token 7.5 美元,已在 Pro、Team 和 Enterprise 套餐上线。

#模型发布#Agent#编码
阿里 Qwen 团队发布 Qwen3.7-Max,定位为面向智能体时代的专有模型,可通过阿里云百炼(Model Studio)调用 API。官方称其在编码智能体、通用智能体与推理基准上取得领先或接近 Opus-4.6 Max 的成绩,并支持 Claude Code、OpenClaw、Qwen Code 等多种框架。文中还展示了一次约 35 小时、1158 次工具调用的自主内核优化,最终相对 SGLang Triton 参考实现取得 10.0x 几何平均加速。
#模型发布#Agent#编码