N全部新闻

星期四1 条

  1. Answer.AI 官方研发博客一手模型发布
    AI 评分72

    Answer.AI 与 LightOn 发布 ModernBERT,为 BERT 提供替代方案

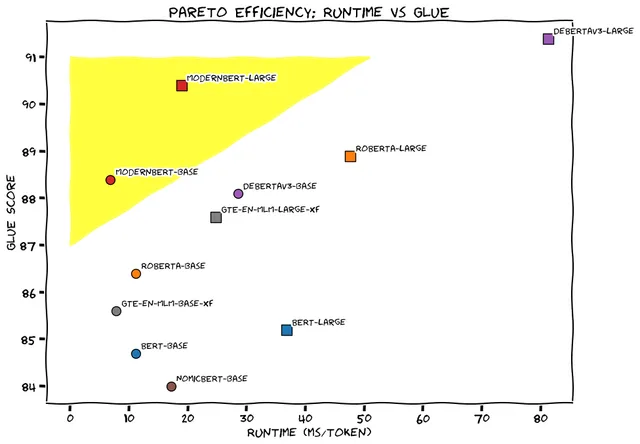
    Answer.AI 与 LightOn 发布 ModernBERT,一个编码器专用模型系列,提供 base(149M 参数)和 large(395M 参数)两个版本,可作为 BERT 类模型的直接替换。它把上下文长度从多数编码器的 512 提升到 8192 token,并首次在编码器训练数据中加入大量代码,在检索、自然语言理解和代码检索任务上整体优于主流模型,速度最高可达 DeBERTa 的 4 倍。模型将随 transformers v4.48.0 发布,在此之前需从 main 分支安装,官方建议搭配 Flash Attention 2 使用。
    #模型发布#开源生态#数据/训练

星期五1 条

  1. Prime Intellect一手模型发布
    AI 评分70

    Prime Intellect 发布 INTELLECT-1:全球分布式训练的 10B 参数模型

    Prime Intellect 发布 INTELLECT-1,称其为首个在全球范围内协作训练的 10B 参数语言模型,规模是此前研究的 10 倍。该模型基于 Llama-3 架构,在 5 个国家、3 大洲的最多 112 张 H100 上训练 1T token,跨洲算力利用率 83%,全美范围内为 96%。团队同时开源基础模型、中间 checkpoint、后训练模型、预训练数据集以及 PRIME 分布式训练框架。

    INTELLECT-1 Release The First Globally Trained 10B Parameter Model

    #模型发布#数据/训练#开源生态

星期三1 条

  1. Cartesia 产品与研究一手模型发布
    AI 评分57

    Cartesia 发布 Voice Changer 变声模型

    Cartesia 发布 Voice Changer 模型,可将任意音频片段的声音替换为其他音色,同时保留原始的语气、情感和韵律。用户可从其录音棚级音色库中选择,或克隆自己的声音,并控制发声、情感和韵律等细节。该模型基于 Cartesia 在状态空间模型(SSM,如 S4 和 Mamba)上的工作,已在 playground 上线,可通过上传文件、选择音色、生成音频三步使用。

    Introducing voice changer: transform audio your way

    #产品更新#语音#模型发布

星期一1 条

  1. Zyphra Research一手模型发布
    AI 评分56

    Zyphra 发布开源小模型 Zamba2-7B

    Zyphra 发布 7B 规模小语言模型 Zamba2-7B,采用 Mamba2 与两个共享注意力块交替的混合架构,并以 Apache 2.0 开源权重。官方称其在评测基准上超过 Mistral-7B、Gemma-7B 和 Llama3-8B,首 token 时间快 25%、每秒 token 数提升 20%,内存占用也明显降低。模型基于 3 万亿 token 预训练数据,并在 128 张 H100 上训练约 50 天。

    #模型发布#开源生态#推理

星期三1 条

  1. Cartesia 产品与研究一手模型发布
    AI 评分51

    Cartesia 发布端侧智能更新:开源 Edge 库、1.3B 模型 Rene 与 Sonic On-Device

    Cartesia 宣布端侧智能首个里程碑,发布开源库 Edge、1.3B 参数 SSM 语言模型 Rene,以及支持低延迟实时流式生成的 Sonic On-Device 私有测试版。Rene 采用 Mamba-2 混合架构,在多项基准上表现与同级 SOTA 小模型相当,Edge 已支持 Apple MLX 和量化推理。

    The on-device intelligence update

    #产品更新#开源/仓库#端侧

星期二1 条

  1. Zyphra Research一手模型发布
    AI 评分58

    Zyphra 发布 1.2B 小模型 Zamba2-mini,权重以 Apache 2.0 开源

    Zyphra 发布 1.2B 小语言模型 Zamba2-mini,称其达到 Llama2 7B 级别的性能,4bit 量化下内存占用不足 700MB,并以 Apache 2.0 协议开源模型权重。该模型采用 Mamba2 与共享注意力层交替的混合架构,相比 Phi1.5-1.3B 首 token 时间快 1.67 倍、内存开销降低 23.3%。模型在约 3T token 的 Zyda 及公开数据集上预训练,并在 100B 高质量 token 上退火,已提供 Hugging Face 集成与纯 PyTorch 实现。

    #模型发布#开源生态#端侧

星期日1 条

  1. Zyphra Research一手模型发布
    AI 评分58

    Zyphra 发布 2.7B 端侧模型 Zamba2-small

    Zyphra 发布 Zamba2-small,一个面向端侧应用的 2.7B 小语言模型,权重以 Apache 2.0 开源。该模型将 Zamba-7B 的 Mamba1 块替换为 Mamba2 块,并采用两个 ABAB 交错共享注意力块,对每个共享 MLP 块应用 LoRA projector。相比 Phi3-3.8B,其首 token 时间快 2 倍、内存开销降低 27%、生成延迟低 1.29 倍,并保持 3-4B 稠密 Transformer 的质量而只需 1-2B 的推理算力与内存。

    #模型发布#端侧#开源生态

星期四1 条

  1. Ollama Blog一手模型发布
    AI 评分73

    Google Gemma 2 上线 Ollama,提供 2B、9B、27B 三个尺寸

    Google Gemma 2 已在 Ollama 上线,提供 2B、9B 和 27B 三个参数尺寸,采用全新架构。Ollama 给出的运行命令为 ollama run gemma2:2b、ollama run gemma2 和 ollama run gemma2:27b,并可与 LangChain、LlamaIndex 等工具配合使用。原文称 27B 版本在基准测试中性能超过参数量两倍于它的模型。

    #模型发布#Google#开源生态

星期五1 条

  1. Claude Platform:开发者版本说明一手模型发布
    AI 评分80

    Anthropic 发布 Claude 3.5 Sonnet

    Anthropic 发布 Claude 3.5 Sonnet,在 GPQA、MMLU、HumanEval 等基准上超越 Claude 3 Opus,速度提升 2 倍,并推出 Artifacts 功能。

    Claude head illustration

    #模型发布#Anthropic#OpenAI

星期五1 条

  1. Cartesia 产品与研究一手模型发布
    AI 评分68

    Cartesia 发布低延迟语音模型 Sonic

    Cartesia 发布低延迟语音模型 Sonic,模型延迟为 135ms,可生成逼真语音。该模型基于状态空间模型架构,在实验中相比 Transformer 实现将时间到首音频延迟降低 1.5 倍、实时因子降低 2 倍、吞吐量提高 4 倍,并提供 Web playground 和低延迟 API。

    Announcing Sonic: a low‑latency voice model for lifelike speech

    #模型发布#语音#多模态

星期二1 条

  1. Sam Altman Blog一手模型发布
    AI 评分93

    Sam Altman 谈 GPT-4o 的免费开放与语音视频交互

    OpenAI 将 GPT-4o 免费提供给 ChatGPT 用户,并推出具有人类级响应速度和表现力的新语音及视频模式。Sam Altman 表示,这种交互快速、自然且实用,未来还将加入可选的个性化、信息访问和代用户执行操作等能力。

    #模型发布#多模态#语音

星期四1 条

  1. Ollama Blog一手模型发布
    AI 评分76

    Llama 3 上线 Ollama,提供 8B 与 70B 两个版本

    Llama 3 现已可通过 Ollama 运行,首发包含 8B 和 70B 两个参数规模,命令分别为 ollama run llama3:8b 和 ollama run llama3:70b。相比 Llama 2,其训练数据集扩大七倍,上下文长度翻倍至 8K,token 词表扩大到 128K,误拒答情况不到 Llama 2 的三分之一。Meta 计划后续发布 400B 参数版本及支持多模态、多语言和更长上下文窗口的多个模型。

    #产品更新#开源生态#Meta

星期二1 条

  1. Zyphra Research一手模型发布
    AI 评分66

    Zyphra 发布 7B 基础模型 Zamba,开源全部训练检查点

    Zyphra 发布 7B 参数基础模型 Zamba,采用 Mamba 块与每 6 层一个全局共享注意力层结合的混合架构,训练和推理比标准 Transformer 更省算力。模型分两阶段训练,先用约 1 万亿 token 开放网页数据,再用约 500 亿 token 高质量数据退火,在多项基准上超过 LLaMA-2 7B 和 OLMo-7B,且训练数据用量不到后者一半。全部检查点以 Apache 2.0 协议开源,由 7 人团队在 128 张 H100 上耗时 30 天完成,Hugging Face 集成和完整技术报告将随后发布。

    Quality vs. Inference Speed

    #模型发布#开源生态#数据/训练

星期五1 条

  1. Ollama Blog一手模型发布
    AI 评分60

    Ollama 发布 LLaVA 1.6 视觉模型,新增 34B 版本

    Ollama 更新 LLaVA 视觉模型集合至 1.6 版本,支持最高 4 倍像素的图像分辨率,并在额外的文档、图表和示意图数据集上训练,提升了文字识别与推理能力。模型提供 7B、13B 和新增的 34B 三种参数规模,可通过 ollama run llava:7b、llava:13b、llava:34b 运行,采用 Apache 2.0 或 LLaMA 2 Community License 授权。CLI 中可直接引用 .jpg 或 .png 文件路径,Python、JavaScript 库和 REST API 则支持在 images 参数中传入 base64 编码文件。

    #产品更新#多模态#开源生态

星期四1 条

  1. Sam Altman Blog一手模型发布
    AI 评分81

    OpenAI 研究发布 DALL•E 2,可通过自然语言创建和编辑图像

    OpenAI 研究发布 DALL•E 2,这款 AI 工具可根据自然语言指令创建和编辑图像。Sam Altman 认为它能增强艺术家和插画师的创造力,也可能影响创意劳动市场。团队计划先与更多研究人员和艺术家协作降低风险,并希望在今年夏天推出可供用户使用的产品。

    #模型发布#图像生成#OpenAI