←搜索结果

按匹配度 · 共 296 条结果 清除搜索

星期二

  1. NVIDIA Developer · Generative AI精选

    NVIDIA 开源 NVIDIA Recovery,自动恢复集群分布式训练任务

    NVIDIA 发布开源工作负载级恢复服务 NVIDIA Recovery,通过应用日志、GPU 指标和调度器信号检测训练中断,并按检测、归因、隔离、重启或停止四阶段循环处理。该服务以 Apache 2.0 许可在 dsx-ai-factory/NVIDIA-Recovery 仓库开放,Slurm 集成通过 Helm chart 部署的 Advisor Controller 实现,支持集群内和 SSH 两种模式。新部署默认处于监控模式,只输出恢复建议不执行调度动作;7 月 9 日至 10 月 9 日在一个训练集群上的监控覆盖每天近 200 个任务,记录约 8,550 次异常检测,平均检测与恢复动作延迟分别为 69 秒和 94 秒。
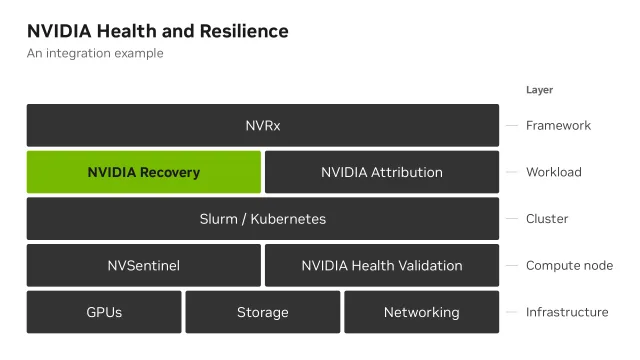
    Five-layer stack diagram showing where NVIDIA Recovery sits in the health and resilience architecture. From the base up: infrastructure, compute node, cluster, workload (where NVIDIA Recovery and NVIDIA Attribution sit), and framework (NVIDIA Resiliency Extension, or NVRx).

    的操作(终止、重新排队、释放或节点排除)、时间戳、工作负载标识符,以及 NVIDIA Attribution 返回的判定结果(若有)。策略引擎操作和看门狗操作会记录在同一条轨迹中,因此记录没有缺口。 Recovery Console 是运维人员仪表板。它显示跨调度器类型的实时工作负载状态,内联呈现异常标记,并为你提供每个工作负载的检测事件和恢复操作时间线。 视频 1:演示在 Kubernetes 上使用 Slurm 的 NVIDIA Recovery 全流程,从环境搭建和作业配置,到作业失败、自动恢复与归因 NVIDIA Recovery 已在 dsx-ai-factory/NVIDIA-Recovery 采用 Apache 2.0 许可证的 GitHub 仓库。让首个工作负载进入恢复流程需要三个步骤: 安装该 chart。NVIDIA Recovery 通过单个 Helm umbrella chart 部署。它附带一个捆绑的 MySQL 子 chart,因此你可以在本地运行快速入门,而无需预置数据库或物理 GPU。对于生产环境,请将该 chart 指向托管 MySQL 服务。仓库中的

    匹配字段正文

星期五

  1. gihyo.jp

    GitHub 在 Universe 2026 上正式提供 Copilot Fusion,并公测 Copilot…

    GitHub 在 2026 年 10 月 28 至 29 日举行的 GitHub Universe 2026 上宣布,整合自动模型选择与多模型协作的 Copilot Fusion 正式提供,可在 VS Code、GitHub Copilot 应用、CLI 和 JetBrains IDE 中使用,按 Standard、High、Max 三档处理级别自动决定所用模型与 Single、Cascade、Critique 三种执行方式。桌面版 GitHub Copilot 应用同时开始公测 Projects,把资料、仓库、会话与成果物集中到一处管理。GitHub 称 Fusion Max 在 Artificial Analysis Coding Agent Index 上得分 60,与使用 Opus 5.5 Max 的 Claude Code 相差 2 分以内,单任务平均 API 费用约为其一半、耗时约少 40%。

    种。可以在 PR 发生冲突或创建安全警报等情况下,启动所设置的处理。 还可以使用 REST API,从外部系统传递相关信息来启动 Automation。此外,通过将某个 Automation 的成功或失败设为另一个 Automation 的启动条件,可以组合多阶段处理。 可使用的 GitHub 工具新增了 20 种,包括重新运行工作流、合并 PR、附加图片和视频等。还可以连接自定义的 MCP 服务器,并按每个 Automation 选择允许使用的工具。对外部服务能做什么,也取决于连接目标的设置和认证信息。 可以为每个 Automation 设置 AI 积分使用量的上限。达到每次执行的上限时,将停止该次执行。还可以设置每日、每周、每月的上限,达到上限时,在切换到下一个统计周期之前不会启动新的执行。 此外,还新增了根据执行结果制定改进方案的功能。请 Copilot 创建想要自动化的工作,以及回顾其结果并加以改进的机制,即可组合用于工作的 Automation 和用于改进的 Automation。 例如在 PR 审查中,准备一个在创建 PR 时确认变更并发表评论的 Automation,以及

    匹配字段正文

  2. VR陀螺

    极米记得开售 AI 记忆眼镜 G1 与记忆手环 L1,599 元起

    极米记得 AI 记忆眼镜 G1 与 AI 记忆手环 L1 于 10 月 28 日正式开售,手环 L1 标准版售价 599 元,眼镜 G1 标准版首发价 1299 元。两款设备共用极米记得 App 与同一套 AI 记忆服务,开机即录,可将日常交流转写并自动生成会议纪要、待办事项和生活卡片。数据管理上采用只留文字不留原音的方式,语音转写完成后删除原始音频,并支持设置免录时段和隐私禁词。

    。 这也让它的产品思路更加清晰。通过不同的硬件形态适应用户的佩戴习惯,再由同一套软件服务,将零散的对话整理成可供回顾和调用的个人记忆。用户是否愿意长期使用,既取决于设备戴起来是否舒服,也取决于留下的内容能否在需要时派上用场。 从这个角度来看,极米记得的尝试,也为AI可穿戴设备向个人Agent演进提供了一条路径。随着记忆不断积累,AI有望结合过去的交流理解当下需求,进一步参与任务跟进与日常安排。而如何将持续记录转化为准确、适时的帮助,将是这类产品接下来需要验证的能力。 投稿/爆料:tougao@youxituoluo.com 稿件/商务合作: 林南(微信 19250561593) 加入行业交流群:林南(微信 19250561593) 版权申明:本文为VR陀螺原创,任何第三方未经授权不得转载。如需转载请联系微信:vrtuoluo233 申请授权,并在转载时保留转载来源、作者以及原文链接信息,不得擅自更改内容,违规转载法律必究。文中有图片、视频素材来自互联网或无法核实出处,如涉及版权问题,请联系本网站协商处理。 数字科技产业资讯与服务平台 下载「陀螺科技」APP,获取前沿深度数字科技产业讯息

    匹配字段正文

  3. 智能制造网

    大晓机器人联合南洋理工大学发布世界模型 Mundo

    大晓机器人联合南洋理工大学 S-Lab 发布面向具体环境构建的世界模型 Mundo,支持场景重建、自由视角探索和时空模拟。Mundo 可将物体的质量、摩擦等物理属性写入场景程序,由物理引擎计算运动、接触与碰撞,并支持调用智能体用代码编辑场景中的物体、属性与动作。输入 1 至 12 张图像即可构建可探索三维空间,同一组参考图像支持多条相机路径,更大场景可连续生成数十秒至分钟级探索画面。

    Atlas 类似的场景重建、自由视角探索和时空模拟能力。相较于Atlas来说,Mundo可以将物体的质量、摩擦等物理属性纳入场景程序,通过物理引擎计算运动、接触与碰撞。同时,Mundo 支持调用智能体,通过代码编辑场景中的物体、属性与动作,将少量影像转化为可自由探索、可编程交互、可用于机器人导航与操作训练的三维世界。 Mundo 将三维场景表示、物理仿真与视频生成相结合,结合Astra打造全新空间理解能力,先通过影像场景与物体,并可以通过代码实现场景可以编辑,再通过代码定义、编辑物体属性和动作。物理引擎计算运动与碰撞,视频模型结合参考影像渲染结果,形成从场景重建、代码编辑到交互模拟的完整流程。场景既能被看见,也能响应动作、记录变化,进而成为机器人训练与测试的环境。 这一能力为机器人进入具体商业场景提供了支持。在大晓机器人以 Kairos 为核心的世界模型技术体系中,Mundo 补充环境建模、训练数据生成与仿真训练能力,帮助机器人完成场景适配和策略优化。 少量图像构建专属世界模型 支持跨空间长路径生成 Mundo 将少量图片或者视频,拓展为可持续探索的三维空间,同一组参考图像可以支持多

    匹配字段正文

  4. 中华网科技

    腾讯灯塔AI正式对外开放:一句话完成数据分析

    腾讯宣布旗下AI数据分析平台腾讯灯塔正式对外开放,企业与个人用户可通过 beacon.qq.com 注册使用,平台提供自然语言问数、看板生成、归因分析、指标监控与团队协作等能力。灯塔AI支持3大类10种数据源接入,官方称搭建全链路运营看板从传统BI的4至6个工作日缩短到不超过2小时,业务监控看板从打开对话框到定稿用时8分钟。平台预置12个数据分析技能和3个可视化技能,可通过MCP协议接入企业内部系统,新用户首次注册赠送500积分,此后每月赠送500积分。

    AI数据分析平台"腾讯灯塔"正式对外开放,企业与个人用户可通过官网beacon.qq.com 注册使用。腾讯灯塔过去十年专注于腾讯内部业务的自助分析洞察与数据可视化,此次品牌升级为AI数据分析洞察套件,面向业务团队提供自然语言问数、看板生成、归因分析、指标监控与团队协作等一站式能力。 经过十多年技术积累和产品迭代,如今新升级的灯塔AI已广泛应用于 QQ、腾讯视频、腾讯新闻、应用宝、微信支付、元宝、腾讯客服、天美游戏等100多个腾讯内部业务团队,积累了丰富的数据分析,日常经营分析经验。 把一张业务看板从"一周"压缩到"小时级" 传统模式下,业务人员想要一张看板,需要经历提需求、等排期、取数、做图、调格式等环节,周期通常在一周左右;口径一变,又要重新排期。灯塔AI的做法是让业务人员自己走完这条链路:用自然语言描述需求,AI直接生成看板,之后的修改、追问、归因和推送都在同一个工作台内完成,无需编写SQL。 在过往的使用案例中,我们发现搭建全链路运营看板,在传统BI工具上需要4至6个工作日,使用灯塔AI后从需求到交付(含迭代调优)不超过2小时,搭建业务监控看板,从打开对话框到看板定稿用时仅8分

    匹配字段正文

  5. 新浪科技

    智元发布 GO-3 Preview 基座模型、Genie Master 框架与精灵 G2 Max 机器人

    智元在 2026 智元创新日具身作业生产力分论坛上发布具身基座模型 GO-3 Preview、具身 Agent 框架 Genie Master 和重载具身工业机器人精灵 G2 Max。GO-3 Preview 采用理解、预测、动作生成统一的 WRAM 架构,在 20 类技能 100 个任务上 Zero-Shot 平均成功率由 13.4% 提升至 56.4%,模型规模扩展实验中由 56.2% 提升至 73.2%,并已登顶 RoboDojo、RoboTwin、RoboColiseum 三大评测榜单。联席总裁姚卯青提出可衡量、可复制、可持续三项能力标准,现场还给出手机包装任务 98.3% 成功率、便利店精灵 G2 任务成功率从首日 28.6% 升至第五天 85.7% 等数据。

    相关专题top start 相关专题top end 期货推广begin 期货推广end 秒拍begin 秒拍end 视频播放器start 视频播放器end 行情图begin 行情图end 新浪科技讯 10月30日晚间消息,2026智元创新日具身作业生产力分论坛上,智元发布具身基座模型 GO-3 Preview、具身 Agent 框架 Genie Master以及重载具身工业机器人精灵 G2 Max 等成果,并展示了一套可部署、可运营、可持续优化的 Physical AI 生产力技术闭环。 “演示考验的是单点能力的上限,但生产力考验的是系统的下限。”在智元联合创始人、联席总裁、具身业务体系总裁姚卯青看来,机器人作业生产力是一套严苛的工程标准:可衡量——成功率、节拍、MTBF(平均故障间隔时间)全部有数;可复制——不是一条示范线,而是成千上百条产线;可持续——不是交付即终点,而是越用越好。具身智能只有同时具备三项能力,才能真正走进产业现场。 据悉,此次发布的GO-3 Preview 通过理解、预测、动作生成统一的WRAM 架构,可实现跨场景泛化与精细操作能力。现场公布的实验显示,在训练数据

    匹配字段正文

  6. 智能制造网

    小米公布新一代仿生手:21个自由度由1827个工厂SOP反推得出

    小米公布新一代仿生手核心信息,包括21个自由度、26个电机混合驱动和1500点全掌触觉。这21个自由度来自小米汽车工厂2579个标准作业程序中1827个的动作捕捉数据,仿真显示17至21个自由度档位的平均稳定抓握成功率比6至15个档位高15%至38%,23个以上提升放缓。手掌采用腱绳驱动为主加5个直驱自由度,手掌重量324克,恶劣工况下单手功耗可超100W,目前没有量产时间、成本或外供时间表。

    儿,到底需要一只手有多少个关节?做少了,抓不住、捏不准;做多了,是在为用不上的灵活性买单,还牺牲了可靠性。 这道题,靠拍脑袋回答不了。做多做少,都得有证据。 小米的办法,是把顺序倒过来:先不设计手,先去看人在工厂里怎么用手。 具体而言,小米技术团队在小米汽车智能制造部中试中心,挑选了16个典型工段、2579个标准作业程序(SOP),对其中1827个做了多角度视频和动作捕捉采集,覆盖70.8%以上的人工工序。采集到的动捕数据经过分类、切片、清洗和重定向,再开展基于人手的多维数据分析和仿真。 说白了,就是给一线工人的手做“工时统计”,看每个关节在干活时到底被用掉了几成。 结论有两层,还挺有意思。 第一层是:人手的关节,其实没怎么“划水”。 小米用“实际作业中的活动范围÷人手该自由度的平均完整行程”,来衡量每个自由度的利用率,发现在数据覆盖的作业中,几乎所有被测自由度的利用率都超过50%。 这说明,这些关节在实际作业中并非闲置,但“能不能合并”最终要靠耦合性和仿真消融来回答,单靠利用率不足以定论。 第二层是:人手的关节存在天然耦合,不是个个都独立干活。 比如同一根手指上,远节指骨(DIP)的

    匹配字段正文

  7. 雷科技

    腾讯 WorkBuddy 升级企业版并发布 Buddy One 跨应用协同体系

    腾讯在 2026 全球数字生态大会上宣布 WorkBuddy 自今年 3 月上线以来累计完成 90 亿次任务请求,企业版落地 50 多个行业。会上发布 Buddy One 跨应用 AI 协同体系,将 WorkBuddy、腾讯文档、腾讯会议、腾讯网盘和 ima 连接起来共享 Agent 底座,同步推出承担统一存储角色的腾讯网盘。企业版还升级了安全与可观测能力,并发布 WorkBuddy 托管智能体(WMA),企业可将工作流程沉淀为 Skills 交由云端 7×24 小时运行;目前生态已汇聚超 5 万家伙伴及开发者,上架 Skills 超 20 万个。

    ,并首次引入视觉理解能力。定位更高性价比的Hy4 flash也将在近期推出。 面向Agent大规模运行的需求,腾讯云还升级了Agent Runtime,通过沙箱快速启动、暂停与恢复等技术降低执行成本。据腾讯介绍,目前沙箱启动仅需60毫秒,每分钟可创建16万个,并可将企业综合部署成本降低70%。 此外,腾讯云还公布了国产算力适配优化、新一代云服务器SA10、音视频AI WAND等技术与产品进展,为AI应用规模化落地提供支持。 虽然今年大会涉及的产品和技术依然不少,但它们正在围绕一个更加明确的方向展开: 让Agent真正进入企业的工作流程。 过去一年,大模型能力不断提升,越来越多企业也开始尝试引入AI,但从个人使用AI,到整个组织依靠AI完成工作,中间仍然存在业务系统割裂、安全风险、部署成本等一系列问题。 所以我们能看到,腾讯正在以WorkBuddy为入口,连接办公应用、企业数据和业务系统,再通过模型、Agent运行环境和云基础设施提供支撑。这也意味着,企业AI竞争从单纯拼模型能力,正在走向拼实际业务落地。 不过,90亿次任务请求和大规模企业覆盖,目前更多证明了WorkBuddy的使用规模

    匹配字段正文

星期三

  1. 邵猛

    MiniMax Code 团队开源 MCode Stack Agent 工作流与 Skills

    MiniMax Code 团队开源了 MCode Stack,把团队日常使用的 Agent 工作流和 Skills 写成可安装的 SKILL.md 与清单,可作为插件接入 MiniMax Code 及任意支持 Skills 的 Agents。仓库按成员打包成 stack,其中 stacks/ronny/ 最完整,含 15 个 skill,覆盖子 Agent 拆分、上下文与工具预算审计、长会话交接、独立评审和热修复判断。配套 notes/ 专栏 MCode Engineering Notes 阐述思路,六条 engineering-* 改编自 Google Engineering Practices,改编部分沿用 CC-BY 3.0,其余为 MIT。

    .md / 清单,并可作为插件进 MiniMax Code 和任意支持 Skills 的 Agents。 开源地址:https://t.co/tU3L7LxLF1 仓库里有什么 按人打包成 stack(每人一套插件): · stacks/ronny/:最完整,15 个 skill · stacks/jiachen/:偏「跳出 Agent 循环、把笔记做成帖/视频」 · notes/:配套专栏 MCode Engineering Notes(文章讲道理,技能可执行) · community/、templates/stack-template/:欢迎外人贡献日常用法 · 三类物件:Skill(/技能名 或按描述自动加载)、Checklist(逐项过项目)、Workflow(WORKFLOW.md 描述日常怎么用)。Ronny 的 WORKFLOW.md 仍标 Coming soon,先以 skills 为准。 Ronny 那 15 个 Skills 1. 规划与拆分:subagent-split-check、engineering-small-prs、engineering-change-

    匹配字段正文

  2. 邵猛

    Apple Creator Studio 大更新:Final Cut…

    Apple Creator Studio 迎来大更新,Final Cut Pro、Motion、Pixelmator Pro、Logic Pro 以及 Keynote、Pages、Numbers 均加入自然语言助手和生成式编辑,多数为测试版,依赖支持 Apple Intelligence 的机型且目前仅支持美式英语。办公三件套新增 MCP 支持,外部 AI Agent 和工具可直接读取内容、改稿并执行自动化操作。Keynote 还推出基于 JSON 的开放包格式 .keyx,方便外部工具和 Agent 读取。

    Apple Creator Studio 大更新:剪辑、图像、音乐、办公一起加上 AI,办公还能被外部 Agent 操作 Apple 这次更新大致三个路线: 1. 把 MotionVFX、Content Hub 里的视频素材、Logic 里更完整的声音浏览等专业内容,收进订阅权益里 2. 在 Pixelmator、Logic,以及 Keynote、Pages、Numbers 里加入自然语言助手和生成式编辑(多为测试版,且依赖支持 Apple Intelligence 的机型,目前只有美式英语) 3. 办公三件套支持 MCP,Keynote 还推出面向外部工具和 Agent 的交换格式 .keyx,文档开始按「能被外界读写」来设计 详细内容:https://t.co/2BAjZvAvHk 视频与动效 Final Cut Pro(Mac)内置 MotionVFX,模板、转场、跟踪、抠像、调色等元素可达数千种。编辑可在应用里打开 Content Hub,使用苹果整理过的视频、图片和背景,不必离开剪辑流程。时间线上的图片可以直接在 Pixelmator Pro 里打开,改完自动写回工程,不用再

    匹配字段正文

  3. 卡尔的 AI 沃茨

    豆包工作上线录制回放功能,支持边操作边讲解最长 30 分钟

    豆包工作上线录制回放(record & replay)功能,可把电脑操作过程录下来交给 AI 生成步骤说明并复刻,类似简化版 RPA。相比 Codex 同类能力,它额外支持边操作边讲解,最长录制 30 分钟,处理时优先转换音频。作者实测用它做跨平台内容采集、公众号排版发布等任务,并指出执行中若占用同一窗口任务会主动暂停,同时打开多个网页则不受影响。

    不同的是,中间如果我要用对应的这个窗口的话,它是会主动断掉的。 拿我在 Codex 上的经验说。经常会遇到我开了一个对话,那个对话要用我的浏览器,但我同时又想开另一个对话,两边就冲突了。操作软件的时候特别明显,浏览器其实还好,可以通过其他 Skill 绕开。 我说具体一些。 比方说我要用 Codex 操控 Grok,同样的环境给我出个日报。但因为我同时在录视频,或者在跟另一个 Agent 对话,它弹出来的页面就会打断我。我不断最小化 gpt 不断重试,很多时候就是因为反复切界面导致操作失败。 所以暂停和重试这两种机制,我觉得有好有坏。如果让我选的话,本机,就是我自己用的电脑,我希望有自动暂停的机制,因为不会打断我主要的工作。但如果是在远程的 Mac mini 上跑,重试更好,反正不挡我。 上次文章里,我没有写这个录制回放技能会跟已有的 Computer Use,Browser Use(浏览器自动化)去搭配使用。像豆包,它其实会先返回说目前的状态是什么,然后给出后续的行动。 那下一步,最好的做法就是让它去做巡检。 我刻意强调巡检这两个词,是因为以前我可能会说每隔 5 分钟,10 分钟去

    匹配字段正文

  4. 智东西

    天数智芯首次实机演示天垓300与端侧终端TY1200

    天数智芯首次实机演示通用GPU天垓300和端侧算力终端TY1200,并预告标称算力600T的下一代端侧产品TY2000。天垓300有144GB显存,在64K长上下文下Attention性能为H200的1.05倍,GLM-5.3模型下MoE吞吐为H200的1.15倍;TY1200为300 TOPS INT8稠密算力,实测TPS超越英伟达Thor T5000。天垓300 IXL144超节点在单机柜集成144颗GPU、聚合约10.1TB显存,每百万有效Token成本较国际主流方案降低约40%。

    n3.8-27B模型,首先向模型提问了“狮子和老虎单挑谁会打赢”。结果显示,TY1200的首词延迟更低、吞吐更高、输出时间更短。 根据天数智芯公开的数据,在大语言模型、多模态模型、世界模型等的实测中,TY1200的TPS(每秒词元数)均超越了T5000。宋远盈称,TY1200性能更优的原因在于显存带宽更高、计算核数量更多。 演示人员现场实测的下一个任务是文生视频。她让两款产品生成了猫咪打架并打碎了花瓶的视频。TY1200在6分10秒内生成了5秒视频。 其次是对保密要求更高的法务合规场景,演示人员现场演示了基于企业内部的规则进行法务合同审核。 最后是物理AI场景。其现场用端侧算力训练了双足鸭机器人MicroDuck,让MicroDuck在仿真环境里完成各项活动,包括前进、后退、转身、被推倒后站起等。 演示人员现场还让实体的MicroDuck自己走动,并在摔倒后站起来。 在具体的应用方面,其基于TY1200打造了面向储能电芯研究的垂直AI智能体;此外在视觉识别领域,传统方案的视觉识别准确率为70%,天数智芯用CV+多模态+端侧算力,再结合云端进行应急指挥管理,将视觉识别的准确率提升至95%

    匹配字段正文

  5. Computerworld

    Apple 更新 M6 版 iMac、14 英寸 MacBook Pro 及 Creator Studio

    Apple 为 14 英寸 MacBook Pro 和 iMac 换上 M6 芯片,前者配备 12 核 CPU、12 核 GPU 和双 16 核 Neural Engine,续航达 24 小时,图形性能比上代提升 30%;iMac 图形性能为 M4 版的两倍。Creator Studio 套件将于 11 月更新:Final Cut Pro 加入 MotionVFX 特效库与 Pixelmator Pro 编辑功能,Logic Pro 增强 Stem Splitter 并引入由 Apple 自研模型与 OpenAI 组合驱动的智能助手,Pixelmator Pro 新增自然语言 Generate Fill,Keynote、Pages、Numbers 以 beta 形式加入理解文档上下文的助手和 MCP 支持。两款 Mac 于 10 月 28 日开启预售,11 月 6 日到店,iMac 起售价 1,499 美元。

    你打造了全球领先的大众市场AI生态系统,就必须做点什么来展示这种能力。Apple通过对其Creator Studio创意工具套件的一系列有趣更新做到了这一点。这些更新将于11月发布。 Mac版Final Cut Pro现在包含庞大的MotionVFX合集,由数千种视觉效果、转场和动态图形工具组成,并内置Pixelmator Pro编辑功能。Apple还为其Content Hub填充了大量新视频素材,可直接从Final Cut Pro内部获取。 Logic Pro新增AI功能、增强的Stem Splitter(现在可分离鼓声)、重新设计的音色浏览器,以及由Apple自研模型与OpenAI组合驱动的新智能助手。 Pixelmator Pro推出Generate Fill,让创作者可以使用自然语言转换图像的选定区域。 Keynote、Pages和Numbers以beta形式引入新的AI功能,包括能理解文档上下文的助手,以及用于工作流自动化的新模型上下文协议(MCP)支持。它们在Content Hub中新增库存视频、新的高级主题和模板,以及由Apple自研模型与OpenAI组合驱动的智能助手。

    匹配字段正文

  6. NVIDIA Blog

    NVIDIA RTX Spark 笔记本更新:新增 Nemotron 3.5 Transcribe 与本地智能体工具

    NVIDIA 公布 RTX Spark 轻薄笔记本的多项更新,包括开放权重语音模型 Nemotron 3.5 Transcribe、Liquid AI 的 LFM3 模型家族支持,以及 NVIDIA App 中可在前台应用与后台智能体之间分配 GPU 资源的控制项。Nemotron 3.5 Transcribe 支持 40 种语言的转写、说话人标注和翻译,约 43 亿活跃参数,已在 Hugging Face 上线。RTX Spark 笔记本现由 ASUS、Dell、HP、Lenovo、Microsoft 和 MSI 出货,起售价 2599 美元。

    ,也能承担过去需要台式工作站才能完成的工作。 这对以下人群意味着什么: AI 开发者: 在本地运行模型和智能体,使用 NVIDIA CUDA ——与在云端为 AI 提供支持的平台相同——并具备在超过 1.5 亿台 NVIDIA RTX AI PC 以及云端 NVIDIA GPU 上部署的路径。 创作者: RTX Spark 可原生编辑相机拍摄的 4:2:2 视频,并渲染最高 90GB 的 3D 场景。Adobe Photoshop 和 Premiere 通过测试版提供对 RTX Spark 的原生支持。 玩家: 数百款游戏可在 RTX Spark 上运行,NVIDIA DLSS、光线追踪、Reflex 和 G-SYNC 带来更锐利的画面以及更流畅、更灵敏的游戏体验。 RTX Spark 笔记本现已由 ASUS、Dell、HP、Lenovo、Microsoft 和 MSI 出货,起售价 2599 美元,128GB 配置已上架。请在 RTX Spark 产品页面. ICYMI:来自 NVIDIA 本地 AI 的更多更新 🦆Microducks 在 RTX Spark 的帮助下学习行走: 在

    匹配字段正文

  7. ElevenLabs Blog

    ElevenLabs 发布强制对齐模型 Cue,支持字符级音频时间戳

    ElevenLabs 发布强制对齐模型 Cue,可为音频中每个字符定位精确时间点,并已用于 Scribe 语音转文字模型家族。Cue 覆盖 90 多种基准语言,单次处理任意长度录音,在生产 GPU 上对齐 1 小时音频约需半秒;在 29 种语言的基准上,其准确率高于 ElevenLabs 测试的所有对齐工具。该模型也通过 Forced Alignment API 单独开放。

    Cue vs. other aligners across accuracy, latency, language, song, and speed benchmarks.

    隆重推出 Eleven v4,这是我们迄今为止最具情感表现力的模型。探索跳至内容登录注册联系销售登录 阅读文档 了解更多 如果你曾在电视上看过一部播出信号出问题的电影,演员的对白与字幕完全对不上,你就知道这有多让人分心,会把你的注意力从故事中拉走。使用语音模型的视频和软件也有同样的问题:晚出现一秒的字幕,或者高亮了错误单词的转录文本,都会让人觉得同样糟糕。 “人类很擅长对齐媒体内容,至少能做到词级对齐,”ElevenLabs 从事对齐研究的研究员 Danila Kozlov 说。“我们通常能本能地感觉到一个词从哪里开始,但要做到字符级、亚毫秒级的精度,就难得多。” 今天,ElevenLabs 进一步介绍了 Cue,这是一种强制对齐模型,能把音频文件中的每个字符放到精确的时间线上。Cue 为 ElevenLabs 的 Scribe 模型家族提供支持,在真实录音上,它在基准测试的全部 29 种语言中都比 ElevenLabs 测试过的所有对齐器更准确。它还能单次处理任意长度的录音,并在不到一秒内对齐一小时的音频。 什么是强制对齐? 想象有人递给你一段视频和一份转录文本,让你把每个词匹配到它

    匹配字段正文

星期四

  1. heise online

    Google 与 Xreal 合作的 Android XR 眼镜 Aura 开售,起价 1099 美元

    Xreal 与 Google 合作开发的 Android XR 眼镜 Xreal Aura 在美国、加拿大、日本和韩国开售,12GB+256GB 版 1279 美元、16GB+512GB 版 1499 美元,年底前优惠价为 1099 和 1299 美元,11 月中旬开始发货。它重约 95 克,采用分体架构,把主要计算单元和电池放到有线口袋主机中,搭载高通 Snapdragon Reality Elite 芯片,支持 Gemini 语音指令、手势追踪和 70 度视场。Xreal 称首发提供 150 多个 XR 应用与体验,并推出带 Gemini 键的手柄和无线键盘配件。

    Mary 以及 Fallout: Factions 的混合现实版本。作为配件,Xreal 推出了一款带 Gemini 按键的游戏手柄,以及一款用于多虚拟窗口办公的无线键盘。与其他显示眼镜一样,笔记本电脑和游戏掌机也可通过 USB-C 连接,并将其屏幕内容呈现在大型虚拟显示器上。 Heise 作者 Josef Erl 在伦敦的一场 Xreal 活动中试用了该眼镜。尤其令他信服的是清晰的画面呈现和稳定的手势追踪,不过他有时觉得视场角有所局限。与以往的 Xreal 型号相比,Aura 佩戴明显更舒适,前部负重感也更小。 每隔一个周一,我们为您带来 XR 行业最重要的进展。让您尽在掌握。 电子邮件地址 有关发送流程和您的撤销权的详细信息,请参阅我们的隐私政策。 与 Xreal Aura 最可比的是 Meta 即将推出的 VR Glasses。它们同样紧凑轻便,也采用分体架构和高通高端芯片。与 Aura 不同,VR Glasses 通过视频透视呈现环境。价格方面,两款设备处于相近量级:Meta 称 VR Glasses 售价 1299 美元,但预计要到 2027 年春季才会推出。 (tobe)

    匹配字段正文

  2. Google Blog精选

    Gemini 应用支持直接生成、预览和编辑文档

    Gemini 应用新增在对话内生成、预览和编辑文件的能力,可全屏直接输入修改、选中文本提问或让 Gemini 改写文件。PDF 预览与编辑在网页端和移动端均支持,Google Docs、Google Sheets、幻灯片、Markdown、TXT 和代码等其他格式仅在网页端支持。该功能已向 Gemini 应用覆盖的所有语言的全部用户开放。

    现在,你可以直接在 Gemini 中生成、预览和编辑文档、PDF、演示文稿、电子表格等。 2026年10月29日 我们正在 Gemini 应用中推出创建和优化文档、PDF、演示文稿、电子表格、代码等内容的新方式。 现在,你可以直接在聊天中生成、预览和编辑文件——展开至全屏即可直接输入修改,选中文本即可提问,或让 Gemini 优化你的文件。PDF 预览和编辑在网页端和移动端均受支持,而所有其他格式(Google Docs、Google Sheets、幻灯片、Markdown 文件、TXT 文件和代码)仅在网页端受支持。 如下方视频所示,你现在可以让 Gemini 根据你上传的手写课堂笔记创建 PDF 学习指南,然后可以轻松手动编辑、选中特定部分让 Gemini 修改文本或视觉内容,甚至进一步提问。 这些功能现已向 Gemini 应用覆盖的所有语言的全部用户开放。 发布于:

    匹配字段正文

  3. ElevenLabs Blog

    ElevenLabs 发布音效模型 SFX v3,已在 ElevenCreative 和 ElevenAPI 上线

    ElevenLabs 发布新一代音效模型 SFX v3,已在 ElevenCreative 和 ElevenAPI 上线。官方称其在基准测试中比 SFX v2 更能可靠处理描述多种声音的提示词,音乐与人声生成更可信,锣、铃、哨声等音效的杂音更少。用户可在 Flows、Sound Effects 标签页、Studio 和 Music Editor 中通过文本提示词生成音效,开发者可通过 ElevenAPI 接入。

    Portrait of a young woman with long dark hair wearing a light blue top.

    隆重推出 Eleven v4,这是我们迄今为止最具情感表现力的模型。探索跳至内容登录注册联系销售登录 注册 宏大的场景很少只靠一种声音。一段足球视频可能需要人群欢呼、足球落地,以及几秒后同一群人的嘘声。在此之前,仅凭一个提示词获得所有这些声音需要反复试错。 在 ElevenCreative 和 ElevenAPI 中推出 SFX v3 SFX v3 是 ElevenLabs 最新的音效模型,正是为此而打造。它能更可靠地处理描述多种声音的提示词,更逼真地生成音乐和人声,并且在基准测试中比 SFX v2 生成更干净、更自然的音频。它现已在 ElevenCreative 中提供,并可通过 ElevenAPI 使用。 在 ElevenCreative 中,你可以在 Flows、Sound Effects 标签页、Studio 和 Music Editor 中通过文本提示词创建原创音效。 更好地处理单个提示词中的多种声音 SFX v3 更擅长遵循单个提示词中的多条指令。这意味着你所描述的更多声音会出现在生成的音频中。描述构成你场景的各种声音,听听它们如何协同呈现。 对于从事视频、游戏和其他项目的

    匹配字段正文

  4. 雷锋网

    蚂蚁灵光2.0打通钉钉、支付宝等数十项服务

    蚂蚁集团10月27日发布灵光2.0后,新版灵光已原生打通支付宝生态,并接入钉钉命令行接口(CLI)等数十项外部工具。以钉钉为例,用户授权后灵光可调用群聊、待办、日历、文档等能力,在后台汇总群聊重点、提取待办并跟进提醒。灵光2.0核心升级了跨会话记忆、长程任务调度与工具连接能力,并支持通过MCP、CLI等协议连接飞书、滴滴出行、高德地图、百度网盘、米家等应用。

    可持续管理复杂事务的“管事型”助手。 除钉钉外,灵光2.0目前还内置支付宝的账单、出行、会员等服务,并支持通过MCP、CLI等开放协议连接飞书、滴滴出行、高德地图、百度网盘、米家智能硬件及主流邮箱等数十款主流应用。从披露信息来看,灵光的应用范围正从个人信息管理延伸至家校沟通、工作协同、出行管理和智能家居等更多真实场景。 蚂蚁灵光2.0发布:从能聊会做,到记得住、盯得牢、办 ... 蚂蚁灵光圈上线!一句话生成应用;苹果宣布库克卸任 ... 中国AI应用跑出全球速度,灵光4天突破100万下载 京东采销员工发布谣言诋毁其他平台被起诉,法院已立案 从 Dreamore 到 CreaXene:AI 生成工具正在走向创作工作流 豆包工作新增画布功能,并接入豆包2.1 Lite模型 最新文章 阿里用速卖通把双11带到韩国,还豪送4辆特斯拉! 瞬恒智能自研灵巧操作人形机器人SynDexy C1首次实现小批量交付 抖音李亮发文:希望同行在阳光下竞争,专家自媒体要遵守基本道德规范 大数据 AR 视频监控 中科院 小鹏汽车 用户体验 互联网金融 工信部 创业者 陌陌 李飞飞 立即设置 以后再说 优路跟踪代码

    匹配字段正文

星期二

  1. 智东西

    Rokid发布全彩AI眼镜Rokid Color及二代Rokid Glasses 2,4999元起

    乐奇Rokid在10月27日杭州发布会上推出第二代AI眼镜Rokid Glasses 2、首款全彩AI眼镜Rokid Color和智能戒指Rokid Ring。Rokid Color起售价4999元,采用与JBD独家定制的0.16cc Micro-LED全彩光机,支持1677万色、色域167%sRGB,整机重55g;Rokid Glasses 2起售价3699元,国内首发高通骁龙AR1+平台并搭载恒玄BES2900BP双芯架构。Rokid还发布Rokid Prism连接器,可让AI眼镜调用Hermes、Codex等桌面智能体执行任务。

    AR+和6nm恒玄芯片,镜片中间“出戏”的彩虹纹等现象大幅减弱。 基于Rokid Prism技术,AI眼镜还可以连接所有的桌面智能体,包括Hermes、Codex、OpenCode、OpenClaw等,直接用眼镜“指挥”它们做事。 作为发布会的“One More Thing”,祝铭明登台亮出了Rokid Color,自家首款全彩AI眼镜。 AI眼镜终于可以看视频了,看股票终于不用“满眼绿油油”,所有App都进入彩色世界。 ▲看视频 ▲看股票 祝铭明特别提到,这一刻,Rokid等了12年,他自己从2012年的谷歌发布会至今等了15年,而身边大概有上千家供应链伙伴等了近20年。 在祝铭明看来,这是真正的“iPhone时刻”,智能眼镜正式进入新时代。 他进一步解读道:Rokid Glasses是一个“工具”,Rokid Color是一个“内容”。过去产业并未形成闭环,今天,AI眼镜产品形成了自己的闭环生态。未来其他所有设备产生的内容,会到AI眼镜上消费。Rokid会跟行业共同努力,让这件事在2-3年内发生。 为了解决交互问题,Rokid还发布了1699元的Rokid Color“乐奇魔戒”,

    匹配字段正文