Ollama 更新 MLX 引擎支持 NVFP4 格式
Ollama 更新 MLX 引擎支持 NVIDIA NVFP4 格式
English translation is being prepared.
匹配字段摘要
Ollama 更新 MLX 引擎支持 NVIDIA NVFP4 格式
English translation is being prepared.
匹配字段摘要
2026年6月4日,Prime Intellect 宣布其托管后训练平台 Lab 对 NVIDIA Nemotron 3 Ultra 提供 day-0 支持,可在 Blackwell B200/B300 上进行托管强化学习训练,配合 vLLM 推理、NCCL 权重广播和 Prime-RL 训练器。平台提供 Environments Hub 中 2,500+ 个开放 RL 环境,并支持 SWE-bench Verified、BrowseComp、τ2-Bench Telecom、Terminal-Bench Hard、IFBench、AA-LCR、GPQA Diamond、RULER-1M 等评测,以及 LoRA 与全权重适配器的一键推理。同日,Prime Intellect 还宣布加入 NVIDIA Nemotron 联盟,贡献 2,500+ 开源 RL 环境、verifiers 框架、Prime Sandbox 及 NeMo Gym 集成,以 Apache-2.0 / CC-BY-4.0 随 Nemotron 模型发布同步开源。此外,NVIDIA Nemotron 3 Ultra 同
匹配字段摘要
2026年5月7日,Prime Intellect宣布其训练平台Lab结束beta测试并正式开放。该平台面向自我改进智能体,将任务定义、harness、评测、奖励信号训练、rollout检查、adapter部署和推理整合到一处,以环境为基本单元。其中Hosted Training负责大规模强化学习,按token计费而非按集群小时计费。正式版首批支持来自NVIDIA、OpenAI、Meta和Qwen的14个模型,参数规模在1B到70B之间。据披露,beta期间已有数百名用户运行超过10,000次训练任务,训练完成的LoRA adapter可通过Prime Inference以OpenAI兼容API部署。
匹配字段摘要
2026年2月10日,Prime Intellect发布Lab全栈训练平台,将Environments Hub、Hosted Training和Hosted Evaluations整合为面向智能体后训练的平台,覆盖大规模智能体RL、推理与评测。平台以环境为核心,包含任务数据集、模型harness和评分rubric;当前Hosted Training支持基于prime-rl的LoRA智能体RL,后续将加入SFT、DPO等算法。私有测试期间已完成3000多次RL运行,Environments Hub累计有250多位创作者构建1000多个环境、下载量超过10万次。2026年3月16日,Prime Intellect公布与NVIDIA在开放超级智能栈上的合作细节:训练与推理负载运行在NVIDIA Blackwell及即将推出的Vera Rubin机架级系统上,并用NVIDIA Dynamo承担全球推理编排,支持LoRA服务与Arcee Trinity等大规模MoE推理;其沙盒基础设施适配Vera CPU,单路88核、SMT开启后176线程可稳定运行176台VM,真实RL沙盒负载下每CPU吞吐较
匹配字段摘要
2025年10月23日,vLLM宣布支持部署NVIDIA Nemotron开放模型家族,使其可在数据中心及端侧硬件上运行智能体推理。其中,Nemotron Nano 2采用混合Transformer–Mamba架构,并提供可配置的thinking budget,开发者可据此调节精度、吞吐量和成本。相关模型权重及超过9万亿tokens的训练数据已在Hugging Face提供。
匹配字段摘要
2025年8月5日,vLLM宣布新增对gpt-oss模型的支持,可在NVIDIA Blackwell、Hopper以及AMD MI300x、MI355x GPU上运行。为适配模型,其集成了面向MXFP4混合专家架构、高效注意力和混合KV缓存的专用内核与内存管理方案,并支持通过OpenAI Responses API、gpt-oss toolkit或外部MCP工具服务器进行工具调用。
匹配字段摘要
2025年1月27日,vLLM发布V1核心架构升级Alpha版,重构调度器、KV cache管理器、Worker、采样器和API服务器,吞吐量较V0最高提升至1.7倍。V1默认启用低开销前缀缓存,并增强多模态模型支持;用户可设置VLLM_USE_V1=1,在不修改现有API的情况下启用。目前该版本仅支持Ampere或更新的NVIDIA GPU,尚不支持LoRA、结构化解码、推测解码和流水线并行等功能。
2025年1月27日,vLLM发布V1核心架构升级Alpha版,重构调度器、KV cache管理器、Worker、采样器和API服务器,吞吐量较V0最高提升至1.7倍。V1默认启用低开销前缀缓存,并增强多模态模型支持;用户可设置VLLM USE V1=1,在不修改现有API的情况下启用。目前该版本仅支持Ampere或更新的NVIDIA GPU,尚不支持LoRA、结构化解码、推测解码和流水线并行等功能。
匹配字段摘要
Together AI 上线 NVIDIA Nemotron 3 Nano Omni
English translation is being prepared.
匹配字段摘要
2026 年 3 月 30 日,Ollama 发布预览版,在 Apple Silicon 上改用 Apple 的机器学习框架 MLX 驱动,利用统一内存架构加速,并在 M5、M5 Pro 和 M5 Max 上借助 GPU Neural Accelerators 提升首 token 时间与生成速度。据 Ollama Blog 介绍,测试于 2026 年 3 月 29 日使用阿里 Qwen3.5-35B-A3B 模型进行,Ollama 0.19 在 int4 量化下可达 1851 token/s prefill 和 134 token/s decode。该版本还引入 NVIDIA NVFP4 格式以降低内存带宽和存储需求,并升级缓存以复用跨对话缓存、在提示词中设置智能检查点并延长共享前缀存活时间,需 Mac 统一内存超过 32GB。目前尚无后续发展事实。
匹配字段摘要
2026 年 3 月 25 日,LMSYS 将 Elastic EP 集成进 SGLang 框架,为 DeepSeek MoE 部署提供部分故障容错。据 LMSYS Blog 介绍,该集成通过解耦专家与 GPU 的固定映射并保留冗余专家,实现单实例内的部分故障容错。在 4 节点 32 GPU 上运行 DeepSeek V3.2、设置 ep_size=dp_size=32 与 256 个冗余专家时,可容忍最多 16 个 rank 故障,服务中断控制在 10 秒以内,相比完整重启所需的 2 至 3 分钟减少约 90%,静态性能与标准 DeepEP 持平。启用需配置 --elastic-ep-backend mooncake、--moe-a2a-backend mooncake、--ep-num-redundant-experts 等参数,NVIDIA Dynamo 团队的 NIXL EP 也可通过 --moe-a2a-backend nixl 试用。目前尚无后续发展事实。
2026 年 3 月 25 日,LMSYS 将 Elastic EP 集成进 SGLang 框架,为 DeepSeek MoE 部署提供部分故障容错。据 LMSYS Blog 介绍,该集成通过解耦专家与 GPU 的固定映射并保留冗余专家,实现单实例内的部分故障容错。在 4 节点 32 GPU 上运行 DeepSeek V3.2、设置 ep size=dp size=32 与 256 个冗余专家时,可容忍最多 16 个 rank 故障,服务中断控制在 10 秒以内,相比完整重启所需的 2 至 3 分钟减少约 90%,静态性能与标准 DeepEP 持平。启用需配置 --elastic-ep-backend mooncake、--moe-a2a-backend mooncake、--ep-num-redundant-experts 等参数,NVIDIA Dynamo 团队的 NIXL EP 也可通过 --moe-a2a-backend nixl 试用。目前尚无后续发展事实。
匹配字段摘要
2024年2月15日,Ollama 在 Windows 上推出预览版,可在原生 Windows 环境中拉取、运行和创建大语言模型。据 Ollama Blog 发布的信息,该版本内置 GPU 加速,支持 NVIDIA GPU 以及 AVX、AVX2 等 CPU 指令集,无需配置或虚拟化;同时提供完整模型库(含 LLaVA 1.6 等视觉模型,图片可拖入 ollama run)和后台运行的 Ollama API(http://localhost:11434),并保持与其他平台一致的 OpenAI 兼容性。目前尚无后续发展事实。
匹配字段摘要
2023年10月5日,Ollama 成为 Docker 官方赞助的开源镜像,用户可在 Docker 容器中运行大语言模型,所有交互在本地完成,不向第三方服务发送私有数据。据 Ollama Blog 当日发布的信息,在 Linux 上,Ollama 可在容器内借助 Nvidia GPU 加速运行,需先安装 Nvidia container toolkit;在 Mac 上则需以独立应用方式运行,因为 Docker Desktop 不支持 GPU。容器内可直接运行 Llama 2 等模型,更多模型见 Ollama library。目前没有后续发展事实。
匹配字段摘要
Together AI 发布并集成 NVIDIA模型、智能体与语音AI能力
English translation is being prepared.
匹配字段摘要
Hao AI Lab 将 Pika Labs 开源的 MiniMax H3 Flex 接入 FastVideo,推理速度最高达到官方开源推理代码的 7 倍。在单张 GB200 上,同一提示词和随机种子生成 5 秒 480p 带音频视频,官方代码耗时 59.7 秒,FastVideo BF16 为 26.6 秒,NVFP4 QAD 为 16.8 秒,FP4 attention 为 15.2 秒。官方代码仅支持单 GPU,FastVideo 增加多 GPU 支持后,4 卡生成 15 秒视频提速 7 倍;单台 DGX Spark 生成 5 秒 480p 首尾帧视频耗时 59.5 秒。项目同时开放权重、推理代码和完整训练配方,并支持 Open-H3-Regenerate-2K 的 2K 模型。
(1/6) @pika labs 于上周晚些时候开源了 @MiniMax AI H3 Flex。今天它已接入 FastVideo,而且速度很快。 比官方开源推理代码最高快 7 倍 在单张 @NVIDIAAI GB200 上,5 秒 480p 视频 + 音频仅需 5.8 秒 开放权重 + 完整训练配方: FastVideo:https://t.co/Hiw9kaxfKq 权重:https://t.co/9qLFw5ArPm 博客:https://t.co/VmslrXQILD
匹配字段正文
Hao AI Lab 把 Pika Labs 开源的 MiniMax H3 Flex 接入 FastVideo,官方开源推理代码在单 GB200 上生成 5 秒 480p 带音频视频需 59.7 秒,FastVideo BF16 为 26.6 秒、NVFP4 QAD 为 16.8 秒、FP4 attention 为 15.2 秒。团队称其比官方代码快至多 7 倍,并补充了多 GPU 支持,4 卡生成 15 秒片段快 7 倍。NVFP4 QAD 对 BF16 Flex 做蒸馏,比普通量化更接近 BF16 14-17%;FP4 attention 把 768p 15 秒片段从 101.8 秒降到 85.3 秒。该片段在单台 DGX Spark 上耗时 59.5 秒,FastVideo 同时支持 Open-H3-Regenerate-2K 的 2K 模型,权重、推理代码和完整训练配方均已开放。
(4/6)在你的台式机上也能运行。一段 5 秒 480p 的首尾帧片段在单台 DGX Spark 上耗时 59.5 秒。从 Blackwell 到 Spark 再到 RTX 5090。@NVIDIARTXSpark
匹配字段正文
MiniMax 于 10 月 28 日以 MIT 协议开源 MCode Stack,包含其团队构建 MiniMax Code 所用的 17 个 SKILL.md 技能和 5 份清单,不含 MiniMax Code 源码。技能按规划拆分、上下文与工具、长会话与命令、评审、实验与热修分组,其中 independent-review 只向评审者提供 diff、需求和测试结果。可通过复制技能目录、本地插件或插件市场安装到 MiniMax Code,也能在 Claude Code 中用 /plugin marketplace add MiniMax-AI/mcode-stack 安装;原文未公布评测结果。
场安装到 MiniMax Code 或 Claude Code。 尚无已发布评测,因此应将其视为操作手册,而非证明。 Michal Sutter+ 文章简介 ⮌ Michal Sutter 是一位数据科学专业人士,拥有帕多瓦大学数据科学理学硕士学位。凭借在统计分析、机器学习和数据工程方面的扎实基础,Michal 擅长将复杂数据集转化为可付诸行动的洞见。 Michal SutterMirendil 发布其首个模型 Fern 0.1,具备 1000 万 token 上下文 $uv pip install omni-parse-bench✓文本✓表格✓布局→ 按页评分在 GitHub 上加星→赞助 相关文章更多来自作者 Baseten 发布 joey-1,一个每 100 万 token 收费 0.01 美元的 2B 决策模型 Prime Intellect 发布 Prime Mega MoE:可训练的融合 MoE 内核,前向传播速度提升 3.11 倍 NVIDIA 发布 Nemotron 3.5 Transcribe:一个面向 40 种语言转录的开放 30B MoE 模型,约 4B 活跃参数
匹配字段正文
AssemblyAI 发布首款文本转语音模型 AssemblyAI-TTS-1 并正式开放,面向实时电话语音智能体,定价为每 100 万字符 15 美元,不设年度合同和并发档位。该模型仅以托管 API 形式在 us-east-1 和 eu-north-1 提供,支持 HTTP、WebSocket 和 OpenAI 兼容接口,内置 4000 多种音色、即时声音克隆和 6 种语言。厂商自测显示实体准确率 93.7%、首字节中位延迟 47 ms,但 Cekura 独立基准测得流式延迟 159 ms、朗读准确率 81.5%,且发布时尚不支持 SSML、语速控制和情感标签。
得流式延迟 159 毫秒,朗读准确率 81.5%。 发布时缺失:SSML、语速控制、发音词典和情感标签。 Michal Sutter+ 发布 简介 ⮌ Michal Sutter 是一名数据科学专业人士,拥有帕多瓦大学数据科学理学硕士学位。凭借在统计分析、机器学习和数据工程方面的扎实基础,Michal 擅长将复杂数据集转化为可执行的洞察。 Michal SutterMirendil 发布其首个模型 Fern 0.1,支持 1000 万 token 上下文 $uv pip install omni-parse-bench✓文本✓表格✓布局→ 按页计分在 GitHub 上加星→赞助 相关文章更多来自作者 Baseten 发布 joey-1,一个 20 亿参数的决策模型,每 100 万 token 收费 0.01 美元 Prime Intellect 发布 Prime Mega MoE:可训练的融合 MoE 内核,前向传播快 3.11 倍 NVIDIA 发布 Nemotron 3.5 Transcribe:一个开放的 300 亿参数 MoE 模型,支持 40 种语言转录,约 40 亿活跃参数
匹配字段正文
Infini-AI-Lab 发布开源框架 Hermit,通过训练外部 harness 适配器来适配 AI 智能体,模型与 harness 保持冻结,v0.1.0 于 2026 年 10 月 25 日发布。框架为 Python 实现、Apache-2.0 许可,可用 pip install hermit-harness 安装,内置 GEPA、SkillOpt、MetaWorld Model、Harness² 和 Continual Harness 五种演化方法。在 GLM 5.3 Flash 上,MWM 适配器在 CL-Bench 数据库探索任务达到 0.795 准确率,高于 in-context 基线的 0.580,但多数结果为单次运行的自报数据。
适配器可部署到 Codex、Claude Code 和 Pi,或导出为插件。 结果均为自报,大多为单次运行,使用 GLM 5.3 Flash。 Asif Razzaq网站 | + 文章简介 ⮌ Asif RazzaqPrime Intellect 发布 Prime Mega MoE:可训练融合 MoE 内核,前向传播快 3.11 倍 Asif RazzaqNVIDIA 发布 Nemotron 3.5 Transcribe:一个开放的 30B MoE 模型,支持 40 种语言转录,约 4B 活跃参数 Asif RazzaqPolymathic AI 与普林斯顿大学研究人员发布 FlashMap,一种用于 LLM 解码提速 6.14 倍的流映射起草器 $uv pip install omni-parse-bench✓文本✓表格✓布局→ 按页评分在 GitHub 上加星→赞助 相关文章更多来自作者 Prime Intellect 发布 Prime Mega MoE:可训练融合 MoE 内核,前向传播快 3.11 倍 NVIDIA 发布 Nemotron 3.5 Transcribe:一个开
匹配字段正文
Prime Intellect 发布 Prime Mega MoE,在 DeepSeek 开源 DeepGEMM 库的 Mega MoE 内核基础上补上了融合且重叠的反向传播,使其可用于训练而非仅推理。在 prime-rl 训练器中,Qwen3 MoE 模型的完整训练步比基线快 32% 至 34%,比 TorchTitan 快 48% 至 55%;单层前向最高提速 3.11 倍(12.0 ms 降至 3.9 ms),但 Qwen3-235B-A22B 的反向仅提速 1.24 倍。该内核支持 BF16、Blackwell 上的 MXFP8 和 Hopper 上的 blockwise FP8,以 Apache 2.0 随 prime-rl 发布,通过 mega_moe 分发后端启用。
中,Qwen3 MoE 模型的完整训练步骤运行速度最高提升 34%。与 TorchTitan 相比,提升达到 55%。对于训练混合专家(MoE)模型的团队来说,这直接减少了 GPU 小时数。 TL;DR 规模:一个 GPU 内核,而非模型。在 Qwen3-30B-A3B 和 Qwen3-235B-A22B(128 个专家,top-8 路由)上测试。 运行于:NVIDIA Hopper(blockwise FP8)和 Blackwell(MXFP8)GPU,两者均支持 BF16。公布的数值使用 8×H200 节点,32 至 128 块 GPU。 性能:完整训练步骤比 prime-rl 基线快 32% 至 34%。比 TorchTitan 快 48% 至 55%。 最佳:在 Qwen3-30B-A3B MoE 层上前向传播快 3.11 倍(12.0 ms 降至 3.9 ms)。 最差:在 Qwen3-235B-A22B MoE 层上反向传播快 1.24 倍(30.5 ms 降至 24.6 ms)。 什么是 Prime Mega MoE? Prime Mega MoE 是 Prime Int
匹配字段正文
Together AI 介绍其 GPU 集群自动修复系统,已正式提供被动健康检查、修复建议、自动修复策略(含按故障和按节点授权)、等待空闲控制、升级阶梯、安全护栏以及 API 与控制台修复,基于节点标签的自定义检测接入仍为预览。系统分检测、决策、修复、复验四阶段,前三个阶段在用户集群内运行,复验在 Together 侧对腾出的物理机执行。平台按信号映射最轻修复动作,用户可决定是否自动执行及等待时长,同一故障同一动作重复两次后自动升一级。
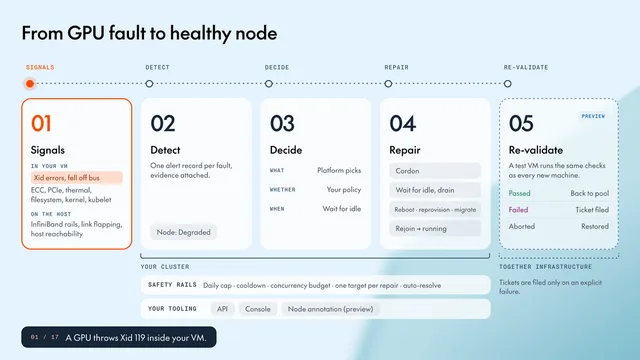
反复重启 在 Slurm 上,导出器会报告被标记为 DOWN 或 DRAIN 的节点。 在主机上, 我们监控 InfiniBand 通道状态和链路抖动,并将其归因于拥有这些通道的 VM。我们还监控主机可达性,因此死掉的主机会在您的节点上显示为问题,而不是一片沉默。 每个告警都附带稳定的摘要、通俗语言的描述和机器可读的证据载荷。对于 Xid,就是每个代码及其 NVIDIA 助记符。对于热降频,就是峰值温度和降频次数。控制平面原样传递这些字符串,因此控制台、API(作为 linked alerts)和您的通知始终表达相同的内容。 我们将观测与可操作区分开来。每个与修复相关的告警都会被记录,并将您的节点标记为 Degraded. 只有具有操作映射的信号才会创建修复。例如,磁盘压力会显示出来,但不会触发重启,因为重启无法解决它。没有映射的告警会被计数并记录,绝不会被静默丢弃,并会转交我们的支持团队进行调查。 2. 策略:我们决定做什么,您决定是否以及何时做 做什么 由平台负责。每个信号都映射到能修复它的最轻量操作,因此您无需知道哪个 Xid 意味着什么: 是否 由您决定。在“修复”选项卡中,
匹配字段正文