←搜索结果

按匹配度 · 共 1170 条结果 清除搜索

星期一

  1. 事件1 条新闻 · 1 个事实

    OpenHands 发布通过 ACP 接入编辑器的教程

    2025年12月9日,OpenHands 发布教程,介绍如何通过 Agent Client Protocol(ACP)在编辑器中配置并使用 OpenHands 代理。据 OpenHands 官方博客,ACP 是让编辑器与 AI 编码智能体通信的标准化 JSON-RPC 协议,智能体作为编辑器子进程运行;Zed、JetBrains 系列 IDE、Neovim(CodeCompanion.nvim)和 Obsidian 已支持该协议。教程以 Zed 为例给出配置步骤:先运行 openhands 配置 LLM 提供商与 API key,再在 Zed 的 agent_servers 中加入 OpenHands 配置,之后即可在编辑器内调用智能体。目前该故事尚无后续发展事实。

    2025年12月9日,OpenHands 发布教程,介绍如何通过 Agent Client Protocol(ACP)在编辑器中配置并使用 OpenHands 代理。据 OpenHands 官方博客,ACP 是让编辑器与 AI 编码智能体通信的标准化 JSON-RPC 协议,智能体作为编辑器子进程运行;Zed、JetBrains 系列 IDE、Neovim(CodeCompanion.nvim)和 Obsidian 已支持该协议。教程以 Zed 为例给出配置步骤:先运行 openhands 配置 LLM 提供商与 API key,再在 Zed 的 agent servers 中加入 OpenHands 配置,之后即可在编辑器内调用智能体。目前该故事尚无后续发展事实。

    匹配字段摘要
  2. 事件1 条新闻 · 1 个事实

    OpenHands 发布 Refactor SDK

    2025年10月9日,OpenHands 发布 Refactor SDK,用于借助 AI 智能体自动化大规模重构任务。据 OpenHands 官方博客介绍,该 SDK 提供任务拆解、修复与验证、进度追踪三类工具。其建议工作流为:先建立 v1-refactor 分支,并写入 AGENTS.md 或 .openhands/microagents/refactor.md 作为上下文;每个智能体从该分支拉出自己的分支,向 v1-refactor 提交 PR,经人工审查后再合并进 main。作者称这类任务通常只有 80-90% 可自动化,仍需理解项目全局的人参与,他目前同时管理约 5 个智能体。目前尚无后续发展事实。

    匹配字段摘要

  3. 事件1 条新闻 · 1 个事实

    Cognition 在 Devin 中上线 Claude Sonnet 4.5

    2025年9月29日,Cognition 宣布在 Devin 中上线 Claude Sonnet 4.5,并同步开放搭载该模型的 Devin Agent Preview,旧版 Devin 仍可使用。官方称这是自 Claude Sonnet 3.6 以来最大的一次跃升:规划性能提升 18%,端到端评测分数提升 12%,新版本速度提升 2 倍,在内部 Junior Developer Evals 上提升 12%,多小时的会话明显更快更可靠。Cognition 表示为 Sonnet 4.5 重构了 Devin,并记录了该模型的若干新行为,包括感知自身上下文窗口、主动写笔记外化状态、主动写脚本和测试构建反馈回路,以及并行执行工具调用,这些行为影响了 Devin 的上下文与记忆管理设计。Scott Wu 称 Sonnet 4.5 擅长测试自己写的代码,使 Devin 能运行更久、处理更难任务并更稳定地交付生产级代码。

    匹配字段摘要

星期日

  1. 事件1 条新闻 · 1 个事实

    Amp暂停免费模式后又取消训练数据要求

    2025年10月15日,Amp暂停了免费模式Amp Free,并表示目前无意恢复,但不排除未来重启的可能。暂停前,该模式已移除广告,支持包括Opus 4.5驱动的smart agent在内的完整Amp体验,用户也不再需要同意分享数据用于训练。10月24日,Amp又宣布Amp Free不再要求用户选择加入训练,程序员可将其作为免费编码智能体用于敏感的工作代码和个人项目。免费模式现在符合Amp付费smart模式的全部安全标准,已使用Amp Free的用户训练模式已被关闭。用户可通过安装或更新Amp后在CLI中使用/mode free,或在编辑器扩展中切换smart/free模式;工作区管理员可在设置中为成员启用或禁用Amp Free,默认启用,但Enterprise工作区暂不支持。

    匹配字段摘要

  2. 事件1 条新闻 · 1 个事实

    vLLM完善智能体训练接口

    2025年10月22日,vLLM官方博客介绍其从v0.10.2起在OpenAI兼容API中新增`return_token_ids`参数。启用后,接口可在返回文本的同时提供输入对应的`prompt_token_ids`和生成结果对应的`token_ids`,避免推理文本在训练阶段重新分词时产生不同的Token序列。Agent Lightning v0.2会自动启用该参数,并通过追踪能力收集训练所需数据。

    2025年10月22日,vLLM官方博客介绍其从v0.10.2起在OpenAI兼容API中新增 return token ids 参数。启用后,接口可在返回文本的同时提供输入对应的 prompt token ids 和生成结果对应的 token ids ,避免推理文本在训练阶段重新分词时产生不同的Token序列。Agent Lightning v0.2会自动启用该参数,并通过追踪能力收集训练所需数据。

    匹配字段摘要

星期三

  1. 事件1 条新闻 · 1 个事实

    Sarvam AI 发布全栈生成式 AI 平台

    2024年8月13日,Sarvam AI 发布全栈生成式 AI 平台,支持 10 种印度语言并具备语音能力。据其官方博客,该平台同时推出 Sarvam Agents、Sarvam 2B、Shuka 1.0 等产品:Sarvam Agents 可通过电话、WhatsApp 或应用内调用,语音智能体价格从每分钟 1 卢比起;Sarvam 2B 称是印度首个开源 2B 小规模 Indic LLM,基于 4 万亿 token 内部数据集从零训练;Shuka 1.0 为基于 Llama 8B 扩展的开源 AudioLM,支持印度语言语音输入与文本输出。目前尚无后续有证据的发展。

    匹配字段摘要

星期五

  1. NVIDIA Developer · Generative AI

    NVIDIA 开源 DSX OS 三组件,用于配置、认证与运维 Kubernetes GPU 集群

    NVIDIA 发布开源软件层 DSX OS,包含 AICR、NVCRE 和 NVSentinel 三个 Apache 2.0 项目,分别负责版本锁定的集群配置、基于 NCCL 与训练负载的就绪认证、以及持续健康监控与故障隔离修复。AICR 将配置渲染为 Argo CD、Flux、Helm 等部署工具的产物并支持漂移检测,NVCRE 通过二分定位可疑节点,NVSentinel 默认只上报节点状态、启用后可封锁、驱逐并修复故障节点。三者可串联成生命周期闭环,节点加入或修复后自动触发重新验证,通过后才解除调度限制。

    Glowing green modular cube with gauge, clock, and gear icons on a black background.

    s 文件中使用通用表达式语言(CEL)表达式: fault-quarantine: ruleSets: - enabled: true version: "1" name: "GPU fatal error ruleset" priority: 100 match: all: - kind: "HealthEvent" expression: "event.agent == 'gpu-health-monitor' && event.componentClass == 'GPU' && event.isFatal == true" - kind: "Node" expression: | !('k8saas.nvidia.com/ManagedByNVSentinel' in node.metadata.labels && node.metadata.labels['k8saas.nvidia.com/ManagedByNVSentinel'] == "false") cordon: shouldCordon: true taint: key: "nvidia.com/gpu-erro

    匹配字段正文

星期三

  1. Mastra Blog

    Mastra 为智能体推出 Knowledge 共享知识库

    Mastra 发布 Knowledge,为智能体提供按页面组织的共享文档库,可配合 signals 把相关知识带入上下文。Knowledge 按 org、resource、thread 三种 scope 控制读写权限,开启 tools 后智能体获得 knowledge_search、knowledge_list、knowledge_read、knowledge_page、knowledge_note 五个工具,可搜索、读取和写入页面。该功能需 @mastra/core@1.82.0 或更高版本,目前处于 alpha 阶段,API 可能随版本变化。

    Paul Scanlon

    ledge"; export const companyKnowledge = new Knowledge({ id: "company-knowledge", scopes: { ...knowledgeMemoryScopes() }, tools: true }); 给 Knowledge 实例,使用 knowledge 选项: src/mastra/agents/company-agent.ts import { Agent } from "@mastra/core/agent"; import { companyKnowledge } from "../knowledge/company-knowledge"; export const companyAgent = new Agent({ id: "company-agent", name: "Company Agent", instructions: / ... /, model: / ... /, knowledge: companyKnowledge }); 在你的 Mastra 实例上注册该智能体和 Knowledg

    匹配字段正文

  2. Together AI Blog

    Together AI 发布 Together Compiler,用智能体持续编译优化推理

    Together AI 发布 Together Compiler(TKCC),一个用高吞吐智能体持续优化推理负载的编译系统,在不到 24 小时内于 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等前沿开源模型上实现最高 2.6x 的 TPS 提升。它在 SemiAnalysis 的 InferenceX 低延迟基准上取得 MiniMax M3.1-Flash 1111 TPS、DeepSeek v4.1-Flash 1205 TPS 的当前最好成绩,并在 Llama 1B batch size 1 场景比开源 megakernel 高 1.7x。TKCC 依靠持久化引擎热加载候选前向计算和快慢两级引擎平衡吞吐与保真度,实验吞吐比基线智能体优化系统高 252x,目前已用于服务每天数万亿 token。

    rnel 工作负载:batch size 为 1 的 Llama 1B。该模型架构已被人类专家和传统机器学习编译器充分优化。TKCC 生成的 TPS 高出 1.7 倍,并且随着序列长度增加仍保持优势。 图 5:Together Compiler 在 H100 和 B200 上均优于 megakernel 和 CUDA graph 基线 InferenceX AgentX 工作负载 我们在 SemiAnalysis 的 AgentX 基准上评估 TKCC。我们从各推理引擎和硬件平台上前沿模型已报告的最佳开源引擎配置出发。TKCC 在所有设置下都持续刷新性能前沿,TPS 最高比高度优化的基线高出 2.6 倍。1 我们还专门评估了 batch size 为 1 的低延迟用例,并在 MiniMax M3.1-Flash 上达到 1111 TPS、在 DeepSeek v4.1-Flash 上达到 1205 TPS 的最先进性能。在这些结果中,我们使用成本模型来选择并行配置,而非使用 InferenceX 配置。我们观察到这种方法带来了加速。 图 6:在大多数模型上,Together Compi

    匹配字段正文

  3. Together AI Blog精选

    Together AI 发布 Together Compiler,推理吞吐提升 1.3-3 倍

    Together AI 发布 Together Compiler(TKCC),用高吞吐智能体持续为不同流量形态、模型和硬件生成推理优化。官方称其在不到 24 小时内于 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 上实现 1.3-3 倍 TPS 提升,并在 SemiAnalysis 的 InferenceX 低延迟基准上以 MiniMax M3.1-Flash 1111 TPS、DeepSeek v4.1-Flash 1205 TPS 取得 SOTA。该系统采用常驻引擎与快慢两级引擎平衡实验吞吐和测量保真度,实验吞吐比基线智能体系统高 252 倍,目前已用于线上服务。

    的 MegaKernel 工作负载:批大小为 1 的 Llama 1B。该模型架构已被人类专家和传统机器学习编译器充分优化。TKCC 生成的 TPS 高出 1.7 倍,并且随着序列长度增加仍保持性能。 图 5:Together Compiler 在 H100 和 B200 上均优于 megakernel 和 CUDA graph 基线 InferenceX AgentX 工作负载 我们在 SemiAnalysis 的 AgentX 基准上评估 TKCC。我们从各推理引擎和硬件平台上前沿模型已报告的最佳开源引擎配置出发。TKCC 在所有设置下都持续刷新性能前沿,以高出 1.3-3 倍的 TPS 超越高度优化的基线。1 我们还专门评估了批大小为 1 的低延迟用例,并在 MiniMax M3.1-Flash 上以 1111 TPS、在 DeepSeek v4.1-Flash 上以 1205 TPS 达到最先进性能。对于这些结果,我们使用成本模型来选择并行配置,而非使用 InferenceX 配置。我们观察到这种方法带来了加速。 图 6:在大多数模型上,Together Compiler 在相

    匹配字段正文

星期二

  1. NVIDIA Developer · Generative AI精选

    NVIDIA 发布 Cosmos Framework 与 Cosmos NIM,支持世界模型训练与部署

    NVIDIA 发布面向物理 AI 的 Cosmos Framework 和 Cosmos NIM,前者提供训练、强化学习、优化与推理的模块化工具和智能体技能,后者以容器形式提供加速推理服务。Cosmos 3 Nano 仿真配方可从已发布 checkpoint 生成同步的相机视频与 LiDAR 观测,覆盖自动驾驶、机器人和手术场景。NIM 通过量化、投机解码和 KV-cache 感知路由,在 H200 上实测约 2–3 倍加速,Cosmos3-Nano 生成任务在 BF16 下需 58 GiB 显存。

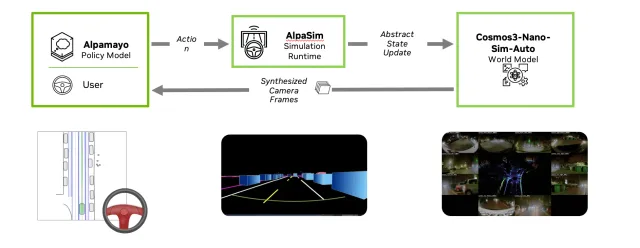
    A policy model (e.g., Alpamayo) or user sends an action to the AlpaSim simulation runtime. AlpaSim updates the simulation state and forwards the context to Cosmos3-Nano-Sim-Auto, which synthesizes the next camera frames and returns them to the policy, completing the loop.

    ng、vLLM-Omni、vLLM、TRT-LLM 和 TRT-Edge-LLM 或 NVIDIA NIM 运行兼容的检查点。 评估质量、准确性和 GPU 使用情况,并最大化计算利用率。 使用 Cosmos Framework 的智能体 在以下位置加载 setup、inference、post-training 和 troubleshooting 技能: .agents/skills给智能体一个有界任务: 提示:训练后 使用 使用 固定所有修订版本,验证数据集,并将训练与评估回合分开。运行冒烟测试,保存配置,并在“ GPU 小时数。使用三个随机种子在留出数据上导出并与基础模型进行比较。在受支持的较低精度下重复评估;记录质量、峰值内存和延迟。 你应该使用哪种 Cosmos 仿真工作流? Cosmos Framework 为机器人仿真、逼真场景生成、多摄像头驾驶仿真以及手术策略评估提供后训练与推理配方。全新的 Cosmos 3 Nano 仿真配方和示例检查点使开发者能够使用智能体可运行的技能来评估我们的示例检查点,并将 Cosmos 3 Nano 适配到自定义传感器、动作空间和数据领域。

    匹配字段正文

星期五

  1. VR陀螺

    极米记得开售 AI 记忆眼镜 G1 与记忆手环 L1,599 元起

    极米记得 AI 记忆眼镜 G1 与 AI 记忆手环 L1 于 10 月 28 日正式开售,手环 L1 标准版售价 599 元,眼镜 G1 标准版首发价 1299 元。两款设备共用极米记得 App 与同一套 AI 记忆服务,开机即录,可将日常交流转写并自动生成会议纪要、待办事项和生活卡片。数据管理上采用只留文字不留原音的方式,语音转写完成后删除原始音频,并支持设置免录时段和隐私禁词。

    AI整理结合起来,让日常交流中的信息更容易被留下,也减少了事后回听和整理的负担。 这也让它的产品思路更加清晰。通过不同的硬件形态适应用户的佩戴习惯,再由同一套软件服务,将零散的对话整理成可供回顾和调用的个人记忆。用户是否愿意长期使用,既取决于设备戴起来是否舒服,也取决于留下的内容能否在需要时派上用场。 从这个角度来看,极米记得的尝试,也为AI可穿戴设备向个人Agent演进提供了一条路径。随着记忆不断积累,AI有望结合过去的交流理解当下需求,进一步参与任务跟进与日常安排。而如何将持续记录转化为准确、适时的帮助,将是这类产品接下来需要验证的能力。 投稿/爆料:tougao@youxituoluo.com 稿件/商务合作: 林南(微信 19250561593) 加入行业交流群:林南(微信 19250561593) 版权申明:本文为VR陀螺原创,任何第三方未经授权不得转载。如需转载请联系微信:vrtuoluo233 申请授权,并在转载时保留转载来源、作者以及原文链接信息,不得擅自更改内容,违规转载法律必究。文中有图片、视频素材来自互联网或无法核实出处,如涉及版权问题,请联系本网站协商处理。 数

    匹配字段正文

星期四

  1. 阿易 AI Notes

    Grok Bot 本周更新:新增 Pages、Vault 与 1Password 联动

    Grok Bot 本周更新了多项功能,包括可直接生成可编辑报告页和仪表盘的 Pages、存放登录与银行卡信息的 Vault,以及与 1Password 的联动。Vault 与 1Password 的设计是让 Bot 代填登录和结账信息,但 Bot 本身看不到密码和卡号。此外还加入了手机 App 授权(日历、通讯录、位置、闹钟,iPhone 上可管理提醒事项和控制 Home 灯光)、根据描述或图片生成视频、新 Bot 角色和 X Spaces 等。

    Damn,Grok Bot 这周一口气更新了啥?4000万人围观,太炸裂了! 我觉得这次 Grok Bot 的更新就是 Agent 落地的真正分水岭, 我把 bot产品经理@mattyp 的 7 分多钟官方更新视频剪成 了3 分钟精华版,加了中英双语字👇 Vault 加上 1Password 联动,解决了行业最大的死穴:让 AI 替你自动登录结账,但严禁它看到你的密码和卡号。 这才是真正的个人特种助理。 再也不用给手机下载一堆互不相通的 App 了,底层逻辑已经被马斯克连根拔起, 当 Grok Bot 能直接穿透日历、通讯录并代填密码时,传统软件引以为傲的入口优势,一夜之间全成了摆设。 1️⃣ Pages:让 Bot 直接生成可编辑的报告页、仪表盘,还能分享给团队(灵感来自 Cursor Canvases) 2️⃣ Vault:存登录、银行卡、联系方式,Bot 代填时看不到密码和卡号 3️⃣ 1Password:每次登录你在 1Password 里批准,由它代填 4️⃣ 手机 App 授权:日历、通讯录、位置、闹钟;iPhone 上还能管提醒事项、控制 Home 的灯 5️⃣ Bot

    匹配字段正文

  2. gihyo.jp

    Entire 推出私有仓库免费托管,并加入 AI 评审与跨会话记忆

    Entire 于 2026 年 10 月 26 日为其人机协作开发平台新增私有仓库免费直接托管功能,用户无需在 GitHub 保留原始仓库即可使用。平台还提供智能体代码评审,以及让新会话的 AI 智能体参考此前会话中确定方针的 Continuous Memory 功能;托管免费,仅按智能体调用 AI 模型的用量计费。配套的 EntireDB 按地域保存仓库完整副本以分散读取压力,计划数月内开源。

    体则根据AI模型的使用量计费。 联合创始人兼CEO Thomas Dohmke在配合发布的X帖子中表示,智能体改变了代码的编写方式,开发工具和工作流程有一半随之改变,剩下的一半也到了该跟上步伐的时候。在后续帖子中,他介绍了Git托管的去中心化、智能体之间共享会话记录,以及将评审结果用于下一次修改的机制。他还表示,Entire自身的开发也使用了Entire。 Agents reinvented how we produce code. It changed our tools and half of our workflow. It’s time for the other half to catch up. Today, we’re shipping Entire: the Git forge for agent-human collaboration. We’ve built @GoEntire using Entire. Now we want to see what you'll build with it. Here’s why and what’s different. 🧵—

    匹配字段正文

  3. Factory 研究 / 产品精选

    Factory 发布 Droid 1.0 智能体框架,默认启用程序化工具调用

    Factory 发布 Droid 1.0,这是其智能体框架迄今最大的一次更新,默认启用程序化工具调用(PTC),让模型写 JavaScript 脚本在沙箱中一次请求内执行数百次工具调用。在 Terminal-Bench 4 上,搭配 GPT-6.1 Sol 时 Droid 比 Codex 高 3.5 分且成本低 12%,搭配 Claude Opus 5.5 时比 Cursor、OpenCode、Devin、Claude Code 高 3.0 至 7.6 分,成本最多低 24%。Droid 1.0 今日开放 macOS 和 Windows 桌面版与终端 UI,并提供 Droid SDK(@factory/droid-sdk)。

    们的用户可以选择市场上最好的模型,也可以让 Droid 通过我们的自动模型路由器 Factory Router 选择最高效的模型组合。 构建一个针对多种模型优化的框架,会让框架本身变得更好。当你只针对单一模型进行调优时,很难将真正的进步与对该模型特性的适配区分开来。跨模型工作能确保最强的改进具有泛化能力,并在启发这些改进的模型之外依然成立。 这就是我们内部 Agent Factory 背后的理念。智能体会研究基准测试中的失败案例,以及用户在实际会话中遇到的摩擦,提出改动建议,并在其影响的每一个模型家族上逐一测试。我们的工程师审查证据,并决定哪些改动上线。 最终成果是市场上最高效、面向企业就绪的编码智能体,针对每一种前沿模型进行了调优,无论其权重是开放还是闭源。 本文余下部分将介绍正面对比结果、框架背后的设计原则、我们如何构建内部 Agent Factory,以及带来最大影响的核心改动。 市场上最高效的框架 在相同任务、相同模型下,Droid 的得分更高、成本更低,优于我们测试过的所有其他框架。 图 1 Terminal-Bench 4GPT-6.1 Sol 未展示 Cursor:它无法

    匹配字段正文

  4. MarkTechPost

    Infini-AI-Lab 开源 Hermit harness 适配器框架

    Infini-AI-Lab 发布开源框架 Hermit,通过训练外部 harness 适配器来适配 AI 智能体,模型与 harness 保持冻结,v0.1.0 于 2026 年 10 月 25 日发布。框架为 Python 实现、Apache-2.0 许可,可用 pip install hermit-harness 安装,内置 GEPA、SkillOpt、MetaWorld Model、Harness² 和 Continual Harness 五种演化方法。在 GLM 5.3 Flash 上,MWM 适配器在 CL-Bench 数据库探索任务达到 0.795 准确率,高于 in-context 基线的 0.580,但多数结果为单次运行的自报数据。

    in-context 学习为 2.51。 ServeLearnBench(recipe)在隐藏且不断变化的策略下流式处理 624 个零售支持请求。MWM 在隐藏策略测试上得分为 45.3。排行榜上最佳学习方法 CH 得分为 28.7。获得策略信息的 oracle 得分为 89.2。 Hermit 与其他智能体优化器相比如何? 特性HermitGEPAACEAgent Lightning 训练对象外部 harness 适配器任意文本参数(提示词、代码)上下文 playbook提示词和模型权重 是否改变模型权重否否未披露是,通过 RL 或 SFT 方法内置 5 种,可自定义 Evolver反思式演化、Pareto 选择Generator、Reflector、CuratorRL、提示词优化、SFT 部署目标Codex、Claude Code、Pi;插件导出DSPy(dspy.GEPA)未披露LangChain、OpenAI Agents SDK、AutoGen、CrewAI 等 许可证Apache-2.0MITApache-2.0MIT 关键结果CL-Bench 数据库 0.795(自报)

    匹配字段正文

  5. 雷锋网

    TRAE 上线开发者个人助理 TRAE宝,引入全局与项目双层助理

    AI 开发产品 TRAE 于 10 月 29 日正式上线开发者个人助理 TRAE宝,把全局助理加项目助理的双层助理体系引入开发工作流。全局助理可读取开发者过往任务、对话与产物,在新任务中自动补齐项目背景与历史决策,并支持绑定飞书、微信等即时通讯工具下发任务和同步进度。项目助理则基于当前项目上下文把复杂需求拆成多个子任务并行推进、联调与汇总。当前版本仅支持本地任务,云端任务与移动端能力将在后续迭代开放。

    顶栏广告位 您正在使用IE低版浏览器,为了您的雷峰网账号安全和更好的产品体验,强烈建议使用更快更安全的浏览器 导语:10月29日,AI开发产品TRAE正式上线开发者个人助理“TRAE宝”,将“全局助理+项目助理”双层助理体系引入开发工作流。 10月29日,AI开发产品TRAE正式上线开发者个人助理“TRAE宝”。与此前围绕单次任务展开的Agent对话不同,TRAE宝将双层助理体系引入开发工作流,让 AI 持续理解开发者长期积累的项目、任务与决策,而非仅响应当前的某一条指令。 长期以来,用户在AI开发过程中的时间消耗不仅在于写代码本身,而且大量花费在项目拆解、任务分派以及多个会话之间的来回切换。新任务启动时,开发者需要向 AI 重新交代项目背景、技术栈与历史决策;需求进入复杂阶段后,又要自行拆解任务、切换会话、追踪进度,再将结果拼装为完整方案。 TRAE宝采用“全局助理 + 项目助理”的双层架构,分别对应上述两类场景。“全局助理”承担跨项目的记忆与统筹,可读取开发者过往的任务、对话与产物,主动梳理其中可复用的方案与约束。开启新任务时,开发者只需陈述目标,助理即可从历史项目中定位相关经验,

    匹配字段正文

星期三

  1. 卡尔的 AI 沃茨

    豆包工作上线录制回放功能,支持边操作边讲解最长 30 分钟

    豆包工作上线录制回放(record & replay)功能,可把电脑操作过程录下来交给 AI 生成步骤说明并复刻,类似简化版 RPA。相比 Codex 同类能力,它额外支持边操作边讲解,最长录制 30 分钟,处理时优先转换音频。作者实测用它做跨平台内容采集、公众号排版发布等任务,并指出执行中若占用同一窗口任务会主动暂停,同时打开多个网页则不受影响。

    要用对应的这个窗口的话,它是会主动断掉的。 拿我在 Codex 上的经验说。经常会遇到我开了一个对话,那个对话要用我的浏览器,但我同时又想开另一个对话,两边就冲突了。操作软件的时候特别明显,浏览器其实还好,可以通过其他 Skill 绕开。 我说具体一些。 比方说我要用 Codex 操控 Grok,同样的环境给我出个日报。但因为我同时在录视频,或者在跟另一个 Agent 对话,它弹出来的页面就会打断我。我不断最小化 gpt 不断重试,很多时候就是因为反复切界面导致操作失败。 所以暂停和重试这两种机制,我觉得有好有坏。如果让我选的话,本机,就是我自己用的电脑,我希望有自动暂停的机制,因为不会打断我主要的工作。但如果是在远程的 Mac mini 上跑,重试更好,反正不挡我。 上次文章里,我没有写这个录制回放技能会跟已有的 Computer Use,Browser Use(浏览器自动化)去搭配使用。像豆包,它其实会先返回说目前的状态是什么,然后给出后续的行动。 那下一步,最好的做法就是让它去做巡检。 我刻意强调巡检这两个词,是因为以前我可能会说每隔 5 分钟,10 分钟去检查一遍。但其实很多时

    匹配字段正文

  2. 智东西

    天数智芯首次实机演示天垓300与端侧终端TY1200

    天数智芯首次实机演示通用GPU天垓300和端侧算力终端TY1200,并预告标称算力600T的下一代端侧产品TY2000。天垓300有144GB显存,在64K长上下文下Attention性能为H200的1.05倍,GLM-5.3模型下MoE吞吐为H200的1.15倍;TY1200为300 TOPS INT8稠密算力,实测TPS超越英伟达Thor T5000。天垓300 IXL144超节点在单机柜集成144颗GPU、聚合约10.1TB显存,每百万有效Token成本较国际主流方案降低约40%。

    芯片间高速互联,搭载新一代Tensor Core,支持FP4、FP8、FP16、BF16等数据精度。 天数智芯性能实验室的实测显示,在64K长上下文下,天垓300的Attention性能为H200的1.05倍。 GLM-5.3模型64K规模下,在保障同等用户体验的同时,天垓300 MoE吞吐为H200的1.15倍。 8K至128K长上下文场景下,天垓300的Agent首字延迟较H200降低约10%—30%;多模态生成推理吞吐,天垓300相较H200提升约2%—5%;在搜广推等在线业务中,推荐推理吞吐提升21%、轻量计算时延降低26%。 训练方面,在基于Qwen3-32B模型的8卡整机FP8精度训练演示中,天垓300每卡有效吞吐达到H100的1.33倍。 强化学习已成为OpenAI、Google、Meta、xAI以及DeepSeek、Qwen、MiniMax、Kimi等国内外主力模型公开采用的核心后训练路线。据条件性工程估算,天垓300以1024张卡对已有预训练基座开展一次强化学习,在40B激活参数的中心情景下,约26天可完成约1T总参数MoE模型的500亿生成Token强化学习任务。

    匹配字段正文

  3. NVIDIA Blog

    NVIDIA RTX Spark 笔记本更新:新增 Nemotron 3.5 Transcribe 与本地智能体工具

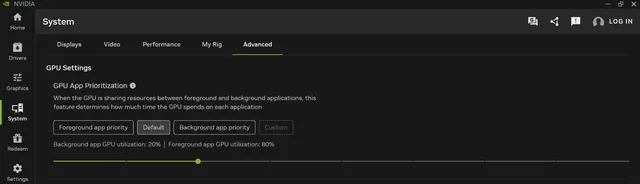
    NVIDIA 公布 RTX Spark 轻薄笔记本的多项更新,包括开放权重语音模型 Nemotron 3.5 Transcribe、Liquid AI 的 LFM3 模型家族支持,以及 NVIDIA App 中可在前台应用与后台智能体之间分配 GPU 资源的控制项。Nemotron 3.5 Transcribe 支持 40 种语言的转写、说话人标注和翻译,约 43 亿活跃参数,已在 Hugging Face 上线。RTX Spark 笔记本现由 ASUS、Dell、HP、Lenovo、Microsoft 和 MSI 出货,起售价 2599 美元。

    模型家族,多种工作方式 Liquid AI 的 LFM3 提供新一代专为特定任务设计的液态基础模型。该系列基于同一共享主干构建,涵盖文本、视觉、音频、全模态和决策模型,基础模型与后训练模型均以开放权重形式提供。这些模型紧凑且快速:Liquid AI 全新的17亿参数基础模型性能超越了其此前26亿参数的基础模型。 这些模型支持本地工作流,例如在 Hermes Agent、Pi 和 OpenClaw 中运行的智能体,可用于分拣收件箱和管理日历、读取文档与应用界面、转写和翻译语音、回答关于手写数学的口头提问,以及转派支持工单或语音请求。 开发者可以在 RTX Spark 上运行 LFM3 模型,通过 llama.cpp 和 vLLM 获得原生支持,并在本地对模型进行微调。 《影之刃零》携 DLSS 4.5 上线 S-GAME 的 《影之刃零》 将于今晚,即10月28日太平洋时间晚上7点,在 Steam 以及 Epic Games Store玩家可以扮演 Soul,一名被诬陷杀害师父的剑客,他行走江湖,揭开一场阴谋。 NVIDIA 与 S-GAME Studio 和 S-GAME Publis

    匹配字段正文