←搜索结果

按匹配度 · 共 512 条结果 清除搜索

星期五

  1. goose 官方博客精选

    goose 桌面端内置基于 llama.cpp 的本地推理模型

    goose 在桌面应用中内置了由 llama.cpp 驱动的本地推理,选择 Local provider 后可直接从 Hugging Face 下载量化 GGUF 模型并在本机运行,无需 Ollama、Docker 或外部服务器,也无需 API key,可离线使用。官方说明本地模型首次请求需 30–120 秒加载,上下文多为 4K–8K token,工具调用是最大短板,Gemma 4 表现较好而模拟模式仅限 shell 命令;建议从小模型起步并使用 Code Mode。
    blog cover

    匹配字段标题、摘要

星期三

  1. Together AI Blog精选

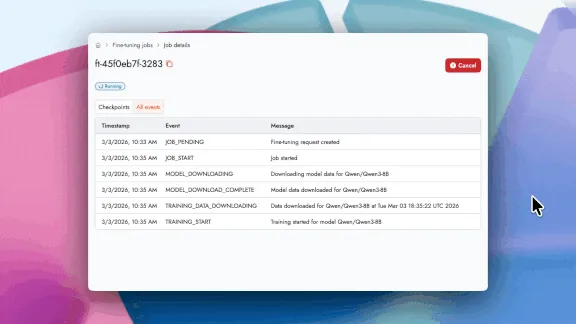
    Together AI 扩展微调服务,支持工具调用、推理和视觉

    Together AI 扩展 Together Fine-Tuning,新增工具调用、推理轨迹和视觉语言模型微调支持。升级后的训练栈可更高效处理 100B+ 参数模型,吞吐量最高提升 6×,并支持最大 100GB 的数据集。服务还新增训练前成本估算和训练中 ETA;推理微调支持 Qwen 与 Z.AI,VLM 微调支持 Qwen、Google 和 Meta 模型。

    Screen showing fine-tuning job details with timestamps, events like JOB_PENDING, MODEL_DOWNLOAD, and messages.

    匹配字段标题、摘要

星期三

  1. LMSYS Blog精选

    SGLang 首日支持 NVIDIA Nemotron 3 Super,面向多智能体系统推理

    SGLang 宣布在发布当天支持 NVIDIA Nemotron 3 Super,并给出安装与推理部署步骤。Nemotron 3 Super 是 120B 参数的混合 MoE 模型,每次前向仅激活 12B 参数,支持 1M token 上下文,官方称其吞吐效率最高可达上一代 Nemotron Super(Llama Nemotron Super 1.5)的 5 倍,并支持 Multi-Token Prediction 与 Thinking Budget。模型权重已在 Hugging Face 提供 BF16、FP8 和 NVFP4 版本,可配合 SGLang 在 4xH200 等配置上部署。

    匹配字段标题、摘要

星期三

  1. Browser Use

    Browser Use 发布 0.8.0 与 ChatBrowserUse 网关,推理延迟降低 6 倍

    Browser Use 发布 0.8.0,推出 ChatBrowserUse 网关,称在保持相同性能的前提下把延迟降低 6 倍,智能体可达每分钟 20 步。官方称 BU 1.0 准确率约 65%,与 Claude Sonnet 4、Claude Sonnet 4.5、Gemini 2.5 Computer Use、OpenAI Computer-Using Model 等计算机使用模型相当,但速度快 4 倍,单条轨迹纯 LLM 推理时间约 68 秒,其他模型约 225 至 330 秒。使用时只需配置 BROWSER_USE_API_KEY 一个环境变量即可接入。

    匹配字段标题、摘要

星期四

  1. vLLM 官方博客

    vLLM Semantic Router 推进 LLM 智能推理路由

    vLLM Semantic Router 为 vLLM 推理引擎提供开源的意图感知路由层,按查询复杂度选择快速路径或 CoT 推理模式。试验中,该设计使准确率提高约 10%、延迟降低约 50%、token 减少约 50%,并支持通过 Kubernetes 和 Envoy 部署。v0.1 路线图包括语义缓存、多因素路由、性能测试和路由策略可视化。

    匹配字段标题、摘要

星期四

星期一

  1. Prime Intellect

    Prime Intellect 开源分布式推理栈,面向消费级 GPU 与公网高延迟

    Prime Intellect 发布分布式推理栈预览,并开源 PRIME-IROH、PRIME-VLLM、PRIME-PIPELINE 三个代码库,目标是让消费级 GPU 通过公网连接运行推理。文章指出流水线并行通信需求最低,适合分布式环境,但同步流水线会因 100ms 级跨洲延迟形成吞吐上限,而异步微批调度在内存带宽受限的解码阶段无法带来训练那样的加速。团队称已可用私有硬件通过公网跑推理,正把组件接入自家栈,用于 SYNTHETIC-2 合成数据运行。

    匹配字段标题、摘要

星期五

星期二

  1. vLLM 官方博客精选

    vLLM 发布面向 Kubernetes 的开源推理栈 production-stack

    vLLM 与 LMCache 团队发布开源参考实现 vLLM production-stack,将单节点 vLLM 扩展为可在 GPU 集群运行的完整推理服务。它支持 KV cache 共享与存储、前缀感知路由、TTFT 和 TBT 等指标观测及自动扩缩容,并可通过 Helm chart 部署到 Kubernetes。多轮问答基准结果显示,该方案在首个 token 延迟和 token 间延迟方面优于 vLLM + KServe 与一个商业端点服务。

    匹配字段标题、摘要

星期二

星期三

  1. UCSD Hao AI Lab

    Hao AI Lab 将 MiniMax H3 Flex 接入 FastVideo,单卡…

    Hao AI Lab 把 Pika 开源的 MiniMax H3 Flex 接入 FastVideo,在单张 GB200 上生成 5 秒带音频片段,官方代码耗时 59.7 秒,FastVideo BF16 为 26.6 秒,NVFP4 QAD 为 16.8 秒,FP4 attention 为 15.2 秒。官方代码只支持单 GPU,FastVideo 增加了多 GPU 支持,4 卡生成 15 秒片段快 7 倍。NVFP4 QAD 通过向 BF16 Flex 蒸馏,比普通量化更接近 BF16 14-17%;FP4 attention 把 768p 15 秒片段从 101.8 秒降到 85.3 秒。项目同时支持在 DGX Spark 上运行,5 秒 480p 首尾帧片段耗时 59.5 秒,并支持 Open-H3-Regenerate-2K 的 2K 模型,开放权重、推理代码和完整训练配方。

    匹配字段摘要

  2. UCSD Hao AI Lab精选

    Hao AI Lab 将 MiniMax H3 Flex 接入 FastVideo,单…

    Hao AI Lab 把 Pika Labs 开源的 MiniMax H3 Flex 接入 FastVideo,官方开源推理代码在单 GB200 上生成 5 秒 480p 带音频视频需 59.7 秒,FastVideo BF16 为 26.6 秒、NVFP4 QAD 为 16.8 秒、FP4 attention 为 15.2 秒。团队称其比官方代码快至多 7 倍,并补充了多 GPU 支持,4 卡生成 15 秒片段快 7 倍。NVFP4 QAD 对 BF16 Flex 做蒸馏,比普通量化更接近 BF16 14-17%;FP4 attention 把 768p 15 秒片段从 101.8 秒降到 85.3 秒。该片段在单台 DGX Spark 上耗时 59.5 秒,FastVideo 同时支持 Open-H3-Regenerate-2K 的 2K 模型,权重、推理代码和完整训练配方均已开放。

    匹配字段摘要

  3. UCSD Hao AI Lab精选

    FastVideo 支持 Open-H3-Regenerate-2K 模型

    Hao AI Lab 宣布 FastVideo 已支持来自 HaoZhe65347 与 NVIDIA AI 的 Open-H3-Regenerate-2K 模型,并给出 2K 模型链接。该系列此前介绍 FastVideo 对 Pika Labs 开源的 MiniMax H3 Flex 做了推理优化,单张 GB200 上 5 秒 480p 带音频视频耗时 5.8 秒,比官方开源推理代码快至多 7 倍,并新增多 GPU 支持。

    匹配字段摘要

  4. UCSD Hao AI Lab精选

    Hao AI Lab 将 MiniMax H3 Flex 接入 FastVideo,单卡…

    Hao AI Lab 宣布 Pika Labs 开源的 MiniMax H3 Flex 已接入 FastVideo,官方称其推理速度最高比官方开源推理代码快 7 倍,在单张 NVIDIA GB200 上生成 5 秒 480p 带音频视频耗时 5.8 秒。同一提示词与随机种子下,5 秒带音频片段官方代码耗时 59.7 秒,FastVideo BF16 为 26.6 秒,NVFP4 QAD 为 16.8 秒,FP4 attention 为 15.2 秒;官方代码仅支持单 GPU,FastVideo 增加了多 GPU 支持,15 秒片段在 4 张 GPU 上快 7 倍。NVFP4 QAD 以 BF16 Flex 为蒸馏目标,比普通量化更接近 BF16 14-17%;FP4 attention 将 768p 15 秒片段从 101.8 秒降至 85.3 秒。5 秒 480p 首尾帧片段在单台 DGX Spark 上耗时 59.5 秒,并支持来自 Hao AI Lab 与 NVIDIA 的 Open-H3-Regenerate-2K 模型。权重、推理代码和完整训练配方均已开放。

    匹配字段摘要、正文

星期二

  1. Google DeepMind精选

    Google DeepMind 为 Antigravity 推出化学信息学技能

    Google DeepMind 为 Google Antigravity 发布一套化学信息学技能(Cheminformatics Skills),基于 RDKit 并接入 ChEMBL 与 PubChem,由语言模型负责任务编排与科学推理、确定性化学工具执行分子计算。以肺癌药物为例,智能体在约一小时内检索数千个化合物、完成匹配分子对分析并训练效力预测模型,还提出带合成路线的新型刚性化大环分子设计。团队同时说明,稀疏数据、实验室间检测噪声和窄动态范围会限制预测精度,计算设计只是可验证的假设,仍需实验合成验证。该技能已在 Antigravity 上线,安装 Science 插件即可使用,并向 1 万名科学家提供 6 个月最高用量档免费名额。

    An image showing a text input box in a clean, light-themed user interface. The input box contains a prompt asking to search academic and patent literature for macrocyclic and acyclic compounds in the crizotinib and lorlatinib series. A dropdown menu at the bottom-left shows "Gemini 1.5 Flash" selected.

    匹配字段摘要、正文

  2. NVIDIA Developer · Generative AI精选

    NVIDIA 发布 Cosmos Framework 与 Cosmos NIM,支持世界模型训练与部署

    NVIDIA 发布面向物理 AI 的 Cosmos Framework 和 Cosmos NIM,前者提供训练、强化学习、优化与推理的模块化工具和智能体技能,后者以容器形式提供加速推理服务。Cosmos 3 Nano 仿真配方可从已发布 checkpoint 生成同步的相机视频与 LiDAR 观测,覆盖自动驾驶、机器人和手术场景。NIM 通过量化、投机解码和 KV-cache 感知路由,在 H200 上实测约 2–3 倍加速,Cosmos3-Nano 生成任务在 BF16 下需 58 GiB 显存。

    A policy model (e.g., Alpamayo) or user sends an action to the AlpaSim simulation runtime. AlpaSim updates the simulation state and forwards the context to Cosmos3-Nano-Sim-Auto, which synthesizes the next camera frames and returns them to the policy, completing the loop.

    匹配字段摘要、正文

星期六

  1. Browser Use

    Browser Use 上线 BU Ultrafast 浏览器智能体,中位任务 22 秒、成本 0.0064 美元

    Browser Use 将最快的浏览器智能体 BU Ultrafast 从等待名单开放到美国所有 Cloud 套餐,免费版也包含。官方数据显示其任务中位耗时 22 秒、单次成本 0.0064 美元,而默认智能体在 GPT-6 Luna 上为 79 秒、0.0098 美元。使用时只需把 model 设为 bu-ultrafast;需要更多逐步推理可改用同一智能体的 bu-fast,后者按标准费率计费。

    BU Ultrafast: a white craft racing over red canyons, median task 22s, $0.006

    匹配字段摘要、正文

星期五

  1. 凤凰科技

    新芯航途发布大模型芯片 X7 Ultra,算力 700 TOPS

    新芯航途(XHEART)发布面向十亿参数级智驾大模型的新一代芯片 X7 Ultra,算力 700 TOPS。官方称用合作伙伴的 Transformer 量产智驾模型实测,计算利用率 98.7%,在模型表现相当的前提下对标行业旗舰芯片内存带宽消耗下降 80%、推理能效提升 100%。X7 系列量产 8 个月累计出货 20 万颗,搭载 10 款量产车型,首发车型为上汽大众 ID.ERA 9X;同场 Momenta 发布参数量比上一代提升 5 到 10 倍的 R7 Ultra 世界模型。

    匹配字段摘要、正文

  2. Rohan Paul

    Anthropic 为 Claude 加入回答后自评估,标记对话中的潜在滥用

    Anthropic 训练 Claude 在每次回答后对对话做初步安全评估,这项名为 self-assessment 的技术自 6 月启用以来已发现其他防护机制未能覆盖的滥用行为。该机制利用 Claude 已读过对话的优势,成本低于分类器,且能随模型改进而提升准确度。Rohan Paul 补充称,Anthropic 最准确的滥用检测器是需先读全部安全政策的 Claude Mythos Preview 分类器,运行成本过高;Anthropic 因此训练 Claude 在不读政策和推理过程的情况下复制其判断,在 Fable 5 流量上该副本匹配检测器 78% 的标记,高优先级案例升至 94%,误报率为 1%。

    匹配字段摘要、正文

星期三