Google 用 Gemini 3.8 Flash 与 ThreeJS 构建交互式 3D 拆解可视化
Google AI Developers 展示了用 Gemini 3.8 Flash 与 ThreeJS 在 Google AI Studio 中构建的交互式 3D 可视化工具,用于测试该模型的复杂推理能力。该模型能为硬件设备生成比例真实的拆解图,自动把设备分解成多个图层,用户可通过拆解滑块展开并查看各层结构。官方同时给出了开始使用 3.8 Flash 的链接。
匹配字段标题、摘要、正文
Google AI Developers 展示了用 Gemini 3.8 Flash 与 ThreeJS 在 Google AI Studio 中构建的交互式 3D 可视化工具,用于测试该模型的复杂推理能力。该模型能为硬件设备生成比例真实的拆解图,自动把设备分解成多个图层,用户可通过拆解滑块展开并查看各层结构。官方同时给出了开始使用 3.8 Flash 的链接。
匹配字段标题、摘要、正文
Google 推出 Fairwind Program,面向 Google Cloud 客户、政府机构和网络安全伙伴提供受限访问,首批开放 Gemini 3.8 Flash Cyber 与 CodeMender 组合,用于自主发现、验证并修复漏洞。官方称该组合可在数分钟内生成经过验证、可直接部署的补丁,运营成本远低于传统前沿模型,目前已有超过 650 家全球伙伴参与。参与机构需遵守严格操作标准,包括仅限内部网络安全、事件响应或渗透测试团队使用,并部署多因素认证等防护措施。
匹配字段标题、摘要、正文
Google 推出 Fairwind Program,面向 Google Cloud 客户、政府机构和网络安全伙伴提供受限访问,首批开放 Gemini 3.8 Flash Cyber 模型与 CodeMender harness,用于自主发现、验证并修复漏洞。Google 称该组合能以远低于传统前沿模型的运行成本,在组织自有安全云环境中于数分钟内生成可部署的验证补丁,而非数周人工修复。目前已有超过 650 家全球伙伴参与,参与者需遵守仅限内部网络安全、事件响应或渗透测试团队使用并启用多因素认证等运营标准。
匹配字段标题、摘要、正文
Google 发布 AI 图像创建与编辑工具 Google Pics,基于 Nano Banana 图像生成与编辑模型,支持用文本提示生成和精修图像。功能包括对象分割、图内文字编辑与翻译、多人协作编辑同一张图,以及一次提示生成多个版本。该工具既是独立产品,也已集成进 Workspace,Docs 和 Slides 即日起可用,Drive 将在未来几周内上线,入口为 pics.new。
匹配字段标题、摘要、正文
Google DeepMind 为 Gemini 3.7 Flash、3.6 Flash 和 3.5 Flash-Lite 推出智能体视频理解功能,模型可动态扫描视频片段,token 消耗最多降低 88%、成本最多降低 66%、准确率最多提升 7%。该功能已在 Google AI Studio 和 Gemini Enterprise Agent Platform 的 Gemini API 中上线,支持视频上传和 YouTube 视频,按标准 token 计费且不额外收费。相比固定 1 FPS 的静态处理,它结合模型推理与原生视频工具,按需检索画面、音频和转录文本,后续还将接入 Gemini 应用和 YouTube 的 Ask YouTube 功能。
匹配字段标题、摘要、正文
Google 为搜索 AI Mode 增加旅行预订能力,可追踪机票价格、查看积分或里程兑换价格,并直接在对话中完成酒店预订。机票价格追踪已覆盖 180 多个国家和地区,积分里程查询全球可用,首批支持 Alaska Airlines / Hawaiian Airlines、American Airlines、Choice Hotels、Hilton 和 Wyndham 等合作伙伴。酒店预订已在美国以英语开始推送,合作方包括 Booking.com、Expedia、Marriott、Trip.com 等。
匹配字段标题、摘要、正文
Google 在 Search 和 AI Mode 中推出面向学习的新工具,包括可生成交互式模拟和可视化的生成式 UI、覆盖科学数学到外语等科目的定制练习测验,以及把 Gemini Notebook 的笔记本接入 AI Mode。生成式 UI 已在 AI Mode 全球上线英文版并开始在 AI Overviews 铺开,练习测验在 AI Overviews 和 AI Mode 中全球免费提供英文版,Notebook 将在未来数日内在 180 多个国家以英文推出。Lens 还将在未来几周推出交互式学习体验,拍照后可获得 AI Overview 讲解、指出可能的错误并在卡住时提供引导。
匹配字段标题、摘要、正文
xAI 推出 Grok 的 Google Workspace 插件,在 Sheets、Slides 和 Docs 中把 Grok 放在当前打开的文件旁边。在 Sheets 中它可依据表格内容回答问题并标注引用的单元格,还能写入和填充公式、插入图表、在假设变化时重跑场景;Slides 中可把大纲变成可编辑的演示文稿并沿用原有主题,Docs 中可把草稿整理成带标题和列表的结构化文本。该插件免费,从 Google Workspace Marketplace 一次安装即可覆盖三个应用,同时也提供 Microsoft 365 版本。
匹配字段标题、摘要、正文
Google DeepMind 将 computer use 作为内置工具集成进 Gemini 3.5 Flash,此前该能力仅以独立的 Gemini 2.5 computer use 模型形式提供。开发者可通过 Gemini API 和 Gemini Enterprise Agent Platform 使用它构建能跨浏览器、移动端和桌面环境感知、推理并执行操作的智能体,面向持续软件测试等长周期与企业自动化任务。为降低实时环境中的提示词注入风险,官方对 computer use 做了针对性对抗训练,并发布两套可选的企业级防护系统。
匹配字段标题、摘要、正文
Google Research 与 Google Cloud 合作推出 Agentic RAG 框架,并已在 Gemini Enterprise Agent Platform 以公开预览形式上线。该框架通过 Planner、Query Rewriter、Sufficient Context 等智能体迭代检索,在信息不足时给出具体缺口并继续搜索,相比标准 RAG 在事实性数据集上准确率最高提升 34%。在 FramesQA 的跨语料设置中,系统需从 4 个语料中路由查询,仍答对 90.1% 的问题,延迟与单语料版本平均相差约 3% 以内。

匹配字段标题、摘要、正文
Google AI Studio 在 I/O 期间上线新功能,用户可直接在 AI Studio 中构建 Android 应用,并一键安装到自己的设备。同时,只需通过提问即可自动为 Google Docs、Sheets 及其他 Workspace 应用构建应用,无需使用密钥。
匹配字段标题、摘要、正文
Google 发布 24/7 个人 AI 智能体 Gemini Spark,可在文档、日历、幻灯片等应用间工作,关闭电脑后仍继续运行,由 Gemini 3.5 驱动。后续将推出 macOS 应用、Chrome 控制以及短信和邮件访问能力,下周开始推送。
匹配字段标题、摘要
Google 发布 Empirical Research Assistance(ERA),一个基于 Gemini 的科研编码工具,可搜索文献、写代码、组合方法并评估结果,用树搜索在数千个方案中优化输出代码。相关成果已发表于 Nature,在基因组学、公共卫生、卫星图像分析、神经科学预测、时间序列预测和数学等基准上达到专家级表现。基于 ERA 和 AlphaEvolve 构建的 Computational Discovery 原型即日起通过 Google Labs 可信测试者计划逐步开放,Google 目前已有八篇应用 ERA 的论文手稿。
匹配字段标题、摘要、正文
Google 在 I/O 开发者大会上宣布重新设计沿用 25 年的搜索框,将其从关键词输入框改为可接受文本、图片、PDF、视频和 Chrome 标签页的多模态对话入口,并立即在支持 AI Mode 的所有国家和地区上线。Google 同时把 AI Overviews 与 AI Mode 合并为一条连续搜索流程,用户可在传统结果页直接追问,无需切换界面。新体验由 Gemini 3.5 Flash 驱动,Google 称 AI Mode 上线一年月活已超 10 亿,AI Overviews 月活超 25 亿。
匹配字段标题、摘要、正文
Google DeepMind 推出 Gemini for Science,包括 Google Labs 的三款实验性工具,以及 Google Antigravity 中的 Science Skills。Science Skills 整合超过 30 个生命科学数据库和工具,可将部分结构生物信息学及基因组分析从数小时缩短至数分钟;实验工具自即日起逐步开放申请。
匹配字段标题、摘要、正文
Google 将内容透明与验证工具扩展至 Search、Gemini、Chrome、Pixel 和 Cloud,并在 Gemini Enterprise Agent Platform 推出 AI Content Detection API。SynthID 已为逾 1000 亿张图像和视频及 6 万年音频添加水印,其 Gemini 验证功能全球使用 5000 万次。Pixel 8、9 和 10 将在未来几周为视频加入 C2PA Content Credentials。
匹配字段标题、摘要、正文
Google Research 宣布在 Google Photos 的 Auto frame 功能中上线一种新的图像编辑方法,让用户在照片拍完后重新调整拍摄视角。该方法把 2D 照片理解为 3D 场景,先用内部 3D 点图估计模型还原人体和面部并推算原相机焦距,再用经典 3D 渲染生成新机位下的画面,最后用生成式潜在扩散模型填补新视角下原本未拍到的背景空洞。该功能已作为 Auto frame 候选中的第二个版本选项上线,可自动检测人脸位置与朝向并计算理想取景参数,也会修正广角前置摄像头造成的透视畸变。

匹配字段标题、摘要、正文
Google Research 发布 Vibe Coding XR 工作流,将 Gemini Canvas 与开源 XR Blocks 框架结合,把自然语言提示词转成可交互、带物理效果的 WebXR 应用,可在桌面模拟环境和 Android XR 头显上运行,官方称生成时间在 60 秒以内。该流程通过专门的系统提示词让 Gemini 掌握 XR Blocks 架构与示例,覆盖房间级 XR 环境、包管理和交互最佳实践,并给出数学辅导、物理实验、化学实验、薛定谔的猫等示例原型。团队用 20 名 Google 员工在四场内部工作坊中提供的 60 条提示词构建 VCXR60 数据集,早期多数错误来自 XR Blocks 自身缺陷或对不存在或已弃用 API 的幻觉,成功率约 70%,经六个月迭代和 11 个主要版本后,以 XR Blocks Gem v0.11.0 在 VCXR60 上的评测作为基线参考,并建议开发者使用 Pro Mode 获得更可靠结果。
匹配字段标题、摘要、正文
Google 宣布在 Flood Hub 上线城市山洪预报,可提前最多 24 小时预测城市山洪风险。该模型用 Groundsource 方法借助 Gemini 从公开新闻报道中提取历史山洪事件作为训练数据,弥补地面观测站缺失,输入仅依赖全球气象产品与 ECMWF、Google DeepMind 的天气预报,当前空间分辨率为 20x20 公里,覆盖人口密度大于每平方公里 100 人的区域。Google 称在南美、东南亚等全球南方地区,模型的精确率与召回率与富裕国家相当,并计划继续提升对农村地区的泛化能力。

匹配字段标题、摘要、正文
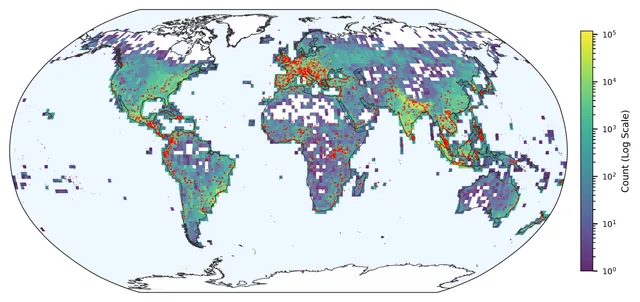
Google 推出 Groundsource,用 Gemini 从全球新闻报道中抽取结构化灾害事件数据,首个开放数据集收录 260 万条城市山洪记录,覆盖 150 多个国家、时间跨度从 2000 年至今。人工复核显示 60% 的抽取事件在地点和时间上均准确,82% 足以用于实际分析;与 GDACS 的时空匹配显示,2020 至 2026 年间 Groundsource 覆盖了后者记录的 85% 至 100% 的严重洪水事件。基于该数据,Google 已在 Flood Hub 推出提前最多 24 小时的近全球城市山洪预报,并表示该方法可扩展到干旱、滑坡和雪崩等灾害。
匹配字段标题、摘要、正文