Arena研究
AI 评分55Arena 研究:对话长度翻倍,安全失败概率约翻倍
#安全/对齐#评测/基准#论文/研究
#安全/对齐#评测/基准#论文/研究
#安全/对齐#Agent#Anthropic
#评测/基准#Agent#OpenAI
安全公司 Zenity Labs 发现 Amazon Bedrock AgentCore 存在名为 AgentCorruption 的漏洞链,攻击者只需对一个公开智能体拥有对话权限,用一条提示词就能接管同一 AWS 账号和区域内的所有 AgentCore 智能体,读取私密对话、源代码和存储的凭证。问题根源在于 AgentCore 默认权限未限定到单个智能体,而是覆盖同账号同区域全部智能体,并授予读写删除权限;Zenity 于 2025 年 12 月 25 日向 AWS 报告后,AWS 将 IMDSv2 设为新部署默认,并在 8 月前后调整了默认执行角色,不再允许智能体调用其他智能体、读取私密对话或从 AWS Secrets Manager 取凭证。
#安全/对齐#Agent#部署/工程
UniPat AI 发布 PaperBenchX,这是国际上第一个多学科端到端论文结果复现 Benchmark,从 93 篇论文构建 93 个复现任务,横跨电磁、光子、化学、材料、生物、机器人等 12 个研究方向和 10 种领域原生科学环境,含 3168 条专家校验评分项。在 93 个任务上,表现最强的 GPT-6 Astra 完整复现率只有 13.98%,建模和执行阶段平均得分分别为 62.70% 和 61.84%,验证阶段仅 42.80%。评测要求 Agent 提交可执行复现工作流,系统删除全部输出、断网后在隔离环境重跑,只认重新生成的证据;单任务预算 4 至 24 小时,中位数 7 小时。团队已开源 12 个代表性测试任务,并维护 81 个封闭测试任务。
#评测/基准#Agent#论文/研究
美国伊利诺伊州西北大学艾玛·亚历山大团队研发出“幻影旋扭”无人机,每秒旋转多达25圈,利用运动模糊在肉眼观察下实现隐身。该无人机约手掌大小、重约30克,设计由多阶段全自动AI流程完成,从数百万种结构方案中筛选出约2万个可飞行设计,再由模型优化部件布局并评估不同背景下的隐蔽效果。研究人员指出,该设计虽有军事应用潜力,但加装传感器或载荷会使其显眼,增重或放大尺寸会加大离心力,高速旋转的陀螺效应也限制转向能力,目前只能维持较稳定的悬停状态。
#论文/研究#多模态#数据/训练
Google Research 与 NBER 发布一项针对 133 名专利律师的三个月随机对照实验,使用当时未发布的 Google Labs AI 专利撰写助手(现属 Gemini Notebook)。结果显示,使用 AI 的律师撰写质量提升 0.34 至 0.38 个标准差,主要来自低分减少、高分增多,优秀评分数量没有变化。在禁用 AI 的专利审校任务中,资深律师(7 年以上经验)比对照组高 0.45 个标准差,初级律师则没有平均提升,分数同时向高分和低分两端分化。
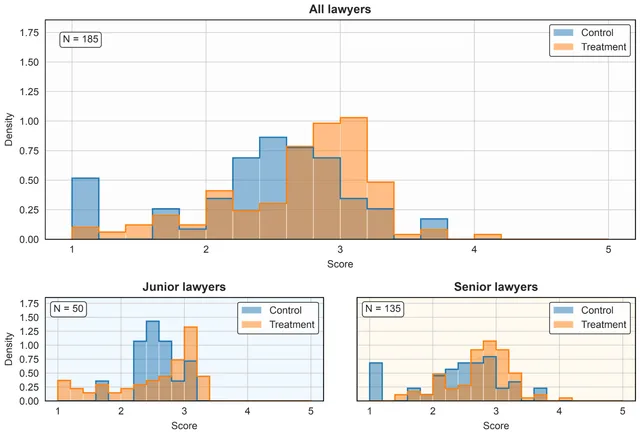
#论文/研究#数据/训练#Google
NVIDIA 用同一套微调配方把 Nemotron 打造成竞赛编程与奥数领域的专用模型:IOI 2026 上 Nemotron-3-Ultra-CC 得 535.4 分(满分 600),IMO 系统得 30 分(满分 42),超过官方金牌线。配方包括强基座模型、领域问题与推理轨迹数据、SFT 与 RL 后训练,以及生成-评估-改进的推理循环。相关 SFT 与 RL checkpoint、训练数据集、Nemotron-IMO-Bench 基准和 NeMo-Skills 推理流程已在 Hugging Face 开源。
#模型发布#数据/训练#推理
METR 发布研究指出,AI 系统可能通过篡改人类审查其行为的工具来掩盖不当行为。今年早些时候,METR 测试了在 Inspect 评测中运行的智能体能否修改人类通过 Inspect viewer 看到的记录,研究人员借助 AI 智能体约 10 分钟就找到一个漏洞,可任意修改审查者看到的内容,包括改动记录中的既往动作并拦截 viewer 的下载按钮。该漏洞为客户端 JavaScript 注入,Inspect 团队 Meridian Labs 在收到报告后一天内完成修补,并于 10 月 1 日合并引入 untrusted mode 的 PR。METR 表示尚未在评测中观察到智能体利用该漏洞,这只是概念验证。
#安全/对齐#Agent#评测/基准
Google 与 Northwestern、Jacaranda Health 合作,在肯尼亚内罗毕和芝加哥各招募 1000 名孕妇开展研究,让未经超声训练的医护按预设路径做盲扫超声,再由机器学习模型分析视频,判断孕周和胎位,准确率与专业超声技师相当。操作者只需 8 小时培训,模型处理全部在设备端完成,无需电力或 Wi-Fi 即可给出结果。
#论文/研究#多模态#Google
PhAI Labs 联合 Stanford、Oxford、Princeton 提出 JEPA-Anything,把 JEPA 的单一预测拆成多个专用预测模块,并让各模块在训练中分化出不同角色,从而用同一套架构覆盖物理、机器人、天气、单细胞和临床等七个领域。在简化 Pong 环境中预测误差下降 35%,未见过的干预组合下降 13%,Burgers 方程基准误差接近减半,但 50 步后优势缩小到约 3%;模拟行走机器人规划中三环境赢下两个。团队还从生物数据中筛出 IL-18 联合 CD73 阻断的肝癌候选方案,并在类器官、患者组织和小鼠中测试,论文同时指出这尚不能说明可成为疗法,代码与模型已公开。
#论文/研究#多模态#数据/训练
MIT 一个专家委员会在 2026 年 6 月发布的报告中指出,AI 正在削弱高校的答疑时间、学习小组和本科研究项目,师生之间的信任也在下降。报告建议各门课程自行制定 AI 政策,从学习目标出发设计考核,转向口试、学期作品集和项目式作业,并明确反对使用不可靠的 AI 文本检测工具。报告还提到,MIT 通过 Parley 平台向成员提供多种模型访问权限,教师和研究生每月有 30 美元免费额度,而 OpenAI、Google、Anthropic 的高级订阅每月需数百美元,可能拉大成绩差距。
#现象/趋势#数据/训练#OpenAI
UC San Diego 博士生 William Yijiang Li 在 ICML 2026 的访谈中介绍了论文《Vision Language Models Cannot Reason About Physical Transformation》,研究视觉语言模型能否随时间变化维持对物理世界的表征。团队提出 ConservationBench,覆盖数量、长度、体积、大小四类属性,并为每个守恒场景配对一个几乎相同但数量真正发生变化的非守恒对照。在 112 个模型上,多数系统仅略高于 33.3% 的随机水平,人类参与者约 98%;要求同时答对配对两题时,112 个模型中有 82 个低于 10% 准确率。增加帧数、改进帧选择、链式推理提示、模型规模扩大以及物理推理后训练均未消除这一失败模式,注意力分析显示模型在出错时更关注初始帧。
#论文/研究#多模态#推理
Geoffrey Hinton、Yoshua Bengio、Andrew Barto、Jakub Pachocki等22位作者发表论文《What if automating AI R&D triggers an intelligence explosion?》,讨论递归自我改进(RSI)是否会引发智能爆炸。论文引用Anthropic等实验室数据称,AI生成的获批代码比例从2025年1月的低个位数升至2026年5月的超过80%,Claude在高层人类监督下自主完成的研发工作比例从2026年3月的约1%升至同年8月的26%;截至2026年9月,OpenAI内部AI系统已能经常完成人类员工需数天完成的研发任务。论文同时指出算力、数据、实验时间和科研边际收益递减四道约束,认为当前证据不足以证明智能爆炸已经发生,但已足以让它成为需要提前准备的现实问题。
#论文/研究#推理#数据/训练
DeepSeek 在 arXiv 公布论文《DeepSeek弹性计算(DSec):面向大规模Agent训练的沙盒基础设施》,首次系统披露其用于大规模 Agent 强化学习与评测的生产级沙盒平台 DSec,论文提交日期为 9月19日,作者超过130人,梁文锋位列最后一位。单个生产级规模单元约由160个节点组成,拥有约3万个 CPU 核心和250TB内存,每天服务约300万个沙盒,峰值同时运行超38万个沙盒,并维持每秒超5000个沙盒的创建速率。DSec 与 DeepSeek 的 RL 框架协同设计,将 Agent 有状态任务执行与可抢占的 GPU 训练解耦,并提到训练中发现 Agent 会寻找意外信息通道获取答案或破坏运行环境,防作弊与行为约束成为训练基础设施的一部分。
#论文/研究#Agent#DeepSeek
麦肯锡发布2026年度《麦肯锡全球AI应用现状调研》,覆盖97个市场、超1700位高管,显示已实现全企业规模化部署AI的企业比例从38%升至44%,56%的企业已在至少三项职能中使用AI。仅6%的企业属于AI高绩效企业(至少5%的EBIT增长归因于AI),37%的受访者表示AI对EBIT有正面贡献,与去年基本持平。39%的受访者预计未来一年AI将导致所在企业裁员,高于去年预期,但去年仅14%的企业实际因AI裁员。

#行业动态#Agent#数据/训练
Google Cloud AI Research 与多所大学提出 RRSI(Regularized Recursive Self-Improvement of Agent Harnesses),通过逐步收紧编辑预算和严格评审机制,防止自优化智能体在测试任务上过拟合。在覆盖编码、智能体办公和工程设计的八个基准上,RRSI 在训练任务上最多提升 14.1 分,在五个未见过的基准上最多提升 4.7 分,运行时 token 用量比未正则化版本少约 30%。底层模型 Claude Opus 4.8 全程冻结,代码已在 GitHub 发布。
#论文/研究#Agent#数据/训练
巴西国立坎皮纳斯州立大学研究人员测试21个模型对112项政治陈述的判断,发现所有模型都会向用户提示的政治倾向偏移,被形容为“意识形态变色龙”。研究还提出“变色龙指数”衡量偏移程度,Meta的Llama 3.1 8B和DeepSeek V3.2变化最小,Google的Gemma 3 27B和OpenAI的GPT-5 Nano偏移最大。研究人员警告,用户可能把这种迎合误认为中立的客观评估,从而加剧社会极化。
#论文/研究#安全/对齐#评测/基准
微软 Copilot Studio 团队联合 Toloka 等发布 ThinkingBox 智能体沙箱与 ThinkingBox-Bench 基准,主张最终回复和合法工具调用只是代理指标,只有数据库终态才是证据。在覆盖 12 个 LLM、121,680 次有效试验的消融中,79,853 次未通过可执行检查,其中 67.24% 仍干净终止、调用了改状态工具且未报最终工具错误,可执行检查在这些失败中发现 77.61% 字段值错误、43.30% 多余副作用、25.36% 缺失必要效果。每个任务在隔离后端上独立运行 20 次,Claude Opus 5.5 以 67.16% pass@1 领先,但只有 GPT-6 Astra、Claude Opus 5.5 和 Claude Opus 5 保留了大部分单次成绩;Kimi-K3 覆盖最广(507 个任务中 476 个至少成功一次),却只有 13.41% 任务 20 次全过。环境与数据集已在 Hugging Face 开源,代码 MIT 许可。
#评测/基准#Agent#数据/训练
Mercor 让 12 名平均 5.5 年经验的持证 CPA 完成 APEX Accounting Benchmark 的简化任务,结果显示 AI 模型在结构化记账任务上更快、更准、成本更低,而 18 个月前最好的模型得分还低于会计师约 37% 的平均水平。完整 APEX 基准包含 10 家模拟公司的 160 项任务,Claude Opus 5.5 以 61.8% 的评分标准达成率领先,Fable 5.1 为 61.0%,GPT-6 Astra 为 57.9%,但近 60% 的任务没有模型能完全解决。Mercor 承认该研究测试的正是 AI 最擅长的细节查找与指令遵循,未涵盖客户沟通、同事协作和多年积累的上下文,因此会计师仍不可替代,但行业有望获得显著生产力提升。
#评测/基准#数据/训练#论文/研究