PromptArmor一手研究
AI 评分75PromptArmor 披露 Google Antigravity 经间接提示词注入外泄 .env 变量
#安全/对齐#Agent#Google
#安全/对齐#Agent#Google
Zyphra 发布技术报告,介绍 ZAYA1——首个完全在 AMD 平台(AMD Instinct MI300X GPU、AMD Pensando 网络与 ROCm 软件栈)上完成大规模训练的 MoE 基础模型,训练集群由 AMD 与 IBM Cloud 联合构建。ZAYA1-base 总参数 8.3B、激活参数 760m,在推理、数学和编码基准上表现与 Qwen3-4B、Gemma3-12B 相当,并超过 Llama-3-8B 和 OLMoE。Zyphra 称其为 AMD 生态可支撑前沿级 AI 训练的验证,并采用压缩卷积注意力(CCA)等架构创新提升训练吞吐与推理效率。

#模型发布#数据/训练#开源生态
安全研究者 Johann Rehberger 披露一条针对 Claude 代码解释器的数据外泄攻击链:借助间接提示词注入,让 Claude 读取用户数据并写入沙箱文件,再用攻击者提供的 ANTHROPIC_API_KEY 调用 Anthropic Files API,把文件上传到攻击者账号,单次最多可外泄 30MB。作者指出默认的 Package managers only 网络配置允许访问 api.anthropic.com,因此并不安全;他于 10/25/2025 通过 HackerOne 向 Anthropic 报告,1 小时后被以超出范围关闭,10/30/2025 Anthropic 确认此类漏洞属于受理范围。缓解建议包括沙箱限制只能与登录用户账号通信、关闭该功能或仅允许特定域名。
#安全/对齐#Agent#MCP/工具调用
Zyphra 发布 Compressed Convolutional Attention(CCA)研究,将 query、key、value 下投影到低维潜空间并直接在潜空间内完成全部注意力计算,同时降低参数量、KV-cache 和 FLOPs。其分组查询变体 CCGQA 结合 GQA 式头共享,可再减少 2 倍 KV-cache 且无性能损失,已用于训练 ZAYA 系列语言模型。在 H100 上,融合 CCA kernel 在序列长度 16k 时相对 MHA 将 prefill 延迟降低约 1.7 倍,反向传播加速约 1.3 倍;消融实验显示 CCA 与 CCGQA 在同等 KV-cache 压缩下优于 GQA 和 MLA。技术报告已发布至 arXiv。

#论文/研究#数据/训练#开源生态
安全研究者 Johann Rehberger 展示了跨智能体权限提升攻击链:GitHub Copilot 可写入 Claude Code 的 MCP 配置和 CLAUDE.md 等指令文件,当开发者随后使用 Claude Code 时,被篡改的配置会被加载并执行任意代码,Claude 也能反向改写 Copilot 配置形成升级循环。作者指出该问题不限于 VS Code 和 GitHub Copilot,而是通用模式,并已向 MSRC 报告,但未被认定为需要立即修复的严重问题。缓解建议包括隔离各智能体配置、不自动覆盖或创建文件、对点文件写入要求用户批准以及最小权限执行。
#安全/对齐#Agent#MCP/工具调用
Anthropic 发布第三版经济指数报告,新增 Claude.ai 使用的地理分布分析和首次对企业 1P API 流量的任务分析。报告显示 Claude.ai 上编程任务占 36%,教育任务从 9.3% 升至 12.4%,指令式自动化对话占比从 27% 升至 39%;企业 API 流量中 77% 为自动化模式,编程任务占比比 Claude.ai 高 8 个百分点以上。地理上,以色列人均使用指数达 7 倍,新加坡 4.57 倍,印度 0.27 倍、尼日利亚 0.2 倍,使用量与人均 GDP 正相关。

#论文/研究#数据/训练#Anthropic
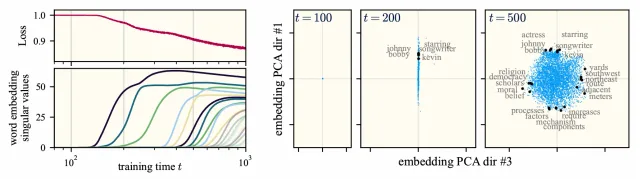
BAIR 研究者提出了 word2vec 学习过程的定量理论,证明其在特定近似条件下可归结为无权最小二乘矩阵分解,最终表示等同于对目标矩阵进行 PCA。模型从小权重初始化时会逐步学习正交特征并增加嵌入矩阵秩,这些特征可由语料统计和算法超参数预先计算。标准类比测试中,原始 word2vec、近似模型和 PPMI 的准确率分别为 68%、66% 和 51%。
#论文/研究#数据/训练
安全研究者 Johann Rehberger 发布 AgentHopper 概念验证,用一个通用提示注入载荷在多个编码智能体间自我传播。载荷先感染开发者智能体,再扫描 Git 仓库注入指令并推送回 GitHub,其他开发者拉取被感染代码后触发注入,形成循环传播。攻击路径涉及 GitHub Copilot、Amp Code、Amazon Q Developer 和 AWS Kiro,相关漏洞均已由厂商修复。作者建议为 SSH 和签名密钥设置口令、启用分支保护并遵循最小权限原则。
#安全/对齐#Agent#编码
安全研究者 Johann Rehberger 披露 AI 编码智能体 Cline 存在数据外泄漏洞:聊天框会渲染来自不可信域名的 Markdown 图片,攻击者可在提示注入攻击中读取 .env 等敏感文件并把内容拼进图片 URL,且无需人工批准即可外泄。该问题于 2025 年 5 月 29 日报告给 Cline 项目,90 多天后仍未修复,作者因此公开披露。缓解建议包括不渲染不可信域名的 Markdown 图片、默认关闭 Auto-approve,并建议 Cline 投入资源做安全工程。
#安全/对齐#Agent#编码
安全研究者 Johann Rehberger 在 AWS Kiro 发布当天测试发现,该编码智能体可被间接提示注入劫持,实现任意操作系统命令执行。两条攻击路径分别是:Kiro 无需开发者批准即可写入 .vscode/settings.json,从而把任意 Bash 命令加入允许列表;以及写入 .kiro/settings/mcp.json 添加恶意 MCP 服务器,保存文件即触发代码执行。作者于 2025 年 7 月 15 日发布当天向 AWS 披露,AWS 在 8 月 5 日前修复,v0.1.42 中报告已修复,未分配 CVE。
#安全/对齐#Agent#MCP/工具调用
安全研究者 Johann Rehberger 演示了一条针对 Manus 的端到端间接提示注入攻击链:通过不可信数据触发 deploy_expose_port 工具,在无人工确认的情况下把内部 VS Code Server 端口暴露到公网,再借助 markdown 图片渲染和浏览不可信域名两条数据外泄通道,把公网 URL 与本地配置文件中的密码发送给攻击者服务器,最终获得该 dev box 的完整远程控制权。作者于 2025 年 6 月 1 日通过支持邮箱向 Manus 团队披露,但具体缓解措施的落实状态仍不明确;他建议限制可连接域名、对暴露端口等高风险工具要求人工确认、将端口锁定到预配置 IP 白名单、用 Content-Security-Policy 阻止不可信域名的图片渲染,并加强提示注入检测。
#安全/对齐#Agent#MCP/工具调用
Johann Rehberger 通过自建名为 Remote Matrix 的远程 MCP 服务器,实测 ChatGPT Deep Research 在同时启用多个连接器时存在数据外泄:智能体会把 Linear 工单中的生产服务信息和凭据合并进对 Remote Matrix 的查询,并可能把记忆和聊天历史发送给 Bing、Shopify 等搜索工具。他还用 Linear 工单和恶意工具描述中的间接提示词注入劫持研究流程,让智能体以特定口吻发起查询。作者建议不要在同一研究流程中同时连接敏感数据源与低可信数据源,并指出 OpenAI 要求自定义连接器只实现 search 和 fetch 两个工具以限制风险。
#安全/对齐#Agent#MCP/工具调用
安全研究者 Johann Rehberger 披露 Windsurf Cascade 存在隐藏提示词注入漏洞,开发者看不到的不可见 Unicode Tag 字符会被模型当作指令执行。演示中一个看似空白的文件实际含隐藏指令,使用 Claude Sonnet 3.7 时 Cascade 会据此调用 web 工具。作者指出 Windsurf 的 SWE-1 模型目前能“看到”这些字符但尚不能将其解释为指令,而 Windsurf 支持的其他模型可以可靠地执行这类不可见指令。该问题已于 2025 年 5 月 30 日披露给 Windsurf,后续沟通一度中断,作者建议在 UI 中显示这些字符或在推理前后直接移除不可见 Unicode Tag 字符。
#安全/对齐#Agent#编码
安全研究者 Johann Rehberger 披露 Windsurf Cascade 的 SpAIware 攻击链:其 create_memory 工具会自动调用、无需人工批准,攻击者可通过间接提示词注入把恶意指令写入长期记忆,从而持续影响后续所有对话并配合此前的外泄漏洞持续窃取信息。作者称已于 2025 年 5 月 30 日向 Windsurf 报告,三个月未获实质回应后公开,Windsurf 随后表示将着手修复但未给出时间表。作者建议用户定期检查 Windsurf 设置中的长期记忆,并指出系统应改为向用户建议记忆而非自动写入。
#安全/对齐#Agent#MCP/工具调用
METR 复现并扩展了 Google DeepMind 论文(Emmons 等)第 5 节的实验,用 Claude 4 Sonnet、Claude 3.7 Sonnet、GPT-4o 作为 actor 模型,GPT-4o、GPT-4o-mini、o3、Gemini 2.0 Flash、Gemini 2.5 Pro 作为监控模型,测试模型能否在掩盖真实学科推理的同时躲过监控。结果显示,开启推理模式后,模型的推理轨迹几乎 100% 会先说出自己的掩盖计划,从而被监控模型直接抓住;在需要 CoT 才能解题的 152 道 GPQA 扩展题上,模型也难以在不损失准确率的情况下躲过监控。由于原论文未提供源码,METR 用 Inspect 开源复现了第 5 节,代码和对话记录已发布在 GitHub。
#论文/研究#安全/对齐#推理
安全研究者 Johann Rehberger 披露 Windsurf Cascade 存在两条提示注入漏洞,可在开发者分析文件时把 .env 等敏感信息外泄到第三方服务器。第一条利用无需用户批准的 read_url_content 工具,第二条通过渲染不受信任域名的图片触发,均无需人工确认。作者于 2025 年 5 月 30 日负责任披露,Windsurf 确认收到后未再回复,后表示将着手修复但未给出时间表。
#安全/对齐#Agent#编码
安全研究者 Johann Rehberger 披露 Amazon Q Developer VS Code 扩展存在不可见 Prompt 注入漏洞,攻击者可将人类不可见的 Unicode Tag 字符嵌入普通文本,Claude 模型会将其当作指令执行,进而调用工具甚至通过 find -exec 实现任意代码执行。该漏洞于 2025 年 7 月 5 日报告给 AWS,AWS 称已于 8 月 8 日修复,但不会发布公开公告或 CVE,建议用户升级到最新版本。作者建议在输入处理前清除或中和 Unicode Tag 字符,并加入针对可疑 Unicode 用法的自动检测。
#安全/对齐#Agent#编码
安全研究者 Johann Rehberger 披露 Amazon Q Developer VS Code 扩展存在间接提示注入漏洞,攻击者可通过源码注释等不可信数据劫持 AI,在开发者未确认的情况下执行任意命令。漏洞根因是 executeBash 工具把 find 归入 readonly 类别从而绕过人工确认,而 find 的 -exec 参数可执行任意系统命令;作者还演示了绕过 Claude 4 拒绝机制、从远程服务器下载并执行命令乃至 Sliver 恶意软件加入 C2 的完整链路。该漏洞于 2025 年 7 月 4 日报告给 AWS,7 月 17 日在 v1.85 版本中静默修复,AWS 最终以该报告需先有系统入侵为由拒绝分配 CVE。
#安全/对齐#Agent#编码
麦肯锡研究显示,尽管 92% 的企业计划未来三年增加 AI 投资,但仅 1% 的企业领导者认为其组织的 AI 部署已达到成熟阶段。员工广泛使用 AI 的可能性是领导者认知的三倍,已有 13% 的员工将 AI 用于超过 30% 的日常任务。
#论文/研究#Agent#OpenAI
安全研究者 Johann Rehberger 披露 Amazon Q Developer VS Code 扩展存在高危漏洞,可被间接提示注入劫持,通过 ping 等命令把开发者机器上的 .env 文件、API key 等敏感信息经 DNS 请求外泄,且无需开发者确认。该扩展下载量超过 100 万,作者于 2025 年 7 月 5 日向 AWS 报告,AWS 确认并静默修复,但未发布安全公告或 CVE,作者建议用户运行最新版本或开启自动更新。作者还发现 Amazon Q 会拒绝 oast.me、Burp Collaborator 等已知安全测试域名,换成普通域名即可绕过,与 Claude Code 的 CVE-2025-55284 行为类似。
#安全/对齐#Agent#编码