←搜索结果

按匹配度 · 共 404 条结果 清除搜索

星期日

  1. 事件1 条新闻 · 1 个事实

    Mistral Large 4上线Arena并获首批评测

    2026年10月6日,Mistral AI的Mistral Large 4上线Arena,可在Agent Arena中实测,用户投票将影响其评估结果,分数稍后公布;Agent Arena用数百万个真实长周期智能体任务评测模型,模型可调用网页搜索、文件系统和终端工具完成复杂工作流,排行榜以因果追踪方法衡量模型相对平均模型的结果表现。Mistral Large 4同时上线Code Arena的WebDev、Text和Vision三个方向。10月8日,Arena发布对Mistral Large 4的首批评测,该模型为1T参数、49B激活,开放权重将于本月底发布;Arena用一系列真实场景测试将其与GPT-6.1 Sol、Astra、Claude Fable、Claude Opus 5.5、Claude Sonnet 5.5、Kimi K3、GLM 5.3 Flash、DeepSeek Flash和Muse Spark等模型对比,后续还会公布更多分数和更新。

    匹配字段摘要

  2. 事件1 条新闻 · 1 个事实

    Mitchell Hashimoto发布OSC 7501终端协议规范

    2026年10月6日,Mitchell Hashimoto发布了一份新的终端转义序列规范OSC 7501,即Program Status Protocol,让程序通过pty直接上报自身状态。据其博客介绍,状态包括idle、working、waiting on the user、finished或failed,并可附带原因;序列体由冒号分隔的key=value组成,唯一必填键是state,可选app和base64编码的msg,多任务可用层级id同时上报多条记录。他指出,agentic inbox目前靠屏幕启发式或非终端API判断agent状态,前者需频繁维护规则,后者要逐个集成且难以跨SSH和容器。他表示已用不超过十几行代码在libghostty、Rex、Terraform、Claude Code、Codex和Homebrew中实现该协议。目前尚无后续发展事实。

    匹配字段摘要

  3. 事件1 条新闻 · 1 个事实

    Box测试Sonnet 5.5企业任务表现

    2026年9月29日,Box在早期访问中使用Box Agent的复杂工作评测,测试并评估Claude Sonnet 5.5在企业知识工作中的表现。据该评测,Sonnet 5.5在整体最难测试中提升4分,完成交付物约快2.4倍,并少用12% token。分行业看,金融服务提升18个百分点、法律7个百分点、生命科学8个百分点、公共部门7个百分点。具体任务中,尽职调查审查提升48分并快约61%,商业租约审查提升14分,现场试验报告提升22分并快约41%,数学干预项目报告提升11分并快约71%。报道还称,客户不久将能在Box AI Studio中用Sonnet 5.5构建AI智能体。目前尚无后续发展事实。

    匹配字段摘要

  4. 事件1 条新闻 · 0 个事实

    Anthropic开放Claude插件目录提交门户

    2026年9月25日,Anthropic上线Claude插件目录提交门户。据Claude应用发布说明,付费Claude计划的开发者可提交插件并跟踪审核进度,插件上线后还能查看安装量与搜索来源等使用分析。插件可打包MCP连接器、Agent Skills或两者,在Claude Code中还可包含LSP、命令、hooks和agents。同一说明提到,Claude已支持MCP 2.0规范,并提供MCP Apps与Enterprise Managed Auth两个扩展。目前尚无后续有证据的发展。

    匹配字段摘要

  5. 事件1 条新闻 · 1 个事实

    Mistral构建Rails测试智能体

    2026年3月11日,Mistral AI 构建了一个基于其开源编码助手 Vibe 的智能体,用于自动为 Rails 项目生成和改进 RSpec 测试。该智能体可在 CI/CD 中无人干预运行,并支持多实例并行处理不同文件。其实现方式包括通过仓库级 AGENTS.md 提供分步执行计划、按文件类型拆分 skills 文件,并加入 RuboCop 与 SimpleCov 自定义工具;其中把 SimpleCov 放在最后一步强制运行每个测试被视为最关键的决定,因为首次执行时只有约三分之一测试通过。在包含 275 个源文件的真实仓库实验中,已有测试文件的 LLM-as-a-judge 评分从 0.49 提升到 0.74,覆盖率达到 100%。目前尚无后续发展事实。

    匹配字段摘要

  6. 事件1 条新闻 · 1 个事实

    Linear构建智能体交互体系

    2025年8月1日,Linear介绍了Agent Interaction SDK的设计。该SDK让AI智能体以独立用户身份进入工作区,并在明确权限下参与任务;身份与交互范围通过OAuth actor=app、app:assignable和app:mentionable管理。系统还使用agent sessions传递结构化上下文、跟踪状态,并以delegation区分人类责任与智能体执行,使问题保留人类负责人,同时可委派智能体采取行动。

    匹配字段摘要

星期二

星期日

  1. 事件1 条新闻 · 1 个事实

    蚂蚁ASystem团队发起AReno本地后训练工具包

    2026年8月14日,蚂蚁ASystem团队发起AReno本地化大模型后训练工具包。同日,蚂蚁百灵发布实践文章,介绍在DGX Spark上用AReno对Ling-3.0-tiny做Agentic RL,以井字棋为最小验证任务,跑通基线评测、Reward定义、后训练与同环境复测四步闭环。实验使用GSPO训练400个step,rollout/rewards_mean从约-0.5升到0.4左右,response_len降至约850 tokens,复测中工具调用与落子选择更稳定。Ling-3.0-tiny为7.9B总参数、1.3B激活参数的混合推理模型,已开源BF16、FP8和INT4版本,AReno提供Docker复现教程。目前该工具包已随上述实践公开。

    2026年8月14日,蚂蚁ASystem团队发起AReno本地化大模型后训练工具包。同日,蚂蚁百灵发布实践文章,介绍在DGX Spark上用AReno对Ling-3.0-tiny做Agentic RL,以井字棋为最小验证任务,跑通基线评测、Reward定义、后训练与同环境复测四步闭环。实验使用GSPO训练400个step,rollout/rewards mean从约-0.5升到0.4左右,response len降至约850 tokens,复测中工具调用与落子选择更稳定。Ling-3.0-tiny为7.9B总参数、1.3B激活参数的混合推理模型,已开源BF16、FP8和INT4版本,AReno提供Docker复现教程。目前该工具包已随上述实践公开。

    匹配字段摘要

星期一

  1. 事件1 条新闻 · 1 个事实

    Browser Use 公开其生产架构

    2026年5月9日,Browser Use 官方博客公开了其开源 browser-use 库在生产环境运行的架构,采用 SQS 到 Lambda 的工程实践。该架构以 FastAPI on ECS Fargate 接收任务,经单条标准 SQS 队列传递消息,由 Lambda 作为 worker 执行 Agent,并将检查点、截图、日志和输出文件存入 S3。由于 Lambda 存在 15 分钟硬限制,系统会在截止前两分钟优雅停止、将状态写入 S3 并重新入队,由新的 Lambda 调用恢复继续执行,continuation 计数器上限为 12,约合三小时墙钟时间。失败处理直接复用 Lambda 重试与 SQS 死信队列,三次失败后进入 DLQ 且不自动重投;作者还提到 Lambda 的 /tmp 在热实例间不会自动清理,因此每次调用开始时清空工作区。目前该架构已由官方公开说明,暂无进一步的发展事实。

    匹配字段摘要

星期三

  1. 事件1 条新闻 · 1 个事实

    Replit 介绍决策时引导控制层

    2026年1月21日,Replit 介绍其决策时引导(decision-time guidance)控制层,用于让 Replit Agent 在长任务中保持可靠。该方案用一个轻量多标签分类器判断当前轨迹需要哪条微指令,只在相关时注入,从而把控制从单一系统提示词拆成可复用的指令库。Replit 称,把鼓励并行工具调用的短提示词放在轨迹末尾,比放在系统提示词中让智能体每轮多执行 15% 的工具调用;而决策时注入超过三到四条提醒后收益递减甚至为负。由于核心提示词不变、注入内容不留在对话历史中,该方案相比动态修改系统提示词可降低成本 90%。目前尚无后续发展事实。

    匹配字段摘要

星期二

  1. Google Developers Blog精选

    Google 实测用轻量分类器在 Gemini 模型与思考等级间路由以降低单任务成本

    Google Developers Blog 用 50 道自动评分的编码智能体题目实测,把 TypeSafe 的 Jev 分类器接在模型调用前做路由,简单任务交给 Flash-Lite、复杂任务升级到低思考等级的 Gemini 3.8 Flash,50 题全部答对,成本与响应时间均低于全程使用低思考等级 Flash。文章还发现,把 maxOutputTokens 压到 300 并不能减少简单任务上的思考开销,反而让 25 道难题中的 7 道出错;基于关键词和提示词长度的本地启发式规则在 34 道未见过的题目上准确率从 93.8% 降到 70.6%。作者建议先直接使用低思考等级的 Flash,再对短小独立任务加分类器路由,长上下文任务保持单一模型以维持 Context Caching 折扣。

    image3 (1)

    仅运行一次,50 条提示词,难度手工分配,评分采用简单自动评分。 4. 每 token 价格并不能说明全部问题 我们的结果中有两点只有在你超越它之后才会显现。 路由和缓存的作用方向相反。 我们的测试提示词是简短的独立任务,在这些任务上 Jev 路由器有助于降低成本和响应时间。真实的编码智能体往往不同。它们每一轮都发送相同的大块上下文,例如仓库地图和工具定义。Agent Platform Context Caching 会存储该块,因此重新发送时你只需支付 75% 到 90% 更少的费用。问题在于缓存属于单个模型。如果你的智能体在 Flash-Lite 和 Flash 之间逐轮切换,它要么保留两个缓存,要么失去折扣。实际的分工是:路由简短的、自包含的任务,如日志解析或模式检查,并将长的、上下文密集的轮次保留在单一模型上。 让模型匹配工作负载。 Gemini 3.1 Pro 专为深度、多步推理而构建,并将同样的深度带入每个请求,包括不需要它的简短查询。对于主要由快速检查和提取组成的工作负载,Flash 配置更合适,而 Pro 最好留给需要其推理深度的任务。模型配置还可以对安全相关提示词应用

    匹配字段正文

  2. AWS Machine Learning精选

    在 Amazon SageMaker AI 上用知识蒸馏构建高效智能体

    AWS 官方博客介绍如何用序列级知识蒸馏(SeqKD)在 Amazon SageMaker AI 上微调购物智能体:以 Amazon Bedrock 上的 GLM-5.3 作为教师模型生成轨迹,用 ShoppingBench 评分器只保留解出任务的轨迹,再对 Qwen3.5-4B 学生模型做服务端无服务器 SFT。在 324 道留出测试题上,蒸馏后 4B 学生平均绝对成功率从 0.297 提升到 0.541,与教师模型和中等规模前沿模型基本持平;去掉教师推理过程只学工具调用时,平均成功率降至 0.415。

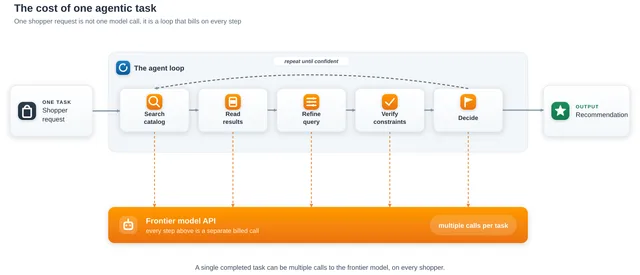
    Diagram of an agentic task as a loop: search, read results, refine, verify, and decide, with each step a separate billed call to the frontier model

    sion="0.36.0") 1. Deploy the base model as an inference component, with LoRA serving enabled. endpoint name, base ic = kd serve.deploy base endpoint( endpoint name="seqkd-shopping-agent", role=role, region=region, image uri=image uri, base model id="Qwen/Qwen3.5-4B", instance types=["ml.g5.2xlarge", "ml.g6.2xlarge", "ml.g6e.2xlarge"], max lora rank=64, max loras=4, max model len=131072, ) 2. Resolve the student's adapter artifacts from its Model Package and attach them as a second inference comp

    匹配字段正文

星期一

  1. LMSYS Blog

    LMSYS 详解 HiCache 如何适配多并行与分布式推理

    LMSYS 博客介绍 HiCache 在上下文并行、流水线并行、投机解码、统一 KV 布局和 P/D 分离场景下的实现方式,核心是让各 rank 在缓存决策上保持一致。讯飞星辰 MaaS 团队用 HiCache 加外部存储服务 GLM-5.1/5.2 CodingPlan 负载,缓存命中率从约 30% 提升到 95%,中位 TTFT 降到 3 秒以内。CP 分片实测中 GPU token 命中率提升 40.48 个百分点,host 内存服务 token 量下降 81.2%,prefill 平均排队时间降低 56.2%。

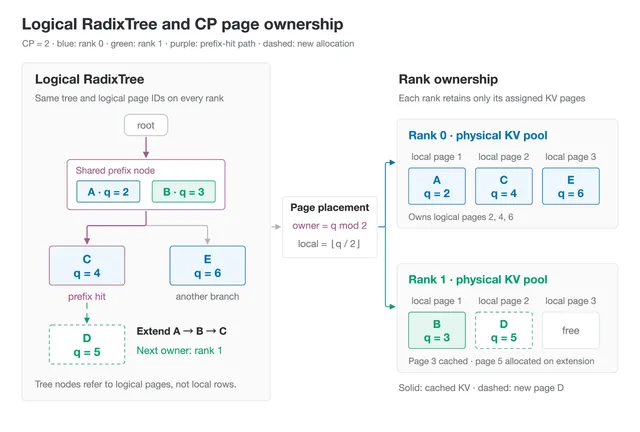
    A logical radix tree shared by two CP ranks: logical page IDs map to rank 0 or rank 1 by q mod 2, and extending the A/B/C prefix allocates page D on rank 1.

    CP 需要进一步集成。混合模型缓存组件和草稿模型缓存状态是下一步计划。 5. P/D × HiCache:解码侧前缀复用 在 P/D 服务中,prefill worker 上的前缀缓存命中可以节省计算,但 decode worker 在生成 token 之前仍然需要相应的 KV。如果没有解码侧复用,该 KV 必须在后续轮次中再次传输。对于具有长共享历史的 agentic 工作负载,重复传输会增加等待每个响应的时间。 解码侧基数树允许 worker 保留来自早期请求的 KV,并将其与传入的提示进行匹配。HiCache 将这种复用扩展到主机内存,因此前缀在其 KV 离开 GPU 后仍可复用。在后续请求中,decode 恢复本地缓存的前缀,并要求 prefill 仅发送缺失的后缀。 图 5。 高亮的树路径匹配一个 8K 前缀:A 在 GPU 上,B 在主机内存中。Decode 在本地恢复 B,并仅从 prefill 接收 4K 后缀 C。灰色分支显示其他缓存的前缀;C 尚未缓存。解码会同时等待恢复和接收完成。 对于每个请求,decode 将提示与其基数树进行匹配,并锁定驻留在 GPU 上的

    匹配字段正文

星期三

  1. 马东锡 NLP

    写给 LLM 读者的强化学习术语:一个分数如何分到每个 token

    文章以 DeepSeek-R1-Zero 在 AIME 2024 上 pass@1 从 15.6% 升到 71.0% 为例,说明规则 judge 只给整段回答一个分数,而训练要调整每个 token 的概率。作者用 Is OpenAI open? 的采样例子依次解释 policy、state、action、reward、return、value、Q、advantage、baseline、TD error、GAE、clipping 和 KL,并指出 PPO 用 critic 学习 V、GRPO 用组内平均分代替 V。

    于选最想当然的那个: open,概率 0.5,后面接 It's in the name.(名字里就写着)。judge 平均打 2 分(满分 10 分)。 closed,概率 0.3,漏掉了开放权重的模型。judge 平均打 5 分。 partly,概率 0.2,后面接 some open weights.(部分权重开放)。judge 平均打 9 分。 循环:agent、environment、reward 在强化学习里,agent 做出 action,environment 给出反馈,reward 衡量 action 的好坏。对应到 LLM: agent 就是模型。模型对下一个 token 的概率分布叫作 policy,记作 π θ,其中 θ 是模型权重。训练改变 θ,也就改变了 policy。 environment 是模型以外的一切:模型收到的 prompt,以及给回答打分的 judge。 judge 是 environment 中给完整回答打分的部分。它可以是用人类偏好数据训练出的 reward model,可以是 R1-Zero 那样的规则检查器,可以是运行生成代码的单元测试,

    匹配字段正文

  2. Pydantic AI 官方文章精选

    Pydantic 用 5,276 次运行对比 code mode 与工具调用

    Pydantic 的 Michael Pfaffenberger 用 5 个小型 Pydantic AI 应用、8 个模型做了 5,276 次评分运行,对比 code mode 与直接工具调用。长任务上 code mode 平均成本降 58%、耗时降 51%、成功率提高 16 个百分点;但 5 条目的短任务在 5 个任务中有 3 个反而贵了 21% 到 38%。作者认为模型写循环比充当循环更擅长,差距随任务变长而扩大。

    Michael Pfaffenberger avatar

    /Pydantic AI 为什么 code mode 能削减你的 agent 账单 Michael Pfaffenberger mpfaffenberger 21 分钟前 2026/10/28 作为 Markdown 现在和我交谈的每个人对 code mode 都有自己的看法。我的看法则是由 Prime Intellect 的 Prime Agent点燃的,这是一个围绕持久化 REPL 构建的编码工具框架,此外还有 Alex Zhang 的 推测性程序化工具调用,它(除其他功能外)能在模型仍在流式输出代码时运行工具。 Cloudflare 就有一个。 Anthropic 也有一个。我们自己也有过几个,从 MCP 代码执行 到 Pydantic Monty编码智能体也在朝同一方向演进: OpenCode 2 现在默认通过 Code Mode 发送 MCP 工具,而 Pi 则自带一个 codemode 工具。常见的宣传话术大致是这样的:别再让模型一次调用一个工具,而是让它写一个小程序来调用这些工具,这样一切都会更便宜、更快、更好。 我信这一点。但我见过的几乎每个数字都来自拥有数百个工具或庞

    匹配字段正文

  3. Unite.AI

    Perplexity 发布 LLM 网关实践指南,梳理请求链路与生产风险

    Perplexity 于 2026 年 10 月 27 日发布 LLM 网关实践指南,说明这一中间层如何路由、鉴权、缓存和记录模型调用,并区分 API 网关、LLM 网关、MCP 网关与 AI 网关四类形态。指南以六步请求生命周期拆解机制,同时警告网关集中了各家供应商凭证,并引用 Microsoft 披露的 LiteLLM 网关入侵事件和 Check Point 报告的 CVE-2026-35029、CVE-2026-59823 两个高危漏洞(已在 LiteLLM 1.83.9 修复)。文中还列出 Cloudflare AI Gateway 与 OpenRouter 的故障复盘、四条部署路径及约 50 美元/月起的付费方案。

    e API Management 的 AI 网关。 在成本方面,指南指出,LLM 网关的价格从免费的开源软件到每月约 50 美元起的付费方案不等,企业版则采用定制定价;有些网关则按比例收费:指南指出,OpenRouter 的 Standard 方案会在购买额度时额外收取 5.5%。 指南最后给出了针对具体供应商的解答。指南指出,Amazon Bedrock AgentCore Gateway 通过 AWS 所称的“推理目标”支持模型调用,让应用程序使用一个端点即可访问包括 Amazon Bedrock、OpenAI 和 Anthropic 在内的供应商。指南指出,Perplexity 自家的 Agent API 支持 OpenAI 的 Responses API 接口,因此团队可以复用现有的 OpenAI 客户端库;并且 Agent API 允许用户按偏好顺序列出最多五个模型,包括来自不同供应商的模型。指南还提到了 Perplexity 的开源项目 Numbat,它通过本地钩子连接到受支持的智能体,并能在计划中的操作(如 shell 命令或文件写入)执行前对其进行检查,阻止功能为可选项

    匹配字段正文

星期四

  1. 阿易 AI Notes

    作者用 Claude Opus 5.5 做出「情商外挂」并借 UUMit 把本地服务变成团队链接

    作者用 Cursor 配合 Claude Opus 5.5 做出零依赖的本地网页工具「情商外挂」,把带情绪的草稿按《非暴力沟通》四要素改写,并内置七类沟通对象与温和、坚定、直接三档语气。工具跑在本机 127.0.0.1:8787,通过 UUMit 客户端生成固定 HTTPS 链接分发给同事,无需买服务器或备案,权限可按人发放和收回。文中还给出单次输入 800 字限制、默认每分钟 10 次与每天 200 次的限流设置,以及两个 GitHub 仓库的源码和 System Prompt。

    到情商外挂点击接入,系统会立刻分配一个专属的固定 HTTPS 网址: 用手机打开这个链接测试,秒开丝滑: 这就顺带解锁了另一个高频场景:家里或工位电脑开着跑工具,人在地铁或出差路上,手机点开链接就能随时改消息。 3.5 写清楚主页与能力介绍 同事打开链接,最怕看到一头雾水的技术词汇。UUMit 提供了能力展示主页,建议只写场景任务,别堆空洞名头。写沟通大师 Agent没人知道能干嘛,写把带火气的话改成对方听得进去的说法,大家立刻就知道在什么时候用它。 3.6 选开放范围 应用接入后,默认处于只有我的安全锁定状态。UUMit 提供了三档范围切换: 需要注意:UUMit 负责控制谁能打开入口。为了防止外部人员过度调用打爆你的模型额度,频率与总量限额已经在情商外挂自己的设置面板里完成了管控(详见第四部分)。 3.7 邀请同事/朋友 分享流程极简,总共三步: 在右侧「成员与邀请」模块点击邀请朋友,生成专用邀请链接与二维码; 点击复制链接通过微信或飞书发给同事(当面直接扫码亦可); 同事点开链接,通过手机号或已有账号登录 UUMit 后即可直接进入工具,加入后会自动出现在你的成员管理列表中。 整

    匹配字段正文

  2. Google Developers Blog精选

    Google A2UI 团队与 CopilotKit 介绍如何构建生成式 UI 应用

    Google A2UI 团队与 CopilotKit CEO Atai Barkai 介绍如何用 A2UI 开放标准和 CopilotKit 构建生成式 UI 应用。A2UI 以声明式 JSON 描述界面,客户端只渲染可信组件目录中的组件,同一份响应可渲染到 React、Angular、SwiftUI、Jetpack Compose 和 Flutter。文中给出用 Google ADK 接入 CopilotKit 的代码示例,并说明通过 AG-UI 协议实现用户操作回传、智能体重新生成界面的双向流程。

    都以大段文字的形式返回。它们没有标准方式来在对话本身之中渲染可选择的套餐列表、目的地地图,或引导你完成其余预订流程的日期选择器。 生成式 UI 是让智能体在运行时构建界面的层,界面形态由每个请求的需求决定——为用户带来丰富、交互式的体验。实现这一点需要两部分:一种描述 UI 的方式,以及一套智能体技术栈,将你的智能体连接到你的应用并渲染该 UI。 A2UI(Agent-to-UI)是 Google 推出的框架无关的生成式 UI 开放标准。智能体将界面描述为数据,你的应用则用你已有的组件将其绘制出来。它在设计上是传输无关的。 CopilotKit 提供智能体集成技术栈,可与“LangChain”、“AWS Strands”、“Google ADK”等智能体框架集成,用于构建面向用户的智能体应用。它提供了一套工具包,用于借助 A2UI 协议构建丰富的应用,包括聊天界面、运行时,并在 React 和 Angular 中利用 A2UI 渲染器。CopilotKit 还为 Vue 和 Slack 提供自定义 A2UI 渲染器。 什么是 A2UI? 生成式 UI 涵盖了一系列方法,从使用预定义的高

    匹配字段正文

星期五

  1. 新京报

    新京报实测千问Go!与灵光2.0:个人智能体竞争转向自主代办

    新京报贝壳财经记者实测阿里千问Go!和蚂蚁灵光2.0,前者用一句话建好每天8点的用药提醒并逐项核对,后者在支付宝授权后梳理近半年账单。文章同时梳理了Meta Muse、OpenAI dots及字节、腾讯的布局,并指出跨生态权限是当前最难拆的墙,字节SAEP公示的拒绝名单达155款应用。

    Personal Agent(个人智能体)赛道骤然变得拥挤。10月27日,蚂蚁集团发布灵光2.0,定位为“能管事的个人AI助理”,官方数据显示产品上线6天下载量突破200万。同样,阿里千问、字节、腾讯也已纷纷下场。 仅仅两个月前,这条赛道还近乎无人问津。海外市场已率先落子:9月8日Meta个人智能体Muse率先在北美上线;在10月21日三季度财报电话会上,扎克伯格披露,美加地区已有超1000万用户完成初始配置,约25%用户每日活跃,购物为核心场景,超四分之一用户在对话内完成下单,平均客单价逾200美元。10月28日Muse落地新加坡,接入Shopee、Lazada、Grab等本地服务。紧随其后,9月29日OpenAI发布智能体dots,现已面向部分订阅用户开放,订阅费每月100美元起。 海外布局推进之际,国内大厂跟进节奏更为密集。9月22日云栖大会,阿里千问宣布加码Personal Agent方向;10月13日推出个人专属助理“千问Go!”。字节被曝将代号Spell的项目与豆包深度整合,独立产品命名“小豆”;腾讯则同步在云端、桌面、微信生态三线布局卡位。 继通用大模型、企业Agent之

    匹配字段正文

星期一

  1. Browser Use

    Browser Use 教程:无 API 网站如何每日登录并下载发票

    Browser Use 发布教程,介绍在没有 API 的供应商门户上自动登录并每日下载发票的三种方案:Playwright 脚本、UiPath 或 Power Automate 等 RPA 工具,以及带保存配置的浏览器智能体。文章给出 Playwright 与 Browser Use Cloud 的完整代码,涵盖复用登录会话、用 1Password 填入 TOTP 验证码、通过 GitHub Actions 定时运行,以及会话过期、2FA 拦截、页面改版和空下载等失败场景的处理方式。作者建议先向供应商索取导出、API 或邮件发票,并提醒先确认门户条款是否允许自动化访问。

    登录信息会保存到配置文件中(配置文件)。保留配置文件 ID。 将密码和 TOTP 放入 1Password。 一个专用保险库、一个具有读取权限的服务账户,在 Settings Secrets 下连接(1Password 指南)。 one-time-password 字段会输入当前代码。仅在门户将你登出时需要。 编写运行并收集文件。 列出运行会话使用的浏览器(agentSessionId),然后列出每个浏览器的下载(下载 API): daily invoices.py import os, pathlib, time, requests from browser use sdk.v4 import BrowserUse API = "https://api.browser-use.com/api/v4" KEY = {"X-Browser-Use-API-Key": os.environ["BROWSER USE API KEY"]} def op(alias, field): one 1Password field, typed only on the portal's host re

    匹配字段正文