N全部新闻

星期二10 条

  1. Artificial Analysis解读
    AI 评分58

    Artificial Analysis 上线 FrontierCode 1.1 编码智能体排行榜

    Artificial Analysis 上线 FrontierCode 1.1 排行榜,该评测由 Cognition 构建,用真实开源仓库的合并标准检验编码智能体,共 150 个任务,本次运行其中 100 个主任务集,全部任务私有以避免污染。Claude Opus 5.5(max with fallback)以 52% 居首,但其尝试中仅 58% 通过阻断性检查,100 个任务中有 9 个没有任何模型通过;前九名模型分数集中在 43% 至 52%,开源权重模型 MiMo-V2.6-Pro 以 45% 领先,DeepSeek V4.1 Flash(max)和 Kimi K3(max)为 44%。GPT-6.1 Sol(max)以每任务 0.81 美元取得 49%,与 Claude Fable 5.1(max with fallback)持平,成本不到后者的十分之一。

    同一事件 · 3 条报道

    #评测/基准#编码#Agent

  2. Artificial Analysis解读
    AI 评分63

    Artificial Analysis 发布 AA-3D 基准,评测 AI 模型构建交互式 3D 场景的能力

    Artificial Analysis 发布新基准 AA-3D,评测 AI 模型构建交互式 3D 场景的能力。模型在离线沙盒中作为智能体把书面任务转成 three.js 网页,由人工评审在不知模型身份的情况下两两比较,共 55 份任务、21 个模型、超 1 万次投票并按 Elo 排名。结果显示 Claude Sonnet 5.5(1194)、Claude Opus 5.5(1190)、GPT-6 Astra(1165)和 Claude Fable 5.1(1131)在统计上并列第一,开源权重模型 Kimi K3(982)和 MiMo-V2.6-Pro(977)分列第 11、12 名。

    #评测/基准#Agent#多模态

  3. 小米 MiMo 官网发布与博客一手解读
    AI 评分67

    小米详解 MiMo-V2.5 推理系统优化实践

    小米 MiMo 团队发布 MiMo-V2.5 系列推理系统的端到端工程实践,覆盖 KVCache 管理、分层缓存、SWA 感知前缀缓存树、调度策略、Prefill/Decode 执行流水线与多模态优化。MiMo-V2.5-Pro 共 70 层,其中 10 层 Full Attention、60 层 SWA,滑动窗口为 128,Hybrid SWA 使计算量与 KVCache 存储降至 Full Attention 的约 1/7。团队称上线以来服务端 KV Cache 命中率平均 93%,重度用户可达 95% 以上,并将部分优化以 PR 形式回馈 SGLang 社区。

    Attention FLOPs vs sequence length: Full Attention vs Hybrid SWA, roughly a 7.0× compute reduction

    #教程/实践#部署/工程#推理

  4. VR陀螺解读
    AI 评分56

    千问N1 Pro深度评测:健康监测与眼动追踪实测

    VR陀螺对千问N1 Pro进行深度评测,重点实测健康监测、眼动交互及AI主动服务等核心能力。N1 Pro支持心率、血氧、皮肤温度等实时体征监测并生成健康洞察报告,还配备眼动追踪传感器,可结合视觉AI识别注视目标,并支持千问与支付宝联合研发的虹膜核身支付。该产品与N1、千问AI耳夹式耳机同期发布,已在淘宝、天猫、京东及抖音等平台开售,AI眼镜到手价2218元起。

    同一事件 · 5 条报道

    #产品更新#端侧#多模态

  5. TensorZero 工程博客一手解读
    AI 评分58

    TensorZero 逆向解析 Cursor 的 LLM 客户端

    TensorZero 团队把自研开源框架作为自托管代理接入 Cursor 与 LLM 之间,成功观测并改写 Cursor 发出的 API 调用。他们通过 Ngrok 暴露公网端点、Nginx 做鉴权,解决了 Cursor 先请求自家服务器和 CORS 校验两个障碍,最终链路为 Cursor → Ngrok → Nginx → TensorZero → LLM 提供商。作者发现 Cursor 回答问题的系统提示词仅 642 token,并会向模型说明自身的模型层级,目前正以 Claude 4.0 Sonnet、GPT-4.1、o4 Mini 和 Gemini 2.5 Pro 做等比例随机分流测试。

    #教程/实践#部署/工程#Agent

  6. TensorZero 工程博客一手解读
    AI 评分52

    TensorZero 如何用每次 Git 提交自动评估 AI 编码助手

    TensorZero 工程博客介绍了一套自动评估 AI 编码助手的方法:用 tree-sitter 把 LLM 生成的代码片段和 Git 提交中的新增代码解析成语法树,再用树编辑距离(TED)计算两者的最小差异,归一化后得到 0 到 1 的奖励值,作为反馈写回 TensorZero。该流程以 Rust 二进制实现,可作为 post-commit git hook 在每次提交后自动运行,并通过 rayon 并行计算。作者称其 CTO Viraj 的个人使用数据显示 GPT-4.1 的效果不如 Claude 3.7 Sonnet、Gemini 2.5 Pro 和 o4-mini,但强调这只是初步结果,不主张某个模型普遍更优。

    Diagram: CursorZero with Feedback Loop

    #教程/实践#编码#部署/工程

  7. TensorZero 工程博客一手解读
    AI 评分51

    TensorZero 实测 OpenAI RFT:成本是 SFT 的 100-700 倍,值不值?

    TensorZero 在数据抽取、智能体编码和客服三个任务上对比了 OpenAI 的 RFT 与 SFT,RFT 成本是同等数据量 SFT 的 100-700 倍。RFT 仅在智能体编码任务上明显优于 SFT,数据抽取上更大数据集的 SFT 效果更好且成本低 159 倍,客服任务上 RFT 反而比基线更差。作者还指出 RFT 会触发比 SFT 更严格的内容审核,导致部分公开基准数据集无法通过验证。

    #评测/基准#数据/训练#OpenAI

星期日3 条

  1. Arena解读
    AI 评分67

    Image-to-WebDev Arena 更新:Claude Opus 5.5 登顶,Sonnet 5.5 紧随其后

    Image-to-WebDev Arena 更新显示,Anthropic 的 Claude Opus 5.5(Max)以 1749 分登顶,Claude Sonnet 5.5(xHigh)以 1740 分、9 分之差位列第二,两款模型均进入帕累托前沿。价格方面,Opus 5.5 的混合输入输出 token 价格为 $16/M,比第三名 GPT-6 Astra 的 $40/M 低 60%;Sonnet 5.5 为 $8/M,比 Opus 便宜 50%,且排名高于 GPT-6 Astra 而成本低 80%。该榜单评估模型从图像和截图生成网站的能力,以及涉及多步推理和工具调用的智能体编码工作流。

    #评测/基准#编码#Agent

  2. OpenAI Developers一手解读
    AI 评分59

    OpenAI 谈如何为 GPT-6 Astra 重写 skills 与提示词

    OpenAI Developers 发文说明,随着模型能力提升,为 Codex 等编码智能体积累的 skills、AGENTS.md 和任务提示词需要重新审视,GPT-6 Astra 尤其如此。文章建议 skill 描述尽量简短并明确使用时机,多流程 skill 用根文档做最小路由实现渐进披露,避免写成过于具体的步骤清单。AGENTS.md 中要求每次编辑前通读文档、强制跑测试等旧指令可能浪费上下文,而 GPT-6 Astra 会自行检查工作,但可能更早停下等待确认,因此需要提前定义完成标准。

    #教程/实践#Agent#编码

  3. OpenAI Developers一手解读
    AI 评分64

    OpenAI 开发者分享如何用 Astra 在 Codex 中构建游戏

    OpenAI 开发者撰文介绍如何用 Astra 在 Codex 中构建游戏,并以太空探索游戏 Void Explorer 为例,展示从概念图、架构设计到地形流式加载与性能测试的完整流程。Void Explorer 包含 2,048 个恒星系和超过 10,000 颗程序化生成的行星,行星最大可与地球相当。作者还提到用同一方式开发了水面渲染的 Sunwake 和 2D 动作 RPG Hollowflux,并可通过 Sites 插件发布为浏览器游戏。

    #教程/实践#编码#Agent

星期六1 条

  1. Artificial Analysis解读
    AI 评分66

    Artificial Analysis 实测四款图像编辑模型连续 30 次编辑表现

    Artificial Analysis 让 GPT Image 2.5 Sunburst、Ideogram 4.5、FLUX 3 和 Nano Banana 2.1 对同一张照片连续执行 30 步房产布景编辑,测试多轮编辑一致性。结果显示 Ideogram 4.5 和 FLUX 3 采用局部编辑,在添加花瓶等小改动时 95% 以上画面基本不变;GPT Image 2.5 Sunburst 每次编辑都会重绘大部分画面,仅约五分之一保持不变,导致色彩和细节偏差逐轮累积;Nano Banana 2.1 介于两者之间,编辑保持局部但画面其余部分会轻微偏移并逐渐变暗。

    #评测/基准#图像生成#多模态

星期五23 条

  1. TensorZero 工程博客一手解读
    AI 评分54

    TensorZero 逆向解析 Cursor 的 LLM 客户端

    TensorZero 团队把自研开源框架作为自托管代理接入 Cursor,成功观测并改写 Cursor 发往 LLM 的 API 调用。他们发现 Cursor 会先请求自家服务器再发起 LLM 调用,因此本地网关无法直连,最终用 Ngrok 加 Nginx 反向代理并处理 CORS 才打通链路。作者看到 Cursor 用于问答的系统提示词仅 642 token,并已用 Claude 4.0 Sonnet、GPT-4.1、o4 Mini 和 Gemini 2.5 Pro 做等比例随机分流测试。

    #教程/实践#部署/工程#Agent

  2. TensorZero 工程博客一手解读
    AI 评分63

    OpenAI 的强化微调 RFT 值得用吗?TensorZero 在三个任务上做了基准测试

    TensorZero 在数据抽取、智能体编码和客服三个任务上对比了 OpenAI 的 RFT 与 SFT,RFT 成本是 SFT 的 100-700 倍。RFT 在智能体编码任务上明显优于 SFT,但数据抽取用 SFT 效果更好且成本低 159 倍,客服任务中 RFT 反而比基线更差。作者还指出 RFT 触发了比 SFT 更严格的内容审核,导致部分公开基准数据集无法通过验证。

    #评测/基准#数据/训练#OpenAI

  3. LMSYS Blog一手解读
    AI 评分51

    SGLang 与 Miles 在 NVIDIA Vera Rubin 上的适配与优化

    LMSYS 团队提前拿到两个 NVIDIA Vera Rubin 节点(8 块 GPU),把 SGLang 推理和 Miles 强化学习训练搬上该平台。推理侧针对 Kimi K3 NVFP4 调整了 attention、MoE/通信和 KDA 内核,例如更深的 MLA 流水线在 batch 16、128k 上下文下快 16%,融合 MoE 尾部每步减少 276 次内核启动、端到端提升 5.9%。训练侧 Miles 用 SGLang 做 rollout、Megatron 做训练,在单托盘 4 块 GPU 上开箱跑通 Qwen3-30B-A3B 的 GSM8K 训练,奖励从约 45% 升到 95%,并在 Vera CPU 上以 64 个沙箱运行 SWE-bench Verified 的智能体 RL。
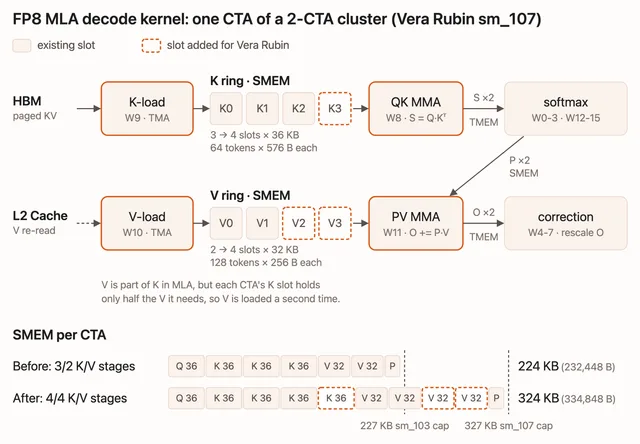
    Deeper MLA pipeline using Vera Rubin shared memory

    #教程/实践#部署/工程#推理

  4. Artificial Analysis解读
    AI 评分55

    Grok Imagine Video 1.5 Lite 在 AA-Video-T2V v2.0 上排名超过 Google Veo 3.1,价格约为其三分之一

    Artificial Analysis 的 AA-Video-T2V v2.0 榜单显示,Grok Imagine Video 1.5 Lite 排名第 17,比 Google Veo 3.1 高两位。在 1080p 带音频条件下,Grok Imagine Video 1.5 Lite 每秒 0.14 美元,Veo 3.1 为每秒 0.40 美元。相比 Grok Imagine Video 1.5,Lite 在 1080p 下便宜 44%,但排名低六位。

    同一事件 · 3 条报道

    #评测/基准#视频#xAI

  5. Artificial Analysis解读
    AI 评分51

    Grok Imagine Video 1.5 Lite 在 AA-Video-T2V-Silent v2.0 上处于质量与速度前沿

    Artificial Analysis 在 AA-Video-T2V-Silent v2.0 上评测的 12 个模型中,Grok Imagine Video 1.5 Lite 在质量与速度上均无对手同时超越,生成 10 秒 1080p 视频中位耗时 60.5 秒。Kling 3.0 1080p (Pro) 质量略高,但生成 5 秒视频需 94 秒;Vidu Q3 Turbo 生成 5 秒 720p 视频快 9 秒,但质量明显更低。

    #评测/基准#视频#xAI

  6. Hugging Face一手解读
    AI 评分62

    作者用 ML Intern 提示词在两天内训练出六个模型

    Hugging Face 博主 yvrjsharma 公开了自己使用 ML Intern 的七个提示词,并展示两天内完成的六个项目,包括基于 Qwen3.5-2B 的柑橘病害 VLM、FLUX.2 klein 4B 的 Huggy 角色 LoRA、Qwen-Image 2.1 的相机视角 LoRA 与涂鸦 LoRA、Pocket Rewriter 0.8B/2B 蒸馏模型,以及把 Agate Preview 002 从 50 步蒸馏到 4 步的版本。作者建议提示词中写明已验证事实、要求训练前基线和带检查的冒烟测试,并设置花费上限,例如柑橘项目限定 12 美元。所有提示词已放在 GitHub 的 yvrjsharma/ml-intern-prompts,ML Intern 模式可在 HuggingChat 中开启使用。

    #教程/实践#Agent#数据/训练

  7. Anthropic解读
    AI 评分57

    天体物理学家用 Claude 生成首张完整紫外天图

    天体物理学家 Brice Ménard 与 Claude Science 合作,制作出首张完整的紫外天图。他引导 Claude 查找已有数据集、将其合并,并用统计推断补全天空未被观测的区域,这项工作原本需要人类数周,借助 Claude 只用了几天,且他同时还在处理其他项目。Anthropic 称这张图是实用的教学工具,也说明这类缓慢、低优先级的科研工作如今因 AI 变得可行。

    同一事件 · 2 条报道

    #论文/研究#多模态#Anthropic

  8. Arena解读
    AI 评分66

    Claude Haiku 5.5 在 Code Arena WebDev 首测第 30 名,1587 分

    Arena 公布 Claude Haiku 5.5(High)在 Code Arena: WebDev 的实测结果,以 1587 分首次上榜排在第 30 名,位于帕累托前沿之外但成本效率突出。其价格为每 100 万输入/输出 token 0.10/0.50 美元,与 GPT-6 Luna 持平,得分高出 6 分。相比其他 Claude 模型,Haiku 5.5 比 Haiku 4.5 成本低 90% 且高 257 分,比 Sonnet 5.5(High)低 95% 但低 128 分,比 Opus 5(High)低 98% 但低 70 分,比 Fable 5.1(Max)低 99% 但低 157 分。

    Introducing Claude Haiku 5.5: the cheapest, fastest, and most capable small model we’ve ever released. On average, it costs around 75% less to run than Claude Haiku 4.5. https://t.co/jm06cZJfkV

    #评测/基准#编码#Anthropic