N全部新闻

星期三1 条

  1. Anthropic:Claude.dev 开发者博客一手
    AI 评分83

    Claude Code 团队成员为何用 HTML 替代 Markdown 生成输出

    Claude Code 团队成员分享了用 HTML 替代 Markdown 生成规划、代码审查、原型和报告的方法,以获得更高的信息密度、视觉清晰度、可分享性与交互能力。用户只需提示 Claude Code 创建 HTML file 或 HTML artifact,也可结合文件系统、MCP、浏览器和 git history 汇集上下文。文章还建议为定制编辑界面加入 copy as JSON、copy as prompt 等导出功能,让调整结果能够返回 Claude Code 或写入文件。

    Eight kinds of information a single HTML file can carry: tables, design, illustrations, code, interaction, workflows, spatial layouts and images.

    #教程/实践#编码#Agent

星期二1 条

  1. Together AI Blog一手解读
    AI 评分50

    大规模推理基准测试:编码智能体

    Together Inference Engine 在 Kimi K2.5 编码智能体负载下,以相同的 4× NVIDIA B200 硬件实现了比 TensorRT-LLM 高 31% 的 TPS,并在饱和时保持约 2 倍更优的 TTFT。测试采用约 45k–200k Token 的长提示词和平均 450 Token 的输出;SGLang 因 TP4 内存不足改用 8× B200。性能提升来自 ThunderMLA、定制内核重写及真实流量下的端到端分析。

    Bar chart titled Coding agents with pink and orange bars on dark background with code snippets behind.

    #评测/基准#编码#部署/工程

星期六2 条

  1. Ahead of AI解读
    AI 评分62

    近期大语言模型架构进展解析:KV 共享、mHC 与压缩注意力

    文章解析 Gemma 4、Laguna XS.2、ZAYA1-8B 和 DeepSeek V4 如何通过 KV 共享、分层注意力预算、mHC 与压缩注意力降低长上下文成本。Gemma 4 E2B 在 128K 上下文中可节省 2.7 GB KV cache,DeepSeek V4-Pro 在 1M-token 上下文下的单 token 推理 FLOPs 和 KV cache 分别降至 DeepSeek V3.2 的 27% 和 10%。这些设计显示 Transformer 架构正以更复杂但更具针对性的改动提升长上下文推理效率。

    #教程/实践#部署/工程#推理

  2. Augment Code 博客一手解读
    AI 评分66

    Augment Code 评测 Auggie 与 Claude Code 在 Opus 4.7 上的成本与质量

    Augment Code 在 Terminal Bench 2.0 和 SWE-Bench Pro 上对比了 Auggie CLI 与 Claude Code 使用 Opus 4.7 的表现,Auggie 通过更精准的上下文检索减少约 32% 的 token 消耗,成本降低约 33%,通过率略高。在私有代码库测试中,Auggie 每个通过任务的成本为 3.90 美元,低于 Claude Code 的 6.49 美元。

    Opus 4.7 for 33% less: How Auggie beats Claude Code on cost and quality

    #评测/基准#编码#Agent

星期四1 条

  1. Together AI Blog一手
    AI 评分66

    Violin:打破语言障碍的开源视频翻译技能

    Together AI 推出完全开源的 Violin 视频翻译工具,通过 ASR、大语言模型翻译和 TTS 语音合成生成译制视频。它还支持基于音视频内容的多模态问答和自然语言选声,不提供声音克隆,并默认以低音量保留原声。GUI、后端模型与智能体技能均以 MIT 许可证开放。

    #开源/仓库#视频#多模态

星期二1 条

  1. Modal 官方工程博客一手解读
    AI 评分57

    Modal 如何实现真正的无服务器 GPU

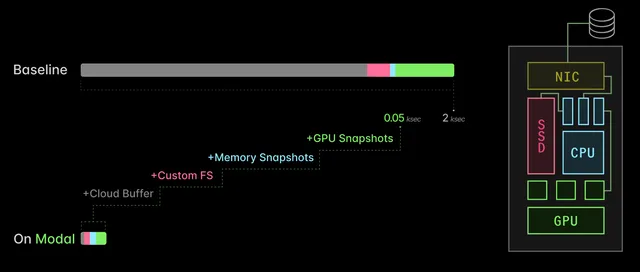
    Modal 官方工程博客详解其无服务器 GPU 方案,通过云缓冲、自定义文件系统 ImageFS、CPU 检查点恢复和 CUDA 检查点恢复四项优化,把 AI 推理服务副本的启动时间从约 2000 秒缩短到 50 秒,提速 40 倍。其中 GPU 内存快照让 vLLM 或 SGLang 服务约 1 GiB 模型(Qwen 3 0.6B bf16)的冷启动典型提速 4-10 倍,Reducto 的冷启动从约 70 秒降到约 12 秒。作者称该技术栈已在数千万个副本规模上运行,过去三个月有数百家组织使用 CPU 和 GPU 快照。

    Diagram indicating latency to scale up an inference server in a baseline cloud system and on Modal

    #教程/实践#部署/工程#端侧

星期一1 条

  1. Together AI Blog一手解读
    AI 评分73

    服务 DeepSeek-V4:为何百万 Token 上下文是推理系统问题

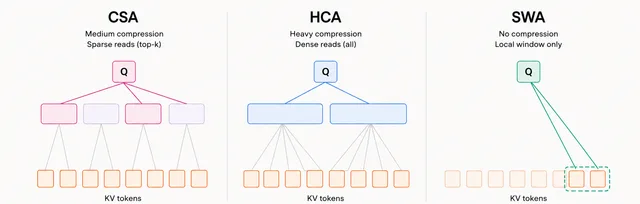
    DeepSeek-V4 通过 CSA、HCA 与 SWA 混合注意力在 KV 存储前压缩上下文,支持 1M-token 上下文窗口,但实际效率取决于推理引擎的缓存管理。Together AI 在 NVIDIA HGX B200 上调整 SWA 缓存策略后,将单节点 KV 缓存容量从约 1.2M tokens 提升至 3.7M tokens。长上下文、解码密集型任务最先受益,短上下文任务仍更依赖预填充优化与内核成熟度。

    Three diagrams comparing CSA, HCA, and SWA methods with different compression and KV token reads.

    #教程/实践#DeepSeek#部署/工程

星期六1 条

  1. Browser Use一手解读
    AI 评分53

    Browser Use 开源库的生产架构:SQS 到 Lambda 的工程实践

    Browser Use 官方博客公开了其开源库在生产环境运行的架构,采用 FastAPI on ECS Fargate 接收任务、单条标准 SQS 队列传递消息、Lambda 作为 worker 执行 Agent,并将检查点、截图、日志和输出文件存入 S3。由于 Lambda 有 15 分钟硬限制,系统在截止前两分钟优雅停止、将状态写入 S3 并重新入队,由新的 Lambda 调用恢复继续执行,continuation 计数器上限为 12,约合三小时墙钟时间。失败处理直接复用 Lambda 重试与 SQS 死信队列,三次失败后进入 DLQ 且不自动重投;作者还提到 Lambda 的 /tmp 在热实例间不会自动清理,因此每次调用开始时清空工作区。

    #教程/实践#Agent#部署/工程

星期五1 条

  1. Together AI Blog一手解读
    AI 评分65

    如何在 Together DCI 上部署任意 Hugging Face 模型并运行推理

    Together AI 展示了如何用 Goose 和 together-dedicated-containers 技能,在单次会话中将 Netflix 的 void-model 部署至 Dedicated Container Inference。智能体可自动生成推理服务与容器配置;该模型能移除视频中的对象及其引发的阴影、反射和物理交互,推理任务以异步方式返回结果。

    Terminal screen showing void-byoc goose session ready with deployment note and URL to huggingface.co.

    #教程/实践#部署/工程#Agent

星期一2 条

  1. goose 官方博客一手解读
    AI 评分64

    goose 搭配 MiniMax M2.5 在 OfficeQA 上以约 1/30 成本接近前沿模型

    goose 官方博客称,用 goose 搭配 MiniMax M2.5 在 Databricks 的 OfficeQA 基准上接近前沿模型表现,成本约为 1/30。闭源模型在准确率上占优(约 80% 对约 70%),但 MiniMax M2.5 平均每次运行 1.74 美元,Opus 4.5 为 56.53 美元。改用 goose 的 harness 后准确率比替代方案高约 10%,成本低 8 倍;在 Terminal Bench 2.0 上,goose 的 token 效率比 OpenHands 高 20 倍,成本比 OpenCode 低 40 倍以上。

    #评测/基准#Agent#开源生态

  2. Together AI Blog一手解读
    AI 评分44

    支撑大规模高效推理的基础研究

    Together AI 介绍其通过算法、系统工程和硬件协同优化大规模推理的方法,旨在提升速度与成本效率,同时维持输出质量和可靠性。生产 AI 系统的推理约占全生命周期成本的 80–90%,尽管 GPT-3.5 水平的推理成本曾下降逾 280 倍,总支出仍随用例扩张而增长。其技术包括可实现 1.5–3x 加速的推测解码,以及 ATLAS 和开源 RL 框架 Aurora 所支持的自适应推测解码。

    #论文/研究#部署/工程#Agent

星期四2 条

  1. Anthropic:Claude.dev 开发者博客一手解读
    AI 评分85

    Claude Code 团队总结 AI 智能体提示词缓存的优化经验

    Claude Code 团队总结了构建长时运行 AI 智能体时优化提示词缓存的实践,核心是保持请求前缀稳定,以降低延迟和成本。具体做法包括静态内容前置、通过消息传递更新、不在会话中途更换工具或模型,以及用 defer_loading 延迟加载工具。执行上下文压缩时,应沿用父会话的系统提示词、上下文和工具定义,使已有缓存前缀能够复用。

    System Prompt Layout, top to bottom: base system instructions and tools (globally cached), CLAUDE.md and memory (cached per project), session state such as env, MCP and output style (cached per session), and messages, which grow each turn.

    #教程/实践#Agent#部署/工程

  2. Google Research一手解读
    AI 评分51

    Google Research 科学家使用 Empirical Research Assistance 的四种方式

    Google Research 介绍了其科学家在流行病预测、宇宙学、大气二氧化碳监测和神经科学四个领域使用 Empirical Research Assistance(ERA)的实践。在流行病预测中,团队每周向 CDC 的流感、COVID-19 和 RSV 预测项目提交全美各州、最长提前四周的预测,公开排行榜显示其表现处于或接近榜首;在宇宙学中,团队将 ERA 与 Gemini Deep Think 结合,推导出六个通解和渐近极限的简洁公式;在大气监测中,ERA 开发的单像素物理引导神经网络利用 GOES East 数据,每 10 分钟估算一次柱平均 CO2 浓度;在神经科学中,ERA 基于 simZFish 的连接图提出了可解释且机制准确的神经回路。这些项目显示 LLM 支持的系统可加速科学发现,ERA 正接近更广泛的可用性。

    Four ways Google Research scientists have been using Empirical Research Assistance

    #论文/研究#数据/训练#Google

星期二1 条

  1. Together AI Blog一手解读
    AI 评分55

    容量无冲突:面向 AI 原生团队的多租户 GPU 集群设计指南

    Together AI 介绍了多租户 GPU 集群的设计方法:在底层集中管理计算、存储和网络资源,同时为各团队提供专用 GPU 节点、存储卷及独立凭据。平台通过硬配额、预约防冲突和按需扩容减少闲置与跨团队干扰,并支持 Kubernetes、Slurm、CUDA 驱动和存储配置按工作负载选择。节点交付前还应通过 DCGM、GPU burn、NCCL 和 NVBandwidth 测试,故障时执行重新配置或集群迁移。

    #教程/实践#部署/工程#数据/训练

星期六1 条

  1. Ahead of AI
    AI 评分59

    Sebastian Raschka 分享理解 LLM 架构的工作流

    Sebastian Raschka 分享了理解开放权重 LLM 架构的手工工作流,通常先阅读官方技术报告,再检查 Hugging Face Model Hub 上的配置文件和 Python transformers 参考实现,以补足论文缺失的架构细节。该方法不适用于权重和技术细节未公开的 ChatGPT、Claude 或 Gemini。

    #教程/实践#数据/训练#开源生态

星期三1 条

  1. Modal 官方工程博客一手解读
    AI 评分52

    如何用 Modal 和 OpenAI Agents SDK 搭建自定义编码智能体

    Modal 官方工程博客发布教程,演示如何在 OpenAI Agents SDK 之上从零搭建自定义编码智能体框架,并接入 Modal Sandboxes 为智能体提供可运行代码甚至 GPU 的隔离环境。教程逐步加入 Session 记忆、orchestrator 与 subagent 分工、异步 SubAgentPool 并行、GPU 配额限制、文件系统快照去重以及 Skills 插件,最终实现可在 GPU 上并行运行 OpenAI Parameter Golf 实验的通用编码框架。文中提到 Ramp 在 Modal 上构建的后台编码智能体已负责其超过一半的 PR。

    #教程/实践#Agent#部署/工程

星期五2 条

  1. Linear:Now一手
    AI 评分59

    Linear 团队如何使用 Linear Agent 推进产品开发

    Linear 团队介绍了三类 Linear Agent 工作流,将客户邮件、Slack 讨论和产品经理发现的问题转化为 issue、代码修改及 pull request。团队让智能体在 Intercom、Slack 和 Linear 等工作发生处获取上下文,并结合 Code Intelligence、定制 MCP servers 和编码智能体协助排查与开发。Linear 认为更有效的做法是把任务拆成小而明确的步骤,先观察表现并补充指导,再逐步提高自主程度。

    Symmetrical white lines and dots radiating from a bright central point on a black background.

    #教程/实践#Agent#编码

  2. Anthropic:Claude.dev 开发者博客一手解读
    AI 评分77

    Claude Code 团队如何从智能体视角设计工具

    Anthropic 的 Claude Code 团队介绍了如何从模型视角设计、测试并持续调整智能体工具。团队用 AskUserQuestion 取代不稳定的文本格式方案,以 Task 替换限制模型协作的 TodoWrite,并从预索引 RAG 转向由 Claude 主动搜索代码库、通过技能渐进获取上下文。Claude Code 目前约有 20 个工具,团队还用独立子智能体检索产品文档,以保持主智能体上下文简洁。

    Diagram titled "Finding the sweet spot": a spectrum from "no structure" to "too rigid". Modified markdown output sits near "no structure" (free but messy, hard to format). An ExitPlanTool parameter sits near "too rigid" (the plan is already formed, so the questions come too late). The AskUserQuestion tool is highlighted in the middle (structured, composable, with a clear UI surface).

    #教程/实践#Agent#编码

星期六1 条

  1. Ahead of AI解读
    AI 评分76

    Sebastian Raschka 详解编码智能体的六大核心组件

    Sebastian Raschka 将编码智能体拆解为实时仓库上下文、提示词与缓存复用、工具调用、上下文压缩、结构化会话记忆和受限子智能体六个组件。他以纯 Python 实现的 Mini Coding Agent 为例,说明智能体框架如何管理代码上下文、工具、执行与迭代反馈,并比较了编码智能体与 OpenClaw 的定位差异。

    #教程/实践#Agent#编码

星期二1 条

  1. Together AI Blog一手
    AI 评分73

    Aurora:从实时推理轨迹持续学习的开源推测解码框架

    Together AI 发布 Aurora,通过强化学习从实时推理轨迹持续更新推测解码的草稿模型,相比训练良好的静态模型额外加速 1.25x,更新期间不中断服务。在涵盖五个领域的 40,000 条提示词混合流实验中,从零开始在线训练的接受长度达 3.08,高于静态基线的 2.63 和预训练后微调方案的 2.99,吞吐量稳定在 302.3 tokens/s。

    #开源/仓库#推理#部署/工程