N全部新闻

星期三1 条

  1. Amp Chronicle一手
    AI 评分62

    Amp 支持 Agent Skills,可按需加载本地工具使用指令

    Amp 支持 Agent Skills,让 AI 智能体按需加载使用本地工具的特定指令,以更高效地利用上下文并改善工具调用表现。Skills 默认安装在工作区的 `.agents/skills/`,同时兼容用户级目录及现有 Claude Skills;团队还列出了 Agent Sandbox、BigQuery、Tmux 和 Web Browser 等实用技能。

    #产品更新#Agent#MCP/工具调用
星期三1 条

  1. Ahead of AI解读
    AI 评分79

    DeepSeek V3 至 V3.2 模型技术演进全览

    DeepSeek V3.2 延续 V3 系列架构,并引入 DeepSeek Sparse Attention、自验证、自改进及多项 GRPO 训练调整。文章梳理了 V3、R1、V3.1、V3.2-Exp、DeepSeekMath V2 和 V3.2-Speciale 的演进,解释 MLA、RLVR 与混合推理模式等关键机制。更新部分还介绍了用于改善训练稳定性和收敛表现的 mHC 残差路径研究。

    #教程/实践#推理#数据/训练

星期三1 条

  1. Anthropic Engineering一手解读
    AI 评分68

    Anthropic 分享长时运行智能体的 harness 设计

    Anthropic 工程博客介绍了让 Claude Agent SDK 跨多个上下文窗口持续工作的两段式方案:首个会话由 initializer agent 搭建环境,包括 init.sh 脚本、claude-progress.txt 进度日志和初始 git commit,后续每个会话由 coding agent 只推进一个功能并留下结构化更新。文章指出,即便 Opus 4.5 在 Claude Agent SDK 上循环运行,仅给高层提示也会出现一次性做完整个应用和过早判定完成两类失败,因此用 JSON 格式的功能清单标记 passes 状态,并要求智能体用 git 提交和进度文件保持环境整洁。测试环节需显式提示使用浏览器自动化工具做端到端验证,作者也提到 Claude 视觉与浏览器自动化工具的限制仍会漏掉部分 bug。

    #教程/实践#Agent#部署/工程

星期二1 条

  1. Johann Rehberger / Embrace The Red解读
    AI 评分77

    Google Antigravity IDE 被曝五类安全漏洞,含远程命令执行与数据外泄

    安全研究者 Johann Rehberger 在 Google 新发布的 Antigravity IDE 中发现五个安全漏洞,包括通过间接提示注入实现的远程命令执行和数据外泄,其中部分问题可追溯到 2025 年 5 月他向 Windsurf 报告过的同类缺陷。Antigravity 默认由 AI 自行判断终端命令是否安全执行,且 MCP 工具调用完全没有人工确认环节,攻击者可利用不可见的 Unicode Tag 字符在源码或 Linear 工单中隐藏指令。作者建议禁用自动执行、谨慎启用 MCP 服务器,并指出 Claude Code、GitHub Copilot、Cursor、Codex 等编码智能体在安全性和补丁历史上更成熟。

    #安全/对齐#Agent#MCP/工具调用

星期三1 条

  1. One Useful Thing解读
    AI 评分70

    从 GPT-3 到 Gemini 3:Ethan Mollick 实测三年 AI 进展

    Ethan Mollick 实测 Google 新发布的 Gemini 3,用同一提示词让模型把三年前只能写诗的演示变成可玩的互动游戏,并称其在多数基准上取得领先。他还测试了随 Gemini 3 一同发布的编程工具 Antigravity,让它自主完成网页研究、建站并在浏览器中验证;随后又让 Gemini 3 清理十年前众筹研究的旧数据文件,自主提出假设、做统计分析并写出 14 页论文,还自创了一个衡量众筹创意独特性的指标。他认为这些工具仍有需要人工纠正的判断问题,但人机关系正从修复 AI 错误转向指挥 AI 工作。

    #行业动态#Agent#编码

星期一1 条

  1. vLLM 官方博客一手
    AI 评分52

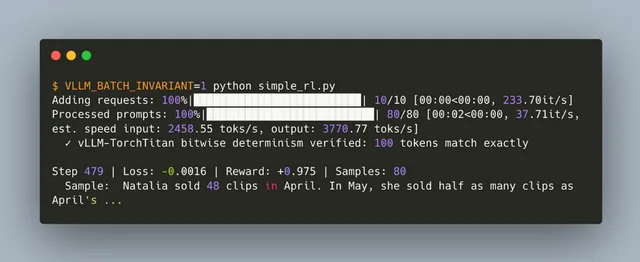
    vLLM 与 TorchTitan 实现训练推理逐位一致的在线强化学习

    vLLM 与 TorchTitan 开源展示了逐位一致的在线强化学习方案,使 Qwen3 1.7B 的训练与推理数值完全匹配。实验中启用逐位一致性后,模型用更少步骤取得更高总奖励,但当前运行速度比非逐位一致方案慢 2.4x。

    #论文/研究#数据/训练#部署/工程

星期四1 条

  1. Baseten 工程博客一手解读
    AI 评分61

    用于牙科笔记记录的专用大语言模型

    Baseten 微调了一款牙科笔记专用模型,以单个 rank 256 LoRA adapter 完成临床笔记生成、实时补充和笔记修改三项任务,准确率媲美 gemini-2.5-pro,响应速度快 5–6 倍。团队使用 Lumina 评估器和 iSFT 处理 30,000 个训练样本,并通过合成数据生成超过 50,000 个样本,使模型在四种牙位标记系统评测中达到 90% 准确率。

    purpose built LLM

    #教程/实践#数据/训练#部署/工程

星期二3 条

  1. Ahead of AI解读
    AI 评分60

    标准 LLM 之外有哪些替代架构

    Sebastian Raschka 梳理了标准自回归 Transformer 之外的线性注意力混合架构、文本扩散模型、代码世界模型和小型递归 Transformer。文章比较了这些路线在长上下文效率、生成质量、代码建模和专用推理上的取舍,并认为通用项目目前仍应优先采用成熟的自回归 Transformer。

    #教程/实践#推理#编码

  2. Modal 官方工程博客一手解读
    AI 评分54

    Modal 用 Pipecat 和开源模型实现一秒内语音到语音延迟

    Modal 工程博客介绍了如何用 Modal、开源框架 Pipecat 和开源权重模型搭建语音 AI 聊天机器人,在客户端与容器就近部署时实现约一秒的中位语音到语音延迟。方案采用 Parakeet-tdt-v3 做语音转文字、Qwen3-4B-Instruct-2507 配合 vLLM 做 LLM 推理、Kokoro 做语音合成,并用 ChromaDB 与 all-minilm-l6-v2 完成 RAG 检索。作者还分享了用 Modal Tunnels 绕过输入平面降低网络延迟、通过区域固定和独立自动扩缩容控制成本的做法,代码已在 GitHub 仓库公开。

    Diagram depicting a person speaking to a voice bot composed of STT, LLM, and TTS services

    #教程/实践#语音#部署/工程

  3. Anthropic Engineering一手解读
    AI 评分70

    Anthropic 工程博客:用代码执行让 MCP 智能体更高效

    Anthropic 工程博客提出用代码执行替代直接工具调用,把 MCP 服务器呈现为文件系统上的代码 API,让智能体按需加载工具定义并在执行环境中过滤数据。文中给出的 Google Drive 到 Salesforce 示例把 token 用量从 150,000 降到 2,000,节省 98.7%。文章还介绍了渐进式披露、结果过滤、隐私保护与状态持久化等做法,并提醒运行智能体生成的代码需要沙箱、资源限制和监控。

    #教程/实践#MCP/工具调用#Agent

星期日1 条

  1. Mario Zechner 原创博客
    AI 评分76

    不使用 MCP,如何用 Bash 和代码构建轻量智能体工具

    Mario Zechner 提出,许多智能体任务无需 MCP,可让编码智能体通过 Bash 调用简洁的 CLI 工具并编写代码。其浏览器工具以 Puppeteer Core 实现启动、导航、执行 JavaScript 和截图等能力,README 仅占 225 tokens;相比之下,Playwright MCP 的 21 个工具占 13.7k tokens,Chrome DevTools MCP 的 26 个工具占 18.0k tokens。这种方式可按需载入说明、串联调用并快速修改输出格式或增加工具,但需要自行设计和维护工具结构。

    #大佬观点#MCP/工具调用#Agent

星期四1 条

  1. Linear:Now一手
    AI 评分51

    Linear 如何通过持续规划衔接产品发现、规划与执行

    Linear 采用持续规划流程,将持续收到的客户需求和产品想法整理为候选项目,再按客户请求数量、收入影响、季度目标等因素确定优先级。团队使用智能分流建议识别相关或重复需求,并以项目作为连接发现、规划、日常执行和进度管理的统一载体。

    Abstract illustration of concentric loops alluding to continuous planning

    #教程/实践#Agent#部署/工程

星期二1 条

  1. vLLM 官方博客一手解读
    AI 评分67

    vLLM 上 Kimi K2 工具调用准确率的深度调试

    vLLM 与 Kimi 团队修复了 Kimi K2 的关键工具调用兼容问题,使成功解析的调用数从 218 个增至 971 个,提升 4.4x。问题涉及缺失 add_generation_prompt、空 content 的结构转换,以及历史工具调用 ID 不符合 functions.func_name:idx 格式。修复后仍出现 316 次 schema_validation_error_count,团队正协作将用于约束工具选择的 Enforcer 组件集成到 vLLM。

    #教程/实践#MCP/工具调用#部署/工程

星期日1 条

  1. vLLM 官方博客一手解读
    AI 评分69

    vLLM Sleep Mode 如何实现模型零重载切换

    vLLM Sleep Mode 通过保留进程、内存分配器、CUDA 图和 JIT 内核,将多模型切换从完整重载的 30-100+ 秒缩短至秒级或亚秒级。Level 1 将权重卸载到 CPU RAM,Level 2 丢弃权重并在唤醒时从磁盘重载;两种模式的切换速度比完整重载快 18-200x,预热模型的推理速度比冷启动快 61-88%。

    #产品更新#部署/工程#开源生态

星期四1 条

  1. vLLM 官方博客一手解读
    AI 评分52

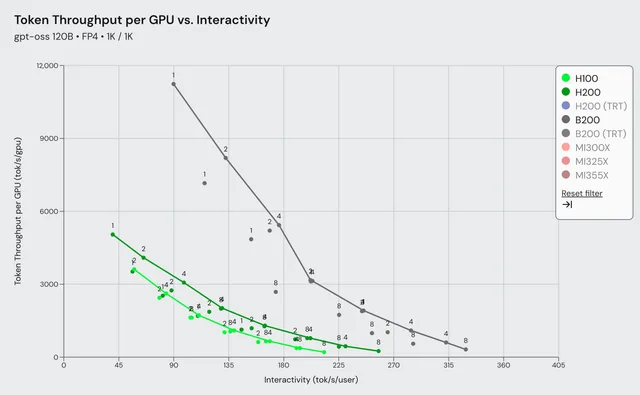
    SemiAnalysis InferenceMAX 评测解析:vLLM 与 NVIDIA 加速 Blackwell 推理

    vLLM 与 NVIDIA 针对 Blackwell 优化大语言模型推理,在相近延迟下,gpt-oss 120B 和 Llama 3.3 70B 的吞吐量较上一代 Hopper 最高提升约 4x。双方通过一百多个 pull request 优化注意力、GEMM、MoE 内核、图融合和异步调度,并加入自动量化后端选择与 FlashInfer 自动调优。SemiAnalysis InferenceMAX 每日更新测试结果,以不同输入输出长度和 Pareto 前沿比较吞吐量与响应速度。

    #评测/基准#部署/工程#开源生态

星期日1 条

  1. Ahead of AI解读
    AI 评分72

    从零理解 LLM 评估的四种主要方法

    文章讲解评估 LLM 的四种主要方法,包括多项选择、验证器、排行榜和 LLM 评审,并配有从零代码实现。不同方法分别侧重知识准确率、可验证任务、用户偏好和整体回答质量,各有成本、偏差与适用范围,因此模型评估应组合多种方法,并使用贴合目标领域的数据。

    #教程/实践#评测/基准#推理

星期一1 条

  1. Anthropic Engineering一手解读
    AI 评分63

    Anthropic 谈 AI 智能体的有效上下文工程

    Anthropic 应用 AI 团队撰文提出上下文工程,将其视为提示词工程的延续,核心是在 LLM 有限的注意力预算内挑选最小的高信号 token 集合。文章指出随着上下文 token 增多,模型准确召回信息的能力会下降,即上下文衰减,因此系统提示词、工具、示例和消息历史都应保持信息充分而紧凑。针对长周期任务,文章介绍了压缩、结构化笔记和多智能体架构三种绕开上下文窗口限制的做法,并提到 Claude Code 采用即时检索与预加载结合的混合策略。

    #教程/实践#Agent#MCP/工具调用

星期四1 条

  1. Anthropic Engineering一手解读
    AI 评分60

    Anthropic 工程团队分享如何为智能体编写高效工具

    Anthropic 工程团队发布文章,介绍为 LLM 智能体编写高效工具的流程:先搭建工具原型并在本地测试,再用贴近真实场景的评测任务衡量表现,最后借助 Claude Code 分析评测记录并迭代改进。文章给出的原则包括只实现少量针对高价值工作流的工具、用命名空间区分功能边界、只返回高信号上下文、通过分页与截断控制 token 消耗,以及像向新同事介绍那样提示词工程化地写工具描述。文中提到 Claude Code 默认将工具响应限制在 25,000 tokens,并称在精确改进工具描述后 Claude Sonnet 3.5 在 SWE-bench Verified 上达到 SOTA。

    #教程/实践#Agent#MCP/工具调用

星期六1 条

  1. Ahead of AI解读
    AI 评分58

    从零理解并实现 Qwen3

    作者用纯 PyTorch 从零实现 Qwen3,通过代码讲解其架构组件,并提供可用于实验或项目的构建模块。文章还介绍了 Qwen3 的 Apache License v2.0 许可,以及从 0.6B 稠密模型到 480B 参数 MoE 模型的多种规模。

    #教程/实践#编码#数据/训练

星期五1 条

  1. vLLM 官方博客一手解读
    AI 评分61

    深入 vLLM:高吞吐 LLM 推理系统架构解析

    文章系统解析 vLLM V1 如何从单 GPU 离线推理扩展到多 GPU、多节点异步服务。内容涵盖调度器、PagedAttention、连续批处理、前缀缓存、引导解码、推测解码、P/D 分离及分布式请求链路,并说明如何用 vllm bench 衡量延迟与吞吐量。分析基于 2025 年 8 月 9 日的 commit 42172ad。

    #教程/实践#部署/工程#开源生态