←搜索结果

按匹配度 · 共 1368 条结果 清除搜索

星期五

  1. DeepLearning.AI · Andrew Ng 来信

    DeepSeek-V4-Flash 超越 Pro 版本,迄今最大 GitHub 抓取,为更安全代码设计系统提示词

    DeepSeek-V4-Flash-0731 在架构不变的情况下通过新一轮微调,在独立测试中超越更大的 DeepSeek-V4-Pro,Artificial Analysis 智能指数达 50 分,仅比 GPT-5.6 Luna 最高推理模式低 1 分。该模型为 284B 总参数、13B 激活参数的 MoE 架构,支持最高 100 万 token 输入与 384,000 token 输出,MIT 许可下权重可免费商用,API 价格为每百万输入/缓存/输出 token $0.14/$0.0028/$0.28。

    匹配字段标题、摘要

星期四

  1. Together AI Blog

    DeepSeek-V4 Flash 0731 与 GPT-5.6 Luna 在 DeepSWE 上的成本与编码对比

    Together AI 在全部 113 个 DeepSWE 任务上对比 DeepSeek-V4 Flash 0731 与 GPT-5.6 Luna,每个任务四次试验。Luna 的 pass@1 为 67.2%,高于 DeepSeek 的 53.3%,但单次成本约 0.61 美元,是 DeepSeek 约 0.10 美元的六倍。先用 DeepSeek 再在测试失败时升级到 Luna 的级联方案解决 78.9% 的任务,每任务成本 0.385 美元,准确率高于 Luna 单用且成本更低。

    匹配字段标题、摘要、正文

星期日

  1. Recode China AI

    中国 AI 周报:CXMT 上海 IPO 大涨472%,Kimi K3 开放权重,DeepSeek 投资者纪要走红

    Recode China AI 汇总2026-07-25至2026-08-01的269篇报道,重点涵盖CXMT上海 IPO 一度上涨472%、Kimi K3全面开放权重,以及DeepSeek暂停融资并发布V4。同期MiniMax H3、Seedance 2.5等模型集中亮相,中美围绕中国开放权重模型与芯片获取的政策争论继续升温。

    Tony Peng's avatar

    匹配字段标题、摘要、正文

星期六

  1. Unsloth精选

    Unsloth 支持 DeepSeek V4 Flash 0731 本地运行

    Unsloth 宣布 DeepSeek V4 Flash 0731 现已可在本地运行,无损 4-bit 量化需 168GB 内存,3-bit 需 110GB 内存,可通过 Unsloth 或 llama.cpp 运行,并提供了指南和 GGUF 链接。Unsloth 称 V4 Flash 0731 表现优于 V4 Pro,更小的量化版本当天晚些时候发布。DeepSeek 官方此前宣布 DeepSeek-V4-Flash 官方 API 进入公开测试,Agent 能力大幅升级,基准分数超过 V4-Pro-Preview,并原生支持 Responses API 格式、适配 Codex。

    匹配字段标题、摘要、正文

星期五

星期四

  1. Recode China AI精选

    梁文锋谈 AGI、算力与 DeepSeek 坚持开源的原因

    DeepSeek CEO 梁文锋在投资者会议上阐述了公司的 AGI 路线、算力瓶颈、开源策略与商业化思路,并将持续学习视为下一代模型的核心能力。他认为当前路线将从 Agent 走向持续学习、自我迭代和具身智能,同时表示最强模型也可能开源,且开源不会影响公司的商业模式。

    Tony Peng's avatar

    匹配字段标题、摘要、正文

星期五

  1. LMSYS Blog

    LMSYS 在 AMD Instinct MI355X 上用 Miles 跑通 DeepSeek-V4 Flash RL 训练

    LMSYS 宣布 DeepSeek-V4 Flash 的 RL 训练已在 Miles 中支持 AMD Instinct MI355X GPU 与 ROCm,完成四节点端到端验证。该模型为 284B 参数 MoE、每 token 激活 13B,团队解决了 SGLang rollout 与 Megatron 训练之间的 log-probability 对齐、量化权重在线更新语义保持,以及 ROCm 多节点并行策略三个问题。在四台八卡 MI355X 上跑过 100+ 优化步,train-rollout 平均绝对 log-probability 差约 0.09,离线 AIME-2024 pass@1 从 0.39 升至 0.49、pass@8 从 0.53 升至 0.67。

    匹配字段标题、摘要、正文

星期一

  1. LMSYS Blog精选

    SGLang 集成 DSpark 投机解码,支持 Qwen3 与 DeepSeek-V4

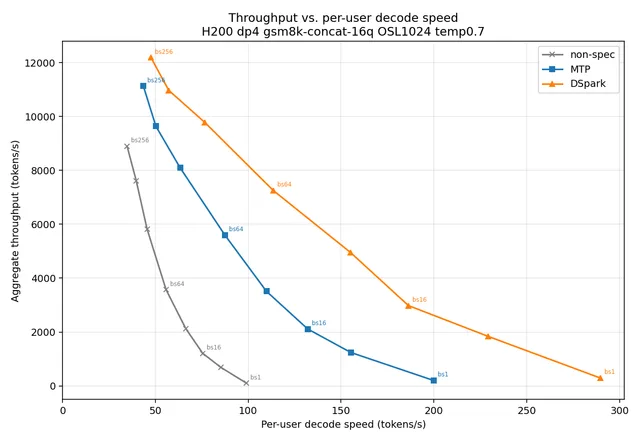
    LMSYS 在 SGLang 中集成 DSpark 投机解码,支持 Qwen3 等稠密模型和 DeepSeek-V4 等稀疏模型,相关实现见 sgl-project/sglang#30261。DSpark 用半自回归块草稿器加置信度头,按每个请求的置信度动态决定验证长度,避免验证不太可能被接受的 token。官方在 DeepSeek-V4-Flash、H200、DP4 上对比非投机与 MTP 基线,并给出 ragged verify 下的完整 CUDA graph、零开销调度和成本表分析等工程细节。

    Aggregate throughput vs. per-user decode speed on H200 dp4, one curve per arm: non-spec floor, MTP, and DSpark. Right-and-up is better; each marker is a batch size averaged over three rounds.

    匹配字段标题、摘要、正文

星期三

  1. Epoch AI:Gradient Updates

    Epoch AI 分析 1604 份中国 AI 招聘启事:DeepSeek、MiniMax 等六家公司在招什么人

    Epoch AI 梳理 DeepSeek、MiniMax、Moonshot、Z.ai、字节跳动和阿里巴巴六家中国 AI 公司的 1604 份招聘启事,发现它们仍依赖 Nvidia CUDA 与 TensorRT-LLM,同时探索昇腾、寒武纪等国产芯片。Z.ai 称其 GLM-Image 已在国产芯片上完成端到端训练,该模型有 160 亿参数。MiniMax、DeepSeek、Moonshot 等初创公司还在自建数据中心,并采用公有云与自建算力混合部署。

    匹配字段标题、摘要、正文

星期六

星期一

  1. Together AI Blog精选

    服务 DeepSeek-V4:为何百万 Token 上下文是推理系统问题

    DeepSeek-V4 通过 CSA、HCA 与 SWA 混合注意力在 KV 存储前压缩上下文,支持 1M-token 上下文窗口,但实际效率取决于推理引擎的缓存管理。Together AI 在 NVIDIA HGX B200 上调整 SWA 缓存策略后,将单节点 KV 缓存容量从约 1.2M tokens 提升至 3.7M tokens。长上下文、解码密集型任务最先受益,短上下文任务仍更依赖预填充优化与内核成熟度。

    Three diagrams comparing CSA, HCA, and SWA methods with different compression and KV token reads.

    匹配字段标题、摘要、正文

星期三

  1. Together AI Blog

    DeepSeek-V4 Pro 现已登陆 Together AI

    Together AI 现已提供 DeepSeek-V4 Pro,Serverless Inference 支持 512K-token 上下文,Dedicated Inference 可提供完整 1M 上下文、预留容量和工作负载隔离。该模型支持三种推理模式,价格为每 1M tokens 输入 $2.10、缓存输入 $0.20、输出 $4.40。

    匹配字段标题、摘要、正文

星期一

星期六

  1. LMSYS Blog精选

    SGLang 与 Miles 为 DeepSeek-V4 提供 Day-0 推理与 RL 训练支持

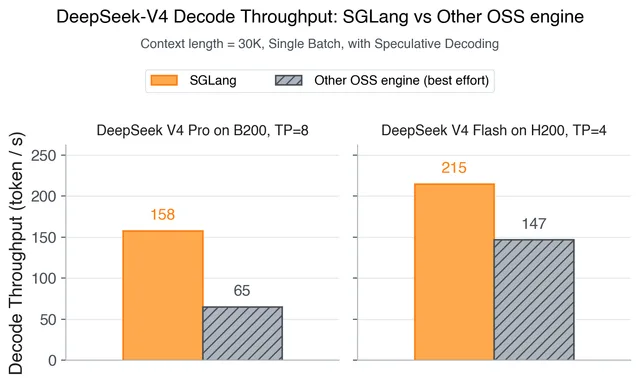
    LMSYS 宣布 SGLang 与 Miles 在 DeepSeek-V4 发布当天提供推理与 RL 训练支持,覆盖 1.6T Pro 和 284B Flash 两个版本。针对 DeepSeek-V4 的混合稀疏注意力、mHC 和 FP4 专家权重,团队引入 ShadowRadix 前缀缓存、HiSparse CPU 扩展 KV、MTP 投机解码等机制,并集成 FlashMLA、FlashInfer TRTLLM-Gen MoE、DeepGEMM Mega MoE 等内核。RL 侧 Miles 支持 DP/TP/SP/EP/PP/CP 六种并行策略与 FP8 训练,已在 32 张 GB300 上完成 285B 模型训练,首步 rollout 与训练 log-prob 偏差约 0.023。

    DeepSeek-V4 decode throughput on Day-0 launch: SGLang vs other OSS engine

    匹配字段标题、摘要、正文

星期三

  1. LMSYS Blog

    SGLang 集成 Elastic EP,为 DeepSeek MoE 部署提供部分故障容错

    LMSYS 在 SGLang 中集成 Elastic EP,通过解耦专家与 GPU 的固定映射并保留冗余专家,实现单实例内的部分故障容错。在 4 节点 32 GPU 上运行 DeepSeek V3.2、设置 ep_size=dp_size=32 与 256 个冗余专家时,可容忍最多 16 个 rank 故障,服务中断控制在 10 秒以内,相比完整重启所需的 2 至 3 分钟减少约 90%,静态性能与标准 DeepEP 持平。启用需配置 --elastic-ep-backend mooncake、--moe-a2a-backend mooncake、--ep-num-redundant-experts 等参数,NVIDIA Dynamo 团队的 NIXL EP 也可通过 --moe-a2a-backend nixl 试用。

    eep-architecture.svg

    匹配字段标题、摘要、正文

星期四

  1. LMSYS Blog

    在 GB300 NVL72 上部署 DeepSeek:长上下文推理大幅提速

    LMSYS 分享了在 GB300 NVL72 上优化 DeepSeek R1-NVFP4 长上下文(128K/8K ISL/OSL)推理的进展,SGLang 实现最高 226 TPS/GPU,较 GB200 提升 1.53 倍。在相同吞吐下 MTP 将单用户吞吐提升 1.87 倍,匹配延迟条件下 GB300 较 GB200 提升 1.38X-1.58X TPS/GPU。GB300 的 288GB HBM 支持 1.6 倍有效解码批大小(40 vs 24 req/GPU),128K 预填充 TTFT 为 8.6s。

    匹配字段标题、摘要、正文