←搜索结果

按匹配度 · 共 3422 条结果 清除搜索

星期日

  1. 事件1 条新闻 · 1 个事实

    Liquid AI发布350M跨语言检索模型

    2025年10月28日,Liquid AI发布LFM2-ColBERT-350M检索模型。该模型为350M参数的晚期交互检索模型,支持跨语言检索,即文档用一种语言存储、查询用另一种语言也能高精度召回。在扩展了日语和韩语的NanoBEIR基准上,其多语言能力显著强于150M参数的GTE-ModernColBERT-v1,德语、阿拉伯语、韩语和日语提升明显,同时保持英语表现。凭借LFM2骨干,其推理吞吐与体积小2.3倍的模型相当。模型已在Hugging Face上线并附交互demo,可直接替换现有RAG流程。

    匹配字段摘要

  2. 事件1 条新闻 · 1 个事实

    Liquid AI发布Liquid Nanos端侧模型系列

    2025年9月25日,Liquid AI发布Liquid Nanos系列任务专用端侧基础模型,参数规模从350M到2.6B,占用内存100MB至2GB,可在手机、笔记本和嵌入式设备上本地运行。首批实验性模型包括LFM2-Extract、LFM2-350M-ENJP-MT、LFM2-1.2B-RAG、LFM2-1.2B-Tool、LFM2-350M-Math,以及社区开发的Luth-LFM2法语微调系列。官方称LFM2-1.2B-Extract在结构化抽取上优于参数量22.5倍的Gemma 3 27B,LFM2-350M-ENJP-MT的英日互译质量超过参数量10倍的通用模型。模型已在LEAP平台和Hugging Face上线,采用开放许可。

    匹配字段摘要

  3. 事件1 条新闻 · 1 个事实

    vLLM深化编译优化推理

    2025年8月20日,vLLM 官方介绍了 torch.compile 的工作原理及其与 vLLM 的集成方式。该方案结合编译缓存、动态批量大小、分段 CUDA Graphs 和自定义编译器 pass 优化大语言模型推理,并已在 vLLM V1 的在线与离线推理中默认启用。部分融合优化最高可带来15%的性能提升。后续方向包括缩短启动时间、采用更稳定的 API,以及探索与 MPK、Mirage 编译器的集成。

    匹配字段摘要

  4. 事件1 条新闻 · 1 个事实

    FutureHouse公布PaperQA2研究

    2024年9月19日,FutureHouse发布工程博客,公布其科学文献智能体RAG系统PaperQA2的研究成果。该博客介绍PaperQA2的设计与实验,称其在回答高难度科学问题、撰写综述文章和检测文献矛盾等任务上超过科学家的表现。团队基于LitQA2的200道专家多选题评测发现,智能体式查询扩展、LLM重排与上下文摘要(RCS)、引用遍历对准确率重要,而嵌入模型选择、混合关键词嵌入、chunk大小和结构化解析影响不大。新增的引用遍历工具通过Semantic Scholar和Crossref API前后各遍历一度引用,提升了正确论文的召回率。目前该研究仍以工程博客形式呈现,尚无后续发展事实。

    匹配字段摘要

  5. 事件1 条新闻 · 1 个事实

    Anthropic提出Contextual Retrieval方法

    2024年9月19日,Anthropic提出Contextual Retrieval方法,用于改进RAG检索。该方法包含Contextual Embeddings和Contextual BM25两项子技术,据Anthropic介绍,可将top-20检索失败率降低49%,从5.7%降至2.9%;叠加reranking后降低67%,从5.7%降至1.9%。其做法是用Claude 3 Haiku为每个分块生成50-100 token的上下文说明,再拼接到分块前进行嵌入和建立BM25索引。配合prompt caching时,生成上下文化分块的一次性成本为每百万文档token 1.02美元。Anthropic同时提供了可直接部署的cookbook。目前尚无后续发展事实。

    匹配字段摘要

星期五

  1. 事件1 条新闻 · 1 个事实

    antirez 提出用 LLM 编码应避免 vibe coding 并保持人在回路

    2025年7月20日,Redis 作者 antirez 更新了他用 LLM 写代码的经验,提出用 LLM 编码应避免 vibe coding,并保持人在回路。他认为当前 LLM 是好的能力放大器,但不是合格的单人开发者,多数场景应拒绝 vibe coding。他推荐主要使用 Gemini 2.5 PRO 和 Claude Opus 4,并建议避免使用编码智能体和 RAG,把完整代码库与文档直接放进上下文窗口,由人手动在终端与 LLM 网页界面之间搬运代码。他同时提醒,因意识形态或心理抵触而完全不用 LLM 也会积累劣势。目前该观点来自其原创博客,尚无后续发展事实。

    匹配字段摘要

星期三

  1. 事件1 条新闻 · 1 个事实

    Answer.AI 发布 ReadBench 多模态读文评测基准

    2025年6月5日,Answer.AI 发布 ReadBench,用于评测视觉语言模型(VLM)从文本图像中读取并推理信息的能力。该基准将 MMLU-Redux、MMLU-Pro、GPQA-Diamond、BABILong 和 LongBench 等文本基准的上下文转为图片,问题保留为文本。结果显示,几乎所有 VLM 在多模态输入下都出现性能下降:短于 1 页的输入下降较小,长输入下降非常显著,说明多页文档直接送入 Visual RAG 管线尚不可行。相关数据已发布于 HuggingFace,代码在 GitHub,论文在 arXiv。目前尚无后续发展事实。

    匹配字段摘要

  2. 事件1 条新闻 · 1 个事实

    Bespoke-Minicheck 上线 Ollama

    2024年9月18日,Bespoke Labs 开发的事实核查模型 Bespoke-Minicheck 在 Ollama 上线。据 Ollama Blog 介绍,该模型可对其他模型生成的回答进行核查,以检测并减少幻觉。其工作方式是接收文档与待验证的 Claim,若文档支持该 Claim 则输出 Yes,否则输出 No。该模型尤其适合作为 RAG 应用的后处理步骤,确保回答基于检索到的上下文。目前尚无后续发展事实。

    匹配字段摘要

  3. 事件1 条新闻 · 1 个事实

    Benedict Evans提出生成式AI产品应拆解为单一用途工具

    2024年6月9日,Benedict Evans提出观点,认为生成式AI的部署方式应是将通用技术拆解为单一用途工具和体验。他以自己用ChatGPT 4o查询印度签证流程却得到错误答案为例,指出LLM不是数据库,无法保证精确事实性回答,是概率系统而非确定性系统。他认为解决路径有两种:一是等待模型变强,如RAG、多智能体;二是把它当作产品问题,通过限定领域、定制UI或把模型抽象为后台功能来构建产品。目前该观点由Benedict Evans博客发布,尚无后续发展事实。

    匹配字段摘要

星期六

  1. 事件1 条新闻 · 1 个事实

    Aim Labs披露M365 Copilot零点击漏洞EchoLeak

    Aim Labs披露了Microsoft 365 Copilot中的零点击漏洞EchoLeak。攻击者只需向受害者发送一封邮件,就能在用户无感知的情况下外泄Copilot上下文中的敏感数据。该攻击链由三处漏洞组成,依次绕过XPIA提示注入分类器、外部链接与图片的脱敏处理,并借助SharePoint和Teams的URL绕过CSP限制。Aim Labs将核心手法称为LLM Scope Violation,认为同类设计缺陷也可能存在于其他基于RAG的聊天机器人和AI智能体中。Aim Labs称Microsoft已确认没有客户受到影响。

    匹配字段摘要

星期四

星期三

  1. Together AI Blog

    Polymorphic Inference:Together AI 用 AI 智能体自优化开源模型推理

    Together AI 推出 Polymorphic Inference,称其为全球首个生产级递归自我改进(RSI)推理系统,已用 AI 智能体优化其端点上的 40+ 个模型。该方案针对模型发布提速、架构多样化、流量形态变化和 B200 到 GB300 等硬件迭代,以 Continuous Compilation 持续编译替代静态调参的推理引擎配置。

    )与 Dan Fu(创始研究高级副总裁) 目录 40+ 个模型入选生产环境……40+ 个模型入选生产环境……40+ 个模型入选生产环境…… 本文中的链接 Together Compiler 摘要 在 Together AI,我们致力于让 AI 惠及每一位个人用户和组织。我们的研究团队——FlashAttention、ThunderKittens、ThunderAgent 等成果背后的研究者——一直是推动我们推理卓越表现的关键力量。随着推理市场呈指数级增长,我们一直专注于如何扩展研究能力,以实现普惠的丰富智能。 这要求我们的思维从静态推理转向 多态推理 ——这是我们针对新模型发布速度、模型架构多样性、快速变化的工作负载以及快速变化的硬件平台的应对之道。在本博客中,我们将重点介绍多态推理时代的研究议程——以及我们如何持续利用 AI 智能体,通过 持续编译. ‍ 什么是多态推理? 我们将这一跨越式变化视为需要一种新方法,我们称之为 多态推理. 多态推理(源自希腊语,意为“以多种形态进行推理”)是对我们在整个行业中看到的诸多变化的回应,对我们而言,这些变化主要由以下几个趋势的汇聚所定义: 模型

    匹配字段正文

  2. Cohere 产品与研究博客

    Cohere Model Vault 上线第三方开源模型,支持 DeepSeek V4.1…

    Cohere 在 Model Vault 与 Model Vault Encrypted 中上线第三方开源模型,企业可在全托管加密推理平台上同时运行 Cohere 自家模型和 DeepSeek V4.1 Flash、GLM 5.3 Flash、Gemma 4、GPT-OSS、Phi 等开源模型。Model Vault 默认对提示词和输出实行零数据保留,Encrypted 版本借助机密计算让 Cohere 和云厂商都无法看到数据。Model Vault 已在美国、欧盟和加拿大上线,Encrypted 版本目前仅限美国,欧盟和加拿大即将支持。

    An abstract image with words overlayed reading "World's leading open models, under your control. Available in Model Vault"

    数据驻留要求,还是仅仅对 AI 模型拥有更多控制权。全球客户将一些最敏感的内容托付给我们。Cohere Model Vault 让 Language Weaver 能够安全高效地运行模型——包括 LW Pro 模型——同时确保客户掌控其数据的去向。它快速可靠,而且由于 Cohere 负责托管和扩展,我们的团队可以专注于我们最擅长的事情:为客户交付价值。” Dragos Munteanu,RWS 研究与产品开发副总裁 为每项任务选择合适的模型 没有单一模型在所有方面都最出色。Model Vault 让您为每项任务选择最合适的模型,并以相同的保护措施运行每一个模型。 Cohere 的模型。 Command 用于生成式和智能体工作,Embed 和 Rerank 用于搜索和检索,Parse 用于文档,Transcribe 用于语音,Translate 用于多语言工作流。 高性能开源模型。 除了我们自己的模型,Model Vault 还运行最常用的开源模型,包括 DeepSeek V4.1 Flash(OpenRouter 上最常用的开源模型)、GLM 5.3 Flash、MiMo V2.6 P

    匹配字段正文

  3. AWS Machine Learning

    Amazon Quick 如何整合结构化与非结构化数据

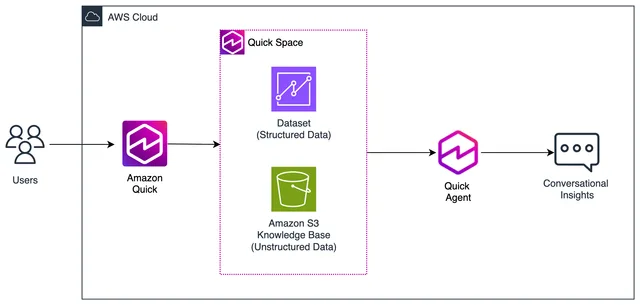
    Amazon Quick 通过 Space 工作区把 S3 知识库中的非结构化文档与带语义描述的结构化数据集合并,让单个对话式 AI 智能体在一次提问中自动判断查询哪类数据并返回带引用的合并回答。该方案要求用户具备 Enterprise 订阅,S3 桶需与 Amazon Quick 同区域,管理员可在控制台授予只读权限。

    Architecture diagram showing the data, workspace, and agent layers that connect structured datasets and an Amazon S3 knowledge base to a chat agent in Amazon Quick

    和文件里。要同时分析这两类数据,通常需要在多个工具之间切换、运行单独的查询,并手动关联结果。 Amazon Quick 通过统一的体验解决了这一问题。你可以通过 丰富数据集 连接结构化数据,并通过 由 S3 支持的知识库连接非结构化数据。然后,你可以通过单个对话式 AI 智能体查询这两类数据。 在本文中,你将学习如何: 将 Amazon Simple Storage Service(Amazon S3)连接为数据源并创建知识库。 构建一个整合结构化和非结构化数据的 Space。 创建并配置一个可跨两种数据类型进行查询的自定义聊天智能体。 在单次对话中提出跨越结构化和非结构化来源的问题。 解决方案架构 下图说明了各组件如何连接,以通过 Amazon Quick 提供统一的数据体验。 图 1:在 Amazon Quick 中整合结构化和非结构化数据的解决方案架构 该架构包含三个层: 数据层: 你的数据以两种形式存在。非结构化内容(文档、PDF、报告)存储在 Amazon S3 中,并通过知识库建立索引。结构化数据(指标、销售数字和运营关键绩效指标)作为丰富数据集加载,并带有语义描述,智能体

    匹配字段正文

  4. AWS Machine Learning

    Gen Digital 如何用 Amazon Bedrock AgentCore Web Search 构建…

    Gen Digital 用 Amazon Bedrock AgentCore Web Search 为 Norton Revamp 搭建 AI 策展新闻引擎,为内容建议、目标推荐和新闻流提供带引用的实时网络信息。该平台于 2026 年 3 月上线,由 Amazon Nova Lite 生成内容,Web Search 以兼容 MCP 的托管连接器形式接入 AgentCore Gateway,返回来源 URL、标题和发布日期。

    Event-driven News Engine architecture showing Amazon Nova, AgentCore Web Search, and the AI Learning System grounding content generation

    力。 基础设施: 前端采用 React、TypeScript 和 Tailwind CSS。后端采用 Node.js、Amazon Elastic Container Service (Amazon ECS)、AWS Lambda、Amazon DynamoDB(多表,采用复合键模式)、Amazon API Gateway、Amazon Simple Storage Service (Amazon S3)、Amazon Simple Queue Service (Amazon SQS)、Amazon EventBridge、Amazon CloudFront、Amazon CloudWatch 和 AWS Secrets Manager。基础设施通过 Terraform 管理,采用蓝绿部署实现零停机发布。 处理流水线: 该平台运行四个流水线阶段: 全量扫描 – 拉取最多 1,000 条历史帖子,存储到 Amazon S3,运行 Amazon Bedrock 批量分析以评估声誉影响。 每日扫描 – 由 Amazon EventBridge 触发的增量分析。 每周目标生成 – Lambda

    匹配字段正文

星期二

  1. 凤凰科技

    曝OpenAI以超30%折扣和免费额度抢走Anthropic客户,Replit合同年价值超1亿美元

    据The Information报道,OpenAI以超过30%的模型价格折扣争取到美国AI编程平台Replit,合同年价值超过1亿美元。OpenAI还通过免费额度、账户翻倍和工程师进群支持等方式争取Rippling、Atomicwork等Anthropic老客户,Anthropic则在新模型发布时下调API价格。

    uter客户支出领先。两组变化表明,企业采购既看模型效果,也看实际报价,领先厂商同样需要反复争取客户预算。 随着模型能力差距缩小、切换供应商更方便,企业大客户有了更多议价空间。模型效果之外,合同折扣、免费额度和技术支持也在影响采购选择。对模型厂商而言,竞争对手一旦推出效果接近、价格更低的产品,原有客户就可能转向。技术领先带来的高价,越来越难长期维持。 来源:The Information、路透社、Anthropic、OpenAI “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  2. 凤凰科技

    Anthropic 在 S-1/A 文件中警示递归自我改进风险

    Anthropic 在周一更新的 S-1/A 招股补充文件风险提示中表示,公司可能很快就会触及《负责任扩缩策略》定义的递归自我改进状态。文件称公司已借助 AI 开发出新模型并实现部分能力跃升,但当时团队并未察觉,未来也可能在研发提速发生之后才察觉。Anthropic 同时说明现有模型均未跨过该门槛,并承诺在可预见的未来保留人类参与前沿模型研发,正考虑修订《负责任扩缩策略》。

    e 完全自主设计、迭代前沿大模型。因此,我们正考虑修订《负责任扩缩策略》,保证前沿模型的开发始终由人类掌控。” 持怀疑态度的人会指出,S-1 招股文件兼具信息披露和宣传属性,宣称即将做出能够自我迭代的超强模型,或许只是宣传话术。 但不可否认,Claude 今年的能力,尤其是编程、数学和网络安全方面,实现了跨越式提升。如果 Anthropic 判断递归自我改进近在眼前,或许我们应当重视这个判断,并据此采取行动,搭建对应的监管规则。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  3. 凤凰科技

    高盛收紧Claude Code等AI编程工具权限,部分交易员不满

    高盛在10月更新的内部指引中收紧Claude Code及微软GitHub相关工具的使用权限,将其主要限定给工程师使用,引发部分交易员不满。此前部分交易员依靠这些工具监控客户交易流、模拟市场与头寸变化;从事交易、量化研究与软件工程交叉工作的“strats”员工不受此次限制。高盛自有AI助手GS AI Assistant整合了OpenAI、Anthropic及Alphabet的模型。

    验评估各类AI工具在不同部门的用途,综合考量生产力与风险管理等因素,再确定适合长期使用这些工具的人员。 据路透社此前报道,高盛于2025年6月在全公司推出GS AI Assistant,当时已有约1万名员工使用。彭博社此次报道提到,高盛自有AI助手整合了OpenAI、Anthropic及谷歌母公司Alphabet的模型。(作者/宋淑美) 更多一手新闻,欢迎下载凤凰新闻客户端订阅凤凰网科技。想看深度报道,请微信搜索“凤凰网科技”。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  4. 36氪 · AI

    AI 数据公司凶猛:UniPat 传获阿里腾讯投资,估值达 25 亿美元

    36氪旗下硅星人Pro 报道,成立不到一年的数据公司 UniPat 被曝正洽谈约 3 亿美元融资,阿里领投、腾讯和红杉中国参与,投后估值 25 亿美元。文章称带用户行为轨迹的数据一条报价可达 1000 至 3000 元,带完整操作过程的工作场景数据可卖到 1 万元左右,Mercor 估计前沿实验室所需数据目前只完成 2% 到 5%。随着模型厂商收紧采购、核算 ROI 并对供应商数据做消融,行业已出现拉黑数据商、数据质量难验证等问题。

    据,一条报价可达1000至3000元,带完整操作过程的工作场景数据,甚至可以卖到1万元左右。若按每条1000至3000元采购1万条,账单就是1000万至3000万元。对于数据公司来说,单笔订单做到百万、千万元已是常态。 要知道,数据供应商不是第一天就在模型训练行业这么吃香的。 很长一段时间里,“数据外包”意味着给图片和文字打标签。Mercor 副总裁 Chirag Mahapatra 对我们回忆:Mechanical Turk 时代的任务包括垃圾邮件分类、给自动驾驶图片标出停车标志,一批勤恳的人就能做。这就是今天还有很多人会第一时间想到的“数据打标”的模式。 后来,人们开始从模型给出的几个回答里挑一个更好的,用这些偏好指导训练,也就是人类反馈强化学习,简称 RLHF。 再往后,Mercor 请来的已是 MIT、哈佛的博士和数学奥赛奖牌得主,他们写解题步骤、定评分标准。Chirag 对我们说:他看到了清晰的需求侧的变化,但没想到供给侧也如此快跟上。“这些人愿意来做这份工作,赚学费或一份额外收入。” “我觉得一部分是疫情期间的影响,这些人有了时间也有了增加收入的需求。” 模型在预训练中阅读

    匹配字段正文

  5. Analytics India Magazine

    HCLTech 推出面向大型机运维的 AI 智能体

    HCLTech 发布面向企业大型机环境的 AI 运维方案,结合专用智能体与对话式 AI 助手,覆盖系统管理、可观测性、优化和运维工作流,智能体在人工监督下运行。该方案依托 HCLTech 的大型机卓越中心,公司称可提升运维效率、加快问题解决并推动从被动响应转向主动管理,但未披露客户部署、支持的大型机平台及量化改进数据。

    管企业寻求对遗留基础设施进行现代化改造,大型机仍继续支撑着关键的企业工作负载。例如,Mphasis 一直通过其 AI 主导的遗留系统现代化方法,探索将 AI 用于遗留 IT 现代化。 “在大型机上运行关键任务工作负载的企业正面临越来越大的压力,需要在不妨碍可靠性或控制力的前提下实现运维现代化并提升效率,”HCLTech 高级副总裁兼混合云全球业务负责人 Rampal Singh 表示。 Singh 表示,此次发布将 HCLTech 的大型机专业知识与 AI 能力相结合,以简化运维并降低风险。 该方案还依托 HCLTech 专门的大型机卓越中心。该公司表示,该中心提供领域专业知识、行业最佳实践,并为该方案的进一步开发提供支持。 “通过我们专门的大型机卓越中心和 AI 创新能力,我们正将智能体和运维智能直接嵌入大型机环境,”HCLTech 企业副总裁兼 AI 生态系统负责人 Raghu Kidambi 表示。 Kidambi 表示,该平台将帮助企业从被动的大型机管理转向主动管理,同时保持安全性、韧性和治理。 HCLTech 未披露该方案的客户部署情况、支持的大型机平台或量化的运维改进数据。

    匹配字段正文