←搜索结果

按匹配度 · 共 695 条结果 清除搜索

星期四

  1. NVIDIA Developer · Generative AI

    NVIDIA 如何用投机解码协同设计 AI 模型以加速 LLM 推理

    NVIDIA 提出用投机解码加速 LLM 推理:小草稿模型一次提议多个 token,由大目标模型并行验证,在不改变输出序列的前提下减少解码迭代次数。文章给出五条准则来选取最优草稿长度与机制,并比较外部草稿模型、EAGLE-3、MTP、DFlash、DSpark 及后缀/n-gram 方法。NVIDIA 的 SPEED-Bench 基准用于衡量编码、摘要等任务的接受长度,EAGLE-3、DFlash、DSpark 的训练示例已开放在 NVIDIA/Model-Optimizer 中。

    匹配字段标题

星期二

  1. NVIDIA Developer · Generative AI

    NVIDIA 如何为 AI 推理与 TCO 合理配置 GPU 规模

    NVIDIA 提出按 AI Chatbots/Copilots、AI Agents、内容生成、翻译应用四类用例映射推理负载,并依据模型选择、DAU、并发、ISL/OSL、缓存命中率、延迟目标和合同期限来规划 GPU 容量。其核心加弹性(core-and-flex)模式用本地或预留云 GPU 承载稳态流量,用公有云 spot 或按需 GPU 应对突发。NVIDIA Model Optimizer 的 FP8 训练后量化将 Llama-3.1-8B 权重内存减少 43.5%,对 Qwen3-8B 教师模型剪枝加蒸馏得到约 6B 参数学生模型。

    匹配字段标题

  2. IEEE Spectrum

    AI 公司转向家庭分布式算力运行推理

    IEEE Spectrum 报道,Far Labs、Evolving Edge、Bless Network、Salad、Gradient 等公司正把 AI 推理任务分散到家庭和小型企业的闲置算力上,并向设备所有者付费。Far Labs 的 Far AI 平台将在未来几周上线,Evolving Edge 处于公开测试阶段。这些平台主要运行较小的开源模型,通过 Ray 或自研软件把单个推理任务拆分到多台设备,Far Labs 称其平台延迟可低至 100 毫秒以内,并以开源节点软件和最小权限设计回应隐私与安全顾虑。

    匹配字段标题

星期四

  1. LG AI Research 官方博客

    LG AI Research 的 ReSQL:通过检索增强错误推理实现自我改进的 Text-to-SQL 框架(ACL 2026)

    LG AI Research 提出 ReSQL,一个通过检索增强错误推理实现自我改进的 Text-to-SQL 框架,相关论文被 ACL 2026 Findings 收录。在 SPIDER 和 BIRD 基准的第二轮精炼后,该框架将歧义列引用错误减少 36.5%、多语句 SQL 错误减少 39.4%、ORDER BY 先于 UNION 的错误减少 73.1%,并完全消除了 GROUP BY 子句中的聚合函数错误。

    匹配字段标题

星期三

  1. Google Developers Blog

    Google Cloud 在 Cloud TPU 上为长上下文多模态嵌入推理提供企业级精度

    Google Cloud 将原生 TPU 支持集成进 vLLM,并以 Qwen3 Embedding 系列为目标模型完成多项优化,使嵌入推理可处理 4K+ token 文本和 15K+ token 多模态输入。TPU 输出与 XPU 参考基线的余弦相似度达到文本 ≥0.999、多模态 ≥0.995,官方已在 AI-Hypercomputer 公共仓库开源 Qwen3-Embedding-8B 的部署与评测 recipe。

    匹配字段标题

  2. NVIDIA Developer · Generative AI

    NVIDIA Dynamo 推出影子引擎恢复,LLM 推理故障恢复从 283 秒缩短到 7.3 秒

    NVIDIA Dynamo 以预览功能形式推出影子引擎恢复,在同一批 GPU 上保留一个已完全初始化的空闲影子引擎,由 GPU Memory Service 共享已有权重而不在 HBM 中额外复制,活跃进程失败后影子引擎可在数秒内接管。在 NVIDIA B200 节点上的双 worker GLM-5.2 部署中,影子引擎恢复用 7.3 秒恢复服务,冷重启需要 283 秒,接近 39 倍差距。该功能要求 Kubernetes 1.34 或更新版本的 Dynamic Resource Allocation 并安装 NVIDIA GPU DRA 驱动,主要支持 vLLM 后端,当前预览版尚不支持将 GMS 用于 KV cache。

    匹配字段标题

星期二

  1. SemiAnalysis精选

    SemiAnalysis 实测 OpenAI 自研推理芯片 Jalapeño:每兆瓦吞吐超过 Blackwell

    SemiAnalysis 在 OpenAI 实验室用 InferenceX 实测了 OpenAI 自研推理 ASIC Jalapeño,称其在多个开源模型上的每兆瓦 token 吞吐超过 NVIDIA Blackwell,且在 DeepSeek R1 上并发 1 时达到每用户 700 tokens/s 以上,全程未使用投机解码。该芯片由 OpenAI 与 Broadcom 合作、2024 年中启动设计,2025 年 11 月完成 CoWoS 流片,采用 HBM4、单封装 15.4TB/s 带宽,架构上不做 prefill 与 decode 分离,用统一芯片池应对变化的负载比例。文章认为更公平的对手是同样使用 HBM4 的 Rubin,两者每美元输出 token 数接近,但 Jalapeño 尚未启用投机解码,量产计划从 2027 年起逐步爬坡。

    匹配字段标题

星期一

  1. SemiAnalysis

    SemiAnalysis 发布 AgentX 1.0:百万上下文多轮智能体编码推理基准

    SemiAnalysis 发布 AgentX 1.0,称其为全球首个完全开源、100 万上下文的多轮智能体编码推理基准,以 Apache 2.0 许可发布,数据集构建投入超过 300 万美元。该基准被纳入 InferenceXv3,用智能体编码流量替代此前 8k 输入 1k 输出的单轮场景,测试矩阵运行在约 2MW 算力、1000 多颗芯片上,覆盖 MI355X、GB300 NVL72、GB200 NVL72、B300、B200、MI325、MI300X、H200 与 RTX Pro 服务器。SemiAnalysis 称其首个成果是已推动 vLLM、SGLang、TensorRT-LLM、ATOM、AITER、Dynamo、LMCache 和 Mooncake 等项目的 70 多个上游 PR,并计划在三到四周后发布 AgentX 更新文章。

    匹配字段标题

星期五

  1. Hugging Face

    Liquid AI 发布 LFM2.5-DSpark 草稿模型,推理最高提速 3.2 倍

    Liquid AI 发布 LFM2.5-DSpark 系列草稿模型,用于 LFM2.5 的推测解码,在 H100 与 M4 Max MacBook 上最高带来 3.2 倍推理提速。草稿模型约 300M 参数,采用 5 层注意力结构、block size 为 9,在多工具场景下将 LFM2.5-2.6B 的延迟平均降低 57%。模型已以 Safetensors 和 GGUF 格式在 Hugging Face 开放,并支持 llama.cpp 与 SGLang,文中给出了对应的启动命令。

    匹配字段标题

星期四

  1. Liquid AI 模型与工程博客

    Liquid AI 发布 LFM2.5-DSpark 草稿模型,推理最高提速 3.2 倍

    Liquid AI 为 LFM2.5-1.2B-Instruct、LFM2.5-2.6B 和 LFM2.5-8B-A1B 发布 DSpark 投机解码草稿模型,GPU 上吞吐最高提升 3.18 倍,端侧最高 2.87 倍,且不改变输出质量。草稿模型约 300M 参数,采用 5 层、block size 9 的简化注意力结构,已在 Hugging Face 提供 Safetensors 与 GGUF 权重,并开源集成到 llama.cpp 和 SGLang。在 BFCL 多工具函数调用场景中,LFM2.5-2.6B 的延迟平均降低 57%;LFM2.5-8B-A1B 受 llama.cpp Metal 后端 MoE 实现影响,端侧仅提升 18%。

    匹配字段标题

星期三

  1. Armin Ronacher AI 博客

    Armin Ronacher 解释大语言模型的推理机制

    Armin Ronacher 解释称,推理轨迹本质上是模型在最终回答前写入暂存区的文本,并通过特殊 token 和解析器与答案分流。他以 GPT-OSS、Responses API 和 DwarfStar 为例,分析推理强度如何由系统提示词塑造,以及禁用原生推理时模型为何可能把思考内容泄露到错误通道。

    匹配字段标题

  2. LMSYS Blog

    LMSYS 如何在 H20 上优化 DeepSeek-V4-Pro 推理服务

    LMSYS 针对 1.6 万亿参数 MoE 模型 DeepSeek-V4-Pro 在 H20 GPU 上的推理服务做系统优化,batch size 1 时单节点 H20-141GB 达到 271 output tokens/s,与 B300 的 383.7 tokens/s 相比性能比缩小到 1.42×。优化后的 prefill 每节点达 8.45k input tokens/s,43.7 秒处理 100 万 token 提示;面向吞吐的 DP16-EP16 每节点达 4.67k output tokens/s,平均 TPOT 27.4 ms。

    Hardware specification comparison across H20-96GB, H20-141GB, and B300, covering FP4 and FP8 compute, HBM capacity, memory bandwidth, NVLink, and RDMA

    匹配字段标题

星期一

  1. Johann Rehberger / Embrace The Red

    作者复现从加密推理链中恢复密码的攻击

    Johann Rehberger 复现了论文《Stealing Reasoning Traces from Proprietary LLM APIs》中的攻击方法,把 GPT-5.6 Sol 在一个 OpenAI 账号下生成的加密推理链,用另一账号的 GPT-5.6 Luna 配合轻度越狱提示词还原出底层推理内容,包括原推理中出现过的密码。他指出这类加密推理 blob 可能因厂商在用户、会话和模型间共用密钥而被跨会话、跨账号恢复,论文作者还从公开仓库抓取的 315,320 个推理块中还原出 367 条 PII 和 182 条凭据。测试期间该攻击曾于 8 月 11 日前后完全失效,三天后又恢复可用,原因不明。

    匹配字段标题

星期四

  1. Microsoft AI Blog精选

    微软发布推理模型 MAI-Thinking-1,已在 Microsoft Foundry 开启公开预览

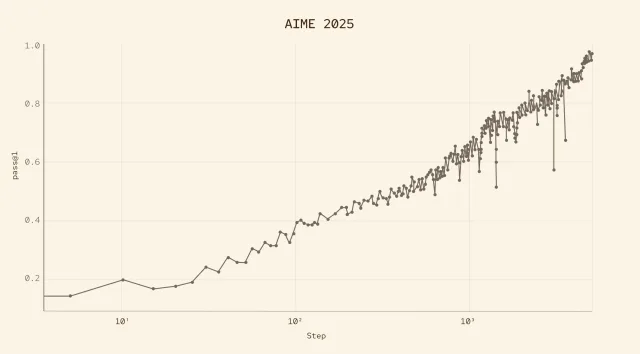
    微软 AI 发布推理模型 MAI-Thinking-1,已在 Microsoft Foundry 开启公开预览。该模型为 35B 激活参数、约 1T 总参数的稀疏 MoE 架构,在 SWE-Bench Pro 上与 Claude Opus 4.6 持平,AIME 2025 得分 97.0%、AIME 2026 得分 94.5%,并在与 Claude Sonnet 4.6 的盲测人评中被更多用户偏好。模型支持 256k token 上下文窗口、函数调用和开发者指令,兼容 Chat Completions API,微软称其训练未使用第三方模型蒸馏,数据为可追溯的企业级数据。

    Line graph titled "AIME 2025" shows a general upward trend in the y-axis values (ranging from 0.2 to 1.0) over increasing x-axis steps, with fluctuations and small vertical error bars.

    匹配字段标题

  2. Microsoft Research

    MindTopo 揭示多模态大模型的拓扑空间推理能力

    微软研究院推出 MindTopo 基准,从连通性、包围、顺序、打结等五类拓扑属性评估多模态大语言模型的空间理解能力,每类分静态推理与交互规划两个认知层级。测试显示,模型在静态推理上普遍强于交互规划,两者均远低于人类水平;规划错误多发生在场景已被理解之后,模型无法在连续动作中维持拓扑关系。图像与视频生成仅在单帧关系可见时偶有帮助,跨序列时经常改变拓扑或违反任务动态。

    匹配字段标题

星期三

  1. Amazon Science

    亚马逊自动推理团队成立十周年:从 Tiros、Zelkova 到 IAM Access Analyzer 的形式化验证落地

    亚马逊自动推理团队(ARG)成立十年来,已将形式化验证从学术研究转化为每天处理数十亿次查询的生产服务,其 Tiros、Zelkova 等工具演化为 IAM Access Analyzer、Amazon Inspector 和 Reachability Analyzer。该团队还证明了 Nitro 隔离引擎、密码学实现以及每秒处理 10 亿次 API 调用的授权引擎的正确性。Amazon Bedrock Guardrails 的自动推理检查用形式逻辑验证模型响应是否符合既定策略,验证准确率最高达 99%。

    匹配字段标题

星期二

  1. Mistral AI

    Mistral 推出区域推理端点与优先级服务层,并接入第三方开源模型

    Mistral 宣布 Mistral Regional Endpoints 正式可用,客户可选择推理在欧洲或美国运行,同时 Mistral Priority Tier 进入公开预览,提供自定义速率限制和带 SLA 的可用性承诺。其平台还将支持第三方开源模型,首个接入的是 Z.ai 的 GLM-5.2,这些模型将运行在与 Mistral 自有模型相同的基础设施、区域控制和服务承诺之上。Mistral 同时组建企业联盟,通过 European Compute Units 汇集多年期算力承诺,并计划到 2030 年建成最高 1 GW 的算力容量。

    匹配字段标题

星期六

  1. The Next Platform精选

    AMD 收购 AI 推理芯片初创公司 Taalas

    AMD 本周以未披露金额收购 AI 推理初创公司 Taalas,计划把其技术整合进加速器路线图,并与 AMD Instinct GPU 组成系统级方案。Taalas 将模型权重固化进 ROM 电路并搭配大块 SRAM 作为片上 KV cache,当前 HC1 芯片可容纳 80 亿参数模型,下一代 HC2 目标为 200 亿参数。此前 AMD 已与 Cerebras 合作做分离式推理,由 GPU 承担 prefill、专用引擎承担 decode。

    匹配字段标题

星期五

  1. 蚂蚁百灵:Developer Blog精选

    百灵开源 Ling-3.0-flash 混合推理模型

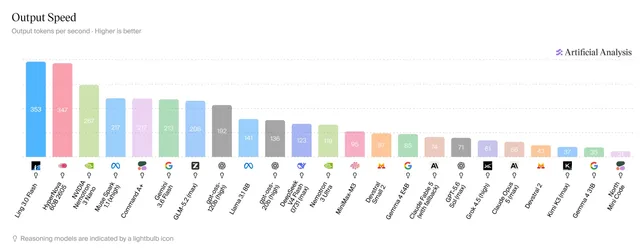
    蚂蚁百灵开源新一代原生混合推理模型 Ling-3.0-flash,采用 124B 总参数、5.1B 激活参数的 MoE 架构,同步提供基础版本及 FP8、FP4、INT4 等多个精度版本。模型支持三种落地方式:云端 API 调用、在单台 NVIDIA DGX Spark 上以 MXFP4 或 INT4 版本完成端到端本地推理,以及在指定 GPU 测试配置下平均输出速率突破 1100 tokens/s 的高性能部署。在 Artificial Analysis 榜单中其输出速度为 353 tokens/s,AA Intelligence Index 中每项任务加权平均调用成本约 0.04 美元。

    图

    匹配字段标题