←搜索结果

按匹配度 · 共 568 条结果 清除搜索

星期三

星期四

  1. Microsoft AI Blog

    微软发布 MAI-Transcribe-1 多语言语音转文字模型

    微软推出多语言语音转文字模型 MAI-Transcribe-1,支持 25 种语言,在 FLEURS 基准上词错率低于 Scribe v2、Whisper-large-V3、GPT-Transcribe 和 Gemini 3.1 Flash-Lite。该模型批量转写速度比现有 Microsoft Azure Fast 快 2.5 倍,定价为每小时音频 0.36 美元,已在 Microsoft Foundry 开启公开预览,并逐步接入 Copilot 语音模式和 Microsoft Teams。

    匹配字段标题

星期四

  1. Noam Shazeer

    Gemini 3.1 Flash Live 现已开放使用,面向生产级语音智能体

    Gemini 3.1 Flash Live 现已开放使用,整体质量得到改进,支持开发者和企业规模化构建可完成复杂任务的语音优先智能体。该模型在 ComplexFuncBench Audio 的受约束多步函数调用和 Scale AI AudioMultiChallenge 的含中断长程推理测试中领先,并以多语言能力支持 Search Live 推广。

    匹配字段标题

  2. Cohere 产品与研究博客精选

    Cohere 发布开源语音识别模型 Transcribe

    Cohere 发布开源权重 Conformer 语音识别模型 Transcribe,可将 14 种语言的语音转为文本,并已开放下载。该模型在 Hugging Face Open ASR Leaderboard 的平均 WER 为 5.42%,可在本地或端侧运行,也可通过有限速的免费 API 和 Model Vault 使用。

    匹配字段标题

星期二

  1. Mistral AI

    Mistral AI 发布 Voxtral TTS 语音合成模型

    Mistral AI 发布首款文本转语音模型 Voxtral TTS,参数规模 4B,支持英语、法语、德语、西班牙语、荷兰语、葡萄牙语、意大利语、印地语和阿拉伯语共 9 种语言,具备情感表达和零样本跨语言音色适配能力。模型在 10 秒参考音频、500 字符输入的典型场景下延迟为 70ms,实时系数约 9.7x,现已通过 API 和 Mistral Studio 提供,定价为每 1k 字符 0.016 美元。官方称人工评测中其自然度优于 ElevenLabs Flash v2.5,并与 ElevenLabs v3 质量持平;带参考音色的版本以 CC BY-NC 4.0 许可在 Hugging Face 开放权重。

    匹配字段标题

星期三

  1. 蚂蚁百灵:Developer Blog

    蚂蚁百灵发布 Ming-flash-omni-2.0 语音生成模型

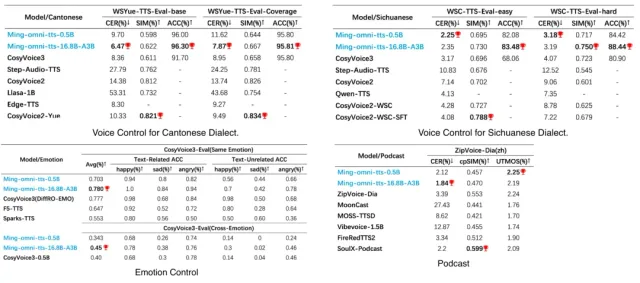
    蚂蚁百灵发布 Ming-flash-omni-2.0 语音生成模型,支持语速、音量、音调等基础属性控制,以及方言、情感和音色设计,内置 100+ 精品音色。该模型基于自研连续表征 Tokenizor 和自回归 Diffusion,实现 speech/audio/music 一体化生成。指标显示粤语和四川话生成准确率为 96% 和 86%,较 CosyVoice3 提升 2.3% 和 11.5%。

    04

    匹配字段标题

星期三

  1. Sarvam AI Blog

    Sarvam AI 发布 Saaras V3 语音识别模型

    Sarvam AI 推出 Saaras V3 语音识别模型,原生支持流式低延迟解码,覆盖 22 种印度官方语言和英语,在 IndicVoices 基准上 WER 约 19%(V2.5 约 22%)。模型基于 100 万小时以上多语言音频训练,在 10 种最常用语言子集上 WER 为 19.31%,并在低资源语言上保持稳定准确率。

    Introducing Saaras V3

    匹配字段标题

星期六

  1. Sarvam AI Blog

    Sarvam AI 发布 Bulbul V3 语音合成模型

    Sarvam AI 发布 Bulbul V3 文本转语音模型,面向印度语言提供自然、富有表现力且可用于生产的语音。该模型在 Josh Talks 开展的第三方盲测 A/B 人耳听测中覆盖 11 种语言,在 8 kHz 电话场景下偏好度领先 ElevenLabs v3 alpha、v2.5 flash 和 Cartesia Sonic-3,并新增低延迟流式输出模式。模型提供 11 种印度语言、35+ 音色并支持声音克隆,计划扩展到 22 种印度语言,2026 年 2 月期间 Sarvam Dashboard 提供不限量 API 访问。

    匹配字段标题

星期二

  1. Sarvam AI Blog

    Sarvam AI 发布 Sarvam Audio:基于 Sarvam 3B 的语音识别模型

    Sarvam AI 发布 Sarvam Audio,这是基于 30 亿参数语言模型 Sarvam 3B 的音频扩展,支持 22 种印度语言,提供五种可控转写格式(逐字转写、规范化非混码、规范化混码、罗马化输出、智能翻译)。在 IndicVoices 评测集上,Sarvam Audio 在非规范化、规范化和混码三种转写风格下的 WER 均优于 GPT-4o-Transcribe 和 Gemini-3-Flash,并支持最长 60 分钟音频的多说话人分离识别。

    Sarvam Audio: Speech Recognition beyond Transcription

    匹配字段标题

星期三

  1. Vapi Blog

    Instawork 每月在 Vapi 上运行 100 万+分钟语音筛选

    Instawork 将 Vapi 语音智能体用于小时工岗位筛选,把电话初筛规模扩大 50 倍,达到每天约 16,000 个岗位批准,技能匹配成功率提升 30%,单次通话成本降低 85%,并从概念到高并发生产上线仅用约 30 天。Instawork 于 2025 年初在评估多个语音 AI 工具后选择 Vapi,看重其大规模可靠性、对 LLM/STT/TTS 与工具调用的灵活配置,以及面向非技术团队的仪表盘。

    匹配字段标题

星期三

  1. Vapi Blog

    拉美汽车市场平台用 Vapi 语音 AI 将呼叫中心减半,营收增长 200%

    一家拉美汽车交易平台通过语音 AI 编排平台接入内部 MCP 服务与 LangGraph 工作流,将呼叫中心规模缩减超 50%,营收增长 200%,获客成本降低 50%。该平台目前每天处理 1 万至 1.5 万通语音 AI 智能体电话,在 5 个国家支持 450+ 并发通话,并部署了 1000+ 本地化智能体。

    匹配字段标题

星期四

  1. Modal 官方工程博客

    Decagon 如何借助 Modal 实现实时语音 AI

    Decagon 与 Modal 合作推出 Decagon Voice 2.0,延迟降低 65%,意图识别与响应质量显著提升。团队用 SFT 和 RL 训练紧凑开源模型,并定制 EAGLE3 草稿模型,接受长度比开源基线高 38%;同时为 SGLang 构建异步调度器,H200 GPU 空闲时间完全消除,吞吐量最高提升 12%。

    decagon diagram

    匹配字段标题

  2. Vapi Blog

    Vapi 推出 Squads:多助手协作的语音 AI 编排方案

    Vapi 发布 Squads,让开发者用多个专职语音助手通过交接协作处理复杂对话,并保持上下文。每次交接可分别设置上下文规则(不传、传最近 N 条或全部消息),交接过程无音频中断,同一 Squad 可同时用于语音和 SMS。Fleetworks 已通过 Squads 每天处理 240,000 通电话。

    匹配字段标题

星期二

  1. Modal 官方工程博客

    Modal 用 Pipecat 和开源模型实现一秒内语音到语音延迟

    Modal 工程博客介绍了如何用 Modal、开源框架 Pipecat 和开源权重模型搭建语音 AI 聊天机器人,在客户端与容器就近部署时实现约一秒的中位语音到语音延迟。方案采用 Parakeet-tdt-v3 做语音转文字、Qwen3-4B-Instruct-2507 配合 vLLM 做 LLM 推理、Kokoro 做语音合成,并用 ChromaDB 与 all-minilm-l6-v2 完成 RAG 检索。作者还分享了用 Modal Tunnels 绕过输入平面降低网络延迟、通过区域固定和独立自动扩缩容控制成本的做法,代码已在 GitHub 仓库公开。

    Diagram depicting a person speaking to a voice bot composed of STT, LLM, and TTS services

    匹配字段标题

星期三

星期五

  1. Microsoft AI Blog精选

    微软 AI 发布 MAI-Voice-1 语音模型并公开测试 MAI-1-preview

    微软 AI 发布首个高表现力语音生成模型 MAI-Voice-1,已在 Copilot Daily 和 Podcasts 中上线,并在 Copilot Labs 提供体验;该模型可在单张 GPU 上不到一秒生成一分钟音频。同时,微软 AI 首个端到端训练的基础模型 MAI-1-preview 已在 LMArena 开启公开测试,这是一个在约 15,000 块 NVIDIA H100 GPU 上完成预训练和后训练的 MoE 模型,未来数周将逐步用于 Copilot 的部分文本场景。

    匹配字段标题

星期四

  1. Vapi Blog

    Vapi 如何构建语音 AI 流水线:第一部分

    Vapi 披露其语音 AI 流水线采用流式架构,以 20ms 音频分块并行处理输入、转录与响应生成,取代传统 STT→LLM→TTS 顺序级联,后者会造成超过 4 秒的对话空白。转录流在用户说话时输出部分结果并立即送入 LLM,端点模型预测用户说完后发送完整语句,若判断错误则丢弃该请求并基于更新转录重新发起。这是该系列三篇中的第一篇。

    匹配字段标题

星期二

  1. Cartesia 产品与研究精选

    Cartesia 发布语音智能体开发平台 Line

    Cartesia 发布语音智能体开发平台 Line,采用代码优先设计,开发者可通过 SDK、CLI 和 GitHub 集成快速构建和部署语音智能体。Line 集成 Sonic 和 Ink 模型,提供低延迟、可扩展的基础设施,并支持企业本地部署和模型微调。

    Several translucent green squares in watercolour, stacked at slight angles so their overlaps darken toward the centre

    匹配字段标题

星期四

星期二

  1. Mistral AI精选

    Mistral AI 发布 Voxtral 开源语音理解模型

    Mistral AI 发布 Voxtral 语音理解模型,包括面向生产应用的 24B 版本和面向本地及边缘部署的 3B 版本,均采用 Apache 2.0 许可证。模型支持 32k Token 上下文、最长 30 分钟转录或 40 分钟理解,并提供音频问答、摘要、多语言识别和语音 Function Calling。模型可从 Hugging Face 下载或通过 API 使用,价格为每分钟 $0.001 起。

    Triangle Voxtral Blog

    匹配字段标题