AI News

按匹配度 · 共 805 条结果 清除搜索

星期五

  1. Google Research

    Google 推出行星预测引擎 PPE,自动完成地理空间建模全流程

    Google Research 发布 Google Earth AI 下的实验性研究能力行星预测引擎(PPE),可依据自然语言查询自主完成数据检索、特征工程、模型训练评估并生成报告,把复杂行星级预测建模从数周人工流程缩短到几分钟。在 21 项 CDC 健康指标上,PPE 的平均 R² 为 76.8%,高于人工专家流程的 60.0%;在尼日利亚粮食安全降尺度任务中 R² 达 66.1%,基线为 31.5%;在刚果(金)2026 年 Bundibugyo 埃博拉疫情期间的实时热点预测中 Recall@10 为 83.3%,较已发表的贝叶斯建模基线约 73% 提升 10.3 个百分点。研究还发现统计协变量与基础模型嵌入向量具有互补性,多模态融合加智能数据选择优于基线。

    匹配字段摘要
星期四

  1. Unsloth精选

    Unsloth 发布 GLM-5.3-Flash 本地运行 GGUF 量化版

    Unsloth 宣布 GLM-5.3-Flash 可通过其 GGUF 量化版本在本地运行,3-bit 量化需要 128GB 内存,并附上使用指南与 GGUF 下载链接。被引用的 Z.ai 发布信息显示,GLM-5.3-Flash 为 320B-A18B 模型,采用 MIT 许可证,原生多模态并支持 1M token 上下文窗口,此前以 Ox Alpha 名义预览,完全运行在中国 AI 芯片上。Unsloth 称该模型在 DeepSWE、编码与智能体基准上可与 Claude Opus 4.8 相比。

    匹配字段摘要

  2. Cohere 产品与研究博客精选

    Cohere 发布企业文档解析模型 Parse

    Cohere 推出视觉语言模型 Parse,将多模态企业文档转换为结构化数据,现已通过 Cohere API、Model Vault、Microsoft Foundry 和 AWS SageMaker 正式提供。Parse 支持九种主要语言,能够识别表格和嵌入图片并输出 Markdown,在 ParseBench 的三个评测维度中得分 79.2。Cohere API 定价为每 1,000 页 $1.50,8 H100 GPU 节点的处理速度为每秒 36 页。

    匹配字段摘要

  3. NVIDIA Developer · Generative AI精选

    NVIDIA 在 GB300 NVL72 上实测 Qwen3.8-Flash-Next 智能体编码

    阿里发布 Qwen3.8-Flash-Next 权重,作为 Qwen4 架构预览供开发者实验评估,这是一个 125B 参数、每 token 激活 6B 的多模态 MoE 模型,原生上下文窗口 262,144 token,借助 YaRN 可扩展至 1M token。NVIDIA 提供 SGLang、vLLM 和 TensorRT LLM 的 Day 0 功能支持,并在 GB300 NVL72 上验证推理,单 GPU 吞吐超过 16K token/秒、单用户超过 200 token/秒。开发者可用 NVIDIA NeMo AutoModel 微调、用 NeMo RL 做强化学习,权重可从 Hugging Face 或 ModelScope 下载。

    Decorative image.

    匹配字段摘要

星期三

  1. Unsloth精选

    Unsloth 发布 Qwen3.8-Flash GGUF,75GB 内存可本地运行

    Unsloth 发布 Qwen3.8-Flash 的 GGUF 量化版本,可在 75GB 内存的本地环境运行这个 125B MoE 模型,并称其表现超过 Claude-Opus-4.6(Max)。同时发布的 Qwen3.8-Flash-Next 支持 CPU 内存与统一内存方案,速度接近显存运行。Unsloth 提供了使用指南和 GGUF 下载链接。被引用的 Qwen 官方介绍显示,Qwen3.8-Flash 为多模态 MoE,采用 GDN + QSA 混合注意力等新架构,每 token 激活 6B 参数,原生上下文 262K,可经 YaRN 扩展至 1M。

    匹配字段摘要

  2. Qwen Blog精选

    Qwen 开源 Qwen3.8-Flash-Next:125B 参数 MoE,激活 6B,训练成本约为 Qwen3.7-Plus 的 1/9

    Qwen 团队开源多模态 MoE 模型 Qwen3.8-Flash-Next,主模型 125B 参数、额外 51B N-gram 嵌入参数、每 token 激活 6B,训练成本约为 Qwen3.7-Plus 的 1/9,原生支持 262,144 tokens 上下文并可通过 YaRN 扩展至 1,000,000 tokens。该模型是 Qwen4 架构的早期预览,在注意力、残差、嵌入和优化四方面升级,采用 GDN + QSA 混合注意力、Gated Residual、N-gram Embedding 与 Muon 优化器,权重已在 Hugging Face 和 ModelScope 开放。生产版本以 qwen3.8-flash 名称在 QwenCloud 提供服务,默认 1M 上下文并内置官方工具,定价为每百万输入 tokens 0.15 美元、每百万输出 tokens 0.47 美元。

    匹配字段摘要

  3. LMSYS Blog精选

    Qwen3.8-Flash-Next 开源,SGLang 提供 day-0 支持

    Qwen 团队开源 Qwen3.8-Flash-Next,这是一个多模态 MoE 模型,也是 Qwen4 架构的早期预览,SGLang 联合 Qwen、NVIDIA、AMD 提供 day-0 支持。模型主模型 125B 参数,另有 51B N-gram Embedding,每 token 激活 6B 参数,共 48 层,其中 36 层 GDN 线性注意力、12 层 QSA 稀疏注意力,MoE 使用 512 个专家、top-10 路由。SGLang 侧给出 NVFP4 量化 checkpoint、N-gram Embedding 主机内存卸载、Gated Residual 的 FlashInfer 算子以及 MTP 索引复用等优化,在 B200 TP4 下 NVFP4 checkpoint 配合 MTP 在 batch size 1 时解码达 540 tok/s。

    Qwen3.8-Flash-Next Architecture

    匹配字段摘要

星期一

  1. The Rundown AI

    AI 前沿的神秘挑战者:Ox Alpha

    匿名模型 Ox Alpha 免费登陆 OpenRouter,支持 1M-token 上下文和多模态输入,面向编程与持续智能体任务。其 DeepSWE 子集完整测试得分为 63%,接近 Fable 5 且每项任务消耗的 Token 更少;早期线索指向智谱 AI,但开发者身份尚未揭晓。

    匿名模型 Ox Alpha 免费登陆 OpenRouter,支持 1M-token 上下文和多模态输入,面向编程与持续智能体任务。其 DeepSWE 子集完整测试得分为 63%,接近 Fable 5 且每项任务消耗的 Token 更少;早期线索指向智谱 AI,但开发者身份尚未揭晓。 · The anonymous Ox Alpha model launched free on OpenRouter with a 1M-token context window and multimodal input for coding and sustained agentic work. It scored 63% in full testing on a DeepSWE subset, approaching Fable 5 while using fewer tokens per task; early clues point to Zhipu AI, but its developer remains unconfirmed.

    匹配字段摘要

星期五

  1. DeepSeek

    DeepSeek-V4-Flash-Vision-Exp 上线 DeepSeek API Platform

    DeepSeek 在 API Platform 上线实验性多模态模型 DeepSeek-V4-Flash-Vision-Exp,其文本能力与 DeepSeek-V4-Flash 相当,涵盖智能体、推理和世界知识。该模型在多模态智能体评测中较 V4-Flash 显著提升,表现接近 Opus-4.8;DeepSeek Harness 0.1.1 已提供开箱即用的支持。

    DeepSeek 在 API Platform 上线实验性多模态模型 DeepSeek-V4-Flash-Vision-Exp,其文本能力与 DeepSeek-V4-Flash 相当,涵盖智能体、推理和世界知识。该模型在多模态智能体评测中较 V4-Flash 显著提升,表现接近 Opus-4.8;DeepSeek Harness 0.1.1 已提供开箱即用的支持。 · DeepSeek has made the experimental multimodal model DeepSeek-V4-Flash-Vision-Exp available on its API Platform, with text capabilities matching DeepSeek-V4-Flash across agents, reasoning, and world knowledge. It significantly improves on V4-Flash in multimodal agent benchmarks, approaching Opus-4.8, and DeepSeek

    匹配字段摘要

  2. AI at Meta

    Meta 预览 WildArtifactBench 智能体评测框架

    Meta 预览内部评测框架 WildArtifactBench,用于评估智能体在多种交付格式下的复杂真实任务,并开放其中 10 个任务。该框架采用人类与智能体偏好评判给出的胜率和 Elo 分数,而非严格的标准答案评分标准,从而扩大对实际多模态工作流的任务覆盖。帖子还展示了 Muse Spark 1.1 和 1.2 在 Cat Mesh、Plywood Whale 任务上生成的产物。

    匹配字段摘要

星期五

  1. Unsloth

    Unsloth 发布 Qwen3.8-27B 的 GGUF 量化版本,17GB 内存可本地运行

    Unsloth 宣布 Qwen3.8-27B 现已可通过其 Dynamic GGUF 在本地运行,17GB 内存即可跑起来,同时上传了 NVFP4 量化版本,并附上 GGUF 下载链接与使用指南。被引用的 Qwen 官方推文介绍,Qwen3.8-27B 是原生多模态稠密模型,27B 参数下整体表现超过 Qwen3.7-Plus,在真实编码与办公工作流中表现突出,原生上下文 262K,可通过 YaRN 扩展至 1M tokens,采用 Apache 2.0 许可;Qwen3.8-2.4T-A95B(Max 级)的开放权重也已发布。

    匹配字段摘要

星期一

  1. Ollama Blog

    Meta Superintelligence Labs 首个开源模型 Muse Glimmer 上线 Ollama

    Meta Superintelligence Labs 的首个开源模型 Muse Glimmer 已在 Ollama 上线,这是一个 30B 多模态模型,面向本地运行的智能体工作负载,上下文长度 128K+,采用 Apache 2.0 许可。它可用于 Claude Code、Codex、Pi 等编码智能体,以及 OpenClaw、Hermes 等长期运行的个人助手,并支持 low、medium、high、xhigh 四档可控推理强度。在 Apple Silicon 上,Ollama 的 MLX 引擎新增 DFlash 与图像输入支持,使 Muse Glimmer 运行速度提升 1.5×–1.8×,其 1.8B 参数感知编码器带来原生图像理解能力。

    匹配字段摘要

星期日

  1. Interconnects

    最新开源模型盘点第23期:Laguna S2.1、Inkling 与 Kimi K3 展现开源模型的帕累托前沿价值

    Interconnects 发布第23期开源模型盘点,涵盖 Thinking Machines 的 Inkling、腾讯 Hy3、Poolside 的 Laguna-S-2.1 与 Laguna-XS-2.1、DeepSeek-V4-Flash-0731、月之暗面 Kimi-K3、美团 LongCat-2.0、Motif-3-Beta、Swiss AI 的 Apertus-v1.5-70B 以及 AMD 的 Instella-MoE-16B-A3B-Think。作者认为此前关于模型实验室将走向整合的预测并未成真,反而有更多公司在训练强模型并公开释出,token 需求高涨让更多机构把构建 token 机器视为价值路径。其中 Thinking Machines 的 Inkling 是 975B-A41B 多模态 MoE,支持文本、图像和音频输入,并同步发布 276B-A12B 小版本;美团 LongCat-2.0 为 1.6T 参数 MoE,完全在昇腾 910 上训练。

    匹配字段摘要

星期一

  1. Air Street Press精选

    Black Forest Labs 发布 FLUX 3,视频生成骨干被用于机器人控制

    Black Forest Labs 发布多模态基础模型 FLUX 3,在单一架构中联合学习图像、视频和音频,可单次生成最长 20 秒带音频视频,支持文本、图像或视频输入。其视频骨干被 mimic 用于 FLUX-mimic 机器人控制系统,在软体 kitting 任务上报告 95% 成功率,高于同数据训练的 π0.5 的 55%;冻结骨干时仍具竞争力。FLUX 3 Video 已开放早期访问,图像生成与编辑随后推出,动作预测通过合作方提供,并计划发布开放权重版本。

    匹配字段摘要

  2. Modal 官方工程博客精选

    Moonshot 发布 Kimi K3,Modal 同日上线并实现 460 tokens/s

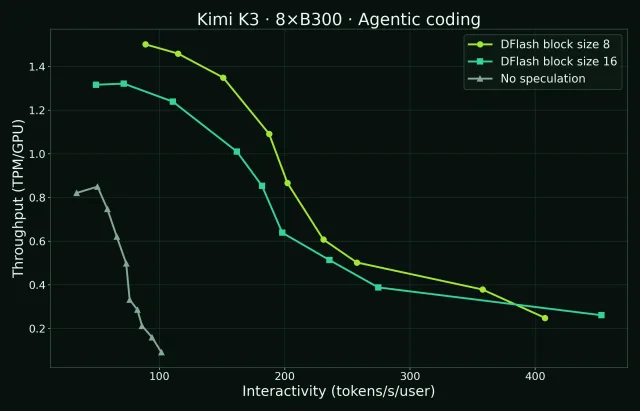
    Moonshot 发布 Kimi K3,这是一个 2.8 万亿参数的多模态模型,具备 1M token 上下文窗口和原生视觉能力,采用 MoE 架构,每 token 激活 896 个专家中的 16 个。Modal 与 Moonshot、vLLM 合作在发布当天完成支持,通过定制训练的 DFlash 推测器将交互速度从 100 提升到 460 tokens/s,单 GPU 吞吐从 800k 提升到 150 万 TPM。K3 现已通过 Modal 的 OpenAI 兼容 Shared API 按 token 计费提供,也可作为 Auto Endpoint 使用。

    匹配字段摘要

星期四

  1. 阶跃星辰 StepFun

    Step 3.7 Flash 上线 Baseten

    很高兴看到 Step 3.7 Flash 现已通过 @baseten 提供。 我们为真实世界的智能体工作流打造了这款模型,具备原生多模态理解、可靠的工具调用以及生产所需的效率。 感谢 Baseten 团队的出色合作。

    很高兴看到 Step 3.7 Flash 现已通过 @baseten 提供。 我们为真实世界的智能体工作流打造了这款模型,具备原生多模态理解、可靠的工具调用以及生产所需的效率。 感谢 Baseten 团队的出色合作。

    匹配字段摘要

星期三

  1. Together AI Blog精选

    Together AI 首日上线 Thinking Machines Lab 新模型 Inkling

    Thinking Machines Lab 发布多模态混合专家模型 Inkling,Together AI 同日在其推理平台上线。Inkling 接受文本、图像和音频输入并输出文本,支持可调推理强度,总参数 975B、每 token 激活 40B、上下文窗口 1M tokens。Together AI 称其采用基于 FlashAttention-4 的注意力内核,通过 Serverless 单端点提供三种输入模态。

    匹配字段摘要

星期二

  1. The Next Platform

    HPE 与 Dell 在量子-经典 HPC 数据中心的布局

    HPE 在 Discover 2026 上宣布与 Intel、IQM、Quantinuum、QuEra、Rigetti 等合作,把多模态量子系统与其 Cray 超级计算机家族集成,并打造混合算法、软件互操作与 HPC-量子工作流基准测试平台。IQM 已售出 23 套系统,其 20-qubit Radiance 系统在橡树岭国家实验室投入运行,Halocene H4 将于明年部署于 LUMI AI Factory。Dell 过去 10 年已与 20 多家量子公司合作。

    匹配字段摘要

星期六

  1. Mira Murati

    Thinking Machines 成立一周年回顾

    一年前,我们以多模态 AI、定制模型和开放科学为重点,立志赋能人类。 我们预览了能像人一样协作的交互模型。Tinker 让任何人都能训练自己的开放权重模型。我们发表了关于 Connectionism 的研究。

    一年前,我们以多模态 AI、定制模型和开放科学为重点,立志赋能人类。 我们预览了能像人一样协作的交互模型。Tinker 让任何人都能训练自己的开放权重模型。我们发表了关于 Connectionism 的研究。

    匹配字段摘要

星期四

  1. Amazon Science

    Amazon Science 发布 Rust 代理 Turnstile,为智能体强化学习捕获 token ID

    Amazon Science 发布用 Rust 编写的代理 Turnstile,位于智能体 harness 与模型后端之间,在生成时刻记录模型采样的精确 token ID、逐 token 对数概率和 loss mask,并导出与框架无关的轨迹供现有 RL 训练栈使用。Turnstile 兼容 OpenAI Chat Completions API,harness 无需改动,后端目前为 SGLang,计划支持 vLLM。在验证中,一个纯文本编码智能体和一个多模态计算机使用智能体在 RL 训练中持续提升。

    匹配字段摘要