Unsloth 推出 DSpark,DeepSeek-V4-Flash 本地推理提速约 1.4–2 倍
Unsloth 发布 DSpark,使 DeepSeek-V4-Flash-0731 的 GGUF 本地生成速度提升约 1.4–2 倍,且精度不变。该版本在本地可达到 120 tokens/s,Unsloth 同时提供了 GGUF 文件与使用指南。
匹配字段标题
Unsloth 发布 DSpark,使 DeepSeek-V4-Flash-0731 的 GGUF 本地生成速度提升约 1.4–2 倍,且精度不变。该版本在本地可达到 120 tokens/s,Unsloth 同时提供了 GGUF 文件与使用指南。
匹配字段标题
Jensen Huang 宣布推出面向自动驾驶汽车的前沿开放推理模型 Alpamayo 2 Super,使系统能够理解复杂环境并在行动前进行推理。该模型依据 OpenMDW-1.1 许可开放商业使用,团队可检查、微调和部署,并可作为出租车、卡车、班车、配送车、拖拉机及移动机器人的基础模型。
匹配字段标题
NVIDIA 技术博客分析 dense attention 在 GPU 上的性能规律:增大 group size(G)可提升 decode 吞吐,head dimension 取 128 或 256 更契合 GPU tile 与 128 字节内存传输;prefill 延迟随 ISL 平方增长,decode 延迟随 KV cache 序列长度线性增长。文章给出四条协同设计准则,并指出张量并行不应超过 KV head 数(KH),TensorRT-LLM 以 Wide EP 和 Helix Parallelism 应对。
匹配字段标题
Together AI 的 Dedicated Model Inference 支持按推理引擎原生指标自动扩缩容,包括 in-flight requests、TTFT、GPU 利用率和 token 吞吐量,用户可设置副本上下限、指标目标值以及控制扩容与缩容节奏的两个时间窗口。平台提供 8 种扩缩容指标,多指标时仅第一个生效;min_replicas: 0 只能与 max_replicas: 0 搭配用于显式停止部署,不支持缩容到零后自动唤醒。
匹配字段标题
Together AI 联合佐治亚理工、UIUC 和 CMU 提出 ThunderAgent,把每个智能体工作流抽象为可调度程序,以程序级调度缓解 KV cache thrashing,在合成数据生成流水线中实现最高 2.5 倍单节点吞吐提升。在单台 8×H100 节点、batch size 192 下,SGLang 吞吐降至 390 token/s、平均延迟 65s,ThunderAgent 达到 803 token/s、平均延迟 10.6s;8 节点集群上相对 SGLang Gateway 加速 2.39 倍,从 16 到 64 GPU 吞吐近线性扩展。该工作已被 ICML 2026 接收为 Spotlight 论文,代码开源,客户端只需增加一个 program_id 字段,并已被 SkyRL 和 NVIDIA Dynamo 采用。

匹配字段标题
Together AI 的专用模型推理由 endpoint、deployment 和 config 三部分组成,通过容量感知流量拆分将三者绑定,支持灰度发布、A/B 测试、影子实验和零停机变更。路由按 weight × ready_replicas 计算有效容量并按比例分配流量,因此相同权重代表每副本负载相同而非流量份额相同。config 以不可变的 cr_ 修订形式存在,模型目录自带经认证的部署配置,例如 zai-org/GLM-5.2 在 4 张 NVIDIA-B200 上以 FP4 量化、TP4 并行运行。
匹配字段标题
Kimi K3 已在 Together AI 上线,Together AI 作为 Day 0 发布伙伴,为开发者提供针对编码智能体和生产负载优化的高吞吐推理访问。Together AI 称 K3 是 Kimi 的开源前沿模型,面向跨代码、工具、视觉和研究的长时间智能体工作流。Kimi 方面感谢 Together AI 团队快速推进此次发布。
匹配字段标题
Kimi K3 现已在 @digitalocean 的 Serverless Inference 上线! 开发者可以在几分钟内用我们最强的模型开始构建。https://t.co/mDDv2zBpJg
匹配字段标题
Fireworks 在 Kimi K3 开源当天提供 Day-0 推理与训练支持,称其为全球最强开源模型,并推出仅限美国区域的 Serverless 端点和零数据保留。Kimi K3 是首个达到 2.8 万亿参数的开源模型,采用 Kimi Delta Attention 与 Stable Latent MoE,激活 896 个专家中的 16 个,扩展效率是 Kimi K2 的 2.5 倍。Fireworks 称自托管需 64 个以上加速器超级节点,其 Serverless 推理默认速率限制提升 10 倍以上,Serverless Training 进入私有预览。
匹配字段标题
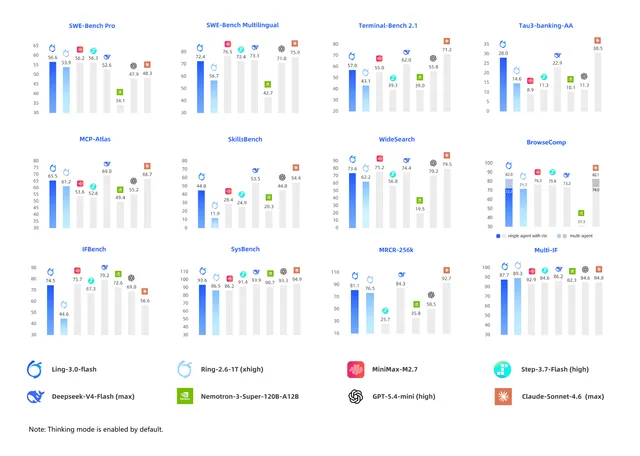
蚂蚁百灵发布新一代原生混合推理模型 Ling-3.0-flash,总参数量 124B、激活参数 5.1B,官方称在多项指标上对标甚至超越上一代 1T 级旗舰 Ring-2.6-1T。模型从预训练起采用 5:1 交替堆叠 KDA 与 MLA 的混合线性注意力架构,专家激活比例由 1/32 降至 1/64,原生支持 256K 上下文并可扩展至 1M。官方同时开放 OpenRouter 与百灵官方平台限时免费 API 调用,免费期截至 8 月 3 日 23:00,权重将在免费期结束后开源。
匹配字段标题
Hugging Face 在 Diffusers 中原生支持 Nunchaku Lite,可直接加载采用 SVDQuant 的 4-bit 扩散模型,无需自定义管线、独立推理引擎或本地编译。在 RTX 5090 上,示例模型生成 1024x1024 图像约需 1.7 秒,峰值显存约 12 GB,而 BF16 管线约为 24 GB。NVFP4 检查点要求 NVIDIA Blackwell GPU,早期架构可使用 INT4,但 Volta 和 Hopper 目前不受支持。
匹配字段标题
Together AI 发布 Dedicated Model Inference 推理平台更新,支持在同一稳定端点后运行多个部署,并提供 canary、蓝绿和滚动更新及按阈值自动回滚、A/B 与影子流量测试、按 inflight 请求或 GPU 利用率等指标自动扩缩容。平台重建了模型缓存与分发层,内部测试中多个前沿模型的冷启动速度约提升 4 倍,同时提供组织级 Prometheus 端点接入自有可观测工具。Together AI 还开启自定义训练内测,涵盖全权重与 LoRA 强化学习及监督微调,checkpoint 可直接部署到推理服务,内测名额有限。
匹配字段标题
Sakana AI 在 ICML 2026 论文 UnMaskFork(UMF)中提出,让多个掩码扩散语言模型(MDLM)通过模型切换协作完成同一个答案,并用蒙特卡洛树搜索寻找不同模型负责不同阶段的顺序。该方法无需额外训练或改动模型,在编码基准上持续优于现有推理时扩展方法,在数学任务上也随计算量增加稳步提升。
匹配字段标题
文章解释了大语言模型如何通过不同推理力度,在回答质量、token 消耗、成本和延迟之间进行权衡。其实现通常结合混合 SFT 数据、按模式调整的 RL 奖励、长度惩罚、独立专家模型或硬性 token 预算;DeepSeek V4、Nemotron 3 Ultra、Kimi K3、GLM-5、Qwen3 和 Inkling 采用了不同组合。模型规模与推理力度是两套独立控制方式,较小模型提高推理力度有时可达到与较大模型降低推理力度相近的基准成绩。
匹配字段标题
Andrew Ng 与 Cerebras 合作推出新课程,教开发者用为快速推理设计的硬件构建 LLM 应用。课程使用 Cerebras 的 Wafer-Scale Engine,通过让模型权重靠近计算单元,使 token 生成速度比典型 GPU 设置快数倍。学员将对比 GPU、TPU 与 Wafer-Scale Engine 处理内存到计算瓶颈的方式,并构建网页个性化和市场信号分析等实时应用。
匹配字段标题
Together AI 发文拆解推理服务 99.9% 可用性背后的架构含义,指出 GPU 推理的故障模式与常规服务不同,需按节点、单数据中心、多设施、多区域逐层应对。Together AI 为 Cursor、Decagon、Cartesia、Yutori 等团队提供推理服务,并称其可用性在推理完成时而非网关处计量,可用性与性能是两份不同的合约。
匹配字段标题
Unsloth 发布 Gemma 4 的 NVFP4 量化版本,称在 GPU 上推理速度提升 1.5 倍。其中 Gemma-4-12B NVFP4 可在 11GB 显存上运行,26B-A4B 在 B200 上达到 13K tok/s。官方称该 NVFP4 方案面向 Blackwell 平台,可实现更快、更准确的 4-bit 推理。
匹配字段标题
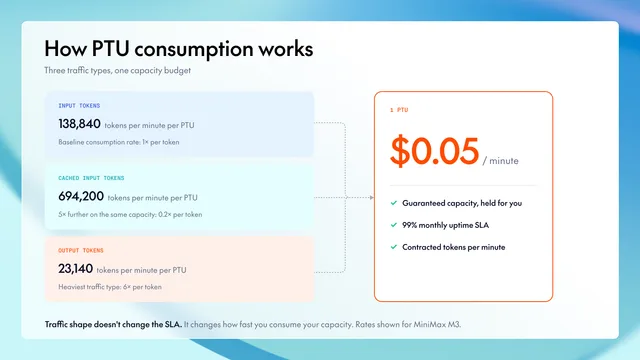
Together AI 推出 Provisioned Throughput,为前沿开放模型提供预留推理容量,采用按 token 计费并附带 99% 可用性 SLA,成本最高比 Claude Opus 4.8 标价低 90%。该产品今日起支持 MiniMax M3 和 GLM-5.2,容量覆盖北美、EMEA 等地区,最短承诺期一个月。用户按 Provisioned Throughput Units(PTU)购买,每个 PTU 每分钟 0.05 美元,在 MiniMax M3 上单个 PTU 每分钟可提供 138,840 输入 token、694,200 缓存输入 token 或 23,140 输出 token。
匹配字段标题
DeepLearning.AI 周报汇总多项进展:OpenAI 发布 GPT-5.6 Sol、Terra、Luna 三款闭源视觉语言模型,目前仅向约 20 家美国政府批准的机构开放,价格从每百万 token 输入 5 美元到 1 美元不等,OpenAI 称未来几周扩大开放。Sakana AI 发布 Fugu 与 Fugu-Ultra 两款编排其他模型和智能体的模型,称在 Terminal-Bench 2.1、GPQA-Diamond 等基准上超过 Claude Fable 5、Claude Mythos Preview 和 GPT-5.5。微软推出首个未蒸馏或微调自其他厂商的推理模型 MAI-Thinking-1,采用 MoE 架构,总参数 1 万亿、每 token 激活 350 亿,称在 AIME 2025 上以 97.0% 超过 Claude Sonnet 4.6。周报还介绍了斯坦福与伯克利团队的 RoboReward 机器人奖励模型。
匹配字段标题
BAIR 公布 2026 届博士毕业生名单,其研究覆盖机器人、具身智能、大语言模型与推理、计算机视觉、生成模型、AI 安全、人机交互及 AI for Science 等方向。毕业生去向包括 OpenAI、Mistral AI、Physical Intelligence、Amazon 研究岗、普林斯顿 CITP 博士后以及自主创业。

匹配字段标题