2026 BAIR 博士毕业生展示:从机器人到 LLM 推理的 AI 研究全景
BAIR 公布 2026 届博士毕业生名单,其研究覆盖机器人、具身智能、大语言模型与推理、计算机视觉、生成模型、AI 安全、人机交互及 AI for Science 等方向。毕业生去向包括 OpenAI、Mistral AI、Physical Intelligence、Amazon 研究岗、普林斯顿 CITP 博士后以及自主创业。
匹配字段标题
BAIR 公布 2026 届博士毕业生名单,其研究覆盖机器人、具身智能、大语言模型与推理、计算机视觉、生成模型、AI 安全、人机交互及 AI for Science 等方向。毕业生去向包括 OpenAI、Mistral AI、Physical Intelligence、Amazon 研究岗、普林斯顿 CITP 博士后以及自主创业。
匹配字段标题
ElevenLabs 研究工程师 Angelos Perivolaropoulos 介绍了如何通过标准工程优化,将语音推理的单 GPU 服务能力从 1 名用户提升至 70 名,架构级改造则可达到约 140 名。连续批处理、FP8 量化、多 token 预测和经蒸馏适配的 FP8 KV cache 是主要手段,其中 KV cache 缩小 2.5x 后,吞吐量从 28 名用户增至 70 名。各项技术会引入延迟、内存上限或质量损失,实际选择取决于具体工作负载。
匹配字段标题
LLM RL 优化顺序推理 我们还优化推理策略,包括并行思维链、并行轨迹聚合和顺序推理 这使模型能在测试时更好地探索和分配计算资源
匹配字段标题
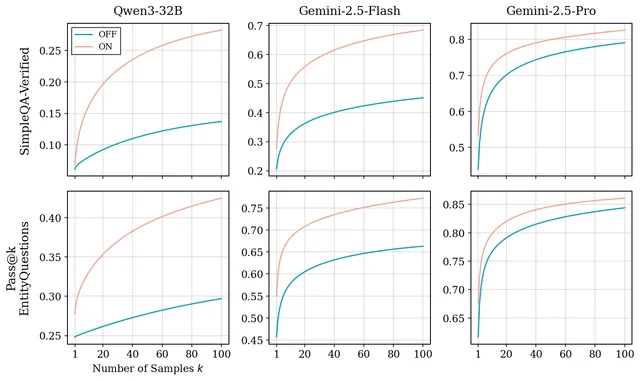
Google Research 在 COLM 2026 论文中揭示,推理能帮助 LLM 回忆简单事实,机制包括用生成的推理 token 进行隐式计算,以及生成相关事实来激活正确答案。研究在 Gemini-2.5 Flash/Pro 和 Qwen3-32B 上,用 SimpleQA Verified 与 EntityQuestions 数据集对比推理开关模式,发现开启推理后模型能回忆起关闭时几乎无法获取的答案。
匹配字段标题
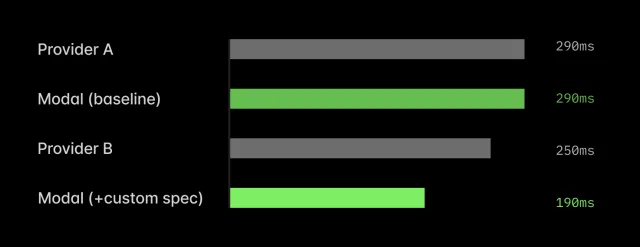
Modal 本周推出 Auto Endpoints,结合 Blackwell GPU、SGLang 和 Modal Servers,通过推测解码优化延迟。在 Decagon Voice 案例中,基线 p50 延迟约 290ms,优化后削减 100ms,比专有推理提供商的最佳延迟快 60ms 以上。推测解码带来的加速与接受长度近似线性,是降低解码延迟的关键手段。
匹配字段标题
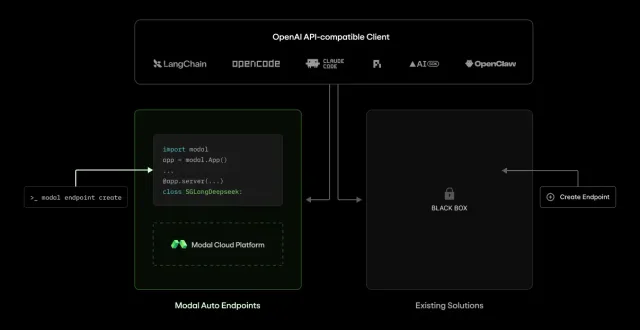
Modal 发布 Auto Endpoints,提供 OpenAI API 兼容、生产可用的推理服务,底层是用户可见可控的 Modal App,可通过 CLI 或点击部署 GLM 5.2 等开放模型。官方称不隐藏代码与指标,自动提供投机解码接受长度、每副本引擎侧 token 延迟分位数等数据,并同步推出面向超低延迟路由的 Modal Servers,HTTP 请求开销约 5ms。其部署配方基于 SGLang、FlashAttention-4 等开源引擎的补丁与上游贡献,并采用 Z Lab 的 DFlash 块扩散 drafter 架构。
匹配字段标题
百度美研在十年前投资晶圆级芯片公司 Cerebras,以降低 AI 计算中的通信成本并减少对英伟达的依赖。文章回顾了其流片、散热、电源和编译器等工程难题,并认为 CUDA 生态使训练迁移成本较高,而推理需求增长正为 Cerebras 等异构芯片带来新窗口。
匹配字段标题
Tensordyne 公布其 Napier AI 推理引擎架构,核心思路是把数据转成对数后用加法替代矩阵乘法,官方称相比 Nvidia 和 AWS 的混合架构性能提升一个数量级以上,价格与功耗更低。Napier 采用 3nm 工艺、1380 亿晶体管,支持 NVFP4、FP8、FP16,FP8 稠密算力 2.1 petaflops,配备 144 GB HBM4 和 256 MB SRAM,单芯片功耗 300 瓦,对比 B300 GPU 的 1200 瓦。公司计划 2026 年底开放云端访问,2027 年第一季度向客户交付 beta 版 TDN Pod 系统,2027 年第二季度末开始出货。
匹配字段标题
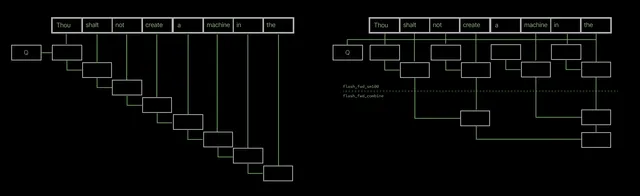
Modal 对 FlashAttention-4 内核做了一系列改动以适配 LLM 推理,尤其是解码阶段:PR 2109 支持 FP8 输入(e4m3/e5m2),相对 bf16 基线吞吐最高提升 1.16 倍;PR 1999 与 PR 2104 支持任意 KV page size 并优化性能,小 page size 下吞吐最高提升 2.40 倍。改动还包括调整并行策略(从 query 并行转向 key/value 并行)以及用 cp.async 加载替代 TMA 的 cp.async.bulk 加载以支持不规则全局内存访问。
匹配字段标题
微软 MAI 在 Build 2026 主题演讲中发布七款新模型,覆盖图像、语音、转录、推理和编码。首个推理模型 MAI-Thinking-1 为 35B 激活参数 MoE,256K 上下文窗口,AIME 25 得分 97%,SWE Bench Pro 53%,官方称未做知识蒸馏。编码模型 MAI-Code-1-Flash 仅 5B 参数,SWE Bench Pro 51%,今日起在 VS Code 中逐步向约 10% 个人用户推送。
匹配字段标题
微软 AI 发布七款自研 MAI 模型,覆盖图像、语音、转录、编码与推理,包括旗舰推理模型 MAI-Thinking-1、面向 GitHub Copilot 的 MAI-Code-1-Flash、MAI-Image-2.5、MAI Transcribe-1.5 和 MAI-Voice-2。MAI-Thinking-1 在盲测人工对比中优于 Sonnet 4.6,MAI Transcribe-1.5 支持 43 种语言且速度是竞品的五倍,MAI-Image-2.5 的 Arena 分数超过 Nano Banana Pro。模型将在 Foundry、OpenRouter、Fireworks 和 Baseten 上提供,开发者首次可以自行微调模型权重;微软同时宣布与 Mayo Clinic 合作共建医疗前沿模型。
匹配字段标题
LMSYS 通过 Dynamo 与 SGLang 实现异构 Encode-Prefill-Decode(EPD)分离,将 VLM 的视觉编码任务卸载到 CPU(如头节点 CPU),在负载下 TTFT、TPOT 和吞吐量均获提升。在 Intel Xeon 6747P 与 5x L40S 配置、8 张 1080p 图像、QPS 1.0-2.0 下,P99 TTFT 和请求吞吐量提升约 1.2x-1.3x,P99 TPOT 降低约 1.3x-30x。Dynamo 路由器新增设备感知加权路由模式(PR #7215),以能力比 R 在 CPU 与 GPU 池间分配请求。
匹配字段标题
MiMo-V2.5 系列推理有什么新进展? 我们刚刚发布了一篇博客,介绍 MiMo-V2.5 系列的全流程推理优化,包括我们如何将混合 SWA 效率推向极限。 在此阅读完整博客: https://t.co/lYBEcgaVhU
匹配字段标题
Zyphra Research 与 AWS 合作,在 AWS Neuron 推理栈中实现了 Domino 式张量并行通信重叠,并在 Inferentia2 上对 Llama 3-8B 进行不同 NeuronCore 数量的基准测试。结果显示聚合输出吞吐量提升,首 token 时间和每输出 token 时间均下降,在张量并行度更高、集合通信占关键路径更大时收益最明显。

匹配字段标题
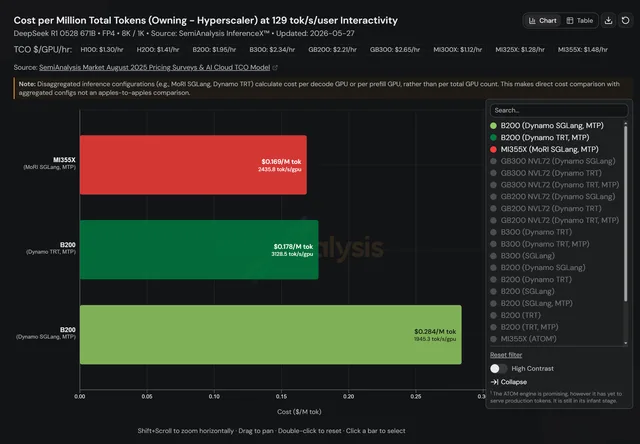
SGLang 与 AMD 团队合作,在 AMD Instinct MI355X 上通过 SGLang 与 MoRI 通信库优化 DeepSeek-R1 分离式推理,在 129 tok/s/user 交互性下达到每百万 token 0.169 美元,比 B200 TRT-LLM 低 5%、比 B200 SGLang 低 40%,每 GPU 吞吐 2,436 tok/s(24 GPU),比 B200 SGLang 高 1.25 倍。优化包括 MoRI 量化 all-to-all(往返带宽最多降低 2.56 倍)、MoRI-IO KV cache 后端(吞吐比 Mooncake 高约 10%)、SDMA 双批次重叠、ROCm 上的 Specv2 MTP 以及 CPU 流式优化。结果已开源并通过 SemiAnalysis 的 InferenceX 持续验证。
匹配字段标题
LG AI Research 提出“GPU Job Scheduling using an idle inference GPU pool”方案,把 LLM 服务夜间闲置的推理 GPU 用于训练和研究任务。其基于 vLLM 内部指标做自动扩缩容,分析显示单副本占 4 张 GPU 时,平均约 52 张 GPU 每天闲置约 12 小时;任务以 best-effort 方式运行,服务流量上升时可随时被中断回收。
匹配字段标题
antirez 在 DwarfStar 项目中探讨本地 LLM 推理的分布式方案:Mac Studio M3 Ultra 512GB 可跑 DeepSeek v4 PRO,约 150 t/s prefill、10-13 t/s 解码;M5 Max 128GB 跑 2-bit 量化的 DeepSeek v4 Flash 和 Mimo V2.5 可达约 500 t/s prefill、35-40 t/s 解码。他提出层切分、基于 Apple RDMA 的专家并行,以及共享无关的 LLM ensemble 三种思路,认为 ensemble 是被低估的第三方向。
匹配字段标题
Together Inference Engine 在 Kimi K2.5 编码智能体负载下,以相同的 4× NVIDIA B200 硬件实现了比 TensorRT-LLM 高 31% 的 TPS,并在饱和时保持约 2 倍更优的 TTFT。测试采用约 45k–200k Token 的长提示词和平均 450 Token 的输出;SGLang 因 TP4 内存不足改用 8× B200。性能提升来自 ThunderMLA、定制内核重写及真实流量下的端到端分析。
匹配字段标题
Zyphra 发布 Zyphra Inference 在单节点 AMD Instinct MI355X GPU 上的首批端到端基准,覆盖 Kimi K2.6、GLM-5.1 和 DeepSeek V3.2,并与 AMD MI355X 与 Nvidia B200 基线配置对比。MI355X 每卡提供 288 GB HBM3E(B200 为 180 GB),两者 HBM 带宽均约 8 TB/s,但 MI355X 采用全连接 xGMI 点对点互联,8 路集合通信峰值 537.6 GB/s。测试使用 ShareGPT 与 LMSYS-Chat-1M,仅限 vLLM 框架、单节点且无真实流量。

匹配字段标题
Together AI 与 Pearl Research Labs 推出 Gemma-4-31B-it-pearl 推理端点,利用 Pearl Network 在推理过程中生成 ¶PRL,使价格降低超过 25%。双方计划扩展 Pearl 驱动的产品组合,并探索让客户直接获得部分货币发行收益。
匹配字段标题