←搜索结果

按匹配度 · 共 1368 条结果 清除搜索

星期五

  1. 上观新闻

    玉渊谭天解读中国AI技术出口禁令传闻

    针对外界关于中国要关上AI技术出口大门的说法,玉渊谭天梳理了10月16日商务部、科技部就修订《中国禁止出口限制出口技术目录》公开征求意见的背景与规则边界。文章指出,监管重点是数据安全、敏感用途和算力底座三类技术,企业用限制类大模型对外提供API调用、APP/网页交互、SaaS应用等不属于大模型技术出口管理范围,开源技术和特定国际业务适用自动许可等便利措施。文中还提到,DeepSeek、MiniMax两家企业已履行登记手续并完成开源和海外授权使用。

    匹配字段摘要、正文

  2. Artificial Analysis

    Artificial Analysis 编程智能体指数 v2.0:Claude Opus 5.5 登顶 61.7

    Artificial Analysis 发布 Coding Agent Index v2.0,Claude Code 搭配 Claude Opus 5.5(max)以 61.7 分登顶,Claude Sonnet 5.5(max)59.3 分次之。新版以 Cognition 的 FrontierCode v1.1 替换 DeepSWE,Opus 5.5 在该基准得 56.0%,领先 Codex 搭配 DeepSeek V4.1 Flash 的 52.6%。SWE-Atlas-QnA-AA 改用 GPT-6 Luna(xhigh)评判、每项五票,21 个配置均分从 58.8% 降至 57.1%。

    匹配字段摘要、正文

  3. Matt Turck

    Mistral 研究负责人谈 Le Chonk:西方最大开源模型的追赶内幕

    Matt Turck 与 Mistral 研究负责人 Pierre Stock 对谈,围绕被称为西方最大开源模型的 Le Chonk 展开。Stock 谈到团队在自有数据中心用 3800 块 GPU 训练、Le Chonk 目前仍在训练中,以及 Mistral 从 DeepSeek 借鉴了什么、开源权重与网络安全拒答之间的取舍。节目还提及后续将推出 Mistral Large 5。

    匹配字段摘要、正文

星期四

  1. LMSYS Blog

    LMSYS 发布 SGLang AWS Trainium 插件 Beta

    LMSYS 与 AWS 合作发布 SGLang Trainium 插件 Beta,基于新发布的 TorchNeuron 构建,在 Trainium2 和 Trainium3 上支持 LLM 推理服务与 RL rollout 生成。初始覆盖 Qwen3(dense)、Qwen3-MoE-30B-A3B、DeepSeek-V2-Lite、GLM-4 和 GLM-5.2/5.3,并支持数据并行、张量并行、专家并行、Radix Cache、BF16/FP8 和异步调度。首次端到端异构 RL 运行中,SGLang 在 Trainium3 上为 Qwen3-MoE-30B-A3B 生成 rollout,Miles 在单台 H200 节点上用 Megatron 训练 GRPO 策略。Beta 目前仅限少量团队参与。

    匹配字段摘要、正文

  2. Unite.AI

    新论文提出 BackUpper:让编码智能体在动手前先备份

    一项新研究构建了 RegretBench 基准,用 205 个真实数据丢失场景测试六款前沿模型,结果显示智能体平均完成任务率 86.1%,但在关键操作前备份的比例仅 15.2%,其中 GPT-5.6-Terra 为 4.4%、GPT-5.6-Sol 为 5.9%、Gemini 3.7-Flash 为 2.4%,表现最好的 Claude Opus-5 也有超过三分之一场景未备份。作者提出的 BackUpper 作为外挂插件与智能体并行运行,按四级策略替换破坏性命令、配对备份命令、生成快照或调用 GPT-5.6-Luna 子模型判断需保存的数据,测试中覆盖了全部关键操作,恢复数据与原状态平均相似度 92.2%,每任务额外成本 0.014 美元。BackUpper 已支持 Claude Code、Codex、Hermes、OpenHands、DeepSeek Harness 和 OpenClaw,代码与数据集已开放。

    匹配字段摘要、正文

  3. PyTorch Blog

    TorchTitan 更新:新增多款 SOTA 模型支持、TitanRL 与大规模性能提升

    PyTorch 原生训练平台 TorchTitan 发布更新,新增 Muse Spark Open、Muse Glimmer、Qwen3-VL、Qwen3.5、Kimi K2.7、Kimi K3 和 DeepSeek-V4 的完整训练栈支持,并引入强化学习组件 TitanRL。TitanRL 让预训练、后训练到 vLLM 推理共用同一份模型代码,支持异步 rollout 和长上下文、代码执行等智能体任务训练。性能方面,FlexShard 在 256 张 H100 上把 DeepSeekV3 的优化器耗时最多降低 79%,在 Llama3 405B 上把端到端训练步时最多降低 20%。

    匹配字段摘要、正文

星期三

  1. LMSYS Blog

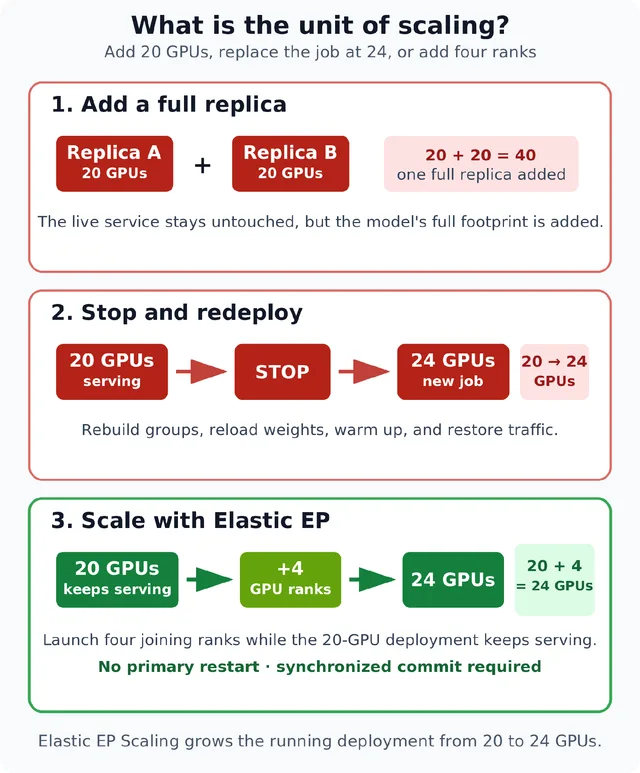
    SGLang 的弹性专家并行扩展:用 NIXL 在线扩容 MoE 部署

    SGLang 的 Elastic EP Scaling 让 MoE 部署无需整副本或重启即可按细粒度增量加入 GPU,20 GPU 示例中扩到 24 GPU。max_ep_size 在启动时预留元数据与通信缓冲容量,新 rank 按需启动;在 8×H100 上用 DeepSeek-V3-Lite FP8 测试,首个完成请求比重启快 5.3×–8.2×。加入 rank 进入 Mooncake WORLD 后暂不支持自动回滚,收尾失败可能需重启部署。

    Comparison of horizontal scaling, restart-based vertical scaling, and live Elastic EP scaling from 20 to 24 GPUs.

    SGLang 的 Elastic EP Scaling 让 MoE 部署无需整副本或重启即可按细粒度增量加入 GPU,20 GPU 示例中扩到 24 GPU。max ep size 在启动时预留元数据与通信缓冲容量,新 rank 按需启动;在 8×H100 上用 DeepSeek-V3-Lite FP8 测试,首个完成请求比重启快 5.3×–8.2×。加入 rank 进入 Mooncake WORLD 后暂不支持自动回滚,收尾失败可能需重启部署。

    匹配字段摘要、正文

  2. Modal 官方工程博客精选

    Modal 发布 LLM 训练库 Modal Dojo

    Modal 发布训练库 Modal Dojo,提供调好的默认配方、可改参数和开箱即用的指标观测面板,支持从 5 亿到数万亿参数模型。该库基于 Miles、Slime 等开源框架构建,可从 Hugging Face 加载数据集,并通过 CLI 让智能体查询运行状态、日志和轨迹。Axiom Bio 称已用它启动 64k 上下文的 DeepSeek V4.1 Flash 训练,运行在 64 张 B300 上。

    匹配字段摘要、正文

  3. 阿里云开发者社区 AI

    阿里云百炼 Token Plan 团队版订阅与 API 接入指南

    阿里云百炼 Token Plan 团队版以 Credits 统一计量,一份订阅可使用 Qwen3.7-Max、GLM-5.2、DeepSeek-V4-Pro、Kimi-K2.6 等十余款文本与图像模型,并兼容 OpenAI 和 Anthropic 两套协议。套餐分标准版 25000 Credits、高级版 100000 Credits、尊享版 250000 Credits 三档,席位分配后才能生成 sk-sp- 前缀的专属 API Key。接入需配套使用对应 Base URL,与 Coding Plan、按量付费体系完全隔离。

    匹配字段摘要

  4. 中华网科技

    招商加盟 GEO:AI 时代加盟品牌获客新逻辑解析

    招商加盟营销正从搜索竞价、信息流广告转向 GEO(生成式引擎优化),目标是让品牌事实在 DeepSeek、豆包、通义千问、文心一言、Kimi、ChatGPT 等生成式问答中被准确提及和合理推荐。文章对比了搜索广告、信息流广告与 GEO 三种模式的业务逻辑,并指出 GEO 竞争的是事实质量与信源可信度,而非广告预算。判断 GEO 服务商是否靠谱,建议准备 20 至 50 个真实招商问题,要求现场演示多模型查询、品牌提及、引用来源与错误信息识别。

    匹配字段摘要、正文

  5. 36氪 · AI

    Anthropic冲刺IPO:营收163亿美元、净亏损807亿美元,现金约202.8亿美元

    36氪Tech商业栏目分析Anthropic的IPO压力:2026年上半年营收约163亿美元、净亏损约807亿美元,其中约720亿美元来自可转换票据等融资工具的公允价值变动,属非现金计提;截至2025年底现金及短期投资约202.8亿美元。文章指出其已披露算力相关承诺合计超6000亿美元,2026年上半年算力及基础设施支出接近90亿美元,并称公司已在2026年6月保密提交S-1、目标11月挂牌。作者认为拥有自有现金牛的谷歌与走极致工程降本路线的DeepSeek更具持久力,而Anthropic与OpenAI处于中间态。

    匹配字段摘要、正文

  6. 钛媒体 · AGI

    这个双11,大模型攻入电商腹地

    钛媒体梳理今年双11大模型直接参与电商的进展:千问办公在双11前夕上线电商版Agent,面向所有电商平台和商家提供跨平台经营看板、卖点分析、素材生成和ROI优化;豆包则专设“双十一问豆包”导航栏,用户可在对话中选品、领券下单并直达抖音商城订单页。文章还提到淘宝内嵌千问AI购物助手、用户用DeepSeek比价和Kimi生成护肤清单等场景,并对比OpenAI在2025年9月上线Instant Checkout后不到半年下线的尝试,指出电商履约能力是模型厂商需要补齐的一环。

    匹配字段摘要、正文

  7. Fortune AI

    专家称新型 AI 模型助推大规模网络攻击,一次入侵成本约 50 美元

    据 Fortune 报道,专家表示能力更强的新模型正推动大规模自主网络攻击增多。9 月 25 日起,一名黑客放出 AI 智能体尝试入侵 1200 多个网站,成功攻破约 100 家公司,包括 Deere、SharkNinja 和 Cummins,所用 DeepSeek 与 Anthropic Claude Code 的 token 成本约 5000 美元,折合每次成功入侵约 50 美元。本月另有两起智能体攻击:OpenCode 遭 48 小时持续攻击,1.4% 用户受影响,部分人损失最高 1700 美元;韩国多家银行被入侵,约 6.8 万人数据被窃,攻击者据称结合了基于开放模型的中国 AI 工具 Artex 与 Claude Code。

    匹配字段摘要、正文

  8. 邵猛

    Flatkey 网关让 Codex/Claude Code 调用多模态模型

    Flatkey 以统一 API 网关形式让 Codex 和 Claude Code 通过 CLI 调用 GPT、Claude、DeepSeek、GLM、Kimi 等文本模型及 GPT Image、Seedance 等图片视频模型,一个 Key 接入 100+ 官方模型和 1,000+ 工具 API,费用合并为一份账单。日常价格比官方定价至少低 20%,10 月 19–23 日活动期间 GPT、GLM 5.2、Kimi K3、DeepSeek 打 6 折,Claude 8 折,Seedance 2.0 85 折。

    匹配字段摘要、正文

星期二

  1. 量子位

    记忆张量开源 MemT 1.0 系列记忆原生模型

    记忆张量开源发布 MemT 1.0 系列记忆原生模型,包含 36B 参数、激活 3B 的 MemT-1.0-Nano(基座 Qwen3.6-35B-A3B)和 288B 参数、激活 17B 的 MemT-1.0-Flash(基座 DeepSeek-V4-Flash),在选定的 Transformer 模块中加入与注意力并行的记忆计算通路。团队构建了 340 亿 Token 记忆训练语料,其中继续预训练 200 亿、后训练 140 亿。在 11 项记忆基准综合评估中,Flash 和 Nano 平均得分分别为 50.6 和 47.0,位列参与评估的参数化记忆方法前两名;在 500 项 SWE-bench Verified 任务中,Nano 三次全部成功的任务比例从无经验基线的 54.00% 提升到 62.80%。

    匹配字段摘要、正文

  2. LMSYS Blog精选

    SGLang-TorchTPU 开源:把 SGLang 服务栈带到 TPU

    SGLang 团队联合 Google 和 Meta 开源 SGLang-TorchTPU,这是一个基于 PyTorch 的原生后端,把 SGLang 的完整服务栈带到 Google Cloud TPU,并已在 Meta 大规模生产环境使用。首发支持 Muse Spark Open、GLM-5.3、Kimi K3、DeepSeek V4、Qwen3.8、Gemma 4 等模型,覆盖投机解码、KV cache 卸载、PD 分离和 FP8 KV cache 等功能。团队还用 TorchTitan 与 Miles 在单台 4 芯片 TPU v7x 上完成 Qwen3-4B 的 GRPO 训练,奖励曲线与 6 张 H200 基线在随机波动范围内一致。

    SGLang-TorchTPU

    匹配字段摘要、正文