←搜索结果

按匹配度 · 共 801 条结果 清除搜索

星期三

  1. Dan Hendrycks

    Claude Opus 4.5 与 Gemini 3 对比

    Claude Opus 4.5 与 Gemini 3 相比如何? - 推理/文本:在控制推理 token 数量的情况下,Gemini 3 ≈ Opus - 多模态:在视觉/图像输入上,Gemini 3 大幅优于 Opus - 安全:能力 ≠ 安全。在越狱、诚实性等方面,Opus 优于 Gemini

    Claude Opus 4.5 与 Gemini 3 相比如何? - 推理/文本:在控制推理 token 数量的情况下,Gemini 3 ≈ Opus - 多模态:在视觉/图像输入上,Gemini 3 大幅优于 Opus - 安全:能力 ≠ 安全。在越狱、诚实性等方面,Opus 优于 Gemini

    匹配字段摘要
星期四

  1. vLLM 官方博客

    vLLM TPU 推出统一后端,以 JAX 路径支持 PyTorch 和 JAX

    vLLM TPU 现由 tpu-inference 驱动,通过统一的 JAX→XLA 降低路径支持 PyTorch 和 JAX,并在无需修改模型代码时将吞吐量提高约 20%。新版默认采用 SPMD,引入支持任意模型规格、量化 dtype 和张量并行的 RPA v3,其在 Trillium(v6e)上的吞吐量较 RPA v2 提高约 10%。当前整体性能已接近 2025 年 2 月首个 TPU 原型的 5x,并支持稠密模型、多模态输入、前缀缓存、分块预填充和结构化解码等能力。

    匹配字段摘要

星期一

  1. Ollama Blog

    Ollama 与 NVIDIA 合作,在 DGX Spark 上开箱即用运行本地模型

    Ollama 与 NVIDIA 合作,确保最新 NVIDIA DGX Spark 开箱即用、快速高效运行。该设备搭载 NVIDIA GB10 Grace Blackwell Superchip,提供 1 petaFLOP 性能,配备 128GB 内存,可运行 Qwen、DeepSeek、Llama、Mistral、Gemma、Gpt-oss 等模型,也支持上传自定义或微调模型。双方正针对聊天、文档处理、代码任务和多模态工作流优化 Ollama 性能。

    Ollama NVIDIA DGX Spark

    匹配字段摘要

星期二

  1. Liquid AI 模型与工程博客

    Liquid AI 发布 LFM2-VL 视觉语言模型,含 450M 与 1.6B 两个版本

    Liquid AI 发布首个视觉语言模型系列 LFM2-VL,包含 LFM2-VL-450M 和 LFM2-VL-1.6B 两个版本,面向低延迟与端侧部署,支持文本和可变分辨率图像输入。模型基于 LFM2 骨干,视觉塔采用 SigLIP2 NaFlex 编码器,原生分辨率最高 512×512,更大图像按 512×512 分块处理,官方称在 GPU 上推理速度最高可达同类模型的 2 倍。模型已兼容 Hugging Face transformers 和 TRL,训练使用约 1000 亿多模态 token。

    匹配字段摘要

星期三

  1. Ollama Blog精选

    Ollama 发布 macOS 和 Windows 桌面应用

    Ollama 的新应用已在 macOS 和 Windows 上线,提供下载模型并直接对话的图形界面。新应用支持拖放文件,可对文本或 PDF 进行推理,处理大文档时可在设置中提高上下文长度,但会占用更多内存。应用还基于新的多模态引擎支持向 Gemma 3 等模型发送图片,并能处理代码文件;纯 CLI 版本仍可在 Ollama 的 GitHub releases 页面单独下载。

    illustration of Ollama seeing the new app

    匹配字段摘要

星期五

  1. Vapi Blog

    如何在 Vapi 上用 Grok 3 构建企业语音智能体

    Vapi 发布教程,介绍如何在 Vapi 平台选择 Grok 3 构建企业语音智能体。Grok 3 是 xAI 的推理模型,具备 100 万 token 上下文窗口、Think 模式与多模态能力,在 AIME 2025 得 60%、GPQA 79.1%、LiveCodeBench 65.5%,MMLU 0.799。定价为每百万 token 输入 $3、输出 $15,快速版 $5/$25,但 API 上下文窗口实际限制为 131,072 token,且不支持原生音频处理。

    匹配字段摘要

星期四

  1. Answer.AI 官方研发博客

    Answer.AI 发布 ReadBench:评测视觉语言模型的文本阅读能力

    Answer.AI 推出 ReadBench,将 MMLU-Redux、MMLU-Pro、GPQA-Diamond、BABILong 和 LongBench 等文本基准的上下文转为图片、问题保留文本,以评测 VLM 从文本图像中读取和推理信息的能力。结果显示几乎所有 VLM 在多模态输入下都出现性能下降,短于 1 页的输入下降较小,长输入下降非常显著,说明多页文档直接送入 Visual RAG 管线尚不可行。数据已发布于 HuggingFace,代码在 GitHub,论文在 arXiv。

    匹配字段摘要

星期三

  1. OpenHands 官方博客精选

    OpenHands 发布 VersaBench 基准与 OpenHands Versa 智能体

    OpenHands 发布 VersaBench 基准和 OpenHands Versa 智能体,前者覆盖 5 大类共 10 项公开基准,后者在 8 项上取得 SOTA,部分提升最高达 30 分。Versa 新增多模态文件读取、多模态网页浏览和信息检索三类工具,已在最新版 OpenHands 中默认启用,OpenHands 0.41 及以上版本可下载使用,相关论文与基准代码均已公开。

    OpenHands Versa Methodology

    匹配字段摘要

星期二

  1. Sarvam AI Blog

    Sarvam AI:为印度构建主权 AI 生态

    Sarvam AI 宣布正为印度构建主权 AI 生态,打造覆盖印度语言与推理任务的基础模型、云端与边缘服务平台,以及对话与推理智能体等应用。其基础多模态模型获 MeitY 的 IndiaAI Mission 支持,将与 IIT Madras 的 AI4Bharat 和 CeRAI 合作开发,并以宽松许可证开源。Sarvam 本周起每周发布开源模型及技术报告,首个发布聚焦印度语言准确性与推理任务的后训练模型。

    Building a sovereign AI ecosystem for India

    匹配字段摘要

星期三

  1. Mistral AI精选

    Mistral AI 发布 Mistral Medium 3,兼顾高性能与更低成本

    Mistral AI 发布 Mistral Medium 3,称其在多项基准测试中达到或超过 Claude Sonnet 3.7 约 90% 的表现,并重点提升编码和多模态理解能力。该模型定价为每百万 Token 输入 $0.4、输出 $2,支持云端、企业本地或 in-VPC 部署,自托管至少需要四块 GPU,并提供定制后训练及企业系统集成能力。

    Table Medium 6

    Mistral AI 发布 Mistral Medium 3,称其在多项基准测试中达到或超过 Claude Sonnet 3.7 约 90% 的表现,并重点提升编码和多模态理解能力。该模型定价为每百万 Token 输入 $0.4、输出 $2,支持云端、企业本地或 in-VPC 部署,自托管至少需要四块 GPU,并提供定制后训练及企业系统集成能力。 · Mistral AI launched Mistral Medium 3, claiming that it achieves at least about 90% of Claude Sonnet 3.7’s performance across benchmarks while emphasizing coding and multimodal understanding. The model costs $0.4 per M input tokens and $2 per M output tokens, supports cloud, on-premises, or in-VPC deployment, requires at l

    匹配字段摘要

星期六

  1. vLLM 官方博客

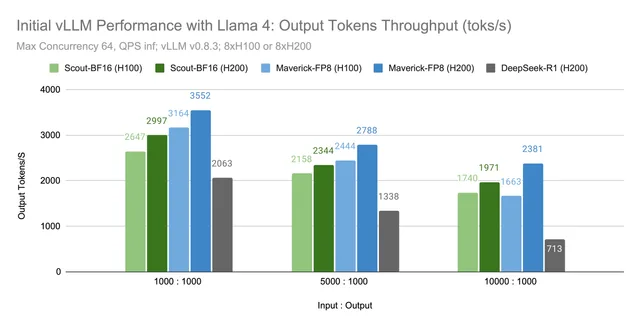
    vLLM v0.8.3 新增对 Llama 4 Scout 和 Maverick 的支持

    vLLM v0.8.3 开始支持 Llama 4 Scout(17B-16E)和 Maverick(17B-128E),可部署长上下文原生多模态推理。在 8xH100 上,Scout 可提供 1M 上下文,Maverick 约为 430K;设置 `--limit-mm-per-prompt image=10` 后,每次请求最多可输入 10 张图像。A100 已支持 bf16 版本,AMD MI300X 可通过源码构建运行,Scout 的单 H100 INT4 量化版本仍在开发中。

    vLLM v0.8.3 开始支持 Llama 4 Scout(17B-16E)和 Maverick(17B-128E),可部署长上下文原生多模态推理。在 8xH100 上,Scout 可提供 1M 上下文,Maverick 约为 430K;设置 --limit-mm-per-prompt image=10 后,每次请求最多可输入 10 张图像。A100 已支持 bf16 版本,AMD MI300X 可通过源码构建运行,Scout 的单 H100 INT4 量化版本仍在开发中。

    匹配字段摘要

星期一

  1. Mistral AI精选

    Mistral AI 发布 Mistral Small 3.1

    Mistral AI 发布 Mistral Small 3.1,提升文本性能和多模态理解,将上下文窗口扩展至 128k tokens,推理速度达每秒 150 tokens。该模型采用 Apache 2.0 许可证,基础版和指令版均已开放,可在单张 RTX 4090 或配备 32GB RAM 的 Mac 上运行。用户现可通过 La Plateforme API 和 Google Cloud Vertex AI 使用,NVIDIA NIM 与 Microsoft Azure AI Foundry 将在未来几周提供。

    Perf Gpqa Diamond Mistral

    Mistral AI 发布 Mistral Small 3.1,提升文本性能和多模态理解,将上下文窗口扩展至 128k tokens,推理速度达每秒 150 tokens。该模型采用 Apache 2.0 许可证,基础版和指令版均已开放,可在单张 RTX 4090 或配备 32GB RAM 的 Mac 上运行。用户现可通过 La Plateforme API 和 Google Cloud Vertex AI 使用,NVIDIA NIM 与 Microsoft Azure AI Foundry 将在未来几周提供。 · Mistral AI released Mistral Small 3.1 with improved text performance and multimodal understanding, a context window of up to 128k tokens, and inference speeds of 150 tokens per second. Licensed under Apache 2.0, it is available in both bas

    匹配字段摘要

星期一

  1. vLLM 官方博客精选

    vLLM V1 Alpha 发布,重构核心架构并将吞吐量提升至多 1.7x

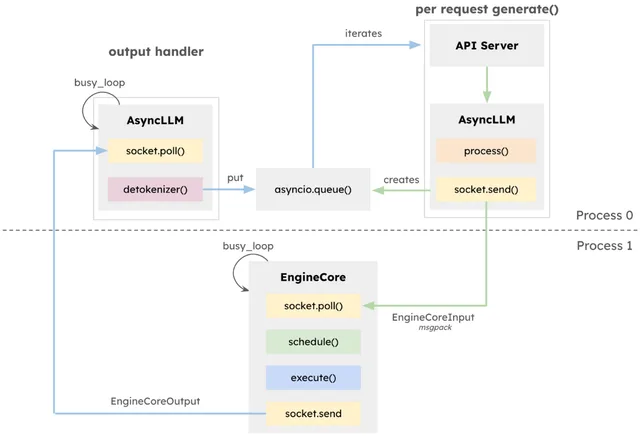
    vLLM 发布 V1 Alpha,通过重构调度器、KV cache 管理器、Worker、采样器和 API 服务器,将吞吐量较 V0 提升至多 1.7x。V1 默认启用低开销前缀缓存,增强多模态模型支持,并可通过设置 `VLLM_USE_V1=1` 在不修改现有 API 的情况下启用。当前版本仅支持 Ampere 或更新的 NVIDIA GPU,尚不支持 LoRA、结构化解码、推测解码和流水线并行等功能。

    vLLM 发布 V1 Alpha,通过重构调度器、KV cache 管理器、Worker、采样器和 API 服务器,将吞吐量较 V0 提升至多 1.7x。V1 默认启用低开销前缀缓存,增强多模态模型支持,并可通过设置 VLLM USE V1=1 在不修改现有 API 的情况下启用。当前版本仅支持 Ampere 或更新的 NVIDIA GPU,尚不支持 LoRA、结构化解码、推测解码和流水线并行等功能。

    匹配字段摘要

星期日

  1. The Gradient

    LLM 在金融市场中的应用

    The Gradient 刊文分析大语言模型能否用于预测价格与交易:Hudson River Trading 在 2023 年 NeurIPS 上估算,3000 只股票、每只每日 10 个数据点、每年 252 个交易日、每日 23400 秒,每年约有 1770 亿个股市 token,与 GPT-3 的 5000 亿训练 token 相差不远。但金融数据噪声远大于信号,且市场近乎有效,预测下一笔收益远比预测下一个词困难。文章认为多模态学习与残差化思路或可把价格、新闻、情绪、卫星图像等非价格信息结合用于预测。

    匹配字段摘要、正文

星期四

  1. Ollama Blog

    Llama 3 上线 Ollama,提供 8B 与 70B 两个版本

    Llama 3 现已可通过 Ollama 运行,首发包含 8B 和 70B 两个参数规模,命令分别为 ollama run llama3:8b 和 ollama run llama3:70b。相比 Llama 2,其训练数据集扩大七倍,上下文长度翻倍至 8K,token 词表扩大到 128K,误拒答情况不到 Llama 2 的三分之一。Meta 计划后续发布 400B 参数版本及支持多模态、多语言和更长上下文窗口的多个模型。

    匹配字段摘要

星期一

  1. 事件2 条新闻 · 1 个事实

    亿信华辰发布睿治OPT多模态数据治理平台

    2026年10月30日,亿信华辰发布全新一代睿治OPT多模态数据治理平台。该平台采用AI原生架构,内置30余个数据治理专家智能体、50余项治理技能与100余个知识库,并将元数据、数据标准、数据质量等治理能力封装为CLI。平台采用四层架构,提供全自动执行、人机协同、人工修订三种工作模式,多模态治理覆盖从采集汇聚到场景化交付六个环节。亿信华辰总经理毛大群在20周年客户大会上提出“AI与数据双螺旋”观点,并发布睿治OPT智能体工作架构,称该架构下原本需团队半年到一年的治理工作可由一人完成。

    匹配字段标题

星期五

  1. 事实所属事件

    亿信华辰发布睿治OPT多模态数据治理平台

    2026年10月30日,亿信华辰发布全新一代睿治OPT多模态数据治理平台。该平台采用AI原生架构,内置30余个数据治理专家智能体、50余项治理技能与100余个知识库,并将元数据、数据标准、数据质量等治理能力封装为CLI。平台采用四层架构,提供全自动执行、人机协同、人工修订三种工作模式,多模态治理覆盖从采集汇聚到场景化交付六个环节。亿信华辰总经理毛大群在20周年客户大会上提出“AI与数据双螺旋”观点,并发布睿治OPT智能体工作架构,称该架构下原本需团队半年到一年的治理工作可由一人完成。

    匹配字段标题

    查看事件:亿信华辰发布睿治OPT多模态数据治理平台

  2. 事件1 条新闻 · 1 个事实

    Rohan Paul称Sunra按厂商原价转售多模态模型调用

    Rohan Paul 于2026年10月29日转述称,Sunra 发布 Sunra API,用户通过一个密钥即可调用各主流图像、视频、音频和 3D 模型,并按各模型厂商自己的 API 价格计费,采用按量付费,没有订阅费,也不加价。Rohan Paul 还称,Seedance 2.5 在 Sunra 上的价格是另外两家网关的一半,这种统一入口也便于对 Google、OpenAI、ByteDance 和 Kling 的模型做 A/B 测试。目前该说法仅见于 Rohan Paul 的转述,尚无 Sunra 官方或其他来源的独立证据。

    匹配字段标题

  3. 事实所属事件

    Rohan Paul称Sunra按厂商原价转售多模态模型调用

    Rohan Paul 于2026年10月29日转述称,Sunra 发布 Sunra API,用户通过一个密钥即可调用各主流图像、视频、音频和 3D 模型,并按各模型厂商自己的 API 价格计费,采用按量付费,没有订阅费,也不加价。Rohan Paul 还称,Seedance 2.5 在 Sunra 上的价格是另外两家网关的一半,这种统一入口也便于对 Google、OpenAI、ByteDance 和 Kling 的模型做 A/B 测试。目前该说法仅见于 Rohan Paul 的转述,尚无 Sunra 官方或其他来源的独立证据。

    匹配字段标题

    查看事件:Rohan Paul称Sunra按厂商原价转售多模态模型调用

  4. 事件1 条新闻 · 1 个事实

    Miles总结美妆企业FDE多模态数据清洗八步方案

    2026年10月28日,Miles总结了一套美妆企业FDE落地项目的多模态数据清洗八步方案。该方案针对从小红书、抖音、视频号、微博采集的文字、图片、音频和视频数据,按定数据规范、保留原始内容、梳理数据关系、多模态归一、冲突和质量清洗、生成结构化数据、执行验收、按规则和版本入库八步处理。原文强调清洗结果不能覆盖原文,OCR、ASR和模型标签只作新增结果;当ASR与OCR数值冲突时回溯原始证据,无法确认则进入待核队列。这套链路也被整理为可复用于消费品洞察、汽车口碑、餐饮选址和品牌舆情等场景的通用方案。

    匹配字段标题