←搜索结果

按匹配度 · 共 3277 条结果 清除搜索

星期一

  1. Together AI Blog精选

    服务 DeepSeek-V4:为何百万 Token 上下文是推理系统问题

    DeepSeek-V4 通过 CSA、HCA 与 SWA 混合注意力在 KV 存储前压缩上下文,支持 1M-token 上下文窗口,但实际效率取决于推理引擎的缓存管理。Together AI 在 NVIDIA HGX B200 上调整 SWA 缓存策略后,将单节点 KV 缓存容量从约 1.2M tokens 提升至 3.7M tokens。长上下文、解码密集型任务最先受益,短上下文任务仍更依赖预填充优化与内核成熟度。
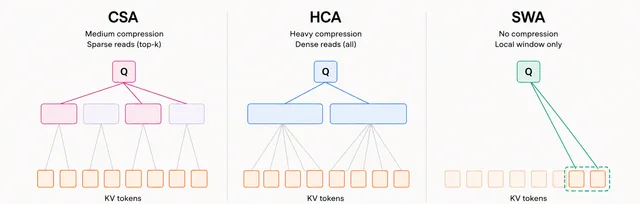
    Three diagrams comparing CSA, HCA, and SWA methods with different compression and KV token reads.

    匹配字段标题、摘要

星期五

  1. Sakana AI:Blog

    Sakana AI 与 NVIDIA 提出 TwELL 稀疏格式,让稀疏 Transformer 推理提速超 20%

    Sakana AI 与 NVIDIA 合作发布 ICML 2026 论文,提出 TwELL(Tile-wise ELLPACK)稀疏打包格式及配套 CUDA kernel,将 99% 高稀疏 token 走快速路径、以稠密备份矩阵兜底重 token,从而适配 GPU 的规则计算。在十亿参数规模上训练与评测稀疏 LLM,推理和训练提速超过 20%,峰值内存与能耗节省更高。

    匹配字段标题、摘要

  2. Berkeley AI Research (BAIR) Blog

    自适应并行推理:高效推理扩展的下一个范式

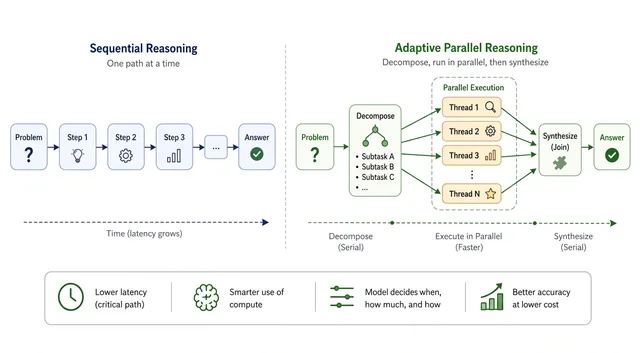
    伯克利 AI 研究(BAIR)博客梳理了并行推理领域的最新进展,重点讨论自适应并行推理(APR)这一范式:让模型在推理时自行决定何时并行、生成多少线程以及如何协调。相比 Tree-of-Thoughts 无需领域启发式分解,相比 BoN 避免冗余计算,相比非自适应方法可选择不并行。文中提到 ThreadWeaver(Lian et al., 2025)与 Pan et al.(2025)提出的 APR 方法。

    Adaptive Parallel Reasoning overview

    匹配字段标题、摘要、正文

  3. Together AI Blog

    如何在 Together DCI 上部署任意 Hugging Face 模型并运行推理

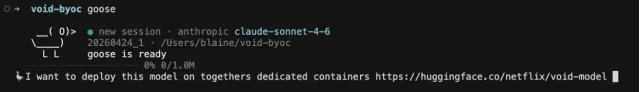
    Together AI 展示了如何用 Goose 和 together-dedicated-containers 技能,在单次会话中将 Netflix 的 void-model 部署至 Dedicated Container Inference。智能体可自动生成推理服务与容器配置;该模型能移除视频中的对象及其引发的阴影、反射和物理交互,推理任务以异步方式返回结果。

    Terminal screen showing void-byoc goose session ready with deployment note and URL to huggingface.co.

    匹配字段标题、摘要

星期三

  1. Zyphra Research

    Zyphra 发布 ZAYA1-8B 推理模型,基于 AMD 全栈训练

    Zyphra 发布 MoE 语言模型 ZAYA1-8B,激活参数不到 10 亿,在数学、编码和推理任务上对标 Nemotron-3-Nano-30B-A3B、Mistral-Small-4-119B 等更大开源模型。该模型在 1024 张 AMD MI300X 集群上完成预训练,采用压缩卷积注意力 CCA 与新型 MLP 专家路由,并配套提出 Markovian RSA 测试时计算方法。模型已在 Zyphra Cloud 提供免费 serverless 端点,权重上线 Hugging Face,采用 Apache 2.0 许可。

    匹配字段标题、摘要

星期一

  1. Together AI Blog

    支撑大规模高效推理的基础研究

    Together AI 介绍其通过算法、系统工程和硬件协同优化大规模推理的方法,旨在提升速度与成本效率,同时维持输出质量和可靠性。生产 AI 系统的推理约占全生命周期成本的 80–90%,尽管 GPT-3.5 水平的推理成本曾下降逾 280 倍,总支出仍随用例扩张而增长。其技术包括可实现 1.5–3x 加速的推测解码,以及 ATLAS 和开源 RL 框架 Aurora 所支持的自适应推测解码。

    匹配字段标题、摘要

  2. Zyphra Research

    Zyphra 推出 AMD 优先的 Zyphra Inference 云推理服务

    Zyphra 发布 Zyphra Cloud 平台的首个组件 Zyphra Inference,这是一项 AMD 优先的推理服务,基于 AMD MI355X GPU 并与 TensorWave 合作,面向长上下文智能体工作负载,托管 Kimi K2.6、DeepSeek V3.2 和 GLM 5.1 等开放模型。以 Kimi K2.6 为例,单台 8x-MI355X 节点提供 2,304GB HBM,可容纳约 184 个 256K 上下文的活跃智能体,而 8x-B200 节点约为 100 个。平台后续将扩展至后训练、强化学习环境和智能体原生基础设施。

    匹配字段标题、摘要

  3. Modal 官方工程博客

    Modal 用一个 Python 字典将 SGLang 多模态推理性能提升超 10%

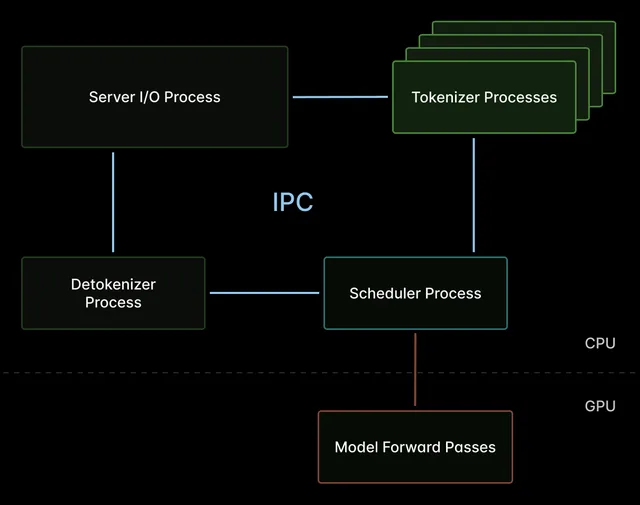
    Modal 在 H100 上对 Qwen2.5-VL-3B-Instruct 做多模态推理基准测试时,发现 SGLang 调度器在 hash_feature 中反复调用 torch.UntypedStorage._new_shared_cuda,造成主机端开销。他们用简单的 Python 字典实现 CUDA IPC Pool Handle Cache,避免重复打开共享内存句柄,使吞吐量提升 16%、延迟降低 10%。该改进已合并进 SGLang v0.5.10。

    Diagram of processes in SGLang, identifying the scheduler process as the key component that might block the GPU.

    匹配字段标题、摘要

星期六

  1. LMSYS Blog精选

    SGLang 与 Miles 为 DeepSeek-V4 提供 Day-0 推理与 RL 训练支持

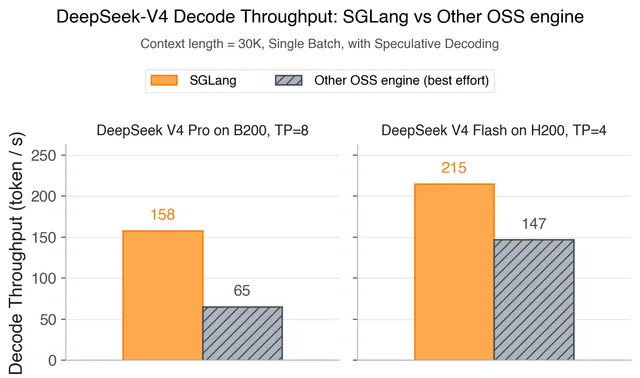
    LMSYS 宣布 SGLang 与 Miles 在 DeepSeek-V4 发布当天提供推理与 RL 训练支持,覆盖 1.6T Pro 和 284B Flash 两个版本。针对 DeepSeek-V4 的混合稀疏注意力、mHC 和 FP4 专家权重,团队引入 ShadowRadix 前缀缓存、HiSparse CPU 扩展 KV、MTP 投机解码等机制,并集成 FlashMLA、FlashInfer TRTLLM-Gen MoE、DeepGEMM Mega MoE 等内核。RL 侧 Miles 支持 DP/TP/SP/EP/PP/CP 六种并行策略与 FP8 训练,已在 32 张 GB300 上完成 285B 模型训练,首步 rollout 与训练 log-prob 偏差约 0.023。

    DeepSeek-V4 decode throughput on Day-0 launch: SGLang vs other OSS engine

    匹配字段标题、摘要

星期五

  1. goose 官方博客精选

    goose 桌面端内置基于 llama.cpp 的本地推理模型

    goose 在桌面应用中内置了由 llama.cpp 驱动的本地推理,选择 Local provider 后可直接从 Hugging Face 下载量化 GGUF 模型并在本机运行,无需 Ollama、Docker 或外部服务器,也无需 API key,可离线使用。官方说明本地模型首次请求需 30–120 秒加载,上下文多为 4K–8K token,工具调用是最大短板,Gemma 4 表现较好而模拟模式仅限 shell 命令;建议从小模型起步并使用 Code Mode。

    blog cover

    匹配字段标题、摘要

星期四

星期三

  1. Modal 官方工程博客

    Physical Intelligence 如何在 Modal 上实现机器人实时远程推理

    Physical Intelligence(Pi)将其 Visual-Language-Action(VLA)模型的实时推理跑在 Modal 上,网络开销仅增加约 10-15ms。为避开 TCP 在连续控制回路中的抖动和队头阻塞,双方基于 UDP 构建了 QUIC 传输门户,借助 STUN 与 UDP 打洞实现自动 NAT 穿透,让机器人一次连接即可持续流式传输观测并接收动作输出。Pi 还能按区域固定推理部署、把检查点存入 Modal Volumes,加载检查点耗时不到 30 秒。

    匹配字段标题、摘要

星期二

  1. Together AI Blog精选

    Aurora:从实时推理轨迹持续学习的开源推测解码框架

    Together AI 发布 Aurora,通过强化学习从实时推理轨迹持续更新推测解码的草稿模型,相比训练良好的静态模型额外加速 1.25x,更新期间不中断服务。在涵盖五个领域的 40,000 条提示词混合流实验中,从零开始在线训练的接受长度达 3.08,高于静态基线的 2.63 和预训练后微调方案的 2.99,吞吐量稳定在 302.3 tokens/s。

    匹配字段标题、摘要

星期六

  1. Redwood Research:Blog

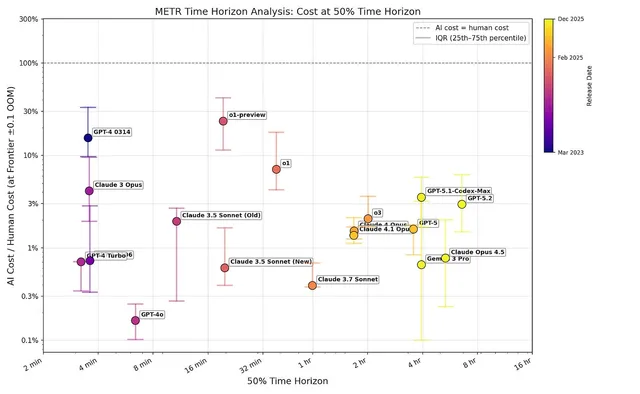
    Redwood Research:AI 能力提升并非源于推理成本下降

    Redwood Research 分析 METR 数据显示,当前前沿模型在其 50% 可靠性时间跨度上完成任务,推理成本约为人类成本的 3%,且该比例未随能力提升而上升。研究还发现,成功完成的任务中,更长任务并未带来更高的成本比;即使将每任务 AI 支出限制在人类成本的 1/32,时间跨度趋势仍约每 3 个月翻倍。作者认为成本并非能力之外的额外瓶颈,自动化时间点可参照 METR 能力趋势线预测。

    匹配字段标题、摘要

星期四

  1. Modal 官方工程博客

    Runway 选择 Modal 为 Runway Characters 提供实时推理算力

    Runway 宣布与 Modal 合作,由 Modal 的无服务器计算平台为 Runway Characters 提供实时推理支持。Runway Characters 是基于通用世界模型 GWM-1 的实时视频智能体 API,可从单张图片生成数字人形象且无需微调,已服务财富 10 强科技公司、好莱坞制片厂等数千家机构。借助 Modal,Runway 团队在 30 天内从概念验证推进到生产环境,并通过一行代码将容器扩展为支持 RDMA 网络的多节点 GPU 集群。

    匹配字段标题、摘要

星期三

  1. Together AI Blog精选

    Together AI 扩展微调服务,支持工具调用、推理和视觉

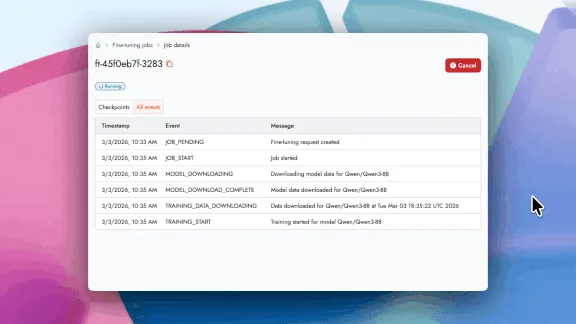
    Together AI 扩展 Together Fine-Tuning,新增工具调用、推理轨迹和视觉语言模型微调支持。升级后的训练栈可更高效处理 100B+ 参数模型,吞吐量最高提升 6×,并支持最大 100GB 的数据集。服务还新增训练前成本估算和训练中 ETA;推理微调支持 Qwen 与 Z.AI,VLM 微调支持 Qwen、Google 和 Meta 模型。

    Screen showing fine-tuning job details with timestamps, events like JOB_PENDING, MODEL_DOWNLOAD, and messages.

    匹配字段标题、摘要

星期二

  1. Together AI Blog精选

    Mamba-3:面向推理效率设计的状态空间模型

    Together AI 等机构推出以推理效率为核心的 Mamba-3,通过更强的递归公式、复数状态跟踪和 MIMO 变体提升性能。1.5B 规模下,Mamba-3 SISO 在所有测试序列长度上的预填充加解码延迟均优于 Mamba-2、Gated DeltaNet 和 Llama-3.2-1B;相关 Triton、TileLang 和 CuTe DSL 内核已开源。

    匹配字段标题、摘要

  2. Mistral AI精选

    Mistral AI 发布 Mistral Small 4,统一推理、多模态与编码能力

    Mistral AI 发布 Mistral Small 4,这是 Mistral Small 系列的下一个主要版本,也是 Mistral 首个把 Magistral 的推理、Pixtral 的多模态和 Devstral 的智能体编码能力统一到单一模型中的版本,采用 Apache 2.0 许可。模型为 MoE 架构,128 个专家、每 token 激活 4 个,总参数 119B、每 token 激活 6B(含嵌入和输出层为 8B),上下文窗口 256k,支持文本与图像输入,并可通过 reasoning_effort 参数在快速响应与深度推理之间切换。官方称相比 Mistral Small 3,端到端完成时间减少 40%,每秒请求数提升 3 倍;推理模式下在三项基准上匹配或超过 GPT-OSS 120B,且输出更短。

    Performance Comparison Across Internal Models

    匹配字段标题、摘要

星期三

  1. LMSYS Blog精选

    SGLang 首日支持 NVIDIA Nemotron 3 Super,面向多智能体系统推理

    SGLang 宣布在发布当天支持 NVIDIA Nemotron 3 Super,并给出安装与推理部署步骤。Nemotron 3 Super 是 120B 参数的混合 MoE 模型,每次前向仅激活 12B 参数,支持 1M token 上下文,官方称其吞吐效率最高可达上一代 Nemotron Super(Llama Nemotron Super 1.5)的 5 倍,并支持 Multi-Token Prediction 与 Thinking Budget。模型权重已在 Hugging Face 提供 BF16、FP8 和 NVFP4 版本,可配合 SGLang 在 4xH200 等配置上部署。

    匹配字段标题、摘要