服务 DeepSeek-V4:为何百万 Token 上下文是推理系统问题
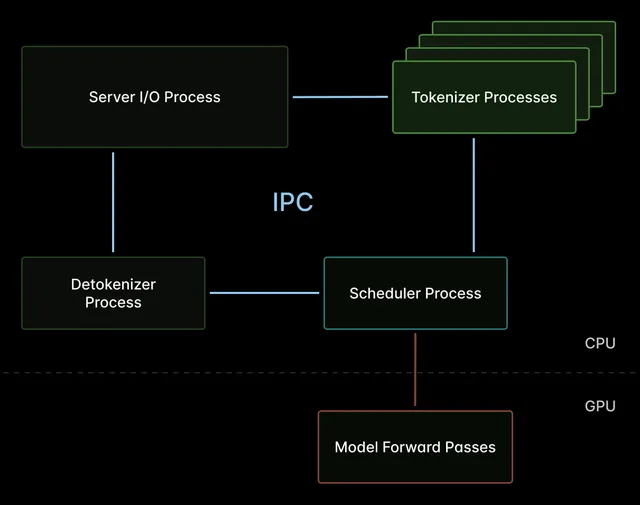
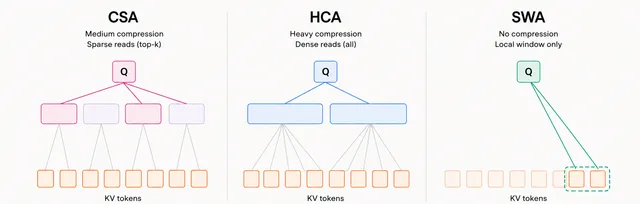
DeepSeek-V4 通过 CSA、HCA 与 SWA 混合注意力在 KV 存储前压缩上下文,支持 1M-token 上下文窗口,但实际效率取决于推理引擎的缓存管理。Together AI 在 NVIDIA HGX B200 上调整 SWA 缓存策略后,将单节点 KV 缓存容量从约 1.2M tokens 提升至 3.7M tokens。长上下文、解码密集型任务最先受益,短上下文任务仍更依赖预填充优化与内核成熟度。
匹配字段标题