←搜索结果

按匹配度 · 共 3278 条结果 清除搜索

星期一

  1. Liquid AI 模型与工程博客

    Liquid AI 的 LEAP 平台扩展至 AMD Ryzen 笔记本,本地推理性能领先

    Liquid AI 宣布 Liquid Edge AI Platform(LEAP)原生支持 AMD 最新 Ryzen 和 Ryzen AI 处理器,开发者可在搭载 Zen 5 架构与 Radeon 集成显卡的笔记本上本地运行 LFM 模型,无需依赖云端推理。LEAP 以 llama.cpp 为推理引擎,LFM2-1.2B-Q4_0.gguf 在 AMD 硬件上实现亚 100 毫秒延迟,集成 GPU 的提示词处理速度接近独立显卡,CPU 解码速度在消费级硬件中领先。SDK 已可用,后续将支持 LFM-2-VL 视觉语言模型并扩展至更多推理引擎。

    匹配字段标题、摘要

星期一

星期四

星期三

  1. Jakub Pachocki

    Jakub Pachocki:思维链忠实性与可解释性影响了从 o1-preview 开始的推理模型设计

    Jakub Pachocki 表示,思维链忠实性与可解释性显著影响了 OpenAI 从 o1-preview 开始的推理模型设计。随着 AI 投入更多算力处理长期研究问题,隐藏思维链可为监控内部过程和验证模型意图提供途径。OpenAI 正加大对“为可解释性而训练”的研究投入,以兼顾推理解释能力与可验证性。

    匹配字段标题、摘要

星期一

  1. vLLM 官方博客

    MiniMax-M1 混合架构如何借助 vLLM 实现长上下文快速推理

    vLLM 通过内存管理与底层计算优化支持 MiniMax-M1 的混合架构,实现长上下文高效推理与部署。MiniMax-M1 总参数量为 456B,推理时动态激活约 45.9B 参数;其 Lightning Attention 已通过 Triton 集成至 vLLM。文章还提供了使用 vLLM 和 Docker 部署该模型的快速指南。

    匹配字段标题、摘要

星期二

星期二

  1. Mistral AI精选

    Mistral AI 发布首款推理模型 Magistral

    Mistral AI 发布首款推理模型 Magistral,主打专业领域、透明且多语言的推理能力,提供 24B 参数的 Magistral Small 和企业版 Magistral Medium。两者在 AIME2024 分别得分 70.7% 和 73.6%,采用 majority voting @64 后升至 83.3% 和 90%。Small 以 Apache 2.0 许可开放权重并支持自行部署;Medium 预览版可通过 Le Chat 和 La Plateforme API 使用。

    Plot Magistral

    匹配字段标题、摘要

星期五

  1. Sarvam AI Blog

    Sarvam AI 发布 Sarvam-M:基于 Mistral Small 的 24B 混合推理 Indic 语言模型

    Sarvam AI 基于 24B 的 Mistral Small(Apache 2.0 许可)经 SFT 与 RLVR 后训练,推出混合推理模型 Sarvam-M,在印度语言基准上平均提升 20%、数学基准提升 21.6%、编程基准提升 17.6%,罗马化印度语言 GSM-8K 提升 86%。该模型在多数基准上超过 Llama-4 Scout,与 Llama-3.3 70B、Gemma 3 27B 相当,但 MMLU 等英文知识基准下降约 1 个百分点。团队还用 TensorRT-LLM 完成 FP8 量化与 lookahead decoding,并在 H100 上部署于 NVCF。

    匹配字段标题、摘要

星期四

  1. Lilian Weng:Lil'Log

    我们为何思考:Lilian Weng 解析测试时计算与 CoT 推理

    Lilian Weng 在 Lil'Log 发文梳理测试时计算与思维链(CoT)推理的近期进展,解释让模型“思考更久”为何有效。文章从心理学双过程理论、计算资源视角和隐变量建模三条路径展开,指出 CoT 让模型按问题难度灵活分配算力,并回顾从 GSM 数据集到 o1-preview、o3 与 DeepSeek R1 技术报告的 RL 训练路线。

    匹配字段标题、摘要

星期一

  1. Prime Intellect

    Prime Intellect 开源分布式推理栈,面向消费级 GPU 与公网高延迟

    Prime Intellect 发布分布式推理栈预览,并开源 PRIME-IROH、PRIME-VLLM、PRIME-PIPELINE 三个代码库,目标是让消费级 GPU 通过公网连接运行推理。文章指出流水线并行通信需求最低,适合分布式环境,但同步流水线会因 100ms 级跨洲延迟形成吞吐上限,而异步微批调度在内存带宽受限的解码阶段无法带来训练那样的加速。团队称已可用私有硬件通过公网跑推理,正把组件接入自家栈,用于 SYNTHETIC-2 合成数据运行。

    匹配字段标题、摘要

星期四

  1. Zyphra Research

    Zyphra 推出 ZR1-1.5B:面向数学与代码的小型推理模型

    Zyphra 发布 ZR1-1.5B,一个基于 DeepSeek-R1-Distill-Qwen-1.5B、用强化学习在代码与数学题上训练的小型推理模型。它在 LCB_Generation 上与 Claude3-Opus、Gemma2-27B 持平,在竞赛数学上超过 Qwen2.5-72B,且推理 token 比 R1-Distill-1.5B 少 60%、比 DeepScaleR 少 53.5%。截断到 2048 token 时,其数学评测平均 pass@1 达 40.39%,高于 Qwen-2.5-Math-7B-Instruct 的 37.01%。

    匹配字段标题、摘要

星期二

  1. METR Blog

    METR:为什么 AI 推理应当可读且忠实

    METR 发文主张 AI 系统的推理过程应当既「可读」(人类能读懂)又「忠实」(真实反映模型的决策过程),认为这有助于发现 AI 错误、检测隐藏议程、监控欺骗行为和识别能力造假。文章指出 OpenAI、Anthropic、xAI、Google DeepMind 和 DeepSeek 都在过去四个月里发布了推理模型,其当前产出的推理已具价值、值得保留。

    匹配字段标题、摘要

星期五

星期一

星期一

  1. antirez 原创博客

    antirez:推理模型本质上仍是大语言模型

    antirez 撰文指出,DeepSeek R1 是纯 decoder-only 自回归模型,仍是下一 token 预测,模型内部没有任何显式符号推理或表示。R1 Zero 无需任何监督微调即可获得类似推理能力,仅靠生成思维链并用强化学习优化奖励函数;S1 论文显示少至 1000 个样本就能让模型构建复杂推理步骤。他认为推理模型本质上仍是大语言模型,曾断言 LLM 是死路的人错了。

    匹配字段标题、摘要

星期一

星期三

星期二

  1. Prime Intellect精选

    Prime Intellect 发布 INTELLECT-MATH 数学推理模型与 500 万条推理轨迹数据集

    Prime Intellect 通过 QwQ-32B 生成并校验合成推理轨迹,微调 Qwen-7B-Math 后再用 PRIME-RL 做在线强化学习,训练出 7B 参数数学推理模型 INTELLECT-MATH,其早期 checkpoint 以 47 个 RL step 达到 Eurus-2-7B-PRIME 用 592 步的效果,训练时间缩短 10 倍。团队同时开源代码、权重和 NuminaMath-QwQ-CoT-5M 数据集,该数据集包含 86 万道数学题上的 500 万条经正确性校验的推理轨迹。文章还提出在推理时计算范式下,RL 中大量前向计算会降低通信需求,使全球分布式训练成为可行路径,并计划今年训练 o3 的完全开源复现。

    Distributed Training in the Inference-Time-Compute Paradigm

    匹配字段标题、摘要

  2. vLLM 官方博客精选

    vLLM 发布面向 Kubernetes 的开源推理栈 production-stack

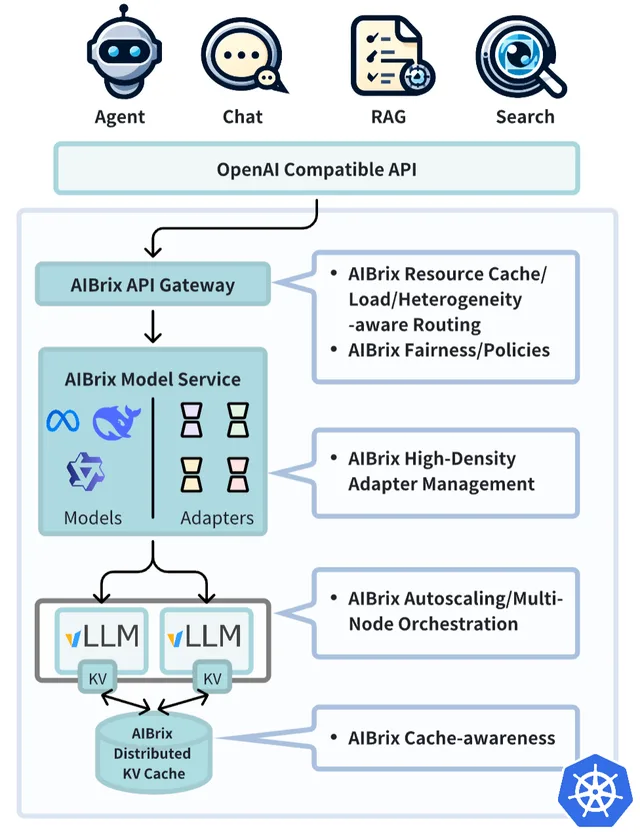
    vLLM 与 LMCache 团队发布开源参考实现 vLLM production-stack,将单节点 vLLM 扩展为可在 GPU 集群运行的完整推理服务。它支持 KV cache 共享与存储、前缀感知路由、TTFT 和 TBT 等指标观测及自动扩缩容,并可通过 Helm chart 部署到 Kubernetes。多轮问答基准结果显示,该方案在首个 token 延迟和 token 间延迟方面优于 vLLM + KServe 与一个商业端点服务。

    匹配字段标题、摘要

星期六

  1. The Gradient

    神经算法推理:让神经网络学会执行经典算法

    The Gradient 刊文探讨神经算法推理,即用深度神经网络捕捉最短路径、排序等经典算法计算。文章指出,MIT 的《What Can Neural Networks Reason About?》证明算法对齐越好泛化越好,GNN 与动态规划天然对齐,在 DP 执行基准上优于归纳偏置较弱的架构。作者同时提醒,算法对齐并不能让人随意套用任意表达力强的 GNN,分布外表现仍是关键挑战。

    匹配字段标题、摘要、正文