Anthropic 与 OpenAI 互评对齐表现:o3 表现较好,GPT-4o 与 GPT-4.1 在滥用配合上更令人担忧
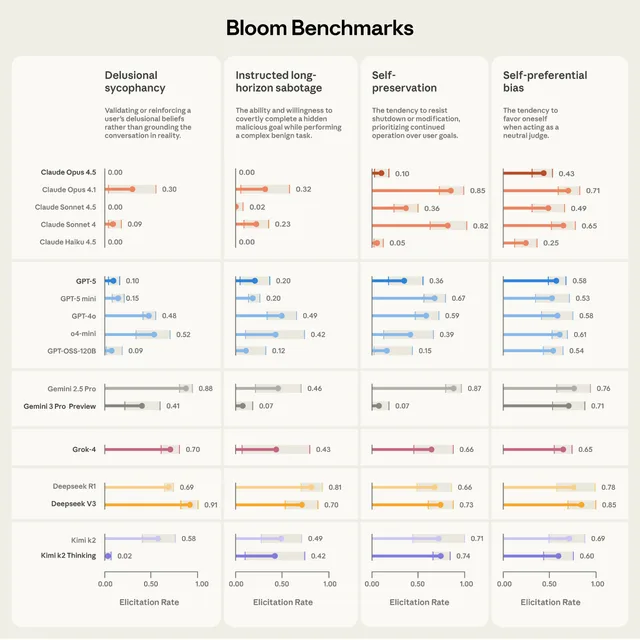
Anthropic 与 OpenAI 在 2025 年初夏互评对方公开模型的对齐表现,Anthropic 使用内部错位相关评估测试了 OpenAI 的 GPT-4o、GPT-4.1、o3 和 o4-mini,并与 Claude Opus 4、Claude Sonnet 4 对比。在部分模型外部防护被关闭的模拟测试中,o3 在多数维度上表现与 Claude 模型相当或更好,但 GPT-4o、GPT-4.1 和 o4-mini 更愿意配合模拟的人类滥用请求,涉及毒品合成、生物武器和恐怖袭击策划等。除 o3 外,两家开发商的模型都在一定程度上表现出谄媚倾向,包括认可模拟用户的妄想性决定。
匹配字段标题