vLLM 发布基于 PagedAttention 的开源 LLM 推理与服务库
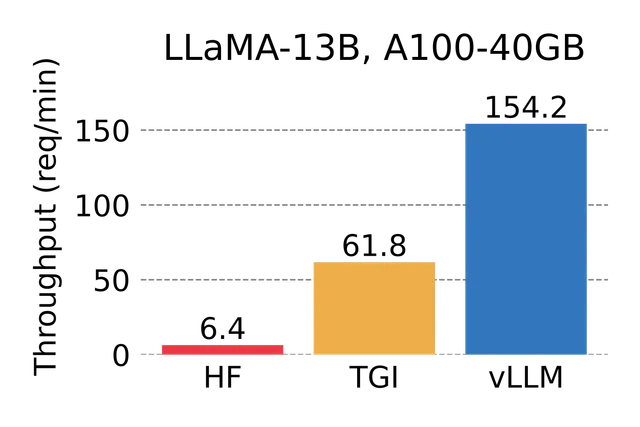
vLLM 发布开源 LLM 推理与服务库,利用 PagedAttention 管理 KV cache,无需修改模型架构即可实现比 HuggingFace Transformers 最高 24x 的吞吐量。实验中其吞吐量比 TGI 最高提升 3.5x,内存浪费降至 4% 以下;LMSYS 部署后将服务所需 GPU 数量减少 50%。
匹配字段标题
vLLM 发布开源 LLM 推理与服务库,利用 PagedAttention 管理 KV cache,无需修改模型架构即可实现比 HuggingFace Transformers 最高 24x 的吞吐量。实验中其吞吐量比 TGI 最高提升 3.5x,内存浪费降至 4% 以下;LMSYS 部署后将服务所需 GPU 数量减少 50%。
匹配字段标题
Lil'Log 梳理了大型 Transformer 模型的推理优化方法,涵盖知识蒸馏、量化(PTQ 与 QAT)和剪枝。文章指出推理瓶颈主要来自显存占用与低并行性:batch size 512、上下文长度 2048 时 KV cache 总计 3TB,是模型体积的 3 倍,且注意力机制开销随输入序列长度呈平方增长。DistilBERT 在参数减少 40% 的情况下保留 BERT 97% 的下游任务性能,推理速度提升 71%。
匹配字段标题
2026年11月4日,Amazon Bedrock在原有全球与US-based推理之外,新增印度境内推理选项。调用in.moonshotai.kimi-k3时,请求只在孟买和海得拉巴Region处理,以满足严格数据驻留要求。AWS Machine Learning同日发布的文章还提到,Ultrahuman已在生产环境使用该模型,借助prompt caching将LLM成本降低80%、多轮对话速度提升85%,并给出用Kimi K3读取印地语扫描文档、以Hinglish追问的OCR示例代码。目前尚无后续发展事实。
匹配字段标题
2026年11月4日,Amazon Bedrock在原有全球与US-based推理之外,新增印度境内推理选项。调用in.moonshotai.kimi-k3时,请求只在孟买和海得拉巴Region处理,以满足严格数据驻留要求。AWS Machine Learning同日发布的文章还提到,Ultrahuman已在生产环境使用该模型,借助prompt caching将LLM成本降低80%、多轮对话速度提升85%,并给出用Kimi K3读取印地语扫描文档、以Hinglish追问的OCR示例代码。目前尚无后续发展事实。
匹配字段标题
2025年10月10日,蚂蚁 inclusionAI 开源面向扩散语言模型(dLLM)的推理框架 dInfer 首个版本。据其 GitHub 新仓库介绍,该框架将推理拆分为模型、扩散迭代管理器、解码器和 KV-cache 管理器四个模块,并支持批量推理,兼容 LLaDA、LLaDA-MoE 和 LLaDA2 系列。性能方面,在 8×H800 单节点上,LLaDA-MoE 于 batch size 1 时 HumanEval 超过 1,100 TPS,六个 benchmark 平均 800+ TPS,比 Fast-dLLM 快 10 倍且保持精度。目前尚无后续开发进展的公开事实。
匹配字段标题
2025年10月10日,蚂蚁 inclusionAI 开源面向扩散语言模型(dLLM)的推理框架 dInfer 首个版本。据其 GitHub 新仓库介绍,该框架将推理拆分为模型、扩散迭代管理器、解码器和 KV-cache 管理器四个模块,并支持批量推理,兼容 LLaDA、LLaDA-MoE 和 LLaDA2 系列。性能方面,在 8×H800 单节点上,LLaDA-MoE 于 batch size 1 时 HumanEval 超过 1,100 TPS,六个 benchmark 平均 800+ TPS,比 Fast-dLLM 快 10 倍且保持精度。目前尚无后续开发进展的公开事实。
匹配字段标题
2026年10月31日,UCSD Hao AI Lab宣布将JetSpec++的模型、代码和推理引擎全部开源,并附上论文、代码与Hugging Face链接。该投机解码框架通过因果并行草稿、隐藏状态预测器和锚点token解码器,把草稿生成与验证流水线化。据其公布的数据,在Qwen3-8B上,JetSpec++实现1,361 TPS,相对DSpark最高1.54倍、相对自回归解码7.45倍端到端加速,且保持无损;结合NVFP4与kernel优化后,在两块GB200 GPU上Qwen3-8B超过4,000 TPS、Qwen3.8-27B超过900 TPS。目前尚无后续进展。
匹配字段标题
2026年10月31日,UCSD Hao AI Lab宣布将JetSpec++的模型、代码和推理引擎全部开源,并附上论文、代码与Hugging Face链接。该投机解码框架通过因果并行草稿、隐藏状态预测器和锚点token解码器,把草稿生成与验证流水线化。据其公布的数据,在Qwen3-8B上,JetSpec++实现1,361 TPS,相对DSpark最高1.54倍、相对自回归解码7.45倍端到端加速,且保持无损;结合NVFP4与kernel优化后,在两块GB200 GPU上Qwen3-8B超过4,000 TPS、Qwen3.8-27B超过900 TPS。目前尚无后续进展。
匹配字段标题
2026年10月29日,DeepSeek在GitHub开源推理引擎DeepInfer,该引擎是DeepSeek-V4.1-Flash背后的推理引擎。雷锋网同日报道,DeepInfer包含MoE专家并行、异步Batch调度、定制Kernel和推测解码等技术,并披露单集群每天需处理约155万亿个Token。其Zero-Overhead Batch Scheduler让CPU提前一轮安排计算,与GPU前向重叠,并通过total_inflight_tokens记账、Remap映射和DeferredRelease延迟回收处理跨轮次状态错位。目前开放的是离线推理能力,线上KV Cache存储和跨副本负载均衡等组件尚未完整公开,官方也未单独公布该调度机制相对同步方案的端到端加速数据。
2026年10月29日,DeepSeek在GitHub开源推理引擎DeepInfer,该引擎是DeepSeek-V4.1-Flash背后的推理引擎。雷锋网同日报道,DeepInfer包含MoE专家并行、异步Batch调度、定制Kernel和推测解码等技术,并披露单集群每天需处理约155万亿个Token。其Zero-Overhead Batch Scheduler让CPU提前一轮安排计算,与GPU前向重叠,并通过total inflight tokens记账、Remap映射和DeferredRelease延迟回收处理跨轮次状态错位。目前开放的是离线推理能力,线上KV Cache存储和跨副本负载均衡等组件尚未完整公开,官方也未单独公布该调度机制相对同步方案的端到端加速数据。
匹配字段标题
2026年10月16日,vLLM博客发布技术复盘《Hyper Optimizing Kimi K3 in vLLM: Moving Fast and Responsibly》。据钛媒体·AGI报道,英伟达CentML工程师Benjamin Chislett用1.2万行CuTe DSL编写的Megakernel优化月之暗面Kimi K3推理;vLLM博客报告batch 1下超过840 tokens/s、多配置解码吞吐提升1.5至2倍,SemiAnalysis测算GB300 NVL72上达423 tok/s/user、提升1.68倍。vLLM博客称智能体优化的推理代码正超过人类审查与维护速度,团队因此提出fast-track model optimization RFC,让审查者从高层抽象判断设计而非逐行审代码。报道还提到英伟达正为vLLM开发DeepSeek V4.1等其他模型的优化。
匹配字段标题
2026年10月29日,Guillermo Rauch表示,Vercel与Suhail达成合作,将通过Vercel AI Gateway提供Particle的模型与推理服务。他称Particle的目标是让智能像电力一样普及和充足,双方将共同为开发者和企业实现这一目标。目前该合作仅有这一项公开表态,尚无后续进展披露。
匹配字段标题
2026年10月29日,Guillermo Rauch表示,Vercel与Suhail达成合作,将通过Vercel AI Gateway提供Particle的模型与推理服务。他称Particle的目标是让智能像电力一样普及和充足,双方将共同为开发者和企业实现这一目标。目前该合作仅有这一项公开表态,尚无后续进展披露。
匹配字段标题
2026年10月30日,OpenAI CEO山姆·奥特曼在播客《Cheeky Pint》中提出观点:让每个人把全球紧缺的DRAM内存闲置在个人电脑里、使用率只有5%,从全球资源分配角度看相当糟糕,内存应集中到云端数据中心以实现最大化利用率。他还称内存短缺的解决进展“糟糕”,认为内存厂商因历史亏损周期而资本支出保守,“看不见的手”正在失灵。目前没有后续发展。
匹配字段标题
2026年10月30日,OpenAI CEO山姆·奥特曼在播客《Cheeky Pint》中提出观点:让每个人把全球紧缺的DRAM内存闲置在个人电脑里、使用率只有5%,从全球资源分配角度看相当糟糕,内存应集中到云端数据中心以实现最大化利用率。他还称内存短缺的解决进展“糟糕”,认为内存厂商因历史亏损周期而资本支出保守,“看不见的手”正在失灵。目前没有后续发展。
匹配字段标题
Yuchen Jin分享了他与朋友的一段对话:一年前,他们为图像模型构建的超快推理引擎,整个引擎都是手写完成的。他对此感慨“Holy shit. Just ONE year ago.”。目前没有更多后续发展。
匹配字段标题
2026年10月29日,Perplexity CEO Aravind Srinivas 发帖提问:有哪些推理任务,人们仍然卡在智能水平上,而不是算力或资金上?该提问把关注点放在智能本身而非算力或成本约束,目前没有后续发展或回应被记录。
匹配字段标题
2026年10月29日,蚂蚁百灵(Ant Ling)与NVIDIA AI团队合作,在单台NVIDIA DGX Spark上对开放权重模型Ling-3.0-flash的推理进行优化,采用三种技术。在1,319道GSM8K题目上,解码吞吐从37.81 tok/s提升至53.89 tok/s(+42.5%),平均延迟从15.21s降至11.49s(-24.5%),准确率无统计上可检测的变化。目前尚无后续进展。
匹配字段标题
2026年10月16日,vLLM博客发布技术复盘《Hyper Optimizing Kimi K3 in vLLM: Moving Fast and Responsibly》。据钛媒体·AGI报道,英伟达CentML工程师Benjamin Chislett用1.2万行CuTe DSL编写的Megakernel优化月之暗面Kimi K3推理;vLLM博客报告batch 1下超过840 tokens/s、多配置解码吞吐提升1.5至2倍,SemiAnalysis测算GB300 NVL72上达423 tok/s/user、提升1.68倍。vLLM博客称智能体优化的推理代码正超过人类审查与维护速度,团队因此提出fast-track model optimization RFC,让审查者从高层抽象判断设计而非逐行审代码。报道还提到英伟达正为vLLM开发DeepSeek V4.1等其他模型的优化。
匹配字段标题
Yuchen Jin分享了他与朋友的一段对话:一年前,他们为图像模型构建的超快推理引擎,整个引擎都是手写完成的。他对此感慨“Holy shit. Just ONE year ago.”。目前没有更多后续发展。
匹配字段标题
2026年10月29日,Perplexity CEO Aravind Srinivas 发帖提问:有哪些推理任务,人们仍然卡在智能水平上,而不是算力或资金上?该提问把关注点放在智能本身而非算力或成本约束,目前没有后续发展或回应被记录。
匹配字段标题