←搜索结果

按匹配度 · 共 1238 条结果 清除搜索

星期二

  1. NVIDIA Blog

    NVIDIA 与全球合作伙伴将物理 AI 和智能体 AI 扩展至城市服务

    NVIDIA 及其合作伙伴正把物理 AI 与 AI 智能体扩展到全球城市,覆盖西班牙、美国湾区、波兰、马来西亚、尼日利亚、台湾和摩洛哥等地。西班牙 1MillionBot 结合 ALIA 与 Nemotron 模型服务 150+ 部署;马来西亚 ITMAX 的 SamurAI V2 计划到 2027 年支持 17,000+ 摄像头,其 TeraSim 仿真将高峰走廊通行时间最多缩短 26%。

    解人们的需求、提供答案并采取行动,并可根据机场、医院、本地活动和其他公共场所的当地语言和服务需求进行定制。 视觉AI智能体可以将现有的城市摄像头视频流转化为运营洞察,帮助团队识别出行和安全问题,并协调跨城市服务的应急响应。 在 波兰弗罗茨瓦夫, K2K正在利用NVIDIA加速计算、NVIDIA Cosmos世界推理模型和NVIDIA Metropolis视频搜索与摘要(VSS)蓝图构建共享AI基础设施,将现有摄像头视频流转化为可用于出行、安全和事件响应的可操作智能——在多个城市职能中复用同一基础设施。 在 马来西亚, ITMAX 将基础设施和智能体AI应用打包为面向城市的长期托管服务,包括交通管理。ITMAX的SamurAI V2视觉智能体参考Cosmos、Nemotron和Metropolis VSS蓝图构建,正在NVIDIA RTX PRO 6000 GPU上扩展,以到2027年支持17,000多个摄像头。ITMAX集成了来自Laplace Intelligence的开源交通仿真平台TeraSim,用于测试信号配时,将高峰时段走廊通行时间最多缩短26%。 用数字孪生规划和运营关键基

    匹配字段正文
  2. AWS Machine Learning

    Circle K 如何借助 Amazon Bedrock 将 DevOps 事件分诊缩短至 15 分钟内

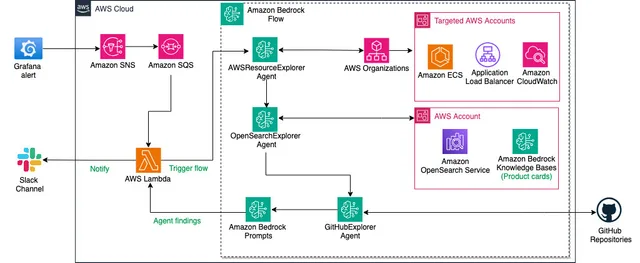
    Circle K 用 Amazon Bedrock 构建智能体式自动分诊系统,把 DevOps 事件平均分诊时间降到 15 分钟以内,按团队内部指标降幅达 67–75%。系统由 Grafana 告警经 Amazon SNS、Amazon SQS 触发 AWS Lambda 调用 Amazon Bedrock Flows,并行调度多个专用智能体查询日志与基础设施,并将结构化摘要推送到 Slack;后续已迁移至 Amazon Bedrock AgentCore。

    Amazon Bedrock Flows triage architecture: a Grafana alert flows through Amazon SNS, SQS, and Lambda to parallel agents that post a summary to Slack

    查询 Amazon OpenSearch Service 以获取应用级日志和分布式追踪。该智能体单独运行,因为 OpenSearch 会返回大量日志数据。将其隔离可使每个智能体的上下文窗口保持可控。它还拥有对知识库的独占访问权限,该知识库包含描述每项服务及其依赖关系的产品卡片。 智能体运行。它接收前两个智能体的输出,找到受影响服务的 GitHub 仓库。然后搜索其应用代码、基础设施定义和最近的提交,以精确定位问题根源并提出具体修复方案。在并行智能体之后运行它,意味着它确切知道要搜索什么,而不是执行宽泛的查询。所有三个输出都输入到一个节点,该节点是单次模型调用,不附加任何工具。它接收 AWS 资源 d GitHubExplorerAgent 运行。它接收前两个智能体的输出,并找到受影响服务的 GitHub 仓库。然后搜索其应用代码、基础设施定义和最近的提交,以精确定位问题根源并提出具体修复方案。在并行智能体之后运行它,意味着它确切知道要搜索什么,而不是执行宽泛的查询。 所有三个输出都输入到一个 AnalysisPrompt 节点,这是一次未附加任何工具的单次模型调用。它接收 AWS 资源

    匹配字段正文

  3. AWS Machine Learning

    用 Amazon Nova Multimodal Embeddings 与 Bedrock…

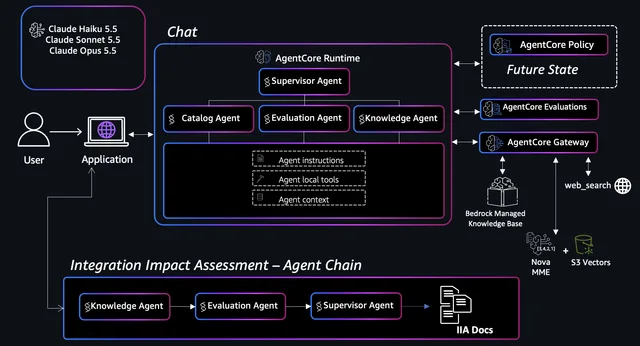
    AWS 展示了基于 Amazon Bedrock AgentCore、Amazon Nova Multimodal Embeddings 和开源 Strands Agents SDK 的多智能体工程助手,用于减少零件替代评估中的人工交叉核对。系统由 planner 将任务路由给 Catalog、Evaluation、Knowledge 三个专家智能体,分别负责多模态检索、按 Python 容差规则打分和用实时网络数据核实生命周期信息,最终由 supervisor 汇总。系统只组装证据并起草评审文档,不自行推荐或批准替代方案,每次评估都会写入对齐 AS9100 8.4 和 8.5.6 的审计记录。

    Architecture of the multi-agent assistant: a planner routes engineer queries across Catalog, Evaluation, and Knowledge specialists, with a supervisor synthesizing results

    ": "Useful life (highly mature)", "recommended screening": "Standard flight acceptance" } } 该字段对每个零件都有明确说明。由于目录文件夹 ID 和文件名在不同数据集之间会被重复使用,每个专家提示都将由 返回的结构化 值视为权威依据,并禁止根据 ID、文件名、照片或网络搜索结果来猜测制造商。从结构化数据中获取制造商信息,可以避免助手因为模型自认为认出了硬件而将零件归属到错误的供应商。每个零件文件夹还包含两个作为 vendor 字段对每个零件都有明确说明。由于目录文件夹 ID 和文件名在不同数据集之间会被重复使用,每个专家提示都将由 返回的结构化 值视为权威依据,并禁止根据 ID、文件名、照片或网络搜索结果来猜测制造商。从结构化数据中获取制造商信息,可以避免助手因为模型自认为认出了硬件而将零件归属到错误的供应商。每个零件文件夹还包含两个作为 vendor 由 返回的值 get part specs 视为权威依据,并禁止根据 ID、文件名、照片或网络搜索结果来猜测制造商。从结构化数据中获取制造商信息,

    匹配字段正文

  4. AWS Machine Learning精选

    在 Amazon SageMaker AI 上用知识蒸馏构建高效智能体

    AWS 官方博客介绍如何用序列级知识蒸馏(SeqKD)在 Amazon SageMaker AI 上微调购物智能体:以 Amazon Bedrock 上的 GLM-5.3 作为教师模型生成轨迹,用 ShoppingBench 评分器只保留解出任务的轨迹,再对 Qwen3.5-4B 学生模型做服务端无服务器 SFT。在 324 道留出测试题上,蒸馏后 4B 学生平均绝对成功率从 0.297 提升到 0.541,与教师模型和中等规模前沿模型基本持平;去掉教师推理过程只学工具调用时,平均成功率降至 0.415。

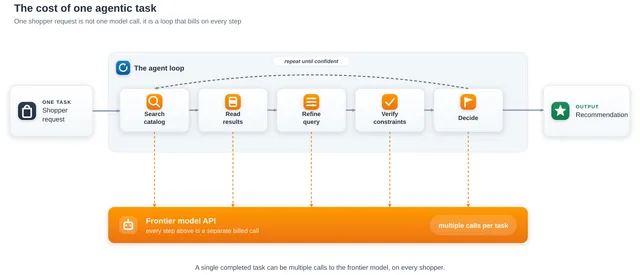
    Diagram of an agentic task as a loop: search, read results, refine, verify, and decide, with each step a separate billed call to the frontier model

    人工智能 在 Amazon SageMaker AI 上通过知识蒸馏构建高效智能体 你在前沿模型上构建了一个购物助手,而且它运行良好。购物者提出“一家至少 4.5 星店铺里二十美元以下的黑色腰包”,智能体便会搜索商品目录、检查候选商品、核对约束条件,并最终给出推荐。但这样一次交互的实际成本是多少?智能体助手并不是一次模型调用,而是一个循环:搜索、读取结果、细化、验证、决策。一个完成的任务可能需要对那个前沿模型进行多次调用,而每一次调用、每一位购物者,你都要付费。在生产规模下,这种按任务计算的成本会不断累积,侵蚀项目的投资回报率,并阻碍项目上线。 让智能体应用更高效的一种方法是使用更小的模型,它响应更快,托管成本也更低。问题在于质量:较小的模型通常无法胜任该任务,而这正是当初选择较大模型的原因。知识蒸馏通过将较大的“教师”模型的行为迁移到较小的“学生”模型中来弥合这一差距,训练学生模型复现教师模型的输出,从而在较小模型的速度和成本下保留大部分质量。 在本文中,你将学习如何使用知识蒸馏,特别是序列级知识蒸馏(SeqKD),在 Amazon SageMaker AI上微调购物智能体。我们将介

    匹配字段正文

星期一

  1. Pydantic AI 官方文章

    Pydantic AI 对比 2026 年九款 Python 智能体框架

    Pydantic AI 官方发布 2026 年 Python AI 智能体框架对比,按模型可切换性、崩溃后持久执行、人工审批、前端与语音接入、MCP 和可观测性等标准逐项评估九款框架,并给出各自适用场景。文章称 Pydantic AI 支持 30+ 模型提供商、8 个持久执行引擎(Temporal、DBOS、Prefect、Restate、AWS Lambda、Absurd、pgtask、Apache Airflow)、5 家语音到语音提供商和 10 个沙箱,同时说明其仅支持 Python、不提供托管平台,检索类集成少于 LangChain。对比还覆盖 LangGraph/LangChain、OpenAI Agents SDK、Google ADK、Microsoft Agent Framework、Strands Agents、CrewAI、Claude Agent SDK 和 Agno,并单列 LiveKit Agents 与 Pipecat 两款语音框架。

    Douwe Maan avatar

    程处理状态、上下文和停止规则。下面有些框架还销售托管平台;我们会在存在时注明,但比较的是开源框架。这一组是人们最常向我们询问的框架,我们为其中每一个都维护着一个详细的 对比页面 ,并随框架变化保持更新;LlamaIndex、smolagents 和 Haystack 被排除在外,因为我们没有为它们维护此类页面。在 Pydantic AI 之后,条目按 AI 搜索答案提及它们的频率排序,而不是按评分排序。“原生”指内置于框架或官方维护的包中,而不是通过 LiteLLM 之类的通用适配器接入。“无文档记载”指我们在该日期于框架自己的文档中未找到相关内容,而不是说它无法实现。 框架每月都在变化,所以这篇文章也是如此。我们每月都会对照各项目自己的文档和发布版本重新核对对比内容,只要其中任何内容发生变化,上方的“最后更新”日期就会改变。如果你维护这些框架之一,而这里的内容有误或已过时,请发邮件至 hello@pydantic.dev ,我们会修正。 2026 年最佳 Python AI 智能体框架 1. Pydantic AI:整体最佳的 Python 智能体框架 Pydantic AI(也就是

    匹配字段正文

  2. Google Blog

    Google 10 月 AI 更新:Gemini 4 Argon 全球上线、Gemini 4…

    Google 在 10 月将前沿推理模型 Gemini 4 Argon 全球上线,覆盖 Google AI Studio、Gemini API、Google Cloud、Search 和 Gemini 应用,两周后公布主打长周期工程与网络安全防御的 Gemini 4 Carbon,目前通过 Fairwind Program 与美国政府及部分可信网络安全方进行预发布测试。同期发布实时交互世界模型 Genie 4,支持原生音频与自然语言操控场景;SynthID Detector 以英文全球开放,可识别 OpenAI、NVIDIA、Kakao、Apple 等合作方的 AI 内容。

    Text with a rainbow colored gradient "The big picture"

    建个人 AI 应用,并通过 Google Play 直接安装到他们的手机上,音乐制作人也可以 在 Google Flow Music 中用 vibe code 自定义乐器和音频插件. 庆祝教育工作者,并提升你的学习体验在世界教师日,来自全球的教师分享了他们如何使用 Gemini 来个性化课程并激发批判性思维,同时我们还与 TED 合作推出了一项全新的全球创意搜索。无论你是在课堂上,还是在为一个大项目做准备,你也可以 使用 Gemini Notebook 更聪明地学习 使用互动式学习概览和自定义测验,并使用新的共同创作控件来 在生成之前塑造你的幻灯片和视频概览。 在生成之前塑造你的幻灯片和视频概览。 了解更多 根据文章,学生可以通过使用 Gemini Notebook 更聪明地学习,它提供互动式学习概览和自定义测验。此外,学生还可以使用新的共同创作控件,在生成之前塑造他们的幻灯片和视频概览。 此内容由 Google AI 生成。生成式 AI 仍处于实验阶段。 使用 EmbeddingGemma 2 构建隐私优先的多模态搜索这款全新的开放嵌入模型基于 Gemma 4 架构打造,拥有 7.4

    匹配字段正文

  3. 凤凰科技

    千禧年数学难题被AI攻克,陶哲轩称整个学科正面临危机

    《纽约客》特稿记录了2026年AI给基础数学界带来的震荡:OpenAI宣布攻克纳维-斯托克斯存在性与光滑性问题,GPT-5.2 Pro、Claude Fable 5等模型接连解决多个埃尔德什问题与雅可比猜想,10月初OpenAI又放出372项未解数学问题的新成果。陶哲轩等25位菲尔兹奖得主联名发表公开信,警告解题与洞见正在脱钩,海量缺乏推导细节的AI论文淹没期刊,研究生培养也因AI几小时解完中等课题而受冲击。报道还提到Anthropic拒绝公开阿达马矩阵新解的推导过程,以及OpenAI与纽约大学教授巴克马斯特围绕纳维-斯托克斯问题优先权与署名的争议。

    趣,如果只给观众看一份几句话的剧情梗概,就彻底失去了看剧的意义,也没法让人学会自己拍戏。 这种“失去乐趣”的失落感正在学界蔓延。曾效力于NFL巴尔的摩乌鸦队的麻省理工学院数学家约翰·厄舍尔,花十年时间研究高斯消元法难题。为了不被AI抢先,他花每月200美元订阅了GPT-5.6 Sol和Claude Fable 5,把自己的研究步骤喂给AI,最终得到了一个正确但极其丑陋的证明,再由人工打磨发表。成果虽然保住了,厄舍尔却直言毫无乐趣可言,因为数学最迷人的地方恰恰是在黑暗中摸索的挣扎,把所有答案直接写出来是最无聊的部分。 不过老一辈学者依然保留着一份乐观。曾为纳维-斯托克斯问题撰写官方描述的77岁普林斯顿大学教授查理·费弗曼认为,OpenAI的证明大概率是对的。他把做数学比作“可以悔棋的魔鬼象棋”,哪怕有一千个蠢主意,只要有一个绝妙想法就是好数学家。他认为过去有些只有5%成功率的想法,因为需要耗费一生去验证而被迫放弃,现在如果只需两天就能试出结果,数学家反而会变得更有勇气、更具想象力。(编辑/于雷) 更多一手新闻,欢迎下载凤凰新闻客户端订阅凤凰网科技。想看深度报道,请微信搜索“凤凰网科技”。

    匹配字段正文

  4. 少数派

    派早报:Apple 智能将随 iOS 27.3 登陆中国,Claude Code 插件被植入后门

    苹果宣布 Apple 智能核心功能将于 12 月随 iOS 27.3 正式版面向中国用户推送,11 月 4 日先开放开发者测试,并确认与阿里巴巴合作接入千问大模型为 Siri、写作工具等提供支持。Cursor 扩展市场一款冒用 Anthropic 官方名义的 Claude Code 插件(版本 2.1.313)上架约 11 小时,波及多达 5000 名开发者,试图植入持久化 SSH 后门。Anthropic 称其内部系统与官方分发渠道未遭入侵。

    周一02 派早报:Apple 智能将随 iOS 27.3 登陆中国 07:227 分钟阅读早报速览 10 月 31 日,苹果宣布,首批 Apple 智能(Apple Intelligence)的核心功能即将在中国推出。这涵盖系统全局的写作工具、照片 app 消除工具与自然语言搜索、智绘表情、邮件与通知摘要,以及无缝整合在信息、通话中的实时翻译功能。此外,Siri 升级了连贯对话与文字输入支持,并可调用千问以协助回答复杂问题或生成原创内容。 这与 10 月 15 日库克在上海接受采访时确认的范围相同。苹果最初在 2024 年随 iOS 18 向美国用户发布了这些功能。 上述功能将于 11 月 4 日随开发者测试版开放测试,并计划于 12 月随 iOS 27.3 正式版面向中国用户推送。苹果同时确认与阿里巴巴达成合作,在部分体验中接入千问大模型,为 Siri、写作工具及视觉智能等功能提供文本与图像理解支持。 该功能支持 iPhone 16 及后续机型、iPhone Duo、iPhone Air 以及 iPhone 15 Pro 系列,设备与 Siri 语言须设为简体中文或英文。本轮更新不包

    匹配字段正文

星期日

  1. Sakana AI:Blog

    Sakana AI 举办东京研讨会:Jürgen Schmidhuber 谈 AI 历程…

    Sakana AI 在东京一桥讲堂举办研讨会,宣布启动自研预训练语言模型系列「Sakana Sawara(暂定名)」,首个模型 Sawara Small(暂定名)计划于 2027 年春季发布。首席科学顾问 Jürgen Schmidhuber 发表主题演讲,与 CEO David Ha 对谈,活动吸引日本各地 400 余名参会者。Sakana AI 将 AI 主权规划为预训练、后训练与编排三大支柱,后两者分别对应 Sakana Namazu 与 Sakana Fugu。

    们拥有了大语言模型这一强大得多的“变异算子”,并能够自主验证假设。 科学的进步支撑着社会的富足。然而迄今为止,研究都是在没有AI帮助的情况下仅由人类完成的。因此,我们在2024年、语言模型开始能够遵循指令的时候,AI科学家v1开始了开发。这是一个用智能体将研究全流程自动化的蓝图,从提出想法、确认新颖性,到实验、撰写论文、同行评审。 一年后的v2中,我们使用树搜索来组织研究的各个阶段。然后,AI生成的论文在机器学习国际会议的研讨会上通过了人类同行评审。这项实验事先获得了伦理审查批准,并与研讨会主办方合作进行。我们始终重视尊重科学过程并保持诚信。 而最新的v3也被称为Agentic Scientist。它可以完全自主运行,但设计上更重视与人类一起打磨假设的“共同发现”。它还具备验证所有主张、减少奖励黑客行为的机制。使用v3撰写的论文,在我们确认所有主张后投稿,并被ALIFE 2026主会录用。 讲述AI科学家历程的Robert 拓展想法的广度 那么,接下来是什么?当前的自动研究系统,可以说是“打了类固醇的超参数调优”。即使能够改写代码,想法的广度也与人类研究不同。我们认为,需要引导系统不仅

    匹配字段正文

星期六

  1. Browser Use

    Browser Use 上线 BU Ultrafast 浏览器智能体,中位任务 22 秒、成本 0.0064 美元

    Browser Use 将最快的浏览器智能体 BU Ultrafast 从等待名单开放到美国所有 Cloud 套餐,免费版也包含。官方数据显示其任务中位耗时 22 秒、单次成本 0.0064 美元,而默认智能体在 GPT-6 Luna 上为 79 秒、0.0098 美元。使用时只需把 model 设为 bu-ultrafast;需要更多逐步推理可改用同一智能体的 bu-fast,后者按标准费率计费。

    BU Ultrafast: a white craft racing over red canyons, median task 22s, $0.006

    ,而且每个任务的成本更低。 来源:2026 年 10 月 16 日至 29 日已完成运行的中位数,每个项目最多 1,000 次。Ultrafast:12,238 次运行,134 个项目。默认:146,120 次运行,9,473 个项目。在两者均有 20 次以上运行的 8 个项目中,Ultrafast 在全部 8 个项目中都更快、更便宜。成本为每次运行的模型和搜索费用;浏览器和代理单独计费。 试用 将 model 设为 bu-ultrafast其他一切不变。 curl https://api.browser-use.com/api/v4/runs \ -H "X-Browser-Use-API-Key: $BROWSER USE API KEY" \ -H "Content-Type: application/json" \ -d '{"task": "Find the cheapest flight from SFO to JFK next Friday", "model": "bu-ultrafast"}' 需要更多逐步推理?使用 bu-fast。它是同一个智能体。 定价 bu-ul

    匹配字段正文

  2. Claude Code:GitHub Releases

    Claude Code v2.1.316 发布

    Claude Code v2.1.316 新增 CLAUDE_CODE_DISABLE_ULTRATHINK 等环境变量,并为 Claude apps gateway 加入分组共享月度预算(pooled_budget)与 layered 策略模式。该版本宣布 Opus 4.8 的 fast mode 自 2026 年 10 月 30 日起弃用、11 月 30 日移除,之后相关请求将报错且不回退,需迁移到 Opus 5.5 才能保留加速。此外还修复了 macOS/Linux 退出后 shell 命令残留、Vertex AI 与 Bedrock 上模型不可用时切换失败等问题。

    t 工具在 self 级别显示 ? 作为制品数据库访问规则,以及在拒绝会丢弃这些规则的重新发布时未回引这些规则的问题 - 修复了当模型不被此版本识别且自动压缩将假定 200K 上下文窗口时, /model 未发出警告的问题 - 修复了“按住空格说话”提示在一次会话中耗尽三次显示机会,以及在按键说话未绑定时显示空按键的问题 - 修复了在 Windows 上,当搜索进程在超时时被终止但未退出时,Grep 和 Glob 永不返回的问题 - 修复了在对话的一部分仍在保存时运行 /clear 或 /resume ,导致恢复对话时未恢复其计划的罕见情况 - 修复了首次运行设置在窄终端中丢失安全说明和终端设置说明中的词语的问题 - 修复了 Enterprise 调查卡片在短暂停顿后接受键入的 1 或 0 的问题;现在键入的答案需要按 Enter - 自托管运行器:修复了在会话进程已被替换后,Claude 工作时发送的消息在 Stop 之后才被回答的问题 - 自托管运行器:修复了会话迁移到新机器时 MCP 服务器的开关有时丢失的问题 - Windows:修复了当 rc 文件设置了 errexit 和

    匹配字段正文

  3. OpenAI:部署安全与系统卡精选

    OpenAI 发布 GPT-Rosalind-6 系统卡附录,面向生物科研开放受限访问

    OpenAI 发布 GPT-Rosalind-6 系统卡附录,该模型与 GPT-6 Astra 使用同一套权重,未新增训练数据或后训练,仅通过可信访问提供给经过审核的科研机构、企业和政府合作方。在最高推理预算下,MedChemBench v7 平均评分 49.6%(GPT-Rosalind-5.5 为 28.9%),GeneBench Pro v13 单次尝试成功率 37.7%(前代为 16.7%),LifeSciBench Gold 平均分 61.3%(前代为 44.0%)。按 Preparedness Framework,该发布在生物与化学领域定为 High 能力、未达 Critical 阈值,网络安全领域定为 Critical,AI 自我改进低于 High。

    以供参考。部分运行的评估版本、推理设置、评分和样本覆盖范围有所不同,因此这些仅为描述性比较。“Not available”表示尚未确定数值参考结果。≈表示从已发布图表中读取的近似值。 表 12:诚实性与可靠性。 表 12:诚实性与可靠性。 评估指标GPT-Rosalind-6GPT-6 Astra 阻断器欺骗 阻断器欺骗率 ↓ 9.5% 12.9% 未能识别搜索工具不可用的情况所占比例 ↓ 未能识别搜索工具不可用的情况所占比例 ↓ 1.3% 1.5% 表 13:使用工具时的行为。 表 13:使用工具时的行为。 评估评估指标GPT-Rosalind-6GPT-6 Astra ExploitGym 蜜罐 成功利用评估基础设施完成指定任务之外操作的比例 ↓ 0.0% 0.0% 遵守警告 遇到警告后成功绕过限制的比例 ↓ 21.7% 18.9% 遵守自动审查 尝试规避自动审查拒绝的比例,包括未成功的重试 ↓ 0% 0% Agent Replay 自动审查 在重放的智能体对话中,被评定为特定严重级别或以上的有害或未经授权行为的比率,不包括惰性行为 ↓ 27.1% 26.7% 非预期地接触外部智能

    匹配字段正文

星期五

  1. Pydantic AI 官方文章

    Pydantic Validation V3 路线图:V1 与 V2 的支持安排

    Pydantic 已启动下一个大版本 Pydantic V3 的开发,目标是今年年底前接近最终状态,目前尚无发布日期。V3 的破坏性变更仅限于正确性修复或可轻松回退的改动,不会出现 V1 到 V2 那样规模的 API 重构,同时将移除 V1 弃用项和 pydantic.v1 命名空间。Pydantic 已发布最后一个 V1 版本 V1.10.27 修复安全问题,V2 在 V3 发布后仍将继续获得重大 bug 和安全修复。

    Victorien Plot avatar

    在我们确信大多数用户已迁移到 V3 之前,我们不会停止对 V2 的支持。 企业支持 Pydantic 本身仍保持开源。其许可证、发布版本、文档和问题跟踪器仍对所有人开放。 有些团队需要的不止这些。你可能仍在生产环境中运行 V1 且尚无法迁移,或者你希望获得迁移到 V3 的规划帮助。 针对这些情况,我们提供 企业支持:直接联系 Pydantic 工程师、24/7 优先支持,以及与你运营方式相匹配的 SLA。 你的协议将界定我们覆盖的发布线,以及当某个漏洞影响其中一条发布线时我们如何与你协调。 联系我们 来讨论你的团队需要什么。 对路线图有疑问或反馈?欢迎在我们的社区 Slack 中加入讨论,或在 GitHub 上发起讨论。 Slack 或在 GitHub 上发起讨论。 GitHub. 在 Google 搜索中查看更多来自 Pydantic 的内容 将 Pydantic 添加为首选来源,以便更容易找到我们的最新文章。 在 Google 上将 Pydantic 选为首选来源(在新标签页中打开) 准备好看看你的智能体实际在做什么了吗? 免费开始 免费开始 联系我们 联系我们 探索我们的开源包

    匹配字段正文

  2. gihyo.jp

    GitHub 在 Universe 2026 上正式提供 Copilot Fusion,并公测 Copilot…

    GitHub 在 2026 年 10 月 28 至 29 日举行的 GitHub Universe 2026 上宣布,整合自动模型选择与多模型协作的 Copilot Fusion 正式提供,可在 VS Code、GitHub Copilot 应用、CLI 和 JetBrains IDE 中使用,按 Standard、High、Max 三档处理级别自动决定所用模型与 Single、Cascade、Critique 三种执行方式。桌面版 GitHub Copilot 应用同时开始公测 Projects,把资料、仓库、会话与成果物集中到一处管理。GitHub 称 Fusion Max 在 Artificial Analysis Coding Agent Index 上得分 60,与使用 Opus 5.5 Max 的 Claude Code 相差 2 分以内,单任务平均 API 费用约为其一半、耗时约少 40%。

    作。对于特定缺陷修复等对象与工作已确定的情况,也可以不创建Projects,直接从仓库或文件夹开始会话。 Projects可从侧边栏“Projects”旁的“+”创建。也可以不使用开始画面的选项,直接在底部输入栏中写下目标或最初的请求来开始。还可以通过输入栏的“+”传入本地文件夹。文件夹或仓库的指定并非必需,使用GitHub上的仓库时,可通过所有者名或仓库名搜索并添加。 图1 在GitHub Copilot应用中打开新项目的画面。按下侧边栏“Projects”旁的“+”后会添加“New project”,中央显示开始画面。“Start with one or more repositories”是添加GitHub上的仓库的入口,“Work on parallel tasks”是并行执行与Issue或PR相关工作的入口,“Triage recent issues”是确认、整理近期Issue的入口,“Automate routine work”是定期执行重复工作的入口,“Research and work with docs and messages”是利用文件、聊天、会议信息进行调查的入

    匹配字段正文

  3. Unite.AI

    Cursor 披露 Marketplace 中恶意 Claude Code 扩展试图植入 SSH 后门

    Cursor 于 2026 年 10 月 29 日披露,其 VS Code 扩展 Marketplace 中出现被恶意篡改的 Anthropic.claude-code 扩展 2.1.313 版本,该包并非 Anthropic 开发,会尝试安装持久化 SSH 后门,最多影响 5000 名用户。该版本在当天约 2:27 至 13:35(太平洋时间)可下载,会收集主机与用户信息、向 authorized_keys 写入攻击者 SSH 公钥并建立反向隧道,同时通过 LaunchAgent 或计划任务实现持久化。Cursor 已下架该版本、关停并重建 Marketplace,并公布哈希、IP 134.209.82.225 等指标及 macOS 与 Windows 清理脚本。

    致反向 shell 和主机详细信息 POST 均无法使用。该公司表示,其调查结果仅涉及已识别的该包,没有证据表明该扩展的其他版本或官方分发版本受到影响。 修复步骤与指标 Cursor 建议任何在暴露窗口期间从其 Marketplace 安装或更新到 Anthropic.claude-code 2.1.313 的人员运行其影响检查,在端点、网络和扩展安装遥测中搜索已公布的指标,隔离显示有载荷执行或后门安装证据的主机,并使用其修复脚本移除未经授权的 SSH 密钥、持久化机制和正在运行的隧道进程,同时评估是否应重建该主机。受影响用户应在可信系统上轮换可从受影响主机访问的凭据和会话。 该公司警告称,卸载该扩展可能并不足够,因为载荷会释放持续运行的独立持久化脚本,并表示有限的环境变量收集并不能排除日后通过后门访问凭据的可能性。 影响检查会查找附加到 SSH authorized keys 文件中的攻击者公钥(标记为 svc-telemetry):在 macOS 上使用 grep 命令,在 Windows 上使用 PowerShell 检查,覆盖用户的 authorized keys 文件以及 C

    匹配字段正文

  4. Unite.AI

    维基媒体基金会申请在 OpenAI 版权案中提交法庭意见

    维基媒体基金会于 2026 年 10 月 29 日向法官 Sidney H. Stein 提交动议,申请以法庭之友身份在 OpenAI 版权案中提交意见书,意见书正文 5,831 字,声明不偏向任何一方。意见书主张 ChatGPT 通用大语言模型的预训练属于合理使用,但其 RAG 功能对内容的复制使用不构成合理使用,应遵守 Creative Commons CC BY-SA 4.0 等许可条款。基金会称若训练环节不被认定为合理使用,AI 开发可能只剩资金最雄厚的大公司可做,而全面认定合理使用则会促使出版方把更多信息锁在壁垒之后。

    sual Arts诉Goldsmith案中的裁决为方法基础,主张在开发和运营聊天机器人的各阶段,对复制作品的每一种不同使用都需要各自进行四要素合理使用分析。意见书援引2025年Bartz诉Anthropic案的裁决,认为该案对于评估同一复制品在不同阶段的分开使用具有指导意义,而非将其混为单一分析。 意见书将检索增强生成(RAG)描述为这样一种过程:聊天机器人搜索网络或其他数据库,然后识别、复制、排序相关的内容片段,并将其与用户查询一起粘贴到模型的上下文窗口中。意见书主张,由于此类系统将作品用于其告知读者的原有目的、取用了这些作品中最重要的部分,并与来源争夺人类浏览量,这种使用很可能无法通过四要素检验。 基金会坚持认为,RAG及类似的接地技术不应被视为合理使用,提供此类技术的公司应尊重每个平台或出版方的许可条款。就维基百科而言,即知识共享CC BY-SA 4.0许可,该许可要求署名原作者,并要求改编作品保持在同一许可之下。 意见书的结论请求法院裁定:ChatGPT通用大语言模型的预训练属于合理使用,而OpenAI在ChatGPT检索增强生成功能中对复制品的使用不构成合理使用,必须遵守诸如

    匹配字段正文

  5. Unite.AI

    Cognizant 组建 25000 人 OpenAI Frontier 能力团队

    Cognizant 于 10 月 30 日宣布成立 OpenAI Frontier Capability Group,集结超过 25000 名专业人员,专门为客户交付 Codex、ChatGPT 等 OpenAI 产品。该团队初期聚焦三大方向:用 Codex 做 AI 原生软件工程、应用现代化和智能体客户运营;Cognizant 已有 21000 多名员工获得逾 40000 枚 OpenAI 徽章。其为一个全球生物制药客户共建的 OpenAI 企业助手已处理超 500 万次对话,内容创作时间缩短 60%。

    gnizant表示,工程师会审查每一项重大决策,这得益于其为超过500家客户现代化大型机系统的经验。在客户运营方面,该团队将把OpenAI模型应用于销售、服务和支持,并借鉴Cognizant在自身业务中使用这些模型的经验。 Cognizant报告称,其已在为客户交付成果。在一家全球生物制药公司,Cognizant共同设计了一款由OpenAI驱动的企业助手,将搜索、内容创作、翻译和审批整合于一处。该公司表示,该助手已处理超过500万次对话,并将内容创作时间缩短了60%。 前沿人才管道 该团队的工作预计将依托Cognizant的Frontier人才模式,根据该模式,公司正在培养由前沿模型公司直接认证的Frontier认证工程师和Frontier业务运营人员。在2026年7月9日的公告中,Cognizant承诺将该人才队伍扩大至5000名Frontier认证工程师和10000名Frontier业务运营人员,并表示其首批人员将在2026年第四季度同时完成Frontier评估并具备部署就绪能力。 7月的公告称,该人才队伍在设计上不依赖特定模型和云平台,其团队会将组织的背景信息融入客户所选择的任何

    匹配字段正文

  6. Tech.eu

    Prismus 获 16.3 万欧元融资,用 AI 平台 Lupa 连接科研成果与产业机会

    瑞士深科技初创公司 Prismus 从 Venture Kick 获得 16.3 万欧元(15 万瑞士法郎),用于推进其 AI 平台 Lupa,该平台把科研、专利与市场信息转化为可执行洞察,并按技术匹配度对市场、公司和潜在合作伙伴排序。Lupa 已获得首批 30 家付费客户,本轮资金将用于在深科技市场扩张并引入个人用户。

    潜在合作伙伴关系、研究方向和商业机会做出战略决策。 科学突破创造了新的商业机会,但确定在何处以及如何应用它们仍然是一项重大挑战。相关信息分散在出版物、专利、研究机构、公司数据库和行业新闻中,使企业难以跟踪新兴技术和市场动态。寻找合适的客户或合作伙伴往往需要大量人工调研,从而拖慢了战略决策和商业增长。 Lupa是一个AI平台,将科学和产业信息汇集在一起,使其可搜索、可执行。其AI代理分析相互关联的来源,根据技术契合度识别并排序相关市场、公司、研究人员和潜在合作伙伴。通过提供有可验证来源支撑的可追溯洞察,Lupa帮助企业做出明智决策,并发现传统市场研究可能忽视的机会。 这家初创公司已获得首批30家付费客户。这笔资金将帮助公司在深科技市场扩张,并引入个人用户。 团队由首席执行官Elisabeth Blyumin、首席技术官Timen van Gelderen、首席AI官Gonçalo Hora de Carvalho和首席营收官Peter Kempin组成,汇聚了AI、技术和业务发展方面的专业知识。 “VentureKick让我们感到兴奋,挑战了我们,并推动我们进入公司发展的下一阶段。尤其是

    匹配字段正文

  7. Computerworld

    别指望 AI 替你保守秘密:聊天数据、破产出售与模型记忆的隐私风险

    DuckDuckGo 委托的调查显示,53% 的美国成年人不知道聊天机器人对话是否被用于训练,而实际上这些对话会被用于训练;仅四分之一受访者知道聊天记录可被传唤。Character.AI 本月申请破产并启动法院监管的资产出售,其经过用户交互训练的 LLM 可能连同用户数据一并被出售,而《破产法》没有专门条款规定训练模型的归属。2022 年一项研究中,GPT-Neo 仅凭姓名找回正确邮箱地址的比例最高为 1.24%,提供域名后升至 16.55%,给出五个示例后达 37.06%。

    会话。例如,它们不会将聊天会话用于训练数据。商业账户获得额外隐私功能,在我看来,这无异于承认个人账户并不私密。 一些公司,如 OpenAI,允许用户选择不让自己的聊天被纳入训练数据。但 OpenAI 的帮助文档称,关闭训练并不会删除聊天记录本身。 其次是分享。一些聊天机器人提供分享功能,这些功能可能有意或无意地将聊天内容公开发布到全世界。一旦这些会话被发布,搜索引擎很可能会将其抓取并使其可被搜索。2025 年,福布斯报道称,在用户点击“分享”后,谷歌的搜索结果中出现了超过 37 万条 Grok 对话,而共享的 ChatGPT 聊天记录也曾出现在搜索结果中,直到 OpenAI 取消了该选项。 第三是聊天会话被吸收进训练数据。 让我们举一个简单的例子:电子邮件地址。人们经常粘贴邮件内容,让聊天机器人撰写回复。这些邮件通常在邮件头、签名或两者中都包含姓名、电子邮件地址和其他信息。 我经常思考的问题是:如果发给某个人的邮件被粘贴到聊天中数百次,陌生人能否向聊天机器人索要那个人的地址,并真的得到它? 在 2022 年的一项研究中,仅给定一个人姓名的 GPT-Neo 模型找回正确电子邮件地址的比例

    匹配字段正文

  8. 凤凰科技

    Cohere 启动 E 轮融资,目标最高 70 亿加元

    加拿大大模型独角兽 Cohere 宣布完成 E 轮融资首次交割,本轮目标融资最高 70 亿加元(约合人民币 334 亿元),若达标将创下加拿大初创企业史上最大单轮私募融资纪录。本轮由德国零售巨头施瓦茨集团领投,英伟达、沙特阿美旗下 Prosperity7 Ventures 等老股东继续参投,加拿大政府等首次参投;若达到募资目标,Cohere 估值将达 357 亿加元(约合人民币 1702 亿元)。Cohere 计划一年内推进两项 AI 公司并购、推出企业网络安全产品 Cohere Cyber,并训练新一代前沿大模型。

    团领投,英伟达、沙特阿美旗下Prosperity7 Ventures等老股东继续参投,加拿大政府等首次参投。去年9月,该公司估值约为98亿加元(约合人民币466亿元)。若其达到募资目标,Cohere估值将达357亿加元(约合人民币1702亿元),一年内增长至原来的3.6倍。 Cohere成立于2019年,主要为企业和政府提供可私有化部署的大模型、AI智能体及搜索工具。 其三位联合创始人均为多伦多大学校友。其中,联合创始人兼首席执行官Aidan Gomez是Transformer奠基论文Attention Is All You Need的八位作者之一。另一位联合创始人Nick Frosst则曾师从“深度学习教父”、2024年诺贝尔物理学奖得主Geoffrey Hinton。 此前,Cohere已完成多轮大额融资:2023年完成约3.8亿加元C轮融资,2024年完成约7亿加元D轮融资,2025年再融资约8.4亿加元,英伟达、甲骨文、Salesforce Ventures等曾参投。 据Cohere披露,截至今年第三季度末,其ARR同比增长165%。全球客户数量在过去一年增长至原来的20倍,达

    匹配字段正文