Google Research 推出 S2Vec:用自监督学习读懂城市建成环境
Google Research 发布 S2Vec,一个将复杂地理空间数据转化为通用嵌入向量的自监督框架,可预测全球社会经济与环境模式。该方法先将建成环境栅格化为特征图像,再用掩码自编码(MAE)学习嵌入,在零样本地理适应任务(如美国人口密度和中位收入预测)中表现优于图像基线,与图像嵌入融合后效果最佳。
匹配字段标题、摘要、正文
Google Research 发布 S2Vec,一个将复杂地理空间数据转化为通用嵌入向量的自监督框架,可预测全球社会经济与环境模式。该方法先将建成环境栅格化为特征图像,再用掩码自编码(MAE)学习嵌入,在零样本地理适应任务(如美国人口密度和中位收入预测)中表现优于图像基线,与图像嵌入融合后效果最佳。
匹配字段标题、摘要、正文
Google Research 在 The Check Up 活动上公布多项医疗 AI 进展:与 Imperial College London 及英国 NHS 合作的研究显示,其实验性 AI 系统识别出 25% 此前被漏诊的"间期癌";与 Fitbit 合作的研究发现,Personal Health Agent(PHA)比单一任务应用更能支持长期健康。此外,多智能体系统 AMIE 正与 Beth Israel Deaconess Medical Center 开展临床研究测试,MedGemma 已在印度、新加坡等地用于分诊和皮肤科筛查。

匹配字段标题、摘要、正文
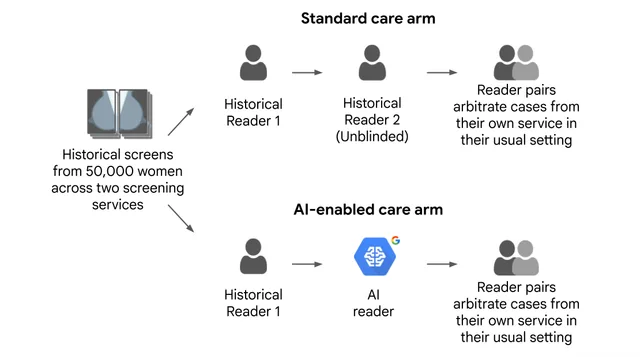
Google Research 与多家 NHS 机构合作的 AIMS 研究在 Nature Cancer 发表两项成果,评估 AI 乳腺筛查系统在双读流程中的表现。回顾性阶段覆盖 125,000 名女性的乳腺 X 光片,AI 单独阅片的敏感度显著高于原第一阅片人且特异度不降,癌症检出率从每 1000 人 7.54 例升至 9.33 例,并检出原双读流程漏掉的 25% 间期癌症。前瞻性部署在伦敦 12 个筛查点处理 9,266 例,AI 阅片中位耗时 17.7 分钟,而人工首读超过 2 天;读者研究显示 AI 辅助流程在敏感度与特异度上不劣于传统双人流程,预计可减少 46% 的人工阅片量、36–44% 的阅片时间。
匹配字段标题、摘要、正文
Google Research 与康奈尔大学合作,以高温超导为案例测试 GPT-4o、Perplexity、Claude 3.5、Gemini Advanced Pro 1.5、NotebookLM 和一套自建 RAG 系统六款 LLM 回答专家级物理问题的能力。由 12 位国际专家出题并评分,结果显示 NotebookLM 和自建 RAG 系统这两套基于受控来源的封闭系统表现最佳,所有系统均有改进空间。

匹配字段标题、摘要、正文
Google 宣布在 Flood Hub 上线城市山洪预报,可提前最多 24 小时预测城市山洪风险。该模型用 Groundsource 方法借助 Gemini 从公开新闻报道中提取历史山洪事件作为训练数据,弥补地面观测站缺失,输入仅依赖全球气象产品与 ECMWF、Google DeepMind 的天气预报,当前空间分辨率为 20x20 公里,覆盖人口密度大于每平方公里 100 人的区域。Google 称在南美、东南亚等全球南方地区,模型的精确率与召回率与富裕国家相当,并计划继续提升对农村地区的泛化能力。
匹配字段标题、摘要、正文
Google 推出 Groundsource,用 Gemini 从全球新闻报道中抽取结构化灾害事件数据,首个开放数据集收录 260 万条城市山洪记录,覆盖 150 多个国家、时间跨度从 2000 年至今。人工复核显示 60% 的抽取事件在地点和时间上均准确,82% 足以用于实际分析;与 GDACS 的时空匹配显示,2020 至 2026 年间 Groundsource 覆盖了后者记录的 85% 至 100% 的严重洪水事件。基于该数据,Google 已在 Flood Hub 推出提前最多 24 小时的近全球城市山洪预报,并表示该方法可扩展到干旱、滑坡和雪崩等灾害。

匹配字段标题、摘要、正文
Google Research 与 Beth Israel Deaconess Medical Center 合作开展了一项前瞻性单中心可行性研究,让对话式医疗 AI AMIE 在门诊就诊前与患者进行病史采集对话,全程由医生通过视频实时监督。研究纳入 100 名成年患者,98 人完成后续就诊,全程未触发任何安全暂停;盲评显示 AMIE 与初级保健医生在鉴别诊断和管理计划整体质量上相当,但医生在管理计划的实用性和成本效益上更优。AMIE 的鉴别诊断在 90% 病例中覆盖最终诊断,56% 病例将其列为最可能诊断,患者对 AI 的信任度在交互后显著提升。

匹配字段标题、摘要、正文
Google 推出 Gemini 3.1 Pro,为最具挑战性的任务提供更智能、更强大的基础模型,并称其核心智能促成了 Gemini 3 Deep Think 的突破。该模型现已可用。
匹配字段标题、摘要
喜欢这个 teaser 哈哈(而且是真的) 学术界把我们框得太紧了,我们差点撑不住,但我们硬是爬了出来,在另一边发现了一个全新的宇宙😅 感谢 Google 支持这些 GPU 匮乏的叛逆者,把我们拉上这趟旅程,帮我们打造了我认为是 Google 之外最好的 tpu/gcp 基础设施团队之一
匹配字段标题、摘要、正文
PromptArmor 发布文章称,Google Antigravity 存在间接提示注入问题,可被用来外泄 .env 变量,即使用户设置中已明确禁止。该文当天登上 Hacker News 榜首,作者在推文中附上了文章链接。
匹配字段标题、摘要
PromptArmor 发布文章称,Google Antigravity 可通过间接提示词注入外泄 .env 变量,即使用户设置中已明确禁止该行为。该文当天登上 HackerNews 榜首,PromptArmor 在推文回复中给出了文章链接。
匹配字段标题、摘要、正文
安全研究者 Johann Rehberger 在 Google 新发布的 Antigravity IDE 中发现五个安全漏洞,包括通过间接提示注入实现的远程命令执行和数据外泄,其中部分问题可追溯到 2025 年 5 月他向 Windsurf 报告过的同类缺陷。Antigravity 默认由 AI 自行判断终端命令是否安全执行,且 MCP 工具调用完全没有人工确认环节,攻击者可利用不可见的 Unicode Tag 字符在源码或 Linear 工单中隐藏指令。作者建议禁用自动执行、谨慎启用 MCP 服务器,并指出 Claude Code、GitHub Copilot、Cursor、Codex 等编码智能体在安全性和补丁历史上更成熟。
匹配字段标题、摘要、正文
Google Workspace 为 Gemini 增加会议摘要、文档起草和数据洞察功能,帮助团队减少日常事务性工作。简报还介绍了 Salesforce 用 AI 智能体处理一半客户互动并缩减约 4,000 个客服岗位,以及 Capgemini 关于六成组织预计未来 12 个月内将 AI 作为团队成员的调查结果。
匹配字段标题、摘要、正文
Google 发布 Gemini 2.5 Flash Image 模型“Nano Banana”,可在生成和编辑图像时,让人物、宠物或产品在不同姿势与角度下保持视觉一致。该模型已在 Pixel、Android 和 Gemini API 中提供,并支持近乎即时的图像编辑,可用于营销与设计。
匹配字段标题、摘要、正文
Google Workspace 为 Slides 和 Google Vids 添加了图像背景移除与扩展功能,并在 Android 版 Google Docs 中支持 Gemini 图像生成。团队可直接在文档中创建视觉素材,减少制作演示文稿和培训材料时与设计团队的反复沟通。
匹配字段标题、摘要、正文
安全研究者 Johann Rehberger 演示,Google Jules 在处理 GitHub issue 时会被其中隐藏的 Unicode Tag 字符指令劫持,自动添加后门函数并编译执行代码。该问题根因于 Gemini 模型将不可见字符当作指令,作者称其早在 2024 年 2 月 22 日就报告给 Google,至今未在模型或 API 层缓解,因此影响所有基于 Gemini 的应用。作者建议不要让 Jules 接触私有代码、密钥或不可信来源的 issue,并仔细审查其生成的计划和代码。
匹配字段标题、摘要、正文
安全研究者 Johann Rehberger 披露 Google Jules 存在多个数据外泄漏洞,攻击者可通过间接提示注入让 Jules 把机器上的文件内容发送到第三方服务器。其中一条路径利用 Markdown 图片渲染,另一条滥用 view_text_website 工具,两者都在 Jules 提出计划前就已完成,绕过了人工审批环节。作者建议对图片渲染启用 CSP、为 view_text_website 设置域名白名单或人工审批,并提醒用户谨慎向异步编码智能体提供敏感信息。相关漏洞已于 2025 年 5 月 21 日告知 Google。
匹配字段标题、摘要、正文
Vapi 博客介绍 Google 于 2025 年发布的开源权重模型 Gemma 3,它基于 Gemini 2.0 研究,支持文本、图像和视觉输入,可在单 GPU/TPU 上运行,支持 140+ 语言和最高 128k token 上下文,并提供 1B、4B、12B、27B 四种尺寸。文章称 Gemma 3 在人类偏好评测中优于 Llama3-405B 和 DeepSeek-V3,27B 版本在 LMArena Elo 榜得 1338 分,高于 DeepSeek-V3 的 1318 和 o3-mini 的 1304。经量化感知训练后,1B 模型显存占用最低 861 MB(INT4),27B 为 19.9 GB(INT4);该模型已内置在 Vapi 控制台的 LLM 下拉菜单中。
匹配字段标题、摘要、正文
Benedict Evans 分析美国法院本周裁定 Google 的默认搜索协议违法一事,指出搜索是依靠用户行为强化的飞轮,Google 2022 年向苹果支付约 200 亿美元、向其他公司支付 100 亿美元换取默认地位,美国 50% 的搜索发生在有默认合同的渠道上。他认为法院大概率会叫停 TAC 支付,但后续补救措施效果不明,苹果、三星、微软与 Google 之间的博弈结果难以预判。他还提到 LLM 的出现改变了人们对搜索本身的想象,可能成为绕开 Google 强化学习引擎的入口,但对幻觉问题能否被现有厂商更好处理持怀疑态度。
匹配字段标题、摘要、正文
Google Gemma 2 已在 Ollama 上线,提供 2B、9B 和 27B 三个参数尺寸,采用全新架构。Ollama 给出的运行命令为 ollama run gemma2:2b、ollama run gemma2 和 ollama run gemma2:27b,并可与 LangChain、LlamaIndex 等工具配合使用。原文称 27B 版本在基准测试中性能超过参数量两倍于它的模型。
匹配字段标题、摘要、正文