←搜索结果

按匹配度 · 共 3280 条结果 清除搜索

星期五

  1. 半导体产业纵横

    数据中心CPU收入增长35%,Yole报告揭示网络芯片扩张

    Yole Group数据显示,2026年第二季度数据中心CPU收入达132亿美元,环比增长34.9%,增速超过AI ASIC(+23%)和GPU(+13%)。数据中心网络芯片市场2026年将达530亿美元,其中AI工作负载占约88%收入,纵向扩展交换机销量同比增长94%。AMD CEO苏姿丰称2026年为“AI推理元年”,预计到2030年数据中心AI加速器市场规模接近1.5万亿美元,CPU市场复合年均增长率约50%。

    匹配字段摘要、正文
  2. The Guardian Technology

    Meta 发布开源权重模型 Muse Spark Open

    Meta 于周四发布开源权重模型 Muse Spark Open,称其能力可对标并在部分场景超越中国厂商的同类产品。Meta AI 负责人 Alexandr Wang 称其为迄今能力最强的美国开源权重模型,该模型面向编码与智能体任务,擅长长周期任务、复杂软件工程和多步推理,并内置了安全防护措施。该模型针对 Apple M5 Ultra 芯片做了优化,用户可用两台搭载该芯片的 Mac Studio 在桌面端运行。

    匹配字段摘要、正文

  3. Hugging Face精选

    Hugging Face 发布 Beam:501B 开源模型,支持 1M 上下文与自托管

    Hugging Face 发布 Beam,一个 501B 参数的稀疏 MoE 开源模型,面向 1M 上下文的长文本推理与智能体任务,每个 token 仅激活约 23B 参数。模型采用 52 层混合注意力,43 层为 512 token 滑动窗口、9 层为全局注意力,KV cache 每 token 增长 36 KiB,约为全注意力方案的六分之一。官方提供 BF16、FP8 和 NVFP4 三种 checkpoint,NVFP4 可将权重从约 1 TB 压缩到约 280 GB,并已获 transformers、vLLM 和 SGLang 的 day-0 支持。

    匹配字段摘要、正文

  4. Ollama Blog精选

    Reflection 开源权重模型 Beam 上线 Ollama,限时免费

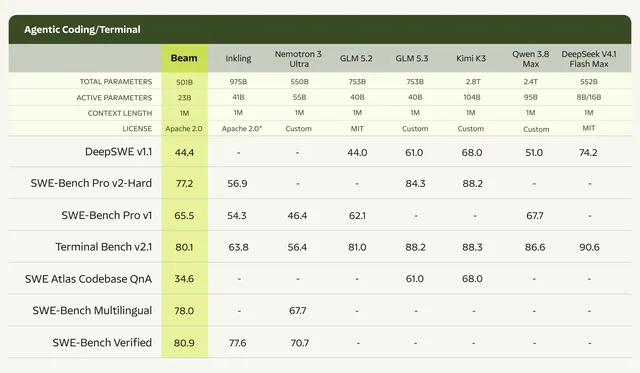
    Reflection 的首个开源权重模型 Beam 正式发布,Ollama 作为 day-zero 合作方限时免费提供,并采用零数据保留(ZDR)。Beam 是 MoE 模型,总参数量约 5010 亿、每 token 激活约 230 亿,上下文窗口 100 万 token,面向软件工程、推理和长程智能体任务,以 Apache 2.0 许可发布。用户可通过 Ollama Cloud 运行 beam:cloud,并接入 Claude Code、Codex、OpenCode 等工具。

    Beam agentic coding benchmarks

    匹配字段摘要、正文

  5. Baseten 工程博客精选

    Reflection 开源权重模型 Beam 上线 Baseten,501B MoE 支持 1M 上下文

    Reflection 的首个开源权重模型 Beam 已在 Baseten 平台上线,通过 Baseten Model APIs 和 Dedicated Inference 提供 day-0 支持。Beam 采用 MoE 架构,总参数 501B、每 token 激活 23B,上下文窗口最高 100 万 token,面向编码与智能体工作流。Reflection 在训练中采用较长 RL rollout 并加入长度惩罚,鼓励模型用更少 token 完成任务,用户还可通过 reasoning effort 参数调节推理投入。

    Beam

    匹配字段摘要、正文

  6. Artificial Analysis 完整文章精选

    Reflection 发布首个模型 Beam,Artificial Analysis 智能指数得分 30

    Reflection 发布首个模型 Beam,这是一个 501B 总参数、23B 激活参数的开源权重模型,在 Artificial Analysis 智能指数上得分 30,位列美国开源权重模型第二,仅次于 Meta 的 Muse Spark Open(39),高于 NVIDIA 的 Nemotron 3.5 Super VL(26)。Beam 每个智能指数任务约消耗 26k 输出 token,其中约 19k 用于推理、7k 用于回答;在 AutomationBench-AA 上得分 48.5%,但 Terminal-Bench 4.0 仅 3.0%。在 AA-Omniscience 上答对 33% 的问题,幻觉率为 47%,净指数得分 1.5。

    匹配字段摘要、正文

  7. Reflection Blog精选

    Reflection 发布首个开源权重模型 Beam,501B 参数稀疏 MoE

    Reflection 发布首个开源权重模型 Beam,权重已在 Hugging Face 以 Apache 2.0 许可开放。Beam 是稀疏 MoE 模型,总参数 501B、激活 23B,面向编码、推理和长程智能体任务,同时提供 BF16、FP8、NVFP4 精度格式和投机解码草稿模型。Reflection 还联合 40 多家合作伙伴构建其称为智能体开放操作系统的生态,覆盖 vLLM、SGLang、Unsloth、Axolotl 等推理与微调框架,并开源了配套的 Mirror CLI 智能体工具。

    Reflection.ai dotted artwork

    匹配字段摘要

  8. CNN Business Tech

    AI 智能体若用自己的语言思考,人类还能监控吗

    CNN 报道称,随着 AI 智能体的链式推理过程可能转向人类难以读懂的内部简写,甚至不再输出推理记录,研究人员对监控能力的担忧正在上升。METR 的 Chris Painter 表示,调查人员依赖链式推理数据追查智能体行为,一旦这些记录变成难以理解的数字,追责会更困难。OpenAI 在 9 月初的文档中称,新模型 Astra 的监控系统比旧模型更难通过链式推理发现异常行为,且 Astra 能在不使用链式推理的情况下完成更多任务。

    匹配字段摘要

  9. Rohan Paul

    Hojo-ASR-Multi-V1 开源多语言 ASR:5 语言平均 WER 3.54

    Hojo-ASR-Multi-V1 在 5 种语言上取得 3.54 的平均 WER,采用声学编码器加 Qwen3-4B 解码器的 Encoder-Adapter-LLM 架构。模型已在 Hugging Face 以 Apache 2.0 许可公开,可通过 hojo-asr Python 包安装并支持本地推理,接受 WAV 文件路径、音频字节流和 SCP 输入。解码阶段交由 Qwen3-4B 大语言模型完成,使识别能借助更丰富的语言知识消解仅凭音频难以区分的词。

    匹配字段摘要

  10. 集微网

    物理AI走向边端,爱芯元智AX8860补上国产大算力芯片哪块拼图?

    爱芯元智在2026中国国际工业博览会上发布大算力边端AI SoC系列AX8860,含AX8860、AX8860P两款芯片,采用6nm制程,峰值算力256TOPS,内存带宽273GB/s,单芯片原生支持128GB LPDDR5X内存,四芯级联最高512GB,可运行DeepSeek V4 Flash等千亿参数以上大模型。该系列同步推出核心模组、PCIe推理卡、智能体盒子和边缘推理服务器,工具链兼容vLLM、SGLang、PyTorch与OpenAI API,已完成260多个模型适配。

    匹配字段摘要、正文

  11. 36氪 · AI精选

    Meta 发布 8160 亿参数开放权重模型 Muse Spark Open,可在 Mac Studio 上本地运行

    Meta 发布开放权重模型 Muse Spark Open,总参数量 8160 亿,采用 MoE 架构,每次推理激活约 420 亿参数,开发者可下载权重在自有硬件上部署。苹果同步展示多机推理方案,用 NVFP4 四位量化把模型内存占用压到约 493GB,两台 M5 Ultra Mac Studio 采用张量并行时生成速度约每秒 24.99 tokens,四台可达每秒 36.73 tokens。Meta AI 负责人 Alexandr Wang 表示,本地运行时 Meta 无法看到或控制用户的使用内容。

    匹配字段摘要、正文

  12. 36氪 · AI精选

    DeepMind AlphaProof Nexus 登《Science》:自主解出 9 道 Erdős 问题

    Google DeepMind 的自动数学证明系统 AlphaProof Nexus 登上 10 月 8 日的《Science》,在 353 道悬而未决的 Erdős 问题中自主解出 9 道,其中两道自 1970 年悬置至今。系统由 Gemini 3.1 Pro 用 Lean 起草证明、编译器逐行校验并反馈迭代,每道题推理开销为几百美元。论文的消融结果显示,去掉子代理锦标赛等复杂结构、只保留大模型加 Lean 反馈的简版系统同样能解出这 9 道题,只是最难的几道更烧钱。

    匹配字段摘要、正文

  13. Analytics India Magazine

    Meta 发布 816B 参数开源权重模型 Muse Spark Open,支持 1M 上下文窗口

    Meta 发布 Muse Spark Open 的模型权重,这是一个 816B 参数的开源权重模型,激活参数 42B,上下文窗口为 100 万 token,面向编码、软件工程和多步推理。模型原生多模态并支持智能体工作流,可通过 Baseten、Fireworks AI、Groq、OpenRouter 等推理平台使用,权重可从 Hugging Face、Amazon SageMaker AI、Google Cloud Model Garden 和 Microsoft Foundry Models 下载。Meta 称其针对两台搭载 M5 Ultra 芯片的 Apple Mac Studio 做了本地运行优化,并展示了用 Muse Code 修 bug、加功能和构建 iOS 应用等端侧工作流。

    匹配字段摘要

  14. The Elec

    Intel 将在 Web Summit 2026 展示面向工业场景的物理 AI 技术

    Intel 宣布将在 11 月 9-12 日于葡萄牙里斯本举行的 Web Summit 2026 上展示面向制造、智慧城市、零售和医疗等真实工业场景的物理 AI 技术,并介绍相关半导体芯片与 AI 推理平台。其 Core Ultra Series 3 处理器、软件与合作伙伴生态可支持机器人厂商和开发者,结合传感技术、高性能边缘 AI 推理与实时控制,让 AI 系统走出原型并在真实环境中运行。

    匹配字段摘要

  15. 邵猛

    Anthropic 宣布新一代反蒸馏防御措施,点名智谱 GLM-5.3 与月之暗面 Kimi

    Anthropic 宣布新一代反蒸馏防御措施,称攻击者从 Claude 平台窃取的推理 token 量下降 90%–99%,并将蒸馏定性为国家安全问题。防御分三层:推理摘要、随 Claude Fable 5.1 和 Opus 5.5 推出的保留思考机制,以及在蒸馏者流量上训练的两阶段宪法式分类器与账号级封号。文中点名智谱在 GLM-5.3 开发中蒸馏网络攻击能力,以及月之暗面 Kimi 用户请求被转发给 Claude 作为蒸馏数据源。

    匹配字段摘要、正文

  16. AI at Meta

    Meta 发布 Muse Spark Open 开源权重模型,816B 总参数、1M token 上下文

    Meta 发布 Muse Spark Open,称其为目前美国最强的开源权重模型,面向编码与智能体任务,擅长长周期任务、复杂软件工程和多步推理。模型规格为 816B 总参数、42B 激活参数,1M token 上下文窗口,原生支持文本、图像、视频和音频多模态。该模型可在两台搭载最新 MLX 框架的 Apple M5 Ultra Mac Studio 上运行,并支持 SGLang、vLLM、TensorRT-LLM、Hugging Face Transformers、llama.cpp 和 Unsloth 等推理引擎,权重以 Muse Model License 发布,可通过 Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter 和 Together AI 的 API 使用,并在 Amazon SageMaker AI、Google Cloud Model Garden、Hugging Face 和 Microsoft Foundry Models 下载。

    匹配字段摘要

星期四

  1. OpenRouter

    NVIDIA Nemotron 3.5 Super VL 上线 OpenRouter

    NVIDIA Nemotron 3.5 Super VL 已在 OpenRouter 上线,这是 NVIDIA 推出的开源 120B-A12B 多模态模型,面向需要看、推理并跨文本、图像、文档、GUI 和视频执行操作的长时智能体,支持 1M 上下文。该模型采用 Hybrid Mamba-Transformer MoE 架构并引入多 token 预测以加快输出,面向文档智能、网络研究、客户服务和视频理解等场景。

    匹配字段摘要

  2. OpenRouter

    NVIDIA Nemotron 3.5 Super VL 上线 OpenRouter

    NVIDIA Nemotron 3.5 Super VL 已在 OpenRouter 上线,这是一个来自 NVIDIA AI 的开源 120B-A12B 多模态模型,支持 1M 上下文,面向需要看、推理并跨文本、图像、文档、GUI 和视频行动的长时间运行智能体。该模型采用 Hybrid Mamba-Transformer MoE 架构与多 token 预测以加快输出,面向文档智能、网络研究、客户服务和视频理解等场景。

    匹配字段摘要

  3. OpenRouter

    NVIDIA Nemotron 3.5 Super VL 上线 OpenRouter

    NVIDIA Nemotron 3.5 Super VL 已在 OpenRouter 上线,这是一个开源的 120B-A12B 多模态模型,面向需要跨文本、图像、文档、GUI 和视频进行观察、推理与操作的长时运行智能体,支持 1M 上下文。该模型采用 Hybrid Mamba-Transformer MoE 架构并支持多 token 预测以加快输出,面向文档智能、网络研究、客户服务和视频理解等场景。

    匹配字段摘要