←搜索结果

按匹配度 · 共 1640 条结果 清除搜索

星期四

  1. Qwen Blog精选

    阿里千问发布 Qwen3.6-Plus,主打真实世界智能体能力

    阿里千问发布 Qwen3.6-Plus,通过阿里云百炼 API 提供,默认 1M 上下文窗口,重点提升智能体编码与多模态感知推理能力。官方基准显示其在 SWE-bench Verified 得 78.8、Terminal-Bench 2.0 得 61.6、QwenClawBench 得 57.2,均高于 Qwen3.5-397B-A17B。API 新增 preserve_thinking 参数用于保留多轮思考内容,默认关闭,可接入 Claude Code、Qwen Code、Cline、OpenCode 等编码工具。

    阿里千问发布 Qwen3.6-Plus,通过阿里云百炼 API 提供,默认 1M 上下文窗口,重点提升智能体编码与多模态感知推理能力。官方基准显示其在 SWE-bench Verified 得 78.8、Terminal-Bench 2.0 得 61.6、QwenClawBench 得 57.2,均高于 Qwen3.5-397B-A17B。API 新增 preserve thinking 参数用于保留多轮思考内容,默认关闭,可接入 Claude Code、Qwen Code、Cline、OpenCode 等编码工具。

    匹配字段摘要
星期二

  1. Mistral AI

    Mistral AI 发布面向人类与智能体的 CLI 工具 Spaces

    Mistral AI 发布内部平台工具 Spaces CLI,用于脚手架搭建项目、生成配置并部署到 staging,同时兼顾人类开发者与编码智能体两类使用者。团队为每个交互式提问补上等价 flag,并加入 -y 无阻塞模式,使智能体可端到端自主完成配置与部署。每次 init 还会生成 context.json 与 AGENTS.md,向智能体说明项目模块、端口、命令和环境变量,减少其猜测与误操作。

    匹配字段摘要

星期三

  1. Modal 官方工程博客

    Doppel 如何用 Modal 消除 ML 基础设施税

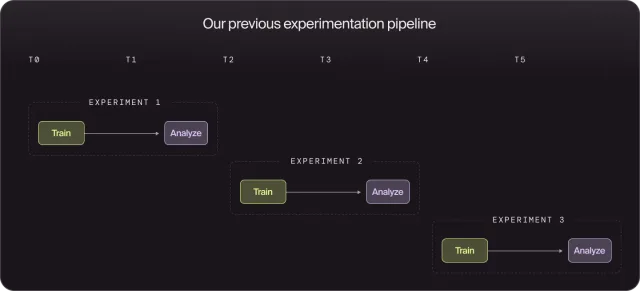
    Doppel 将大部分 ML 工作流迁移到 Modal,训练实验从串行改为并行,推理部署的镜像构建时间最多缩短 10 倍,复杂模型也能实现亚分钟级热构建。Modal 的 CLI 让编码智能体可直接启动实验、查看日志并触发后续运行,Cloud Run 单实例仅支持单 GPU 等限制带来的运维摩擦随之减少。

    匹配字段摘要

  2. Browser Use精选

    Browser Use 用 Auto-Research 在 Online-Mind2Web 上取得 97%

    Browser Use 称其浏览器智能体在 Online-Mind2Web 基准上取得 97%,为目前最高分。该基准包含 136 个真实网站的 300 个任务,团队用 Claude Code 配合评测平台 CLI 循环运行 20 轮自动搜索最优智能体,并把浏览器智能体改造为可写 Python 解析 HTML 的编码智能体。团队还构建了基于 Claude Agent SDK 的智能体评审,并公开了仓库、提示词、结果与评判,便于复现。

    匹配字段摘要

  3. Google Research

    Google Research 推出 S2Vec:用自监督学习读懂城市建成环境

    Google Research 发布 S2Vec,一个将复杂地理空间数据转化为通用嵌入向量的自监督框架,可预测全球社会经济与环境模式。该方法先将建成环境栅格化为特征图像,再用掩码自编码(MAE)学习嵌入,在零样本地理适应任务(如美国人口密度和中位收入预测)中表现优于图像基线,与图像嵌入融合后效果最佳。

    匹配字段摘要

星期四

星期三

  1. Mistral AI精选

    Mistral 如何用 Vibe 搭建自动编写 Rails 测试的智能体

    Mistral AI 基于其开源编码助手 Vibe 搭建了一个自动为 Rails 项目生成和改进 RSpec 测试的智能体,可在 CI/CD 中无人干预运行,并支持多实例并行处理不同文件。该智能体通过仓库级 AGENTS.md 提供分步执行计划、按文件类型拆分 skills 文件,并加入 RuboCop 与 SimpleCov 自定义工具,其中把 SimpleCov 放在最后一步强制运行每个测试是最关键的决定,因为首次执行时只有约三分之一测试通过。在包含 275 个源文件的真实仓库实验中,已有测试文件的 LLM-as-a-judge 评分从 0.49 提升到 0.74,覆盖率达到 100%。

    匹配字段摘要

星期三

  1. Physical Intelligence

    Physical Intelligence 为机器人模型推出 MEM 记忆系统

    我们为模型开发了一套记忆系统,同时提供短期视觉记忆和长期语义记忆。 我们的方法让我们能够训练机器人执行长时间、复杂的任务,比如清理厨房或从头制作烤奶酪三明治 👇 没有记忆,机器人在许多真实场景中会陷入困境,比如反复犯同样的错误、卡住或失去时间感。 但我们不能直接把几分钟甚至几小时的视频塞进模型的上下文——那很快就会变得不可处理。 为此,我们开发了多尺度具身记忆(MEM)。核心思路:用不同模态在不同时间尺度上表示记忆。 📹 对于短时程记忆,我们开发了一个高效的视频编码器,让模型记住近期交互中的细粒度细节。 📜 对于长时程记忆,我们训练模型用文本总结事件,使其能记住长达 15 分钟的事件。 借助 MEM,我们的模型可以在真实世界中执行真正的多阶段任务,比如清理整个厨房或准备食谱所需的食材。视频展示了机器人如何用文本跟踪长时程记忆。 除了解决新任务,记忆还让我们的策略更加鲁棒:我们展示了上下文适应的早期迹象,机器人通过从过去的错误中学习,实时调整自己的行为。 更多内容,请查看 我们的论文:https://t.co/xQLvOwko0m 我们的博客文章:https://t.co/tjJO4D6MYP

    模型开发了一套记忆系统,同时提供短期视觉记忆和长期语义记忆。 我们的方法让我们能够训练机器人执行长时间、复杂的任务,比如清理厨房或从头制作烤奶酪三明治 👇 没有记忆,机器人在许多真实场景中会陷入困境,比如反复犯同样的错误、卡住或失去时间感。 但我们不能直接把几分钟甚至几小时的视频塞进模型的上下文——那很快就会变得不可处理。 为此,我们开发了多尺度具身记忆(MEM)。核心思路:用不同模态在不同时间尺度上表示记忆。 📹 对于短时程记忆,我们开发了一个高效的视频编码器,让模型记住近期交互中的细粒度细节。 📜 对于长时程记忆,我们训练模型用文本总结事件,使其能记住长达 15 分钟的事件。 借助 MEM,我们的模型可以在真实世界中执行真正的多阶段任务,比如清理整个厨房或准备食谱所需的食材。视频展示了机器人如何用文本跟踪长时程记忆。 除了解决新任务,记忆还让我们的策略更加鲁棒:我们展示了上下文适应的早期迹象,机器人通过从过去的错误中学习,实时调整自己的行为。 更多内容,请查看 我们的论文:https://t.co/xQLvOwko0m 我们的博客文章:https://t.co/tjJO4D6MYP

    匹配字段摘要

  2. Physical Intelligence精选

    Physical Intelligence 提出 MEM 多尺度具身记忆系统

    Physical Intelligence 开发了 Multi-Scale Embodied Memory(MEM)记忆系统,为模型同时提供短期视觉记忆和长期语义记忆。短期记忆用高效视频编码器记住近期交互的细节,长期记忆则让模型用文本总结事件,最长可记住 15 分钟的内容。该记忆系统让机器人能完成清理整个厨房、按食谱备料等多阶段真实任务,并展现出从过去错误中即时调整行为的上下文适应迹象。

    匹配字段摘要

  3. Physical Intelligence

    Physical Intelligence 推出多尺度具身记忆 MEM

    为此,我们开发了多尺度具身记忆(MEM)。核心思路:用不同模态表示不同时间尺度上的记忆。 📹 对于短时程记忆,我们开发了一个高效的视频编码器,让模型能记住近期交互中的细粒度细节。 📜 对于长时程记忆,我们训练模型用文本总结事件,使其能记住长达 15 分钟的事件。

    为此,我们开发了多尺度具身记忆(MEM)。核心思路:用不同模态表示不同时间尺度上的记忆。 📹 对于短时程记忆,我们开发了一个高效的视频编码器,让模型能记住近期交互中的细粒度细节。 📜 对于长时程记忆,我们训练模型用文本总结事件,使其能记住长达 15 分钟的事件。

    匹配字段摘要

  4. Physical Intelligence

    Physical Intelligence 提出多尺度具身记忆 MEM,让机器人记住 15 分钟事件

    Physical Intelligence 为自家模型开发了多尺度具身记忆系统 MEM,用不同模态表示不同时间尺度的记忆。短期记忆由高效视频编码器保留近期交互的细粒度细节,长期记忆则通过训练模型用文本总结事件,最长可记住 15 分钟。该系统让机器人能完成清理整个厨房、从头准备烤奶酪三明治等多阶段真实任务,并展现出从过往错误中即时调整行为的上下文适应迹象。

    匹配字段摘要

星期五

  1. Browser Use

    Browser Use 创始工程师分享如何赢得黑客松:从选题、规划到演示的完整指南

    Browser Use(YC W25)创始工程师 Reagan 结合自己在 Y Combinator、MIT、斯坦福等黑客松获奖经验,给出从选题、规划到演示的完整建议。他建议多与赞助商交流、从真实问题出发、优先打磨视觉冲击力强的演示,并在实现阶段并行运行约 5 个编码智能体。演示前至少预留 10 分钟、最好 20 分钟准备脚本。

    First place overall at Y Combinator

    匹配字段摘要

星期二

  1. Cognition 模型 / Devin 博客精选

    Cognition 发布 Devin 2.2,支持 computer use 测试与自动修复

    Cognition 发布 Devin 2.2,称这是 Devin 上线以来最大更新之一,目标是让它成为最自主的智能体。新版本可借助 computer use 在自有 Linux 桌面上启动并测试桌面应用,创建 PR 后建议测试并回传屏幕录制;Devin Review Autofix 让它在用户打开 PR 前完成规划、编码、自审、发现问题并修复。启动速度提升 3 倍,界面重建统一了从规划到代码审查的开发流程。自 2026 年 2 月 24 日起新用户的 Devin 会话默认开启 Desktop 支持,老用户可在 Settings 中开启。

    匹配字段摘要

星期四

  1. OpenHands 官方博客

    速度已死:AI 生成编译器与软件工程的未来

    OpenHands 首席架构师 Ray Myers 撰文指出,Anthropic 用编码智能体生成 100K 行 Rust 的 C 编译器、耗资 2 万美元 token,他本人则用 OpenHands 配合 Opus 4.5 以 200 美元生成 40K 行 Go 版本,但两者都不具备实际用途。他认为代码生成速度已不再是瓶颈,行业应转向质量与“智能体就绪度”,即测试、模块化架构和静态分析等持续交付实践。

    匹配字段摘要

星期三

  1. Zyphra Research

    Zyphra 发布 ZUNA:380M 参数 EEG 基础模型推进思维转文本

    Zyphra 发布 ZUNA,一个 380M 参数的扩散自编码器 BCI 基础模型,用于去噪、重建和上采样头皮 EEG 信号,支持任意通道布局。ZUNA 在通道丢失超过 75% 时于所有数据集上超越 MNE 默认的球面样条插值,优势随数据退化程度增加而扩大。该模型面向研究人员、临床医生和 BCI 开发者,可恢复部分损坏的 EEG 会话并让低通道设备映射到更高分辨率信号空间。

    匹配字段摘要

  2. Zyphra Research

    Zyphra 发布 ZUNA 脑机接口基础模型,推进思维转文本

    Zyphra 发布首个基于脑数据训练的基础模型 ZUNA,这是一个 380M 参数的扩散自编码器,可从有噪声或不完整的头皮 EEG 数据中重建高保真脑信号,并能从稀疏输入和电极坐标预测缺失通道,适配从消费级头戴设备到 256 电极研究系统的多种布局。ZUNA 在更高缩放因子下持续优于 MNE 中实现的球面样条插值这一行业标准方法。模型以 Apache 2.0 许可开源,权重发布于 Hugging Face,推理与预处理代码发布于 GitHub,并提供 pip install zuna 安装包。

    匹配字段摘要

  3. Claude Platform:开发者版本说明精选

    Anthropic 发布 Claude Sonnet 4.6,支持 1M token 上下文

    Anthropic 发布 Claude Sonnet 4.6,在编码、计算机使用、长上下文推理、智能体规划和知识工作等方面全面升级,并支持 1M token 上下文窗口(beta)。该模型现为 claude.ai 和 Claude Cowork 的默认模型,定价与 Sonnet 4.5 相同,起价 $3/$15 每百万 token。早期测试中,用户在 Claude Code 里对 Sonnet 4.6 的偏好度比 Sonnet 4.5 高约 70%,比 Opus 4.5 高 59%。

    匹配字段摘要

星期一

  1. LMSYS Blog

    SGLang-Diffusion 如何为生产级视频生成做高级优化

    SGLang-Diffusion 公布面向生产级视频生成的高级优化,将序列并行分片从帧级改为 token 级,把 T×H×W 展平后分片以减少甚至消除 padding 与通信量。框架还引入 Parallel Folding 解耦 Text Encoder 与 DiT 的并行策略、为 Wan-VAE 实现分布式编码解码,并修复 Cache-DiT 在多请求服务下的缓存上下文污染与形状不匹配崩溃问题。

    匹配字段摘要

  2. Qwen Blog精选

    Qwen3.5 发布:首个原生多模态智能体模型 Qwen3.5-397B-A17B

    Qwen 团队正式发布 Qwen3.5 系列首个开源权重模型 Qwen3.5-397B-A17B,这是一个原生视觉语言模型,在推理、编码、智能体和多模态理解等基准上给出完整评测结果。模型采用线性注意力(Gated Delta Networks)与稀疏 MoE 混合架构,总参数 397B、每次前向仅激活 17B,语言与方言支持从 119 种扩展到 201 种。托管版本 Qwen3.5-Plus 通过阿里云百炼提供,默认 1M 上下文窗口,并内置官方工具与自适应工具调用。

    匹配字段摘要