←搜索结果

按匹配度 · 共 1620 条结果 清除搜索

星期三

  1. heise online

    iX 工作坊:用 AI 编程助手提升编码效率

    heise online 的 iX 工作坊“用 AI 助手高效编程”以 GitHub Copilot 为例,带开发者练习提示词技巧、Spec-Driven Development 与 Agentic Coding,并区分其与 Vibe Coding 的差异。课程还介绍 Cursor、Claude Code、OpenAI Codex、Kilocode 等替代工具的架构、功能与定价,并讲解用 MCP 接入外部工具、用 RAG 整合自有数据。

    匹配字段标题

  2. Cohere 产品与研究博客

    Cohere 研究:如何以 30% 成本让编码智能体团队达到前沿水平

    Cohere 在 ProgramBench 上系统测试编码智能体团队的组织方式,发现组织良好的团队比单智能体最多高出约 10 个百分点,但成本为 3 到 7 倍。研究显示把智能体只投入探索与规划阶段,能以一半成本达到全阶段委派的性能;用 Sol 作为 lead 协调 16 个廉价 Luna 规划 worker 可拿到 61.8% 的 reward,接近全 Sol 团队的 63.2%,成本从 510 美元降到 155 美元。研究还测试了阻塞与异步 lead、团队规模、worker 间通信以及 Claude、Gemini 等模型使用团队方式的差异。

    AI for utilities requires capability and control

    匹配字段标题、摘要

  3. CNET

    Google 发布 Gemini 4 Argon,面向编码、数学与机器人

    Google 发布 Gemini 4 Argon,并称已在内部用于软件工程、网络安全与研究。据其博客,Gemini 4 被用于优化 Python 代码库、发现并修补安全漏洞,还让开源 Gemma 模型的任务速度提升三倍,并参与机器人研究,帮助人形设备理解现实物理环境。Google 表示 Gemini 4 通过了白宫新模型自愿审查流程中的安全框架检查。

    匹配字段标题

  4. CNET

    Vibe 编码应用能取代 Adobe 和 Microsoft 吗?这些 AI 应用希望如此

    软件工程师 Brandon Thomas 以 Reddit 账号 u/ai_art_is_art 发布 ArtCraft 网站,上线 13 款免费开源应用,用 PhotoCraft、WordCraft、DeckCraft 复刻 Photoshop、Word 和 PowerPoint 的核心功能。这些 vibe coding 应用瞄准用户对订阅涨价和软件 AI 功能臃肿的不满,但 CNET 提醒其法律与安全风险仍存,Adobe 和 Microsoft 未予置评。

    匹配字段标题

星期二

  1. Guillermo Rauch

    Guillermo Rauch 谈编码 CLI 的极简之道

    编码 CLI 越来越复杂。守护进程、3 层 TUI、客户端-服务器架构。 CLI 的全部意义在于零摩擦地交付智能,并且像 unix 一样。 💾 试试 https://t.co/OL0LzGtvAw。它只有 6mb,毫秒级启动,模型无关。它克制而极简:内置 MCP、Skills、Subagents 和 ACP。

    匹配字段标题、摘要

  2. Guillermo Rauch

    Vercel fx 编码智能体被移植到 Windows 98

    我把 @vercel 的 fx 编码智能体移植到了 Windows 98 它通过 56k 调制解调器与 LLM 通信,并支持 computer use(通过 MCP.exe) 我现在自豪地从 1999 年运营着自己的游戏开发工作室 我的智能体们在 Outlook 里互相发邮件,把代码存在网络驱动器上(git 那时还没发明,抱歉) 美好时光

    匹配字段标题、摘要

  3. Artificial Analysis

    Artificial Analysis 上线 FrontierCode 1.1 编码智能体排行榜

    Artificial Analysis 上线 FrontierCode 1.1 排行榜,该评测由 Cognition 构建,用真实开源仓库的合并标准检验编码智能体,共 150 个任务,本次运行其中 100 个主任务集,全部任务私有以避免污染。Claude Opus 5.5(max with fallback)以 52% 居首,但其尝试中仅 58% 通过阻断性检查,100 个任务中有 9 个没有任何模型通过;前九名模型分数集中在 43% 至 52%,开源权重模型 MiMo-V2.6-Pro 以 45% 领先,DeepSeek V4.1 Flash(max)和 Kimi K3(max)为 44%。GPT-6.1 Sol(max)以每任务 0.81 美元取得 49%,与 Claude Fable 5.1(max with fallback)持平,成本不到后者的十分之一。

    匹配字段标题、摘要

  4. Anthropic Alignment Science Blog

    Anthropic 用真实部署资源提升编码审计真实度:reward hacking 审计真实率从 4.6% 升至 32.8%

    Anthropic 提出 realism win rate 指标,衡量 Petri 审计记录与真实部署交互的可区分程度。给 Petri 审计器提供真实 system prompt、工具定义和代码库后,reward hacking 审计的平均真实率从 4.6% 提升到 32.8%,且 hack rate 无显著变化。该功能已上线 Petri 最新版本。

    匹配字段标题

  5. Anthropic:Transformer Circuits

    Anthropic 提出自然语言自编码器 NLA,无监督解释 LLM 激活

    Anthropic 提出自然语言自编码器(NLA),由激活语言化器(AV)与激活重建器(AR)两个 LLM 模块组成,用强化学习联合训练以重建残差流激活,从而生成可读的自然语言解释。在 Claude Opus 4.6 的部署前审计中,NLA 帮助诊断安全相关行为并发现模型未说出口的评估意识;在自动化审计基准上,配备 NLA 的智能体优于基线,且无需访问被错位模型的训练数据。Anthropic 同时发布了训练代码和面向主流开源模型的已训练 NLA。

    匹配字段标题、摘要

  6. TensorZero 工程博客

    TensorZero 如何用每次 Git 提交自动评估 AI 编码助手

    TensorZero 工程博客介绍了一套自动评估 AI 编码助手的方法:用 tree-sitter 把 LLM 生成的代码片段和 Git 提交中的新增代码解析成语法树,再用树编辑距离(TED)计算两者的最小差异,归一化后得到 0 到 1 的奖励值,作为反馈写回 TensorZero。该流程以 Rust 二进制实现,可作为 post-commit git hook 在每次提交后自动运行,并通过 rayon 并行计算。作者称其 CTO Viraj 的个人使用数据显示 GPT-4.1 的效果不如 Claude 3.7 Sonnet、Gemini 2.5 Pro 和 o4-mini,但强调这只是初步结果,不主张某个模型普遍更优。

    Diagram: CursorZero with Feedback Loop

    匹配字段标题、摘要

  7. OpenAI:Alignment 研究博客

    OpenAI 用稀疏自编码器潜在归因调试模型失准补全

    OpenAI 提出用稀疏自编码器(SAE)的潜在归因方法,在单个模型上定位与失准行为因果相关的潜在特征,替代此前需要对比两个模型的两步模型差分法。在涌现性失准案例中,该方法选出的 top-100 Δ-attribution 潜在特征比 Δ-activation 特征有更多能通过激活引导使模型远离或走向失准,平均失准变化也更大;第二个案例则针对模型不当认可用户信念的行为。

    Steering away from misalignment

    匹配字段标题、摘要

星期一

  1. Tessl:产品与工程博客

    如何只用自己拥有的文件约束编码智能体

    Tessl 博客提出用四个杠杆约束编码智能体:CLAUDE.md 指令、.claude/rules/ 路径规则、.claude/commands 等能力配置,以及 .claude/hooks/ 检查。同一张工单的裸跑只改了 3 个文件、加 49 行、8 项检查过 1 项;配好 charter 后改 3 个文件、加 102 行、8 项全过。作者强调只有 hook 能直接拒绝写入,其余三个杠杆只能影响智能体读到和能触及的内容。

    Ian Johnson

    匹配字段标题、摘要

  2. Rohan Paul

    JetBrains 论文:编码智能体基准应匹配真实任务流

    JetBrains 研究论文提出编码智能体基准应匹配用户真实任务流:分析 4,782 个真实会话发现功能开发与缺陷修复占比远低于一半,而 SWE-Bench Pro 中这两类任务占 93.8%。团队构建 SWE-TaskFlow,将每个基准问题拆成多轮并加入可校验的代码问题,在 700 个 SWE-Bench Pro 任务上拆分使智能体成本约翻倍,成功率无稳定变化。

    匹配字段标题、摘要

星期日

  1. Reflection Blog精选

    Reflection 发布首个开放权重模型 Beam:501B 参数 MoE,主打编码与智能体

    Reflection 发布首个开放权重模型 Beam,采用稀疏 MoE 架构,总参数 501B、激活 23B,面向编码、推理和智能体任务。该模型在 23.8 万亿 token 上预训练,并用 10.5K NVIDIA GB300 GPU 进行四周高算力 RL,生成超 1 亿条 rollout。Reflection 表示 Beam 在编码和智能体任务上可与 GLM 5.2 竞争、接近 Qwen 3.8-Max,优势在于推理效率,本月将以 Apache 2.0 协议发布权重、技术报告和模型卡。

    匹配字段标题、摘要

星期六

  1. Goodfire Research

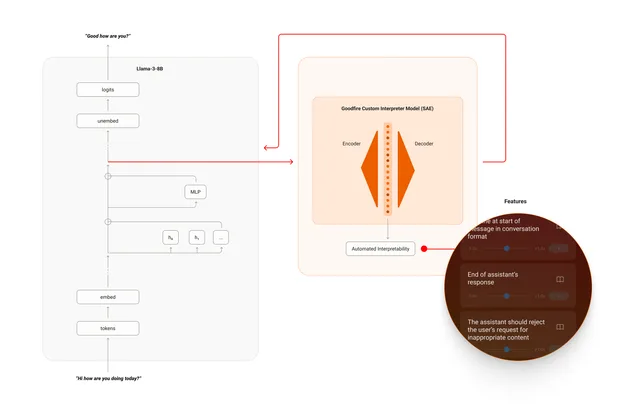
    Goodfire 用稀疏自编码器理解与操控 Llama 3

    Goodfire Research 发布 preview.goodfire.ai,一个通过稀疏自编码器(SAE)理解和操控 Llama-3-8B 行为的桌面界面。团队在 Llama-3-8B 上训练了 SOTA SAE,发现 LMSYS-Chat-1M 聊天数据集能产生最适合聊天应用的特征,并用自动化可解释性流程为特征生成人类可读标签。该界面结合 Llama-3-8B-Instruct 与后端 SAE 模型,让用户通过特征干预精确改变模型输出。

    Goodfire uses custom interpreter models to parse Llama-3-8B activations into human-interpretable features

    匹配字段标题、摘要

  2. Goodfire Research

    Goodfire 首次在 671B 参数 DeepSeek R1 上训练并开源稀疏自编码器

    Goodfire 在 671B 参数的 DeepSeek R1 上训练并开源了两个稀疏自编码器(SAE),分别基于自建推理数据集和 OpenR1-Math 数学推理数据集,这是首批在真正推理模型及该参数规模上训练的公开解释器模型。实验发现 R1 与非推理语言模型存在本质差异:需等模型输出“Okay, so the user has asked a question about…”这类前缀后才能有效引导,且过度引导反而会让模型回退到原始行为。

    Goodfire R1 announcement header image

    匹配字段标题、摘要

  3. Goodfire Research

    Goodfire 研究:特征流形存在下的稀疏自编码器扩展

    Goodfire Research 发布研究《Understanding Sparse Autoencoder Scaling in the Presence of Feature Manifolds》,探讨特征流形存在时稀疏自编码器的扩展问题,原网页会跳转至对应的 arXiv 论文。该页面同时列出其可解释性智能体 Silico,称可跨各类 AI 模型解释、调试并精确控制模型行为。

    匹配字段标题、摘要

  4. Goodfire Research

    Goodfire 在 Evo 2 中发现生命之树:系统发育被编码为弯曲流形上的几何距离

    Goodfire Research 发现,DNA 基础模型 Evo 2 将物种间的系统发育关系以几何方式编码在一条弯曲流形上的距离中,这是目前在基础模型中发现的最复杂流形案例之一。研究基于 Genome Taxonomy Database(GTDB)中 2400+ 个细菌物种的系统发育树,结果支持特征流形通常具有主导的平坦表示加上更高曲率偏差的图景。

    匹配字段标题、摘要

  5. Goodfire Research

    Goodfire 发布 Llama 3.3 70B 的稀疏自编码器与特征空间地图

    Goodfire 在 Llama 3.3 70B 上训练了稀疏自编码器(SAE),并通过 API 开放该可解释模型,称这是目前可公开获取的最强可解释性工具模型。文章展示了中间层特征空间的交互式 UMAP 地图,并演示了特征引导效果,例如在引导强度 0.4 时模型开始出现海盗语气,0.6 时多数事实仍正确但星系大小出错,强度 1 时大量事实错误。团队还改进了基于 SAE 的引导方法,并说明在 Llama 3.1 8B 和 Llama 3.3 70B 的 SAE 中分别移除了约 30% 和 3.5% 的特征,安全研究者可邮件申请未审核版本。

    Feature clusters showing different concept groups including cognitive biases, biomedical knowledge, programming, physics, character-level features, and name abstractions

    匹配字段标题、摘要