Physical Intelligence 发布 π0.7 机器人模型
想了解更多,请查看我们的博客文章、视频和完整研究论文:https://t.co/1Kf6wRiN2P
匹配字段摘要
想了解更多,请查看我们的博客文章、视频和完整研究论文:https://t.co/1Kf6wRiN2P
匹配字段摘要
Physical Intelligence 发布最新机器人模型 π0.7,可处理不仅说明做什么、还说明怎么做的多样提示词,包括丰富语言和视觉子目标图像等多模态信息,测试时这些图像可由轻量级世界模型生成。该模型展现出涌现的组合泛化能力,能把已学技能按提示词以新方式组合,例如学会用空气炸锅烤红薯;还能在没有该机器人洗衣折叠数据的情况下,控制新机器人 UR5e 折叠 T 恤。团队表示仍在探索 π0.7 的能力,更多细节见其博客、视频和完整研究论文。
匹配字段摘要
Sakana AI 完成日本总务省「互联网虚假与错误信息对策技术开发与实证事业(令和7年度)」的系统开发,覆盖 SNS 空间可视化、综合虚假信息判定与对策立案。其 novelty search 技术可递归采样 X 帖子数据以抽取高影响力叙事,并用层级叙事树可视化;判定端结合前沿基座模型与自研模型检测图像视频生成加工痕迹,并实现自动事实核查。对策端基于自研 ABM 框架 Shachi 模拟 SNS 空间,验证反制发信效果。
匹配字段摘要
阿里 Qwen 团队发布 Qwen3.5-Omni,定位为向原生全模态 AGI 扩展的模型,旗舰版本 Qwen3.5-Plus-Omni 可通过阿里云 Model Studio 调用。官方演示覆盖视频合规审核、日常生活短视频解析、多语言歌曲逐段理解、BBC 音频理解、歌词字幕生成、音视频 Vibe Coding 与语音克隆等场景。Model Studio 支持离线调用和实时调用两种模式,实时模式模型名为 qwen3.5-omni-plus-realtime,并可通过 enable_search 参数开启联网搜索。
阿里 Qwen 团队发布 Qwen3.5-Omni,定位为向原生全模态 AGI 扩展的模型,旗舰版本 Qwen3.5-Plus-Omni 可通过阿里云 Model Studio 调用。官方演示覆盖视频合规审核、日常生活短视频解析、多语言歌曲逐段理解、BBC 音频理解、歌词字幕生成、音视频 Vibe Coding 与语音克隆等场景。Model Studio 支持离线调用和实时调用两种模式,实时模式模型名为 qwen3.5-omni-plus-realtime,并可通过 enable search 参数开启联网搜索。
匹配字段摘要
Runway 宣布与 Modal 合作,由 Modal 的无服务器计算平台为 Runway Characters 提供实时推理支持。Runway Characters 是基于通用世界模型 GWM-1 的实时视频智能体 API,可从单张图片生成数字人形象且无需微调,已服务财富 10 强科技公司、好莱坞制片厂等数千家机构。借助 Modal,Runway 团队在 30 天内从概念验证推进到生产环境,并通过一行代码将容器扩展为支持 RDMA 网络的多节点 GPU 集群。
匹配字段摘要
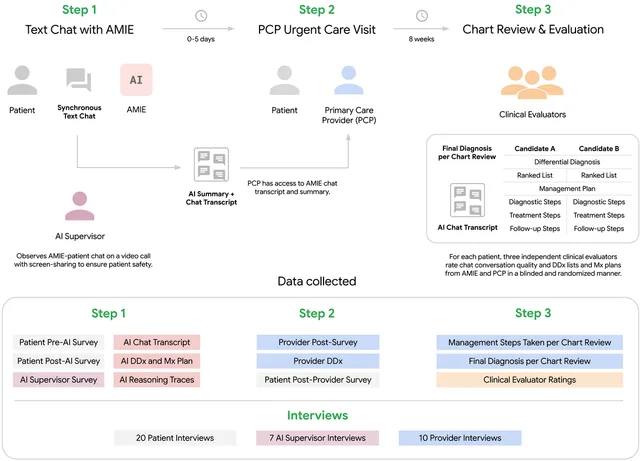
Google Research 与 Beth Israel Deaconess Medical Center 合作开展了一项前瞻性单中心可行性研究,让对话式医疗 AI AMIE 在门诊就诊前与患者进行病史采集对话,全程由医生通过视频实时监督。研究纳入 100 名成年患者,98 人完成后续就诊,全程未触发任何安全暂停;盲评显示 AMIE 与初级保健医生在鉴别诊断和管理计划整体质量上相当,但医生在管理计划的实用性和成本效益上更优。AMIE 的鉴别诊断在 90% 病例中覆盖最终诊断,56% 病例将其列为最可能诊断,患者对 AI 的信任度在交互后显著提升。
匹配字段摘要
Replit 宣布完成 4 亿美元融资,估值达 90 亿美元,较六个月前增长 3 倍,投资方包括 Georgian、G Squared、a16z、Coatue、YC 及卡塔尔投资局等。公司称其用户覆盖 85% 的财富 500 强企业,并计划在 2026 年底前达到 10 亿美元年化收入。同时 Replit 发布 Agent 4,速度比 Agent 3 快 10 倍,围绕自由设计、统一项目内产出应用与幻灯片视频、团队任务管理、多 Agent 并行四个方向组织,新资金将用于欧洲、亚洲和中东的全球扩张及产品与基础设施投入。

匹配字段摘要
我们为模型开发了一套记忆系统,同时提供短期视觉记忆和长期语义记忆。 我们的方法让我们能够训练机器人执行长时间、复杂的任务,比如清理厨房或从头制作烤奶酪三明治 👇 没有记忆,机器人在许多真实场景中会陷入困境,比如反复犯同样的错误、卡住或失去时间感。 但我们不能直接把几分钟甚至几小时的视频塞进模型的上下文——那很快就会变得不可处理。 为此,我们开发了多尺度具身记忆(MEM)。核心思路:用不同模态在不同时间尺度上表示记忆。 📹 对于短时程记忆,我们开发了一个高效的视频编码器,让模型记住近期交互中的细粒度细节。 📜 对于长时程记忆,我们训练模型用文本总结事件,使其能记住长达 15 分钟的事件。 借助 MEM,我们的模型可以在真实世界中执行真正的多阶段任务,比如清理整个厨房或准备食谱所需的食材。视频展示了机器人如何用文本跟踪长时程记忆。 除了解决新任务,记忆还让我们的策略更加鲁棒:我们展示了上下文适应的早期迹象,机器人通过从过去的错误中学习,实时调整自己的行为。 更多内容,请查看 我们的论文:https://t.co/xQLvOwko0m 我们的博客文章:https://t.co/tjJO4D6MYP
我们为模型开发了一套记忆系统,同时提供短期视觉记忆和长期语义记忆。 我们的方法让我们能够训练机器人执行长时间、复杂的任务,比如清理厨房或从头制作烤奶酪三明治 👇 没有记忆,机器人在许多真实场景中会陷入困境,比如反复犯同样的错误、卡住或失去时间感。 但我们不能直接把几分钟甚至几小时的视频塞进模型的上下文——那很快就会变得不可处理。 为此,我们开发了多尺度具身记忆(MEM)。核心思路:用不同模态在不同时间尺度上表示记忆。 📹 对于短时程记忆,我们开发了一个高效的视频编码器,让模型记住近期交互中的细粒度细节。 📜 对于长时程记忆,我们训练模型用文本总结事件,使其能记住长达 15 分钟的事件。 借助 MEM,我们的模型可以在真实世界中执行真正的多阶段任务,比如清理整个厨房或准备食谱所需的食材。视频展示了机器人如何用文本跟踪长时程记忆。 除了解决新任务,记忆还让我们的策略更加鲁棒:我们展示了上下文适应的早期迹象,机器人通过从过去的错误中学习,实时调整自己的行为。 更多内容,请查看 我们的论文:https://t.co/xQLvOwko0m 我们的博客文章:https://t.co/tjJO4D6
匹配字段摘要
Physical Intelligence 开发了 Multi-Scale Embodied Memory(MEM)记忆系统,为模型同时提供短期视觉记忆和长期语义记忆。短期记忆用高效视频编码器记住近期交互的细节,长期记忆则让模型用文本总结事件,最长可记住 15 分钟的内容。该记忆系统让机器人能完成清理整个厨房、按食谱备料等多阶段真实任务,并展现出从过去错误中即时调整行为的上下文适应迹象。
匹配字段摘要
为此,我们开发了多尺度具身记忆(MEM)。核心思路:用不同模态表示不同时间尺度上的记忆。 📹 对于短时程记忆,我们开发了一个高效的视频编码器,让模型能记住近期交互中的细粒度细节。 📜 对于长时程记忆,我们训练模型用文本总结事件,使其能记住长达 15 分钟的事件。
为此,我们开发了多尺度具身记忆(MEM)。核心思路:用不同模态表示不同时间尺度上的记忆。 📹 对于短时程记忆,我们开发了一个高效的视频编码器,让模型能记住近期交互中的细粒度细节。 📜 对于长时程记忆,我们训练模型用文本总结事件,使其能记住长达 15 分钟的事件。
匹配字段摘要
没有记忆,机器人在许多真实场景中会陷入困境,比如反复以同样的方式失败、卡住或失去时间感。 但我们不能只是把几分钟甚至几小时的视频塞进模型的上下文——那很快就会变得难以处理。 https://t.co/VwgdCwaMiN
没有记忆,机器人在许多真实场景中会陷入困境,比如反复以同样的方式失败、卡住或失去时间感。 但我们不能只是把几分钟甚至几小时的视频塞进模型的上下文——那很快就会变得难以处理。 https://t.co/VwgdCwaMiN
匹配字段摘要
Physical Intelligence 为自家模型开发了多尺度具身记忆系统 MEM,用不同模态表示不同时间尺度的记忆。短期记忆由高效视频编码器保留近期交互的细粒度细节,长期记忆则通过训练模型用文本总结事件,最长可记住 15 分钟。该系统让机器人能完成清理整个厨房、从头准备烤奶酪三明治等多阶段真实任务,并展现出从过往错误中即时调整行为的上下文适应迹象。
匹配字段摘要
Sarvam AI 推出 Sarvam Studio,一个将语音、文本和文档工作流整合到单一工作区的多语言内容转换平台,支持 AI 视频配音和智能体文档翻译。在约 280 次与 ElevenLabs、YouTube Dub、Rask AI 等平台的盲测对比中,Sarvam 的配音输出获得最强整体偏好,说话人相似度平均得分 0.88,为研究中最高。该平台目前正通过受控早期 beta 计划向政府、教育、媒体和出版领域的少量生产合作伙伴逐步开放。

匹配字段摘要
自动驾驶将比其他任何事物更快实现现实世界影响。真正酷的部分是,世界模型不只是关于视频;它是关于对各类连续、高维、含噪信号的建模。这才是"多模态"的真正含义。祝贺 @maxjiang93、xander、bo 以及整个 Waymo 团队 👏
匹配字段摘要
千问发布 Qwen3-VL-Embedding 与 Qwen3-VL-Reranker 系列模型,基于 Qwen3-VL 底座,面向多模态信息检索与跨模态理解,支持文本、图像、截图和视频输入,覆盖 30 多种语言。Embedding 采用双塔架构做高效初筛,Reranker 采用单塔 Cross-Attention 对(Query, Document)对联合编码输出相关性分数,两者串联构成两阶段检索流程。官方称 Qwen3-VL-Embedding-8B 在 MMEB-v2 上取得 SOTA,Reranker-8B 在多数任务上表现最佳,模型提供 2B 与 8B 两种规格、32K 序列长度并支持量化与自定义向量维度。
匹配字段摘要
所有视频均为自主运行。我们还测试了"从零"训练(从 VLM 初始化),但所有任务都失败了,这表明微调我们的模型对成功至关重要。 更多内容,请查看我们的博客文章:https://t.co/wrmtci8pUK
所有视频均为自主运行。我们还测试了"从零"训练(从 VLM 初始化),但所有任务都失败了,这表明微调我们的模型对成功至关重要。 更多内容,请查看我们的博客文章:https://t.co/wrmtci8pUK
匹配字段摘要
NVIDIA Nemotron Nano 2 VL 开源视觉语言模型发布,面向视频理解与文档智能,并获 vLLM 推理支持。模型采用混合 Transformer–Mamba 架构,通过 EVS 剪除冗余视频帧以减少 token。vLLM 夜间版本支持以 BF16、FP8 和 FP4 精度部署 OpenAI 兼容的推理服务器。
匹配字段摘要
Qwen3-VL 已在 Ollama 云端上线,本地版本将很快提供。该模型支持操作 PC 和手机 GUI 的视觉智能体、从图像和视频生成 Draw.io/HTML/CSS/JS、原生 256K 上下文并可扩展至 1M,OCR 语言从 19 种增至 32 种。Ollama 同时给出 JavaScript、Python 库及 OpenAI 兼容 API 的调用方式。
匹配字段摘要
Ethan Mollick认为,AI正从需要人类共同塑造过程的协作伙伴,转变为可自主规划并在数分钟内交付复杂成果、但过程不透明的“巫师”。NotebookLM、GPT-5 Pro和Claude 4.1 Opus在视频生成、论文分析和文件处理测试中表现出色,仅出现少量问题。用户因此需要学会判断何时使用智能体、核验其输出,并在无法完全验证时采用与用途相称的暂定信任。
Ethan Mollick认为,AI正从需要人类共同塑造过程的协作伙伴,转变为可自主规划并在数分钟内交付复杂成果、但过程不透明的“巫师”。NotebookLM、GPT-5 Pro和Claude 4.1 Opus在视频生成、论文分析和文件处理测试中表现出色,仅出现少量问题。用户因此需要学会判断何时使用智能体、核验其输出,并在无法完全验证时采用与用途相称的暂定信任。 · Ethan Mollick argues that AI is shifting from a collaborative partner whose process humans help shape into a “wizard” that autonomously plans and delivers complex results within minutes while keeping its process opaque. NotebookLM, GPT-5 Pro, and Claude 4.1 Opus performed strongly in his tests involving video gene
匹配字段摘要
TikTok 幻灯片在应用的照片模式中制作,每张图片按所选音乐自动定时切换。制作时依次点击“+”和 Templates,选择模板、上传照片,再添加音乐、滤镜和文字,即可发布。照片需为 JPEG 或 PNG 格式且至少 1080x1080 像素;若想更精细地控制时间与文字,可用 Descript 将其做成视频。
匹配字段摘要、正文