←搜索结果

按匹配度 · 共 1375 条结果 清除搜索

星期六

  1. 虎嗅

    史无前例的万亿投资,赢家只有英伟达?

    虎嗅梳理全球AIDC建设潮,指出2026年合计算力投资预计达8300亿美元、同比增长79%,但截至2026年7月英伟达Grace Blackwell产能超95%尚未投用。业内共识是巨头资本开支约六成以上对应明确客户,其余三至四成属于提前抢产能。文章以CoreWeave二季度收入25.75亿美元、净亏6.26亿美元等案例说明,单园区收入覆盖成本、利用率与租价稳定、后续融资续上这三个条件目前都未被普遍验证,确定的赢家可能只有卖设备的英伟达。

    500亿美元,年底的目标是700亿。这两条收入曲线,是这轮算力订单最直接的支撑。 但两家都还在亏。Anthropic 上半年的净亏损是807亿美元,其中约720亿来自可转债的账面计价,同期算力开销约90亿美元。收入在涨,亏损也在涨。差别在于,收入是客户付进来的钱,亏损里有很大一块只是会计处理。需求真实,不等于这门生意已经赚钱。 梁文锋在一次投资人交流会上说,DeepSeek 的 API 定价锚在“从市场上买一批设备回来,十个月收回成本”,对应大约六倍利润。 麦肯锡去年初预测,2025到2030年全球算力需求将增长350%,AI 负载占数据中心总负载的比例过半,从今年的实际情况看,这个预测甚至偏保守。 这种需求的短缺也传导至整个供应链。先缺高端 GPU,接着暴露存储和光通信缺口,光芯片的掺杂材料铥、镱、铒都成了瓶颈;光通信的市场规模因为这一轮需求短期放大了约十倍。变压器要等四年,并网排队更久。云厂商于是提前下单,GPU 厂商提前锁 HBM 和先进封装,一路传到上游材料和多层 PCB,每个环节都多备一点货。 按照现在的需求预计,加上两年内看得见的订单,这轮建设潮短期内停不下来。 谁已经赚到

    匹配字段正文

  2. Latent Space精选

    月之暗面发布 Kimi K3.1 Pro:2.8T 总参数、104B 激活参数,权重定于 11 月 4 日开放

    月之暗面发布 Kimi K3.1 Pro,这是一款多模态 MoE 模型,总参数 2.8T、激活参数 104B,上下文窗口 100 万 token,标准版与 Highspeed 版已上线 Kimi 网站、App、Kimi Work、Kimi Code 和 API,官方称 Highspeed 输出速度提升 2–3 倍、价格为标准版两倍。Artificial Analysis 将其排在 Intelligence Index 第四位、得分 55,落后 Opus 5.5 的 58;Arena 的 Code Arena WebDev 排名第 8、1692 分,较 K3 上升九位。标准版定价为每百万 token 输入 2 美元、输出 10 美元、缓存输入 0.2 美元,较 K3 下降三分之一;权重尚未发布,官方承诺 11 月 4 日开放。

    。@natolambert,@simonw Arena 的独立偏好评估提供了一个互补但范围更窄的图景: WebDev:第 8 名,1,692 分,而 K3 为第 17 名、1,655 分。 品牌与营销:第 7 名,较第 9 名上升。 模拟:第 9 名,较第 20 名上升。 Arena 表示,它在所有类别上均有提升,发布后将成为其排名最高的开源权重模型,超过 DeepSeek V4.1 Flash。 在这些设置下,它大致与 Opus 5 Max 相当,未必能与更新的 Opus 5.5 相比。@arena 另一项独立汇总基于已发布的基准测试,给出了 164.7 的初步 ECI,90% 自助法区间较宽,为 152.5–169.0。发布者随后提出 160–165 为合理区间。这是一个不确定的汇总结果,而非另一套独立执行的任务套件。@scaling01,@scaling01 预测与结果的逆转值得注意。测试前,@teortaxesTex 预测 AA 52、Vals 65、CritPt V2 76、Terminal-Bench 4.0 49、WeirdML V3 官方约 20/最佳 28,以及 EC

    匹配字段正文

  3. Arena精选

    Kimi K3.1 Pro 发布,Code Arena WebDev 升至第 8

    月之暗面发布 Kimi K3.1 Pro,在 Code Arena WebDev 以 1692 分位列第 8,与 Claude Opus-5 (Max) 持平而成本低 70%,较 Kimi K3 (Max) 的第 17 名提升 9 位。该模型定价为每百万输入/输出 token 2/10 美元,单任务成本中位数 1.23 美元,比 Kimi K3 低 29%,并将在 11 月 4 日开放权重。Kimi 官方称其为 3T 级开源权重模型,具备 1M token 上下文、2.8T 总参数/104B 激活参数的 MoE 多模态架构,幻觉率下降 65%。

    ! 该模型刚刚以 1692 分在 Code Arena: WebDev 中位列第 8,与 Claude Opus-5 (Max) 持平,而成本低 70%。相比以 1655 分位列第 17 的 Kimi K3 (Max),这提升了 9 位(+37 分)。 Kimi K3.1 Pro 在所有类别上均较 Kimi K3 有所提升。亮点:- 品牌与营销排名第 7(从第 9 上升)- 模拟排名第 9(从第 20 上升) 成本效率也是一项升级。Kimi K3.1 Pro (Max) 定价为每百万输入/输出 token 2/10 美元,单任务成本中位数为 1.23 美元(比 Kimi K3 低 29%)。请在推文串中查看其相对于帕累托前沿的位置。 随着开放权重即将发布,Kimi K3.1 Pro 将成为 Code Arena: WebDev 中新的第 1 开源模型,超越 DeepSeek-v4.1-Flash。敬请期待! 请在下方推文串中查看 @Kimi Moonshot 按实验室的排名,以及 Kimi K3.1 Pro 的 3D 生成结果。 热烈祝贺 @Kimi Moonshot 团队发布此模型!

    匹配字段正文

  4. Nathan Lambert精选

    Kimi K3.1 以 3.1 Pro 名义发布,基准成绩领先当前开源权重模型

    Kimi K3.1 以 3.1 Pro 的名义发布,Nathan Lambert 认为其基准分数明显是当前最强的开源权重模型,前提是权重按官方所称在 11 月 4 日前放出。Kimi 团队明确谈到网络风险,并试图把控开源权重网络能力的前沿、使其相对闭源前沿保持克制。K3.1 每 token 价格低于 K3,但博客中部分基准显示它每次回答消耗的 token 明显更多,实际价格可能相近。

    Kimi K3.1 以 3.1 Pro 的名义发布。如果权重如他们所承诺的那样在 11 月 4 日前放出,其基准成绩看起来显然就是当前最强的开源权重模型。这些成绩非常令人印象深刻。 Kimi 团队就网络风险发表了非常明确的声明,并试图把控开源权重网络能力的前沿节奏,相对于闭源前沿加以节制。 在模型如何经受住氛围测试方面还有很多值得了解的地方,但在过去几年里,Moonshot 团队的 kimi 模型很少失手。K3.1 每 token 的价格也低于 K3,但博客中的一些基准显示它每次回答消耗的 token 明显更多,所以实际价格可能大致相同。 这一点,加上所有网络相关的新闻,以及即将推出更大规模 GLM 模型的传闻,让我们对今年余下的时间充满期待!Pro 这个名字让我觉得 Kimi 很快也会推出 flash 模型,类似于 DeepSeek 和 GLM。

    匹配字段正文

  5. Moonshot AI · Kimi Blog精选

    月之暗面发布 Kimi K3.1 Pro:3T 级开源权重模型,100 万 token 上下文

    月之暗面发布 Kimi K3.1 Pro,这是 K3.1 系列首个模型,也是其迄今最强的 3T 级开源权重模型,上下文窗口为 100 万 token,同时推出速度提升 2-3 倍的 Kimi K3.1 Pro Highspeed。该模型已在 Kimi.com、Kimi Work、Kimi Code 和 Kimi API 上线,完整模型权重将于 11 月 4 日发布。在 Terminal-Bench 4.0 上,K3.1 Pro 得分 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;在内部基准 Kimi Code Bench 3.0 Long-horizon 上得分为 61.2%,高于 K3 的 55.95%。

    Benchmark results for Kimi K3.1 Pro and peer models across 14 coding, science, and knowledge-work evaluations

    Kimi Business”为您的团队订阅。 基准测试 脚注 除非另有说明,下文报告的所有 Kimi K3.1 Pro 结果均在推理强度设为“max”、temperature = 1.0、top-p = 0.95 的条件下获得。 编程基准测试 Terminal-Bench 4.0。Kimi K3.1 Pro 使用 Claude-Code 测试框架进行评估。DeepSeek-V4.1-Flash-1017 的数据取自其发布博客(https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017)。其余所有分数均取其在博客文章或官方 Terminal-Bench 4.0 排行榜(https://www.tbench.ai/). Terminal-Bench Science 0.1。Kimi K3.1 Pro 使用 Claude-Code 测试框架进行评估。我们对 DeepSeek-V4.1-Flash-1017 的内部评估得分为 9.3;不过,较早版本 DeepSeek-V4.1-Flash 在官方 Terminal-Bench Sci

    匹配字段正文

星期五

  1. 邵猛

    Coding Agent 榜单升级 v2.0:Claude Opus 5.5 以 61.7 领跑

    Artificial Analysis 发布 Coding Agent Index v2.0,用 Cognition 的 FrontierCode v1.1 替换 DeepSWE,并收紧仓库问答评分,榜单评的是模型加 harness 组合。当前第一是 Claude Code + Claude Opus 5.5(max)61.7,其后为 Claude Code + Sonnet 5.5 的 59.3 和 Muse Code + Muse Wonder Full 的 58.9,首个 OpenAI 组合 Codex + GPT-6 Astra 为 54.7。同一批 21 个配置在新旧榜单上均值从 54.8 降至 47.4,20 个下降,主因是 FrontierCode 均值约 45.1%,远低于 DeepSWE 的 65.6%。

    x)58.9 · Claude Code + Fable 5.1(max + fallback)57.6 前四相差仅约 4.1 分,其中三席是 Claude Code。首个 OpenAI 组合是 Codex + GPT-6 Astra,54.7。 FrontierCode 单项(Opus 拉开差距处): · Opus 5.5:56.0% · Codex + DeepSeek V4.1 Flash:52.6% · Codex + GPT-6.1 Sol:49.4% · Codex + GPT-6 Astra:49.3% 其余 24 个配置里有 15 个挤在 43%–49% 仓库问答(SWE-Atlas-QnA-AA)前几名: · Muse Wonder Full:68.8% · Claude Fable 5.1:66.4% · Opus 5.5:65.9% · Sonnet 5.5:64.2% 同一批 21 个配置在新旧 Index 上对比:均值从 54.8 → 47.4,20/21 下降;主因是 FrontierCode 均值约 45.1%,远低于 DeepSWE 的 65.6%;问答

    匹配字段正文

  2. 邵猛

    SkyRL 将 GLM-5.3-Flash 训练上下文扩至 100 万 token

    SkyRL 通过四类系统优化,在 B200 上把 GLM-5.3-Flash 的单序列训练长度做到 100 万 token,峰值约 144.5 GiB,约为开箱 Megatron 基线的 64 倍。优化包括让 DSA 跑在稀疏核上、按 query 分块并按 TP 分片 indexer、整层激活重算与层输入 CPU offload、去掉多余 fp32 升精度。真实书籍数据下 512k 峰值约 122 GiB,1M(CP=4)约 109 GiB,trainer 与 vLLM 的 logprob 平均绝对差约 0.04–0.07。

    是堆并行,还包括:让稀疏注意力真的跑在稀疏核上、切碎并分片二次复杂度的 indexer、激活重算与 CPU offload、以及去掉不必要的 fp32 升精度。 https://t.co/Z3E8qjKsZ8 模型与瓶颈 · GLM-5.3-Flash 是混合注意力:45 层里 34 层用 Kimi Delta Attention(线性注意力),11 层用 DeepSeek Sparse Attention(DSA)。只有 DSA 的代价随序列长度近似平方增长,决定了上下文上限。 · DSA 本身对每个 query 只读约 2048 个关键 key(注意力近似线性),但 indexer 要对每个 query 给全部「每 4 token 一池」打分,稀疏注意力的二次成本被挪到了 indexer。 四块优化 1. DSA 真稀疏 · 问题:Megatron 融合稀疏核只认 DeepSeek-V3.2 的张量形状;Flash 版 DSA 无位置编码(NoPE)、维度更窄,且选 2051 而非 2048 个 key。内核静默拒掉后回退到全量稠密注意力。其他优化都开着时,16k 就要约 114

    匹配字段正文

  3. 钛媒体 · AGI

    旧金山AI创投数据包装:6美分买GitHub星标,两周订单年化成全年ARR

    钛媒体AGI梳理旧金山AI创投圈的数据包装手法,包括把两周300万美元订单乘以26对外称约8000万美元ARR、初创公司之间互签500万美元意向书,以及以6美分一个的价格购买GitHub星标。文章还提到这类做法在大型模型实验室和算力中心圈子中同样存在,并引用业内人士称上一家靠互换发票吹出2.2亿美元营收的公司已经破产。

    者吗?并非如此。在某种程度上,VC也参与了这种数据包装的循环。很多投资机构内部也有KPI压力,基金经理需要快速投出明星项目、推高账面回报,才能在下一期基金向LP(出资人)募资。于是,创业者用包装过的数据争取高估值,VC用高估值项目向LP展示回报,LP再指望下一轮接盘。这完全是一场击鼓传花式的循环。 结语:回归常识,拒绝为泡沫买单 旧金山科技圈正在经历的这场“数字大跃进”,像极了2000年互联网泡沫破裂前夕的荒诞岁月。 当时的初创公司,只要在名字里加个“.com”就能股价翻倍;现在的AI初创,只要把两周的订单乘以26,就能自称下一个OpenAI。 对于普通创业者和从业者来说,更稳妥的选择是:不要参与这个循环,不要成为虚报数据的共同参与者。 真正伟大的公司,其核心财务模型永远是简单的:实实在在的营收,减去低于营收的成本,剩下真实的利润。无论是OpenAI还是DeepSeek,在剥离了所有花哨的包装后,拼的依然是算法效率与真实的商业变现能力。 当泡沫破裂时,你会发现,最靠谱的护城河,永远不是花6美分买来的星标,也不是那些互相换来的合同,而是那些愿意在毫无泡沫的寒冬里,为你真实产品买单的客户。

    匹配字段正文

  4. 澎湃新闻

    MiniMax开源M3.1 Flash模型,使用成本降低70%

    MiniMax于10月23日宣布开源M3.1 Flash模型,该模型上线72小时处理超过100万亿Token。相较上一代M3,M3.1 Flash能力全面提升,使用成本降低70%,线上推理速度提升近3倍。MiniMax称将携手华为昇腾、NVIDIA、AMD等芯片厂商及vLLM、SGLang、Hugging Face等推理框架与社区推进开源首日接入。

    下载客户端 +1MiniMax开源M3.1 Flash,“Flash”模型为何成为AI新潮流?澎湃新闻记者 范佳来2026-10-23 13:14来源:澎湃新闻 ∙ 10%公司 听全文字号 国产大模型又卷起来了——在DeepSeek官宣上新后,大模型企业MiniMax也紧随其后宣布更新。 10月23日,澎湃新闻记者获悉,MiniMax(稀宇科技)宣布开源M3.1 Flash模型,该模型上线72小时处理超过100万亿Token。 相较于上一代M3模型,M3.1 Flash模型能力实现全面提升,使用成本降低70%。通过全模型稀疏注意力、量化感知训练,和Power-aware scheduling等优化工作,模型线上推理速度提升了近3倍。 MiniMax表示,将携手华为昇腾、平头哥、昆仑芯、摩尔线程、NVIDIA、AMD等海内外芯片厂商,以及Together AI、Fireworks、Nebius等推理和云服务平台,共同推进M3.1Flash的开源首日接入。此外,vLLM、SGLang、智源FlagOS和Hugging Face、魔搭等推理框架与开源社区,也将与MiniMax共同推动模型在不

    匹配字段正文

  5. IT之家·人工智能

    中国信通院报告:2026 年国内大模型均价翻倍,每秒吞吐量也翻倍

    中国信通院等机构联合发布的《大模型词元服务性能监测报告(2026 年)》显示,2026 年 8 月国内模型平均 TPS 达 78.23,较 2025 年均值 38.25 翻倍,但国外典型模型同期为 112.82,仍高于国内。国内词元服务归一化均价从 2025 下半年的 6.8 元涨至 13.46 元,涨幅接近 1 倍;2026 年 6 月国内词元日均消耗量约 500 万亿,是 2025 年 12 月的近 4 倍。被监测模型中上下文长度达 1M 的占比 47.8%,200K 及以上合计达 95.7%。

    越来越多的 MaaS(Model as a Service,模型即服务)平台厂商通过公有云 API 方式供给大模型词元服务。然而用户对词元服务性能缺乏直观的判断依据,且面临选型困难等各类问题。 报告基于 2026 年 1-8 月的监测数据,围绕各平台词元服务调用成功率、吞吐速度、首词时延、稳定性、价格、上下文窗口等维度开展分析,对比原厂大模型官方平台,以及 DeepSeek、Qwen、GLM、Kimi 四款开源模型在第三方平台上的性能差异,进一步分析影响词元服务性能的关键因素,总结产业核心观察,明确下一步工作计划,旨在为用户选型提供参考,并为产业界优化服务能力提供方向指引。 1. 国内词元服务每秒吞吐量较 2025 年翻倍,仍低于国外 报告提出,8 月份国内各模型平均 TPS(每秒输出词元数)达到 78.23(个 / 秒),与 2025 年均值 38.25(个 / 秒)相比实现翻倍。但 8 月份国外典型模型的 TPS 均值为 112.82(个 / 秒),与 2025 年 12 月的 51.35(个 / 秒)相比,提升亦超过一倍,整体优于国内。 所有大模型词元服务月均 TPS 2. 词元

    匹配字段正文

  6. 凤凰科技

    微软推出 AI 诊断系统 MAI-DxO,复杂病例准确率达 83%

    微软宣布推出 AI 诊断系统 Microsoft AI Diagnostic Orchestrator(MAI-DxO),通过编排多个 AI 智能体模拟医生专家联合会诊。在基于 MIMIC-IV-ED 数据集的美国急诊科常见病例评估中,其诊断准确率为人类医生的 1.7 倍;在基于《新英格兰医学杂志》复杂病例的模拟评估中准确率达 83%,而可独立查阅资料的基层全科医生及普通内科医生为 36%,专科医生未纳入对照。官方称该系统所需成本仅为医生的一半甚至三分之一,研究成果已发表在《科学》期刊。

    及普通内科医生的准确率仅为 36%。 值得注意的是,此类复杂病例在现实临床中通常交由专科专家或多学科医疗团队协作诊治,而这部分专科医生并未纳入本次对照实验。 官方表示,该系统所需的成本仅为医生的一半甚至三分之一,能以更少的化验与诊疗操作精准锁定正确诊断。该项研究成果已正式发表在《科学》期刊。 微软针对 OpenAI、谷歌、Anthropic、Meta 以及 DeepSeek 等多家机构的模型对 MAI-DxO 进行了测试,其中表现最亮眼的当属 OpenAI 旗下的 GPT-5 及 GPT-5.5。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides i

    匹配字段正文

  7. IT之家·人工智能

    微软推出 AI 医疗诊断系统 MAI-DxO,复杂病例准确率达 83%

    微软宣布推出 AI 诊断系统 MAI-DxO(Microsoft AI Diagnostic Orchestrator),通过统一编排多个 AI 智能体模拟医生专家联合会诊。在基于 NEJM 复杂病例的模拟评估中,其诊断准确率达 83%,而可独立查阅参考资料的基层全科医生及普通内科医生为 36%;在基于 MIMIC-IV-ED 数据集评估美国急诊科常见就诊病例时,其准确率为人类医生的 1.7 倍。官方称该系统所需成本仅为医生的一半甚至三分之一,研究成果已发表在《科学》期刊。

    strator,简称 DxO,通过统一编排多个 AI 智能体来模拟医生专家联合会诊的过程 —— 各智能体协同向患者问诊、开具化验检查,并对潜在诊断展开深入研判与辩论。 而在基于《新英格兰医学杂志》(NEJM)复杂病例展开的模拟评估中,MAI-DxO 的诊断准确率高达 83%。相比之下,可独立查阅参考资料的基层全科医生及普通内科医生的准确率仅为 36%。 值得注意的是,此类复杂病例在现实临床中通常交由专科专家或多学科医疗团队协作诊治,而这部分专科医生并未纳入本次对照实验。 官方表示,该系统所需的成本仅为医生的一半甚至三分之一,能以更少的化验与诊疗操作精准锁定正确诊断。该项研究成果已正式发表在《科学》期刊。 微软针对 OpenAI、谷歌、Anthropic、Meta 以及 DeepSeek 等多家机构的模型对 MAI-DxO 进行了测试,其中表现最亮眼的当属 OpenAI 旗下的 GPT-5 及 GPT-5.5。 IT之家附论文链接: 广告声明:文内含有的对外跳转链接(包括不限于超链接、二维码、口令等形式),用于传递更多信息,节省甄选时间,结果仅供参考,IT之家包含外链的文章均包含本声明。

    匹配字段正文

  8. PyTorch Blog

    PyTorch 大会 2026 在圣何塞举行,公布 TorchTPU 与 TorchNeuron 等进展

    PyTorch Conference North America 2026 于 10 月 20–21 日在圣何塞举行,吸引 3500 多名参会者,聚焦加速开放智能及 PyTorch、vLLM、DeepSpeed、Ray、Helion、Safetensors 等项目。会上公布了 Google 与 Meta 合作的 TorchTPU 原生 PyTorch TPU 后端,以及面向 AWS Trainium 的 TorchNeuron 原生后端,后者于 10 月 20 日以 Apache 2.0 进入公开测试。Shopify 分享了用 PyTorch 与 vLLM 构建持续学习循环的案例,称其每天将生产故障压缩进模型权重,服务成本降低 96%。

    PyTorchCon community expo

    构建开放 AI 的研究人员、开发者和公司团结在一起。 “当更多的人、项目和组织开展合作时,开放系统的学习速度会更快,从而产生复合收益,”PyTorch 基金会执行董事 Mark Collier 表示。“开源生态系统让突破能够在组织之间传播,而不是被锁在一家公司内部。” Nebius 长期以来也一直为 vLLM 提供用于开发、测试和基准测试的计算资源,包括在 DeepSeek R1 等大型模型上的多节点工作。 Nscale 最初通过 Ray 进入 PyTorch 基金会的项目生态系统,Ray 是用于分布式计算和扩展 AI 工作负载的开源框架。在 Nscale 计划收购 Ray 背后的公司 Anyscale 之后,Nscale 已承诺继续投资 Ray 的开发及其贡献者社区,延续 Ray 自 2025 年 10 月加入基金会以来在基金会下的治理。 “大多数基础设施提供商将框架和数据中心视为两个独立的问题。我们则把它们视为一体。PyTorch 之所以一直是 AI 的基础层,是因为它保留了研究人员熟悉的 Pythonic 风格,同时在性能上认真发力。同样隶属于 PyTorch 基金会的 Ray

    匹配字段正文

星期四

  1. 邵猛

    斯坦福 CS 329Z 第 9 讲梳理 Agent 系统优化方法选型

    斯坦福 CS 329Z 课程第 9 讲给出 Agent 系统优化的选型图:优化前提是数据、系统、评估指标三者齐备,一般先做上下文优化(prompt 与 few-shots),因为便宜、快、省样本;当上下文优化不够用、想把能力蒸馏到小模型或 prompt 越写越长时再改权重。讲义还梳理了 OPRO、MIPROv2、TextGrad、GEPA 等反思式 prompt 优化方法,SFT、RL(PPO 与 GRPO 对比)、on-policy 蒸馏等权重优化路径,以及 Darwin Gödel Machine、Meta-Harness、karpathy 的 autoresearch 等让 agent 自我优化的做法,并指出 agent 已是不错的优化器,评估指标成为最需要把控的环节。

    迹微调 Llama2-13B,效果超过了直接 prompt 的 GPT-3.5。关键在于任务和环境要足够多样。 · RL:让学生模型自己跑任务,按任务是否完成给奖励,前提是结果可验证。讲义对比了 PPO 和 GRPO:PPO 要在内存中保留 4 个模型、每步训练 2 个;GRPO 只需 3 个、每步训练 1 个,优势值直接用组内奖励的 z-score 计算,DeepSeek-R1 用的就是 GRPO。 · On-policy 蒸馏:学生模型自己采样生成,教师逐 token 打分,好比“复盘自己下过的棋”。引用的 Thinking Machines 结果是,它比 RL 更高效,训出的模型也更好。 让 agent 自己做优化 · Darwin Gödel Machine:agent 修改自己的代码。选哪个版本当“父代”时,表现越好越优先,已有子代越多越靠后。消融实验显示,“自我修改”和“回到早期版本重新探索”这两点都不可或缺。 · Meta-Harness:让一个元 agent 看到全部历史经验,由它决定下一步改什么,逐步改出更好的 harness。 · autoresearch(karp

    匹配字段正文

  2. LMSYS Blog

    LMSYS 用 Miles 在 MI355X 上训练 SWE 智能体,SWE-bench Verified…

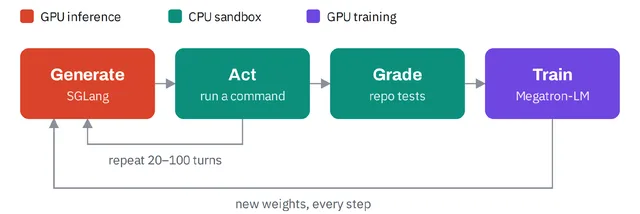
    LMSYS 用 Miles、SGLang、Megatron-LM 和 Harbor 在 AMD Instinct MI355X 上对 Qwen3-30B-A3B-Instruct 做全异步智能体强化学习,在 SWE-bench Verified 的 100 任务分层子集上把 pass@1 从 7.3% 提升到 27.5%。训练分两阶段,先在约 4,000 条 Open-SWE-Traces 公开轨迹上做 SFT,再在约 1,350 个 SWE-smith 任务上跑 GRPO。固定模型和 RL 配方后,推理从 1 个节点扩到 3 个 8 卡节点、改用 E2B 云沙箱并解除并发上限,rollout 吞吐从约 860 提升到约 3,480 条轨迹/小时;在同一 8 卡节点上限制轨迹长度则让单步训练时间从 850 秒降到 284 秒。

    Agentic RL loop: SGLang generates actions, a CPU sandbox executes and grades them, and Megatron-LM trains on the resulting trajectories.

    inct MI355X 上以全异步智能体强化学习训练了 Qwen3-30B-A3B-Instruct,使其在 SWE-bench Verified 的 100 任务分层子集上的 pass@1 分数几乎翻了两番,从 7.3% 提升到 27.5%。最大的瓶颈是长尾轨迹、CPU 沙箱和数据移动。我们分享了如何应对这些挑战以提升吞吐量并加速学习,其中的经验也适用于 DeepSeek-V4-Flash、GLM-5.3 和 Kimi K3 等更大的模型。 摘要 SWE-bench Verified 子集 pass@1:7.3% → 27.5%。 Qwen3-30B-A3B-Instruct,在 SFT 和智能体强化学习之后,于 100 个分层任务上评估,每个任务尝试 4 次。 rollout 吞吐量约提升 4 倍:约 860 → 约 3,480 条轨迹/小时。 模型和 RL 配方保持不变;推理从 1 个扩展到 3 个 8 卡 MI355X 节点,并配合云沙箱和并发修复。 RL 单步速度约提升 3 倍:850 秒 → 284 秒。 在同一 8 卡推理节点上限制轨迹长度可减少长尾。 384 个并发智能

    匹配字段正文

星期三

  1. Baseten Base Labs:模型研究精选

    Baseten Base Labs 发布决策模型 mammoth-1 与 elephant-1

    Baseten 旗下 Base Labs 发布两个决策模型 elephant-1(9B)和 mammoth-1(27B),均基于 Qwen3.5 全量微调,并公开模型权重。mammoth-1 在 Jev Decision Index 0.4 上以 71.24 分位列 208 个模型第一,领先第二名 Perplexity Decider v1.2 1.8 分;elephant-1 在该榜得 62.65 分,在 Artificial Analysis Decision Index 上以 65 分与 d1-ultra 并列第一。训练使用 6.21M 样本的第八版数据混合,并在全注意力层改用块双向注意力掩码,固定数据下该改动使公开 10k 样本得分从 44.8 升至 48.6。

    Max Kirkby

    pipeline (Figure 5). Note that all public data keeps the original labels and joins into the mix at the final stage. In brief, this pipeline first generates new examples using e.g. DeepSeek V4-Pro or GLM-5.3. To account for the fact that no single check will catch all corrupted or bad examples, we stack several checks together. These include: Label. We first label the correct/intended answer independently using either a panel of five judge models or deterministically (as above, in the case of a g

    匹配字段正文

  2. ChinaTalk精选

    中国商务部拟将AI模型纳入出口管制目录

    中国商务部和科技部于10月16日发布2026年第48号公告,拟在《中国禁止出口限制出口技术目录》中新增40项条目,其中14项为禁止出口、26项为限制出口,并即日起对全部新增技术实行出口前登记。草案对前沿模型设定≥10^26 FLOP、≥2T参数或达到全球领先水平三条门槛,同时覆盖AI芯片设计、存储芯片、万卡级集群、智能体、AIGC检测工具、训练数据和网络攻防能力;开源、自建海外数据中心、海外流片等场景可走即报即出通道。意见征集期至11月15日。

    for its capability. As of now, per Epoch AI, only four Chinese models since mid-2024 (Kimi K3, ERNIE 5.0, Qwen 3.8 Max, and Qwen3.8-2.4T-A95B) cross this threshold. No models from DeepSeek, Meituan, Xiaomi, or Z.ai exceed two trillion parameters, but all have models above or near one trillion parameters, and it is reasonable to expect their next releases to cross that threshold. As the Q&A clarified, the restriction does not cover tech that is already public via open weights or literature, so th

    匹配字段正文

  3. 36氪 · AI

    第一波AI生成的黄仁勋演唱会,UP主们已赚饱

    B站UP主用AI工具制作的“黄仁勋演唱会”视频点击近600万,黄仁勋穿黑皮衣唱《Beat It》,台下苏姿丰、奥尔特曼、库克、马斯克等科技大佬化身粉丝。UP主“胡萝卜须儿”用B站Updream、Qwen3和Seedance 2.0创作1分半的“元首演唱会”,Token成本300元,330万播放带来千余元流量分成并涨粉6000+。B站二季度财报称每月约1.9亿用户消费过AI相关内容,AI内容消费时长同比增长72%。

    的“黄仁勋演唱会”, 点击近600万。 这些AI演唱会,大多采用迈克尔·杰克逊的经典名曲《Beat It》+主角替换模式(即将迈克尔·杰克逊、替换成任一主角),来进行创意生成。 在黄仁勋舞台上,他穿着标志性的黑皮衣,从台下弹射入场,开始高歌Beat It。 图 | 库克成了黄仁勋的粉丝 台下粉丝群贤毕至,从华裔“芯片女王”苏姿丰、OpenAI创始人奥尔特曼、DeepSeek梁文锋,到苹果库克、马斯克等一众科技圈大佬,陆续化身迷弟迷妹,露脸尖叫。 再搭配上诸如“算力荒席卷全球,大厂乖乖等待”、“建算力中心靠我,钞票统统拿来”等紧跟行业热点、爆梗不断的歌词,把黄仁勋那种志得意满的情绪,捕捉地特别精准到位,既能娱乐大众,又让业内人士看了叫绝。 以至于马斯克都转发和评论,“这就是内存条为什么这么贵的原因”。网友则纷纷点赞,“连世界首富都看到了。” “胡萝卜须儿”坦言,自己不是这波风潮的首批发起者,但也想亲手试试自己的创作,能否接上这波流量。 于是,由他创作的“元首演唱会”AI版就这样上线了。画面中,科技圈大佬被一众海外历史人物替换,鬼畜风歌词,搭配Beat It的强劲节奏,也碰撞出别样火花。

    匹配字段正文

  4. 36氪 · AI

    开发者借Claude与Codex在红米、小米设备上移植iOS

    开发者dipa-studio开源项目ios-sweet在搭载骁龙732G的Redmi Note 10 Pro上引导运行了来自iPhone X的iOS 16.7.16系统组件,可进入桌面、操作设置和控制中心,并唤醒8个CPU核心。移植过程主要靠AI读报错日志、对比驱动源码并生成转接代码,Codex额度用尽后转由Claude接手。目前蜂窝网络、蓝牙、相机、音频均不可用,Metal图形接口未打通,开机等待约4分钟,且放宽了代码签名校验和沙盒限制。

    0/1000你可能也喜欢这些文章千元机,你快回来AI助听,正在拆掉医疗器械和消费电子之间的墙AI版“小天才”攻占幼儿园,半年猛销40万台现在的安克,会选择当年的阳萌吗?消费电子太无聊,连设计大师都想逃“不务正业”的江浙沪70后男人,狂赚老外2个亿看完禾赛战略级产品Kosmo,禾赛至少值1000亿?联想的AI转型是一场马拉松龙虾热退潮,无头MacBook仍在热卖蓝字计划特邀作者 记录智能时代的每一次浪潮!前沿科技捕手,AI产品深度洞察。发表文章161篇 最近内容当999元的红米亮起苹果logo,库克最担心的事情发生了1小时前年内第18次宕机,融资千亿的DeepSeek反而更脆弱了?2026-10-19花了几百亿美金,但扎克伯格的AI翻身仗栽在一盏灯上2026-10-14阅读更多内容,狠戳这里选靠谱AI,看真实评测查看36氪AI测评官方交流社区加入咨询项目审核和入驻联系36氪项目推荐订阅号关注 36氪欧洲站36氪欧洲站36氪欧洲站Ai产品日报网络谣言信息举报入口热门推荐 推送和解读前沿、有料的科技创投资讯 一级市场金融信息和系统服务提供商 聚焦全球优秀创业者,项目融资率接近97%,领跑行业

    匹配字段正文

  5. 半导体产业纵横

    东方算芯128卡3D芯片集群落地,年底冲刺千卡交付

    东方算芯在国芯展宣布128卡DF1000训练集群稳定运行并已实现大规模训练集群交付,计划年底实现千卡级集群交付。该集群连续训练72小时无中断,已承载Llama2-70B、Step 130B等模型训练任务,千亿参数级Step 130B仅用7天完成训练适配。DF1000采用3D堆叠近存计算,单芯片访存带宽6.4TB/s,从芯片设计、14nm晶圆制造到3D混合键合封装均在本土产业链完成闭环。

    式中,芯片、基础软件、集群系统往往分属不同厂商,跨架构、跨平台的适配要重复投入,每一代硬件升级都意味着全链路的重新适配。东方算芯的做法是从芯片架构到编译器、算子库、集合通信库、分布式训练框架再到集群调度与运维工具全部自研。资料显示,东方算芯全套自研了全栈自主CAAP软件栈,覆盖编译器、算子库、分布式通信库、训练框架与一站式开发工具,全面兼容主流深度学习框架,DeepSeek、千问、STEP等开源大模型可快速迁移部署,降低国产算力芯片落地适配成本。由于芯片、软件、集群出自同一支团队,每一代迭代不需要跨厂商重新适配,上一代积累的算子优化与调度策略可以直接复用到下一代产品。软件定义的架构属性放大了这种优势。传统AI芯片是硬件功能固化的,芯片流片时,支持哪些算子、什么数据通路就已经烧死在硅片里。而软件定义芯片硬件的Tile阵列和数据通路可以由软件配置,同一颗芯片通过不同的软件配置执行不同的计算结构。于是适配的重心从硬件挪到了软件层,对于新模型的适配,CAAP编译器只需把它映射成数据流图,在Tile阵列上展开执行,核心算子已被算子库覆盖,只需做增量优化。芯片换代后,硬件执行模式保持一致,上一代打

    匹配字段正文