←搜索结果

按匹配度 · 共 1620 条结果 清除搜索

星期六

  1. The Decoder

    报道称 Google Gemini 4 Carbon 编码性能对标 Anthropic Opus 5.5

    据 Business Insider 看到的文件、截图和内部聊天记录,Google 正在测试 Argon、Barium、Carbon 三个 Gemini 4 变体,其中 Carbon 已部署在内部编码平台 Jetski 上,据说在编程任务上强于 Argon。一名员工将 Carbon 与 Anthropic 最强的编码模型 Opus 5.5 相比,但表示仍需更多测试。Google 将模型角色划分为 Argon 负责前沿推理、Flash 负责速度与吞吐、Omni 负责生成式媒体、Gemma 负责轻量开源端侧,Carbon 和 Barium 可能是 Argon 家族内的检查点或更新。Gemini 4 尚无官方发布日期,Gemini 应用已出现 3 系列模型的 Automatic 模式和可调推理强度,Google AI Studio 也出现了 Ultra 模式。

    匹配字段标题、摘要
  2. Rohan Paul

    微软 CABRA 研究:编码智能体瓶颈在读懂代码而非改代码

    微软论文发现编码智能体在需要理解大量代码时出错,而非在大量编辑时出错,因此应以阅读和比较代码而非 diff 大小来评测。团队构建 CABRA 生成合成编码任务,每次只提升一种难度,用 8 个 LLM 和 6 个智能体跑了 6,840 个任务,并把每次工具调用标注为阅读、分析、搜索、编辑或测试。纯 LLM 随任务变难而变差,智能体靠 grep 等工具保持接近满分;在 SWE-bench Verified 上,阅读与分析调用次数比编辑行数更能预测智能体失败,相关系数为 -0.200 对 -0.159。

    匹配字段标题、摘要

星期五

  1. Moonshot AI · Kimi Blog精选

    月之暗面开源 Kimi K2.6,主打长程编码与 Agent Swarm

    月之暗面开源最新模型 Kimi K2.6,具备编码、长程执行和 Agent Swarm 能力,已上线 Kimi.com、Kimi App、API 和 Kimi Code。官方称其在长程编码任务上较 K2.5 明显提升,例如在 Mac 上用 Zig 实现并优化 Qwen3.5-0.8B 推理,经 4000+ 次工具调用、超 12 小时连续执行和 14 轮迭代,吞吐从约 15 tokens/sec 提升到约 193 tokens/sec。Agent Swarm 架构从 K2.5 的 100 个子智能体和 1500 步扩展到 300 个子智能体、4000 步并发执行,并新增 Claw Groups 研究预览。

    Kimi K2.6 hero visual

    匹配字段标题、摘要

  2. Databricks Blog

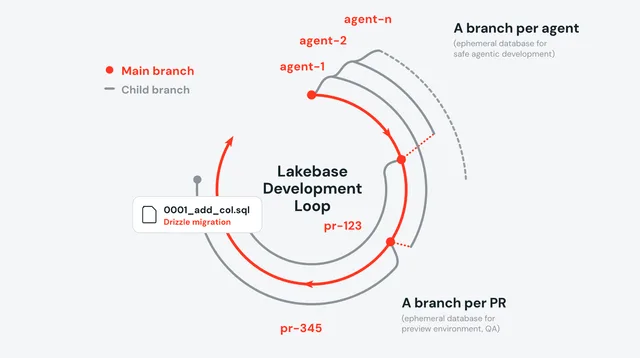
    Databricks 用 Lakebase 数据库分支为编码智能体提供隔离环境

    Databricks 介绍 Lakebase Postgres 的数据库分支能力,基于 copy-on-write 可在不到一秒内为任意大小的数据库创建分支,分支间数据共享、仅在分叉时占用额外存储,并支持 scale-to-zero。文章给出端到端开发闭环:Git worktree 配合 Claude Code 的 post-checkout hook 为每个智能体自动创建数据库分支,GitHub Actions 再为每个 PR 创建临时分支、运行 Drizzle 迁移、在 Databricks Apps 部署预览应用并生成 schema diff 评论。Lakebase 分支不会合并回父分支,schema 变更通过迁移工具提升到父分支。

    image4.png

    匹配字段标题

  3. The New Stack

    Harness 收购 Augment Code 的 Cosmos 软件工厂与编码智能体

    Harness 周四宣布收购 Augment Code 的 Cosmos 软件工厂、Auggie CLI 和 Code Context Engine 及其团队,金额未披露,Cosmos 将更名为 Harness Cosmos Software Factory Agent。Cosmos 通过 MCP 与 Harness 的交付历史、安全发现和软件交付知识图谱相连,可把需求或 bug 报告推进到 pull request,并在隔离 VM 中编写和测试代码。Harness 表示下游智能体在测试、安全或部署中发现的问题会带着上下文回传给 Cosmos 修复,目前通过工单流程运行,Agent Harness 的身份与策略整合仍在进行中。

    匹配字段标题

  4. MarkTechPost

    JetBrains 发布 Mellum2.1:面向编码智能体的 12B MoE 开源模型

    JetBrains 发布 Mellum2.1,一个面向编码智能体与快速子智能体的 12B MoE 思考模型,每 token 激活 2.5B 参数,以 Apache 2.0 许可在 Hugging Face 上发布。架构与 Mellum2 相同,升级几乎全部来自真实软件环境中的强化学习,模型可自行探索仓库、编辑文件并检查改动。基准上 SWE-bench Verified 从 2.0 升至 47.0,LiveCodeBench v6 得 82.0,但 SWE-bench Pro、GPQA Diamond 和 AIME 仍落后于 Qwen3.5-9B;GGUF 量化版本从 7.0 GB 起,可在 llama.cpp、Ollama 和 LM Studio 本地运行。

    匹配字段标题、摘要

星期四

  1. Tessl:产品与工程博客

    AI DevCon NYC:从编码智能体到软件工厂

    AI DevCon New York 将于 11 月 2–4 日在布鲁克林 Industry City 举行,主题是“软件工厂”:不只让单个编码智能体更强,而是构建让智能体开发可重复、可信、可扩展的系统。会议围绕上下文与技能、harness 与工具、编排、验证与评估、反馈与改进等层次展开,并设有企业规模化专场,Zalando 将分享覆盖 2,000 多名工程师的智能体工程实践。

    Patrick Debois

    匹配字段标题、摘要

  2. Satya Nadella精选

    微软为 Windows 引入本地智能体能力,发布 137B 参数编码模型 MAI-Code-1.1 Flash

    微软宣布为 Windows 带来不计量智能,让每台 PC 成为智能体可安全工作的场所。其中 MAI-Code-1.1 Flash 是 137B 参数、256K 上下文窗口的编码模型,已针对 PC 本地运行优化;GitHub Copilot 可将工作交接给该本地模型以降低成本。微软还推出 Hybrid Intelligence 让 Copilot 直接在 PC 上执行操作并保留敏感数据在本地,并通过 Code in Copilot 在桌面构建软件而无需云端 token 消耗;Windows 与 Agent 365 结合,提供 MXC 本地沙箱供智能体执行。相关能力将随搭载 NVIDIA RTX Spark 的 Surface Laptop Ultra 等新设备落地。

    匹配字段标题、摘要

星期二

  1. The Decoder

    Reflection 发布首款开放权重模型 Beam,主打低算力编码与推理

    AI 公司 Reflection 发布首款免费开放模型 Beam,面向编码、逻辑推理和智能体任务,采用 MoE 架构,每 token 激活 5010 亿总参数中的 230 亿。Reflection 称 Beam 在推理任务上可匹配 GLM 5.2,算力消耗仅为后者的三分之一到四分之一,并已用 10500 块 Nvidia GB300 GPU 进行超过四周的强化学习训练。模型权重将以 Apache 2.0 许可在本月晚些时候发布,目前早期版本仅向部分用户开放。

    匹配字段标题、摘要

  2. The Rundown AI

    Reflection AI 发布首款开源权重模型 Beam,主打编码与智能体

    估值 250 亿美元的 Reflection AI 发布首款开源权重模型 Beam,面向编码与智能体任务,公司称其以远低于中国实验室 Z.ai GLM-5.2 的算力达到相近的推理和编码成绩。Reflection 计划本月以 Apache 2.0 许可证放出 Beam 权重,允许企业自行定制和部署,并已在韩国测试由对冲基金或政府用自有芯片和私有数据运行 Beam 的 AI 工厂模式。在自家测试中 Beam 仍落后于 Moonshot 的 Kimi K3,但优于 Thinking Machines 的 Inkling 等美国开源系统。

    匹配字段标题、摘要

  3. AWS Machine Learning

    GLM 5.3 上线 Amazon Bedrock,753B MoE 模型面向编码与长程智能体任务

    Z.ai(智谱)的 GLM 5.3 已在 Amazon Bedrock 上线,据 Hugging Face Hub 发布信息,这是一个 753B 参数的 MoE 模型,面向编码和长程智能体任务优化。Bedrock 提供全托管 API,支持跨区域推理、提示词缓存和服务层级,目前面向符合条件的企业客户开放。相比 GLM 5,官方称其在 DeepSWE、Terminal Bench 3.0、FrontierSWE 等编码基准上有竞争力,并在 CyberGym 基准上测得 84.5 分。

    [Amazon Bedrock Playground screenshot showing chat interface with GLM 5.3 model explaining symmetric vs asymmetric encryption. Response includes detailed comparison with checkmarks and X marks highlighting key differences, examples like AES and RSA, a]

    匹配字段标题、摘要

  4. MarkTechPost

    Reflection AI 发布 Beam:501B 开源权重 MoE 模型,23B 激活参数面向编码与智能体任务

    Reflection AI 发布首款开源权重模型 Beam,采用稀疏 MoE 架构,总参数 501B、每 token 激活 23B,面向编码、推理与智能体工作负载。该模型预训练使用 23.8 万亿 token,在 6,144 块 NVIDIA GB300 NVL72 GPU 上不到 4 周完成,中训练将有效上下文扩展至 1M token;强化学习阶段用 10.5K 块 GB300 GPU 运行 4 周,生成超 1 亿次 rollout。Reflection 报告 Beam 在 SWE-bench Verified 得分 80.9、Terminal Bench v2.1 得分 80.1,目前处于最终红队测试阶段,通过 Reflection 平台候补名单提供早期访问,Apache 2.0 权重计划于本月晚些时候发布。

    匹配字段标题、摘要

  5. PyTorch Blog

    PyTorch 媒体处理生态演进:解码编码统一到 TorchCodec

    PyTorch 将图像、视频、音频的解码与编码能力统一收敛到 TorchCodec,TorchVision 和 TorchAudio 中相关 API 已弃用或移除,两者今后专注 transforms。TorchCodec 支持 CPU 与 CUDA,CUDA 视频解码性能普遍优于旧实现,并集中处理 FFmpeg 4 至 9 等依赖。三个库现已 ABI 稳定,不再绑定单一 PyTorch 版本。

    匹配字段标题、摘要

  6. AWS Machine Learning

    AWS 推出 aws-ai-ml 技能:为 Kiro、Claude Code、Codex 等编码智能体提供 SageMaker 推理优化能力

    Amazon SageMaker AI 优化生成式 AI 推理推出 aws-ai-ml 技能,通过 Agent Toolkit for AWS 提供给 Kiro、Claude Code、Codex 等编码智能体,使其能对端点做基准测试、推荐部署配置、对比性能并生成可执行的 SageMaker Python SDK v3 代码。该技能基于 Model Context Protocol(MCP),可在本地或 SageMaker Studio JupyterLab 空间安装,10 分钟即可开始使用。

    匹配字段标题、摘要

星期一

  1. Clément Delangue

    Hugging Face 把 Claude Code、Codex 等编码工具变成 RL 训练环境

    Hugging Face 的 Clément Delangue 宣布把 Claude Code、Codex、Hermes、Pi、opencode 等编码工具变成 RL 环境,不改动工具本身也不改动训练代码,全部开源。做法是用一个 capture proxy 伪装成模型 API,兼容 OpenAI Chat Completions、OpenAI Responses、Anthropic Messages、Gemini 四种格式,转发到 vLLM 并记录 token ID 与 logprobs,再交给 TRL 训练,目前已有 10 个工具接入且均未修改。在 LFM2.5-2.6B 上,单工具训练后 OpenCode 从 34% 提升到 58%,四工具同时训练后四者均提升(42% 到 54%),而用 Qwen3.8-27B 的 3,189 条 rollout 做 SFT 只停在 47.5%。

    匹配字段标题、摘要

  2. Together AI Blog

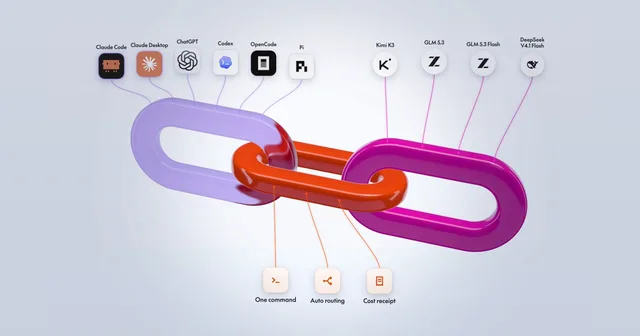
    Together AI 发布 Together Link,把开源模型接入现有编码智能体

    Together AI 发布 Together Link,可将团队已在使用的编码智能体接入其开源模型,官方称可降低超过 50% 的开销。该工具支持 Claude Code、Claude Desktop、Codex(ChatGPT 应用与 CLI)、OpenCode 和 Pi,设置与登录保持不变,一条命令即可切换回原生闭源模型。Auto 模式由 Together AI Router 按会话首个任务选模型,带 Anthropic key 时在 Opus 5.5 与 GLM 5.3 之间路由,否则在 GLM 5.3 与 GLM 5.3 Flash 之间路由,路由每会话只发生一次以保留 prompt caching,并按现有 Together API key 计费。

    匹配字段标题、摘要

星期六

  1. The Decoder

    马里兰大学与 AWS 提出 LEGO-Anything:编码智能体从单张照片生成可编辑 3D 场景

    马里兰大学与 AWS 的研究者提出 LEGO-Anything,让编码智能体接收单张图片后编写并迭代修改 Blender 代码,生成可运行、可编辑的 3D 场景程序。配套的 LEGO-Bench 包含 104 个室内外场景的 208 张图像和 443 个注册资产,从有效性、几何重建和外观三方面评分。测试中六种 GPT 配置几乎都能交付可用场景,但几何准确率差异很大,表现最好的 GPT-6 Astra 在室内场景为 53.4%、室外为 39.6%,较弱配置约 15%;研究者发现智能体在判断两个版本哪个更接近原图时准确率接近或低于随机水平,据此提出无需额外训练的 LEGO-Plugin,使较弱智能体提升最高达 62.7%。

    匹配字段标题、摘要

星期五

  1. MarkTechPost

    Google Research Kauldron 编码指南:纯数据配置、字符串连线组件与可通读的 JAX Trainer

    这篇教程实操 Google Research 的 JAX 训练库 Kauldron,重点演示三个机制:konfig 把实验变成可 JSON 往返的纯字典配置树,kontext 用字符串键路径连接互不感知的组件,typing 模块以命名轴在运行时校验数组形状。文中还自定义 loss 与 metric、用合成内存数据训练 Trainer,并跑了一个五变体 sweep 和断点续训。

    匹配字段标题

星期四

  1. 上观新闻

    谷歌发布 Gemini 4 Argon 模型,称编码与网络安全表现超越 OpenAI

    谷歌发布其最强 AI 模型的新版本 Gemini 4 Argon,称其在代码编写、企业业务、数理科学和网络安全的行业基准测试中达到顶尖水平,表现达到甚至超越 Anthropic 与 OpenAI。该模型的上下文窗口规模提升至原来的 16 倍,正通过顺风计划向部分企业与政府机构开放,用于识别并修复网络安全漏洞。谷歌还表示该模型对提示注入的抵御能力更强,并新增防止智能体脱离测试环境的安全防护机制。

    匹配字段标题

  2. Zyphra Research

    Zyphra 研究:混合 NoPE 模型如何在没有位置编码时学习位置

    Zyphra Research 发现,混合语言模型中滑动窗口注意力(SWA)和门控线性注意力等局部层会在残差流中自然形成近因偏置,使相邻 token 的表示比远距离 token 更相似;全局 NoPE 注意力的 query 和 key 投影随后学会读取这一结构,从而在无显式位置编码的注意力层中形成隐式相对位置编码。该机制解释了局部混合与全局 NoPE 注意力交错架构为何有效,并有望让位置表示自然外推到训练时未见过的序列长度。

    匹配字段标题、摘要