Goodfire 为 Kimi K3 与 GLM 5.3 训练并部署生产级网络安全监控器
Goodfire 为 Kimi K3 和 GLM 5.3 构建了基于探针的网络安全监控器,并部署在生产推理栈上,成本比逐轮调用 LLM judge 低约 50 倍。该级联方案在 5.5% 良性会话中断率下达到约 93% 召回率,每百万次交互成本低于 200 美元,且不增加推理延迟。在 FAR.AI 的静态越狱测试中,监控器将 140 种策略产生的通用越狱从 66 个降至 0 个。
匹配字段摘要
Goodfire 为 Kimi K3 和 GLM 5.3 构建了基于探针的网络安全监控器,并部署在生产推理栈上,成本比逐轮调用 LLM judge 低约 50 倍。该级联方案在 5.5% 良性会话中断率下达到约 93% 召回率,每百万次交互成本低于 200 美元,且不增加推理延迟。在 FAR.AI 的静态越狱测试中,监控器将 140 种策略产生的通用越狱从 66 个降至 0 个。
匹配字段摘要
Goodfire Research 发布与 Mayo Clinic 合作的研究,基于基因组基础模型 Evo 2 的嵌入训练轻量探针,在 839k 个 ClinVar 单核苷酸变异上取得 0.997 AUROC,并零样本泛化到短插入缺失(0.991 AUROC)。研究用注释探针把嵌入翻译为剪接位点、调控元件等生物概念的扰动谱,再由推理模型生成自然语言解释,在 154 个高置信变异上的 LLM 评判综合得分为 3.8/5。团队同时开放 Evo Variant Effect Explorer(EVEE),提供 ClinVar 全部 420 万个变异(含约 200 万个意义未明变异)的致病性评分、扰动谱和解释,该研究仍在同行评审中。
匹配字段摘要
Goodfire Research 开发了基于蛋白质模型嵌入向量的序列感知生物安全监控器,在自建双用途任务基准上超越前沿模型的防护机制,且拒绝率更低。该监控器对改写、片段化等新型对抗攻击更鲁棒,速度与数据库查找方法相当,并能随模型能力提升而扩展。Goodfire 正与前沿实验室和推理服务商合作部署该监控器。
匹配字段摘要
Standard Bots 用共享基础模型加演示微调的方式让工业机械臂学会机器看护、焊接和装配任务,其最大模型参数量仅为 low billions 级别,并强调数据质量比数据量更重要。其零样本感知系统基于超 10 亿张图像训练,负责定位识别零件,运动与单元逻辑仍由传统编程处理;模型在云端训练、在工厂边缘 GPU 上本地推理,通过腕部摄像头和千兆以太网生成 action chunks 送入底层控制。公司已获 2 亿美元 C 轮融资、估值 10 亿美元,客户包括 NASA、Amazon 和 Lockheed Martin。
匹配字段摘要
Standard Bots 用共享基础模型加演示微调的方式让工业机械臂学习机器上下料、焊接和装配任务,最大模型参数量在“low billions”级别,推理在本地边缘 GPU 上完成。其零样本感知系统基于超 10 亿张图像训练,负责定位和识别零件,运动与单元逻辑仍由传统编程处理。公司称通过真实部署中采集的失败信号和人工纠正数据持续改进模型,并强调数据质量比数据量更重要。
匹配字段摘要
据 Business Insider 看到的文件、截图和内部聊天记录,Google 正在测试 Argon、Barium、Carbon 三个 Gemini 4 变体,其中 Carbon 已部署在内部编码平台 Jetski 上,据说在编程任务上强于 Argon。一名员工将 Carbon 与 Anthropic 最强的编码模型 Opus 5.5 相比,但表示仍需更多测试。Google 将模型角色划分为 Argon 负责前沿推理、Flash 负责速度与吞吐、Omni 负责生成式媒体、Gemma 负责轻量开源端侧,Carbon 和 Barium 可能是 Argon 家族内的检查点或更新。Gemini 4 尚无官方发布日期,Gemini 应用已出现 3 系列模型的 Automatic 模式和可调推理强度,Google AI Studio 也出现了 Ultra 模式。
匹配字段摘要
Google 为 Gemini 应用免费版用户推出改动,免费用户无法再手动切换模型,选择器中只剩 Auto 搭配 Gemini 3 模型,由系统自动把提示词分发给最合适的模型,多数提示词走最快的 Flash-Lite,需要更深推理的会走 Flash 或 Pro。若关闭智能模型选择,无 AI 套餐用户的全部回复都使用 Flash-Lite。同时 Google 上线新的 effort levels 取代此前的 Extended 选项,分为 Low、Medium、High 三档,与 Google AI Studio 和 Antigravity 中的 thinking levels 对应。Google AI Plus 用户之后将限制为 Flash-Lite 和 (3.8) Flash。
匹配字段摘要
Interconnects 作者认为,AI 模型几年内将在分布式 GPU 工程等基础设施能力上超越人类,但不会因此发生本质变化;真正的加速来自推理算力扩展与效率优化,模型智能的有效成本可能接近指数级下降。作者预计预训练架构与数据选择研究在 2-3 年内可被自动化,并称 RL 环境质量普遍偏低但可修复。
匹配字段摘要
@francoisfleuret 这不是 LLM。 只要推理涉及*搜索/优化*,就能找到创造性的解决方案。 AlphaZero 会执行搜索。 普通 LLM 不会。
@francoisfleuret 这不是 LLM。 只要推理涉及 搜索/优化 ,就能找到创造性的解决方案。 AlphaZero 会执行搜索。 普通 LLM 不会。
匹配字段摘要
Madhu Guru 认为开源权重模型并未开启智能单位价格的下降,只是加速了已在进行的趋势。过去几年降价由三个因素驱动:模型厂商把最强模型蒸馏成更小、推理更便宜的版本,基础设施效率提升,以及模型提供商之间的竞争。他称这一规律在每家模型公司都成立:中型模型第 x 版具备大型模型第 x-1 版的智能,同等智能、更低价格。
匹配字段摘要
TinyFish 在 Databricks AI Runtime 上训练和微调其 web-native 模型,用 MLflow 做评估、Databricks Model Serving 做生产推理。其内部 go/no-go 基准显示,该模型在 2,178 个 web-agent 任务中完成 1,691 个,任务成功率 77.6%。在近期 15 天内,该模型支撑 294,781 次 agent 运行、640 万次工具调用,模型服务成本约为每次运行 $0.088、每工具步 $0.0040。
匹配字段摘要
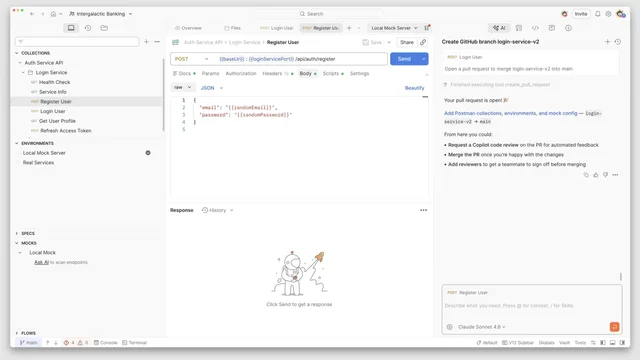
Postman 在 Amazon Bedrock 上运行 Agent Mode,为 4000 万开发者提供覆盖 API 测试、文档、发现与实现的 AI 原生工作方式。其架构将 170 多个工具按任务动态筛选至约 15 个,因为测试显示可见工具超过约 40 个后工具选择错误率上升。Agent Mode 借助 Amazon Bedrock 实现模型选择灵活性、跨区域推理、模型相关的零数据保留和多层提示词缓存,并在修改应用状态前要求用户批准。
匹配字段摘要
Amazon Bedrock 在 9 月新增多款前沿模型:OpenAI 的 GPT-6 Astra、Sol、Luna 系列正式可用,其中 GPT-6 Astra 支持最多 100 万输入 token,Ultrafast 档位推理速度最高提升 6 倍、达 300 tokens/秒;Claude Fable 5.1、Opus 5.5、Sonnet 5.5 上线,Sonnet 5.5 相比 Sonnet 5 每任务成本降低 30%、速度提升 30%;Moonshot AI 的 Kimi K3 以 2.8 万亿参数、100 万 token 上下文窗口和原生视觉能力开放。AgentCore 运行时降低冷启动延迟并改为按用量计费,Strands 开源 harness 在准确率持平主流 harness 的同时减少 28% token 消耗,Strands Decider 2B 决策模型可在本地约 115ms 内完成选项判断。
匹配字段摘要
LlamaIndex 发布教程,演示如何用 LlamaParse Index 解析并索引非结构化文档,再接入 Claude Sonnet 4 与 FunctionAgent 构建可推理的文档智能体。示例以 JPMorgan Chase 存款账户披露文件为数据集,智能体可查询透支政策、补卡费与止付费并调用计算器工具汇总费用。
匹配字段摘要
LlamaIndex 发文解释 Agentic OCR:它不再是一次性提取,而是让系统对文档结构进行推理、按页面内容选择传统 OCR、视觉语言模型或语言模型,并通过自校正循环在结果流出前发现错误。多模态语言模型充当推理层,视觉定位用 bounding box 把每个抽取字段回溯到原文位置,文档类型识别无需按格式配置,因此无需模板即可适应新格式。

匹配字段摘要
LlamaIndex 提出智能体文档抽取方案,把文档处理当作推理任务,采用 plan-act-verify 循环:先识别文档类型与逻辑结构,再按区域抽取,最后自检输出,能发现 OCR 高置信度但语义不合理的错误。其 LlamaParse 结合视觉定位与 bounding box,让视觉布局与语义内容一致后才确认抽取,从而处理表格、复杂版式和医疗表单等场景。

匹配字段摘要
一家欧洲大型银行用 TensorZero 构建了基于 LLM 的 GitLab merge request 变更日志生成器,并通过 Ollama 实现完全本地化部署,数据不出内网。团队借助 TensorZero 内置的动态上下文学习(DICL),把工程师对 AI 生成日志的修改和批准自动用于优化后续推理,无需微调或标注数据集,也无需 ML 工程师即可迭代。
匹配字段摘要
TensorZero 在其开源 LLM 网关中提供自适应实验(A/B 测试)功能,采用多臂老虎机算法解决传统实验固定停止规则和流量分配次优的问题,可在证据充分时自动停止并动态分配推理流量。官方称在多种真实环境中,自适应实验将正确识别最佳 LLM 变体(提示词、模型等)的平均时间比简单 A/B 测试缩短 37%。该功能基于固定置信度最佳臂识别(BAI)的 Track-and-Stop 策略,用 Rust 实现,通过概率采样、周期性更新采样概率和 GLRT 停止规则适配生产环境的异步反馈与并发请求。
匹配字段摘要
TensorZero 提出一种基于 Git 提交自动评估 AI 编程助手的方法:用 tree-sitter 将代码解析为语法树,再用树编辑距离(TED)衡量 LLM 生成代码与提交代码的差异,从而为 Cursor 等编码智能体的推理结果生成反馈。该方案开源,可在已部署 Cursor 集成的机器上运行。
匹配字段摘要
TensorZero 工程博客汇总了其开源 LLM 基础设施的多篇文章,最新一篇为 2026 年 5 月 12 日 Alan Mishler 的《Even (very) noisy LLM evaluators are useful for improving AI agents》。此前文章涵盖 LLM API 隐藏成本、自动化 AI 工程师、LLM Gateway 中的 Bandit 自适应实验、OpenAI RFT 评估、5-30x 更便宜的蒸馏推理,以及逆向分析 Cursor 的 LLM 客户端等主题。
匹配字段摘要、正文