←搜索结果

按匹配度 · 共 2902 条结果 清除搜索

星期五

  1. Databricks Blog精选

    Databricks 与 Linux 基金会将 Delta Sharing 演进为 OpenSharing

    Databricks 与 Linux 基金会宣布 Delta Sharing 演进为 OpenSharing,一个由 Linux 基金会治理的开放协议,可共享的不只是表,还包括 Agent Skills、AI 模型和非结构化数据。协议规范以 Apache 2.0 许可托管在 GitHub,新增 Share → Schema → Asset 层级和 Apache Iceberg REST Catalog 客户端支持,现有 Delta Sharing 配置无需迁移,在 Unity Catalog metastore 上启用即可。Databricks 同时推出 SecureConnect(正式可用)、Global Distribution(私有预览)、Genie Agent Sharing(Beta)和 Lakebase 表与变更数据流共享(公开预览)。
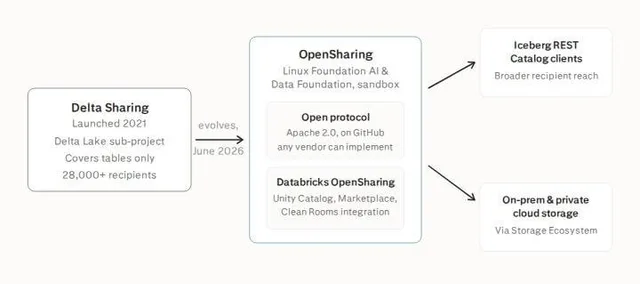
    image2.jpg

    伙伴在数据和 AI 资产上协作,本文将介绍 OpenSharing 究竟是什么、底层发生了什么变化,以及该项目的发展方向。 简要回顾:Delta Sharing 解决了什么问题 当 Databricks 在 Data + AI Summit 2021 上推出 Delta Sharing 时,它所解决的核心问题说起来简单,做好却很难:组织希望与合作伙伴、客户和其他团队共享实时数据,而不必导出文件、搭建脆弱的 ETL 作业,或强迫每个接收方都使用同一平台。Delta Sharing 作为开放协议被贡献给 Linux 基金会,构建在 Delta Lake 和 Parquet 之上,因此提供方可以授予对某张表的访问权限,接收方则可以从 Apache Spark、Power BI、Tableau、pandas 等众多工具中直接、实时地查询该表。 这种开放的零拷贝模式引起了广泛共鸣。据 Databricks 称,Delta Sharing 已发展成为应用最广泛的安全数据共享开放协议,Amadeus、Atlassian、LSEG、SAP、Stripe 和 The Trade Desk 等组织都使用它

    匹配字段正文

  2. Reflection Blog

    Reflection 发布 Beam 开源模型安全训练与评测报告

    Reflection 发布 Beam 的安全技术报告,介绍其通过预训练数据过滤、安全对齐教师模型与多教师在线策略蒸馏(MOPD)来兼顾拒答有害请求与正常回答。在自建的 Iris Safety Evaluations 中,Beam 对有害请求的拒答率为 89%,对安全无害请求的合规率为 82%,处于安全与有用性的帕累托前沿。报告还显示,安全对齐教师从 100B 增至 501B 参数后,过度拒答相对下降 48.7%,有害请求通过率下降 3.1%。

    Reflection.ai dotted artwork

    评估其能力带来的风险。模型可能试图完成有害请求但不具备成功的能力,或者拥有危险能力但拒绝使用它。两项评估对于理解模型安全性都是必要的。 我们的评估将Beam列为可用的最安全开放权重模型之一,在拒绝有害协助同时保持有用性方面表现尤为突出。 安全性与有用性:Beam位于观察到的帕累托前沿,在有害请求上保持拒答,同时在无害请求上仍然合规。 有害请求:Beam比所有其他受测的西方和中国开放权重模型更多地拒绝有害协助。 网络能力:Beam在Irregular的网络能力评估中优于所有受测的西方开放权重模型,并在Artificial Analysis的网络指数上得分34%。 在本文中,我们分享这些结果背后的训练方法以及我们的评估发现。有关完整方法和结果,请阅读 Beam Safety Technical Report. 能力与对齐训练 我们的安全方法将预训练数据过滤与专门的安全后训练相结合。我们训练了两位教师:一位专注于通过强化学习(RL)进行大规模能力开发,第二位专门负责安全与对齐。我们使用单独的监督微调和RL流水线,从Beam的预训练检查点训练安全对齐教师,所用数据专门针对模型应遵守的原则。 然

    匹配字段正文

  3. NVIDIA Developer · Generative AI

    NVIDIA 协同设计如何最大化 AI 工厂中每个字节的价值:五种方式

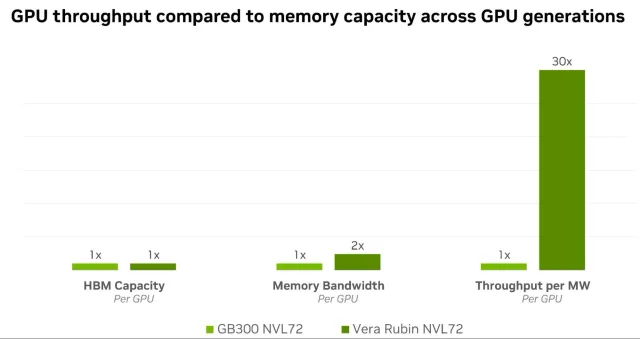
    NVIDIA 通过 NVFP4、Wide-EP、Dynamo、Vera CPU 和 CMX 五项协同设计,让 Vera Rubin NVL72 在每 GPU 288 GB HBM 不变的情况下,于 SemiAnalysis AgentX 上实现最高 30 倍于 GB300 NVL72 的每兆瓦吞吐量。NVFP4 将模型占用较 FP16 缩小约 3.5 倍、较 FP8 缩小 1.8 倍,NVFP4 KV cache 较 FP8 再降最多 50%。TensorRT-LLM 的 Wide-EP 把专家分散到 8 块以上 GPU,Dynamo 则将 KV cache 作为跨 GPU、CPU 和存储的集群级资源管理。

    Bar chart comparing GB300 NVL72 and Vera Rubin NVL72. Relative to GB300’s1x baseline, HBM capacity per GPU is 1x, memory bandwidth per GPU is 2x, and throughput per megawatt is 30x.

    e Runner(KVCR): 它跟踪每个块在已配置的 GPU、固定 CPU 和存储层级(包括本地 SSD 和挂载的网络文件系统)中的存放位置。保留在 HBM 之外的前缀可在后续请求需要时恢复,使有用的上下文在 GPU 逐出后仍能存活,并继续节省预填充工作。KVCR 使用 NVIDIA 推理传输库(NIXL) 用于其存储传输路径,使缓存块能够在 GPU 处理其他工作的同时进行迁移。KVCR 还支持分布式复用,由路由器提供的提示帮助选定的 worker 从对等节点检索缓存的上下文,同时推理引擎保留对 GPU 内存和本地主机卸载的控制。额外的 KVCR-Guard 功能可在引擎发生故障时保留已提交的、由 KVCR 管理的主机内存缓存,只要保护服务和主机仍然可用。 图 6. Dynamo 将 KV 感知路由、分离式服务和分层 KV 缓存复用相结合。 Dynamo 的 KV 缓存卸载依赖于快速检索:当加载 HBM 之外保留的前缀比重复预填充更快时,这样做就能节省时间。NIXL 将这条卸载路径连接到外部存储系统。在各自的验证测试中,存储厂商 VAST Data 和 WEKA 分别展示了:使用 G

    匹配字段正文

  4. Sierra:Blog

    Sierra 收购浏览器智能体公司 Anon

    Sierra 宣布收购 Anon,后者专注让企业 AI 智能体像人一样在无 API 的网站上登录、导航页面并填写表单。Anon 此前融资超过 1300 万美元,产品服务数百家客户,并在银行、医疗和企业软件领域部署过智能体。其团队与技术将并入 Sierra,用于让 Sierra 智能体在需要登录网站或操作门户时把任务推进到完成。

    Bret and Clay

    时间推移,我们在生产环境中完成了数十万个复杂任务。这种对可靠性的执着塑造了我们的技术,也塑造了我们对企业在规模化使用智能体时所需能力的理解。 为什么选择 Sierra 我通过一位共同投资人第一次见到 Clay,我们立刻看到了契合点。Sierra 拥有一支卓越的团队、对智能体发展方向的清晰观点,以及对为客户创造成果的不懈专注。在如此快速变化的市场中,我还没有在其他地方见过这样的组合。 我们正在为许多相同的公司解决相关的问题,它们对安全性和可靠性有着相同的期望。如今借助 Horizon,基于 Sierra 构建的智能体正在追求运行时间更长的目标,例如发起贷款或为医疗程序获得事先授权。完成这些目标需要跨多个系统工作,包括没有 API 的服务。 我们将帮助 Sierra 的智能体弥合这一差距。当某个步骤需要登录网站、浏览门户或通过浏览器输入信息时,智能体将能够把更多工作推进到完成。 时机也恰到好处。更好的模型和运行框架让浏览器智能体可靠得多,最优秀的智能体现在在许多现实任务上表现优于人类。这使我们此刻加入 Sierra 恰逢其时。 感谢早期信任我们的客户、支持我们的投资人,以及每一位与我一起打

    匹配字段正文

星期四

  1. Databricks Blog

    Debezium Server 3.7 通过 Zerobus Ingest 将 CDC 事件直接推入 Unity…

    Debezium Server 3.7 新增 Zerobus Ingest sink,可将 CDC 事件直接推入 Unity Catalog 的 Delta 表,无需中间 Kafka 集群或拉取式连接器。该 sink 由 NVIDIA 与 Databricks 联合开发并贡献给开源 Debezium 项目,NVIDIA 补充了 envelope 模式、幂等键和源 offset 推进前的持久化确认等投递保障。这一推送式架构让受限于私有网络、禁止入站连接的环境也能安全向外复制数据。

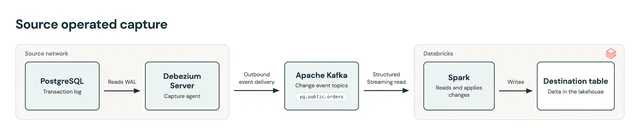
    Architecture with a message bus: source operated capture

    线。运行 Kafka 需要资源来进行容量规划,以预测处理峰值负载所需的 broker 数量以进行物理扩展,并估算消费者跟上生产速率所需的分区数量以进行逻辑扩展。这需要一个在 Kafka 部署和管理方面有经验的专职团队。 一旦数据落入 Kafka,你就有了下一个要完成的任务,即将这些事件复制到湖仓。这可以通过部署 Spark、Kafka Connector 或其他工具的摄取作业来实现。结果是形成了从 Debezium 到湖仓的两跳架构。 使用 Zerobus Ingest 的架构: 当你唯一的目标端是湖仓时,Zerobus 允许你绕过消息总线等中间跳。这既简化了端到端架构,也消除了为数据传输而部署和管理 Kafka 基础设施的需要。当使用 Zerobus 作为 Debezium 的 sink 时,它无需调优即可在高峰时段继续工作。 什么是 Debezium? Debezium 是一个开源的、基于日志的变更数据捕获平台。它不轮询表,而是读取数据库的事务日志,例如 PostgreSQL 的预写日志(WAL)、MySQL 的 binlog 和 MongoDB 的变更流。然后它将每个变更作为结构

    匹配字段正文

  2. MacRumors Apple Intelligence

    iOS 27.3 beta 代码显示 HomeView 或将支持 AI 聊天机器人应用

    代码调查者 pdfu 在 iOS 27.3 beta 中发现,HomeView 用于显示 iPhone/iPad 应用的软件新增了“Conversational Apps”类别,并加入双向音频路由、会话管理和中断处理准备,但尚未完全接通,苹果也未宣布支持 ChatGPT、Claude 等聊天机器人。HomeView 还内置防欺骗保护:同一配置文件三次欺骗尝试后需用 iPhone 认证才能查看个人数据,该功能已在 HomeView 27.2 软件中启用。HomeView 将于 11 月 13 日发售,售价 $299,分桌面版和壁挂版。

    hone 或 iPad 的应用的软件,在最新 beta 中新增了“Conversational Apps”类别。据报道,此次更新还为双向音频路由、会话管理和中断处理做了准备,但 pdfu 指出,它“仍未完全接通”。 苹果尚未宣布 HomeView 的聊天机器人应用,代码也未显示哪些应用可能使用该类别,或它可能何时推出,因此对 ChatGPT、Claude 或其他聊天机器人的支持尚未得到确认。这并非首次提出这种可能性:pdfu 周日曾表示,基于 HomeView 软件中一个未使用的标志,聊天机器人应用可能会随之推出。 防欺骗保护 在另一项发现中,pdfu 还发现 HomeView 包含防欺骗保护。显然,在针对某个配置文件进行三次欺骗尝试后,用户必须通过 iPhone 进行认证才能查看个人数据,并且该保护已在 HomeView 软件 27.2 中启用。 据称,苹果还在开发一种锁定冷却系统,类似于在 iPhone 上输入错误密码时发生的情况。第一次锁定可以立即解除,但第二次锁定会带来一小时的等待,第三次为四小时等待,第四次(或任何后续)锁定则为八小时等待。 pdfu 补充说,锁定冷却期仍在开

    匹配字段正文

  3. 9to5Google

    Google 搜索在校园强制接入 Gemini 与 AI Overviews,引发学校与监管争议

    9to5Google 报道,Google 对校园搜索体验的调整要求学校主动选择启用 Gemini、Gemini Notebook、Gemini in Classroom 和 AI Overviews,Google 的理由是搜索与 AI 已深度整合,关闭其一等于关闭另一个。前 FTC 主席 Lina Khan 在 X 上批评 Google 借搜索垄断迫使学校采用 AI。文章还提到,AI 热潮推高零部件价格,部分低收入学区已收回学生 Chromebook、改回共享设备。

    。 ⭐️ 精选 很难夸大美国学区对 Google 的依赖程度。全国几乎每个学校董事会都为学生们购买 Chromebook,许多学生能把它们带回家当作个人笔记本电脑使用。IT 和采购经理喜欢它们,因为它们相对便宜,并提供零接触注册,降低了前期和持续的维护成本。老师们也喜欢它们,因为 Google Classroom 相对直观,而且 ChromeOS 针对大多数其他基于网络的教育平台进行了优化。 本周早些时候,《纽约时报》报道称,学校中 Google 搜索体验的变更将要求学校主动选择启用 Gemini、Gemini Notebook、Gemini in Classroom,以及或许最重要的 AI Overviews,事情由此达到顶点。此举实际上发生在 Google 受到压力、被要求让学生使用 AI 变为主动选择之后。Google 的理由是:搜索和 AI 如今在技术栈中“深度整合”,因此禁用其中一个就意味着禁用另一个。 Google 对 AI Overviews 的替代方案是一项名为 Guided Learning 的新功能,它用帮助学生理解问题的分步指南,取代了搜索的主要功能——解决问题。

    匹配字段正文

  4. Hugging Face

    Hugging Face 发布端侧语音模型 Phonon,31m 版本以 Apache 2.0 开源

    Hugging Face 发布端侧 TTS 模型 Phonon,提供约 65 MB 和 75 MB 两个尺寸,覆盖英语、法语、德语、西班牙语和葡萄牙语,内置 100 多个音色。其中 Phonon 31m 仅支持英语并以 Apache 2.0 开源,可用于商业产品;Phonon 40m 覆盖五种语言但采用非商业许可。官方称其在 Open TTS Leaderboard 的德语和西班牙语可懂度排名第一,并在 CPU 流式首包延迟基准上领先,配套推理框架 ptts 支持 CPU、GPU 和 NPU 等 10 余种后端。

    为什么语音应该运行在你的设备上 大多数语音 AI 都运行在云端:每说一句话都要往返服务器一次。而 Phonon 则运行在你自己的设备上。你的文本留在本地,语音无需网络也能工作。我们还开放了模型权重。Phonon 31m 采用 Apache 2.0 许可,因此你可以免费使用,甚至用于商业产品。其他模型采用 CC BY-NC 许可,因此可免费用于非商业项目。如果你要用这些模型开发商业产品,定价依据是你的用户数量,而不是你生成了多少语音。 让高质量的语音在小型设备上运行一直很难。你可以把模型做小,但那样音质就不够好。或者你可以让音质出色,但那样模型就装不下。我们同时解决了这两个问题。 我们在四月发布了 Phonon,并在接下来的六个月里与合作伙伴和早期用户一起在此基础上继续开发。他们的反馈帮助我们塑造了这次发布。模型变得更小,我们还增加了更多语言,并通过语音克隆和语音设计支持自定义音色。 Phonon 基于 Pocket TTS 系列,因此使用流匹配来生成音频,这与其他 TTS 系统所用的建模技术非常不同。正是这一点让我们能把这种水平的音质带到如此小的模型中,但它在训练模型时也带来了新的挑战

    匹配字段正文

  5. Browser Use

    Computer Use 与 Browser Use 的区别及各自适用场景

    Browser Use 官方对比了 computer use 与 browser use 两类 AI 智能体:前者靠截图定位屏幕坐标操作整个桌面,后者通过 CDP 直接读取页面结构并操作元素。Browser Use 认为网页任务应优先用 browser use,因为页面结构可直接定位元素、可并行运行无头浏览器,Browser Use Cloud 每浏览器小时 $0.02;只有桌面应用、系统对话框或纯 canvas 页面才需要 computer use。

    获取完整的表格或表单,而不只是截图中能容纳的部分。 确定性的步骤可以写成代码。 当任务的一部分是可预测的,智能体可以运行脚本,而不必对每一次点击都进行推理。从页面中提取表格只需一次 JavaScript 调用,而不是十几个滚动和读取的步骤。我们在 浏览器智能体的苦涩教训. 浏览器可以横向扩展。 无头浏览器不需要桌面环境,因此你可以同时运行多个浏览器,每个都与其他浏览器相互隔离。在 Browser Use Cloud 上,一个浏览器的费用为每浏览器小时 $0.02,无需订阅(定价). 真实网页的难点在于浏览器,而不在于模型。 机器人防护、CAPTCHA、代理、登录和会话状态决定了智能体究竟能否进入。这些都是浏览器基础设施问题。我们发布了一份 隐身基准测试 关于这在《浏览器智能体的苦涩教训》中能走多远的讨论。浏览器可以横向扩展。无头浏览器不需要桌面环境,因此你可以同时运行多个浏览器,每个都与其他浏览器相互隔离。在 Browser Use Cloud 上,一个浏览器的费用为每浏览器小时 $0.02,无需订阅(定价)。真实网页的难点在于浏览器,而不在于模型。机器人防护、CAPTCHA、代理、登

    匹配字段正文

  6. 清华大学战略与安全研究中心

    孙成昊:东南亚在中美AI博弈中的选择与东盟区域合作

    清华大学战略与安全研究中心副研究员孙成昊认为,东南亚在AI领域的选择将长期受中美博弈影响,但各国可通过自身投入和区域合作增强自主选择能力。新加坡AI Singapore的SEA-LION项目曾使用美国企业的Llama、Gemma和中国的通义千问(Qwen)开发东南亚语言模型。东盟已出台《2025—2030年负责任人工智能路线图》,并推进区域AI安全网络建设。

    清华大学战略与安全研究中心

    来西亚、越南更关注数字基础设施建设和本土产业升级,数字基础较弱的国家则仍在积累基本的人才储备与设施建设。各国同中美的政治和安全关系也有差异,对外部风险的判断自然不同。因此,各国会根据发展阶段和安全需要,与不同伙伴开展不同领域的合作。 这种差异也意味着,不能仅凭一国使用哪国技术,就判断其外交走向。一国可以利用中国的模型改善公共服务,同时与美国开展安全合作,再向其他伙伴学习治理经验。这些选择未必彼此冲突,却需要政府协调好不同合作所附带的条件。欧洲、日本、韩国和印度等伙伴,可以帮助地区国家增加选择,但也难以消除对中美关键技术的依赖。东南亚国家需要弄清哪些合作能够相互补充,哪些安排会妨碍今后与其他国家合作。 要减少这些约束,东南亚各国还需要把外部技术转化为本国能够掌握的能力。政府需要把AI发展同教育、科研和产业政策结合起来,持续培养人才,改善技术使用所需的基础条件。如果AI只在少数部门得到应用,大部分社会仍缺少使用和判断技术的能力,国家就难以充分获得发展收益,也更容易长期依赖外部支持,而这些能力建设,仅靠引进几个大型项目难以完成。 多数东南亚国家很难投入与中美体量相当的资金,开发全球领先模型,

    匹配字段正文

  7. Goodfire Research

    Goodfire 提出机制塑造框架,用内部表征约束模型训练

    Goodfire Research 发布论文,提出机制塑造框架,通过依赖塑造和表达塑造两种方法,在训练目标中加入对模型内部概念的惩罚项,指定模型该依赖什么、不该表达什么。在胸部 X 光诊断实验中,该方法减少模型对胸管等伪特征的依赖,准确率超过平衡数据训练的软上限;在 OLMo-3-7B 的 DPO 后训练中抑制了谄媚行为,在 Qwen3.5-9B 的 Countdown 任务中把作弊行为压到 96–98% 的诚实求解率。论文还提出五级可监控性分级,实验显示被塑造的概念通常只是转移位置而非消失,重训探针后仍可监控。

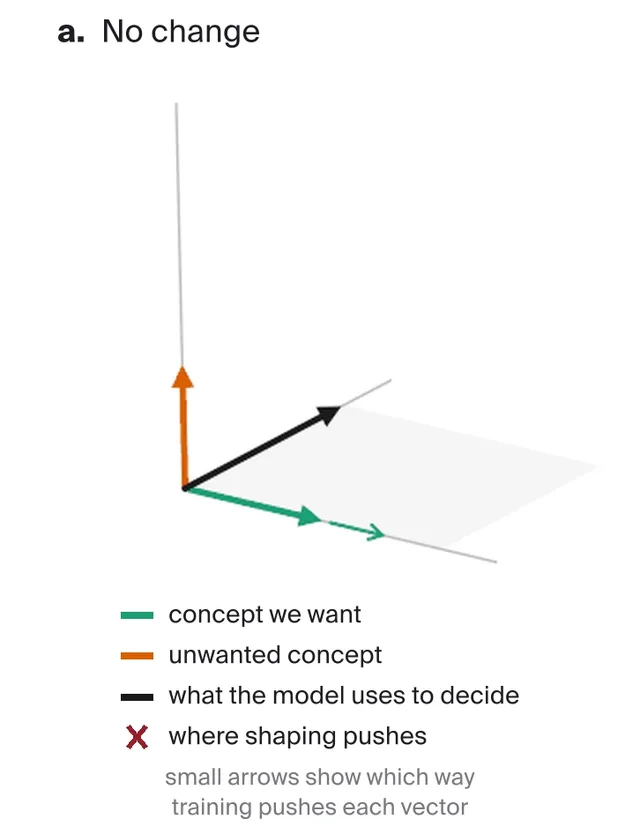
    a. No change (Figure 7): the unwanted concept stays in place while the model stops using it.

    可能会在更靠后的层重建这一概念。 为了更好地理解实际可能发生什么以及为什么会这样,我们研究了机制塑造最简单、最强的版本: 从模型的表征中完全删除(投影消除)某个概念方向 从模型的表征中。我们在此总结该理论的三个主要要点,但论文展示了更多内容: 概念表征会立即开始重新生长。 原始的概念方向得不到训练信号,但任务仍然奖励该概念的存在,因此一个新的概念方向会立即在其他地方开始生长。 重新生长出的表征可能会与期望的概念纠缠在一起。 不期望概念的新的表征会沿着模型用于该任务的方向生长,因此它可能与我们会 希望模型用于决策的概念混杂在一起。频繁刷新可能会训练出该概念的非线性表征。反复刷新你用于塑造的概念方向(即重新拟合不想要的概念方向)会引发一场竞赛:一边是重新生长出新的线性概念方向,另一边是发展出非线性编码。最终,非线性编码可能在这场竞赛中胜出。然而,模型可以在更靠后的层再次以线性方式表征该概念,而非线性编码的类型需要一种 希望模型用于决策的概念。 频繁刷新可以训练出该概念的非线性表征。 反复刷新你用于塑造的概念方向(即重新拟合不想要的概念方向)会引发一场竞赛:一边是重新生长出新的线性概念方向,

    匹配字段正文

  8. NVIDIA Developer · Generative AI精选

    NVIDIA 发布 AI Factory Operations Agent,用多智能体协同排查 DGX 集群故障

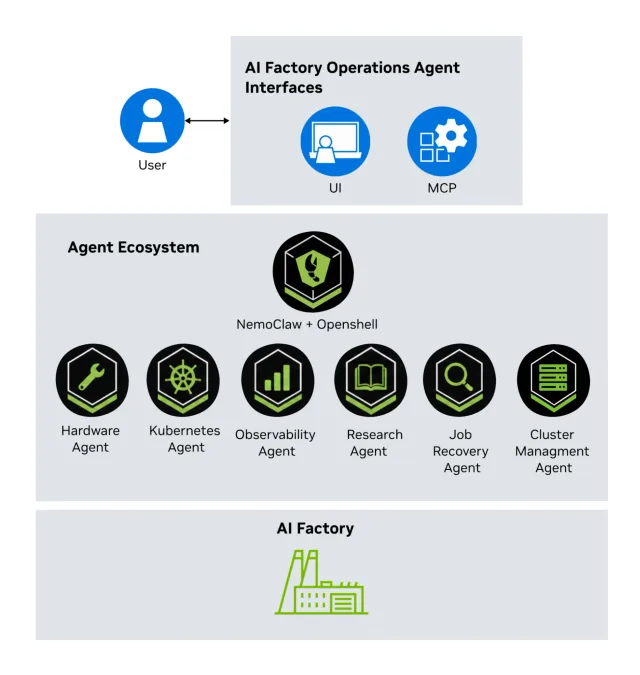
    NVIDIA 发布 AI Factory Operations Agent,通过多个领域子智能体协同,在计算、网络、硬件和调度层之间定位根因,并通过聊天界面给出建议,用于自家 DGX SuperPOD 运维。该框架基于 NVIDIA NemoClaw blueprint 和 OpenShell 构建,完全本地部署,推理使用本地 NVIDIA Nemotron 开源模型,运行在 DGX H100、DGX B200 和 DGX GB300 生产集群上。框架包含 Job Recovery、Hardware、Observability、Research、Kubernetes 和 Cluster Management 等子智能体,并集成 web 搜索、代码执行和 Grafana 看板等 MCP 工具,开发者示例与开源代码已开放。

    Diagram of workflow where either an SRE or agent triggers the AI factory agents powered by NVIDIA Nemotron 3 models that perform reasoning tasks to output root cause analyses, run commands for issue resolution, or generate relevant dashboards.

    入你的 AI 工厂 对于大规模运行 AI 工厂的组织而言,首选部署模式是采用与生产集群隔离的专用 GPU 加速控制平面。控制平面负责智能体编排与推理,而生产集群则提供遥测数据,同时不会占用训练用 GPU,也不会干扰工作负载。 NVIDIA 内部部署在专用 GPU 容量上运行模型推理,并使用现有的控制平面 CPU Kubernetes 管理空间运行运行时服务。其他部署可根据数据主权、集群规模和可用 GPU 容量,使用本地或云端推理端点,较小的部署则使用 RTX PRO 工作站 或 DGX Spark. 对于多租户 AI 工厂,作用域受限的智能体、工具、沙箱和 Kubernetes 权限控制着每个租户可用的集群数据、工具和节点。租户 SRE 只能看到自己的命名空间、作业和节点,而中央运维团队则保留更广泛的集群可见性。每个租户在需要时都可以使用自己的一套领域专用智能体和专用推理硬件。OpenShell 通过在内核级限制的隔离沙箱中运行每个租户的智能体和工具来强制执行这些边界。 开始使用 要开始简化集群运维管理,请探索 AI 工厂运维智能体 开发者示例,或直接在 GitHub 上访问开源框架和

    匹配字段正文

  9. SiliconANGLE

    Oracle 用真实应用测试保障 AI 驱动的安全补丁安全

    Oracle 执行副总裁 Juan Loaiza 在 Oracle AI World 上表示,公司今年 3 月获得 Mythos 模型早期访问权限并用其扫描自身代码,发现大量严重安全漏洞,随后将修复纳入季度补丁,今年一次季度安全更新修复了超过 1,400 个漏洞。Oracle 用 Real Application Testing 捕获真实工作负载验证补丁,并通过 4 月起交付的 Deep Data Security 把用户身份以加密 token 传入数据库,在数据层强制执行安全与业务规则。

    AI 无法绕过的地方执行,也就是一直下到数据层,”Loaiza 说。“AI 智能体必须获得你的身份。它代表你行事。如果它看不到数据,就无法泄露数据。” 业务规则遵循同样的逻辑。Loaiza 指出,应用程序代码一直会阻止超过客户限额的信用卡扣款,但被要求执行该规则的 AI 智能体可能不会遵守。Oracle 正在提供声明式方式来定义此类规则,以及 SQL Assertions,用于检查通过 SQL 所做的更改是否有效。 “有信用额度,有各种各样不能被违反的业务规则。再说一次,如果我们把所有这些一直下移到数据中,那么无论你如何访问数据、使用什么机制、如何使用 AI,它都无法违反这些规则,”Loaiza 说。 以下是完整的视频采访,这是 SiliconANGLE 和 theCUBE 对 Oracle AI World 报道的一部分: ( 披露:theCUBE 是 Oracle AI World 的付费媒体合作伙伴。Oracle 作为 theCUBE 活动报道的赞助商,以及其他赞助商,均不对 theCUBE 或 SiliconANGLE 的内容拥有编辑控制权。) 图片:SiliconANGLE

    匹配字段正文

  10. Cognition 模型 / Devin 博客精选

    Cognition 发布 SWE-2 Flash 编码模型

    Cognition 发布 SWE-2 Flash 编码模型,基于 Thinking Machines 的 Inkling-Small(276B 总参数、12B 激活参数)训练,在训练流程中首次加入强化学习前的中训练阶段。官方称 Terminal-Bench 4.0 从 0.9% 提升到 20.0%,FrontierCode 2.0 从 3.2% 提升到 24.0%,ExploitBench 从 11.3% 提升到 34.8%。该模型已在 Devin Desktop 和 CLI 上线,价格为同门更大的 SWE-2 的五分之一,速度为其 3 倍(200 tok/s 对 60 tok/s),权重暂不公开,计划通过项目向可信行业伙伴和研究机构安全共享。

    始,我们测量了每个候选数据混合配比需要多少 token 才能达到与基线相同的验证损失。通过将上述 token 数量的比值绘制在 y 轴上、将基线 token 数绘制在 x 轴上,我们就能直接比较不同混合配比的训练效率。 各数据混合配比的 token 效率 我们对中训练数据的组成进行了反复迭代,最终确定了一个由数万亿 token 的高质量科学文章、博客、代码及其他来源组成的数据集。训练分三个阶段进行,以便模型在训练后期看到最稀缺、质量最高的数据。在每个阶段中,留出验证损失都以稳定的对数线性速率改善。 中训练期间的验证损失 在中训练阶段之后,我们进行了大规模强化学习。虽然我们对 SWE-2 的 RL 配方做了一些调整,但大部分改进来自我们 RL 任务质量和多样性的显著提升。 在质量方面,我们仔细审查了任务的指令、环境设置和验证器。在多样性方面,我们策划了若干新的任务类型,覆盖的能力范围远超以往,以培养 Devin 中真实工作所要求的通用推理和问题解决能力。在这些数据上训练,使我们在几乎每一项所测量的基准上都取得了显著提升。 RL 期间的 rollout 分数与基准平均值对比 起源与网络安全

    匹配字段正文

  11. Databricks Blog

    Databricks 谈企业为何转向开放权重模型:Unity AI Gateway 统一托管

    Databricks 认为开放权重模型已接近前沿模型水平且成本更低,企业因此重新评估单一前沿模型供应商策略。其 Unity AI Gateway 通过统一 API 托管开放权重、前沿和外部模型,支持智能路由、回退与预算控制;自 1 月以来客户平均使用模型数从 4.2 增至 7.1,其中约 40% 为开放权重模型。

    image4.png

    型在一个测试框架中得分为 61.7%,在另一个中为 48.1%,而在裸模型下为 38.4% [9]。由于测试框架的选择会改变基准测试结果,评估应同时测试模型和测试框架。 7. 开放权重模型已赶上前沿模型。 顶级开放权重模型如今的基准测试水平已可与顶级前沿模型相媲美,且成本更低 [3][4][5]。这在十八个月前并不成立。开放权重模型达到前沿级基准性能,改变了其他六点中所述的成本、控制和部署权衡。 综观这些观察,企业正试图:1)在不牺牲生产力提升的情况下优化成本,2)保持运营自由,3)确保 AI 实施能够快速纳入创新。为此,他们需要一种架构,使模型和测试框架能够在不削弱治理的情况下发生变化。 开放权重模型的吸引力 相比前沿模型,开放权重模型在成本效率、控制和灵活性方面更优: 智能商品化: 随着模型智能成为商品,开放权重选项如今以极低成本提供与顶级前沿模型相当的智能,从而使 AI 部署获得更好的 ROI。 数据主权: 在可控基础设施上托管模型,使团队能够掌控合规、安全和数据保留政策,并降低未来出现不合规变更的风险。 完全运营自主权: 开放权重模型让团队能够运行前沿护栏可能阻止的工作负载(例

    匹配字段正文

  12. Google Research

    Agile Deliberation:Google Research 如何用 AI 帮人类厘清主观分类的灰色地带

    Google Research 提出 Agile Deliberation 框架,把主观图像分类器的构建变成人与 LLM 的迭代对话,先让用户拆解子类别与排除项,再由 VLM 主动挑出语义边界图像,反馈进入自动提示词优化循环。团队在 18 场、每场 1.5 小时的真人实验中验证,该流程减少了用户疲劳与焦虑,产出的分类器优于标准基线,代码与算法已在 GitHub 开源。

    Abstract artwork blending fluid watercolor washes on the left with geometric network nodes on the right, connected by a glowing central light.

    基线均能带来一致的性能提升,而人工审议方法往往无法提升分类器准确率,甚至会导致其下降。 缓解认知疲劳 我们实时研究的一项关键发现是手动提示词工程带来的认知负担。我们的研究表明,当用户试图预测哪些搜索词可能揭示边缘案例时,他们在手动概念审议过程中会经历明显的认知疲劳。此外,他们还报告称,持续感到焦虑,担心手动调整文本提示词以修复一个错误,可能会无意中降低分类器其他已经修复部分的性能。 用户体验与认知负荷指标. 与传统的人工提示词工程相比,使用 Agile Deliberation 的参与者报告称,所需投入的精力与承受的压力在统计上显著降低,同时心理负担更低,对成功率的感知和易用性更高。 Agile Deliberation 通过承担繁重的计算工作来解决这一摩擦。用户无需成为提示词工程师;他们只需查看精心挑选的边界图像画廊,并提供自然反馈。系统会无缝吸收他们的意图,并自动更新底层模型。 因此,使用 Agile Deliberation 的参与者报告称,他们感到压力显著更小、挫败感更少、精神上也更不易疲惫,并且每位参与者都表示相较于手动方法更偏好 Agile Deliberation。 结论

    匹配字段正文

  13. SiliconANGLE

    Smartsheet 推出 AI 规划执行平台 vsActual,用 Execution Graph 追踪项目偏差

    Smartsheet 在 Engage 2026 大会上发布 AI 驱动的规划与执行平台 vsActual,通过 AI 智能体持续监控跨企业系统的工作进度,并与战略目标比对、推荐调整。其核心 Execution Graph 基于约 20 年工作流数据和 9 PB 信息构建,底层依托 AWS Neptune 知识图谱约 1 亿个节点,可连接 Oracle、SAP、Workday、Atlassian 和 ServiceNow 等系统。平台同时新增 Agentic Workflows、多项集成和 ISO/IEC 42001 认证,默认保留人工审批。

    整方案。该公司还为其现有的工作管理平台宣布了新的智能体工作流能力、集成和安全控制功能。 vsActual的核心是Smartsheet所称的Execution Graph,这是一个知识图谱,据该公司称,它基于二十年的工作流数据构建,涵盖数百万个项目和9 PB的信息。该图谱映射任务、项目、项目群和战略目标之间的关系,以帮助AI智能体理解组织某一环节的变化如何影响其他环节。 Smartsheet首席产品与技术官Pratima Arora表示,该公司的目标是解决AI带来的个人生产力提升与可衡量的组织成果之间日益加剧的脱节问题。 “我们看到大量智能和生产力提升停留在个人层面,未能转化为团队和组织层面的成果,”她说。 vsActual的设计宗旨是在现有企业应用之上运行,而不要求组织将工作整合到单一平台上。它可以连接Oracle Corp.、SAP SE、Workday Inc.、Atlassian Corp. PLC和ServiceNow Inc.的应用,以收集有关预算、进度、人员配置和项目依赖关系的信息。 Smartsheet表示,AI智能体可以将战略文档、电子表格和预算提案转化为结构化计划,模

    匹配字段正文

  14. Figma AI / Agent / Make

    Figma 如何大规模管理沙箱:Nimbus 平台解析

    Figma 构建了名为 Nimbus 的集中式沙箱管理平台,通过 namespace 配置文件和 GetOrCreate、Get、Delete 三个 API,让工程师无需了解云厂商细节即可创建、复用和删除沙箱。Nimbus 使用统一基础镜像 sandbox-base 和守护进程 sandboxd 管理进程、网络与健康检查,目标是在 1 秒内返回已配置好的沙箱,并跨多个云厂商做负载均衡以应对故障。

    Illustrated sandbox factory with workers inside glass spheres moving along conveyor belts as an operator manages the system.

    个沙箱,必要时会创建一个。 Get 检索沙箱及其当前生命周期状态。 Delete 拆除沙箱。 虽然 API 很简单,但 Nimbus 为履行其契约义务所做的工作绝非如此。一个 GetOrCreate 请求不能只返回一个正在运行的容器;它必须返回一个能快速、安全地满足 namespace 要求的沙箱,无论使用哪个提供商。 容器边界还不够 沙箱将 AI 生成的或其他不受信任的代码与 Figma 服务器上运行的其他进程隔离开来。但从安全角度来看,这还不够。代码仍然可以通过网络发送我们不希望离开沙箱的信息。最直接的解决方案是实现严格的网络允许列表,但对于我们想要构建的产品来说,这往往过于简单粗暴。AI 工作负载可能需要搜索和读取互联网上的任意页面,而允许列表会阻止这一点。 在构建 Nimbus 的过程中,我们最终确定了一种对读取和写入区别对待的解决方案。通过 namespace,产品团队可以显式允许一份完全受信任的主机列表——代码可以从这些主机读取数据或向其发送数据。对于该列表之外的目标,Nimbus 仅允许 读取请求——、 或 ——且不带请求体。这对于网络搜索和页面检索等功能来说已经足够,而

    匹配字段正文

  15. Wired AI

    美国中期选举结果出炉,反对数据中心的候选人集体获胜

    美国中期选举中,多名主张严格监管数据中心的候选人获胜,包括俄亥俄州参议员 Sherrod Brown,以及佐治亚州和得克萨斯州州长选举中的民主党人 Keisha Lance Bottoms 与 Gina Hinojosa,后两人均主张暂停数据中心建设。NBC News 出口民调显示近四分之一选民将数据中心列为投票的关键因素,近三分之二表示是主要或次要因素。九个州的数据中心公投中,选民否决了未来建设计划并通过了暂停令,仅一个县在 ballot 上允许更多数据中心开发。

    对数据中心来说是一个糟糕的夜晚。在俄亥俄州,民主党人谢罗德·布朗数月来一直投放广告,称其对手是“俄亥俄州数据中心的代言人”,他轻松获胜,翻转了一个参议院席位。民主党人克里斯·帕帕斯在胜选演讲中提到了自己对数据中心的反对,他当选后将成为美国首位公开同性恋身份的男性参议员,这番话在新罕布什尔州的集会上引来人群的大规模嘘声——尽管该州并没有在建的大型数据中心。 在其他地方,两位分别名叫德里克和德里克的共和党人,其民主党对手给他们贴上了“数据中心德里克”和“华盛顿德里克”的标签,他们在俄亥俄州和威斯康星州的众议院竞选中落败。 作为昨晚令人震惊的蓝色浪潮的一部分,选民在各级政府选出了对数据中心持强硬政策的候选人,这明显是对该行业在全国各州扩张的斥责。近四分之一的选民告诉NBC新闻,数据中心对他们的投票“至关重要”,而近三分之二的选民表示这是主要或次要因素。 “对数据中心的反抗是2026年选举的首要议题之一,几年后我们回望时,会把它看作一场更大的AI地震颠覆美国政治的早期震颤,”得克萨斯州民主党众议员格雷格·卡萨尔在一份声明中说。 “在许多选民心中,数据中心和AI作为一种技术是根本关联的,”从事A

    匹配字段正文

星期三

  1. Google Blog

    Henry Cavill 用 Googlebook 打造 16-bit 游戏《Mustache Protocol》

    演员 Henry Cavill 用 Googlebook 的内置 AI 工具 Antigravity 和 Rambler,把口头创意变成可玩的 16-bit 游戏《Mustache Protocol》。Antigravity 可将自然语言提示词转为游戏机制,Rambler 负责语音转文字整理思路,Magic Pointer 用于选取和组合画面元素,Continue On 支持在 Android 手机与 Googlebook 之间无缝切换。游戏完成后上线,11 月期间每次游玩 Google 会向 Movember 捐赠 $11,上限 $500,000,用于男性心理健康、自杀预防、前列腺癌和睾丸癌相关项目。

    打造一款名为《Mustache Protocol》的复古电子游戏。他使用内置工具将口头创意转化为游戏机制、设计角色并完善视觉效果。你可以在我们的新视频系列中观看他推进这个项目的进展。游戏上线后,你可以通过游玩来帮助我们为男性健康倡议筹集资金——这是我们与 Movember 合作的一部分。 摘要由 Google AI 生成。生成式 AI 仍处于实验阶段。 探索其他风格: 演员、制片人兼科技爱好者 Henry Cavill 一直在把 Googlebook 推向极限考验, 而有一点已经变得很清楚:在这台笔记本电脑上,从想法到行动毫不费力。当然,Henry 想进一步挑战 Googlebook 的极限。但他能否把一个餐巾纸上的游戏构想,变成一款在他的 Googlebook 上完全可玩的 16 位电子游戏? 借助 Antigravity 等内置 AI 工具(可将自然语言提示词转化为可运行的 16 位游戏机制),以及 Rambler 这款能润色原始想法的语音转文字工具,Henry 踏上了将他的复古街机梦想变为现实的旅程——当然,还有 Google 的一点帮助。 来看看《Mustache Protoc

    匹配字段正文