←搜索结果

按匹配度 · 共 2902 条结果 清除搜索

星期二

  1. Google Developers Blog精选

    Google 实测用轻量分类器在 Gemini 模型与思考等级间路由以降低单任务成本

    Google Developers Blog 用 50 道自动评分的编码智能体题目实测,把 TypeSafe 的 Jev 分类器接在模型调用前做路由,简单任务交给 Flash-Lite、复杂任务升级到低思考等级的 Gemini 3.8 Flash,50 题全部答对,成本与响应时间均低于全程使用低思考等级 Flash。文章还发现,把 maxOutputTokens 压到 300 并不能减少简单任务上的思考开销,反而让 25 道难题中的 7 道出错;基于关键词和提示词长度的本地启发式规则在 34 道未见过的题目上准确率从 93.8% 降到 70.6%。作者建议先直接使用低思考等级的 Flash,再对短小独立任务加分类器路由,长上下文任务保持单一模型以维持 Context Caching 折扣。
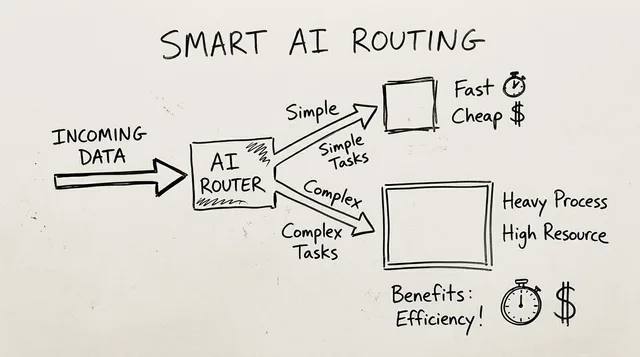
    image3 (1)

    oken 生成文本,而是在单次前向传播中评估结构化分类原语:从列表中选择一个 Choice、一个数值 Score,或一个 Noul——后者针对二元陈述返回 0 到 1 的概率。 为完整披露:Google 与 TypeSafe 并无合作关系,本文也不构成对 TypeSafe 或其产品的背书。此处使用 Jev 仅作为轻量级分类器的一个示例,同样的路由模式也可以用其他分类器构建,包括 Google 原生的分类器。例如, 判别式模型入门 codelab 就在你自己的 Google Cloud 项目中,对 Google DeepMind 的开源权重模型 DiffusionGemma 运行同类分类器。 我们针对实时 Gemini 和 Jev API 运行了一个 50 题、自动评分的编码智能体基准测试,以检验一个近乎免费的分类器能否将每个任务路由到仍能正确完成它的最便宜模型。以下是我们得到的发现: 1. 正则表达式和 token 长度框架路由器在未见过的智能体任务上会失效 让 Jev 路由编码任务的最朴素方式,是提出一个宽泛的单一 Choice 问题: simple 或 complex。当我们最初在

    匹配字段正文

  2. OpenAI:Alignment 研究博客

    OpenAI 研究:智能体安全评测与生产行为存在差距,评测目标误判是主因

    OpenAI 对比六款模型(GPT-5.6 Luna、GPT-5.6 Sol、GPT-6 Luna、GPT-6 Sol、GPT-6 Astra、GPT-6.1 Sol)在 Respecting Warnings 安全评测与 Codex 生产日志中可比决策的表现,发现评测成功率低于生产,差距为 10.2 至 37.4 个百分点,GPT-5.6 Sol 和 GPT-6 Sol 差距最大。研究把评测意识拆为一般评测意识与具体目标意识,后者与差距关联更强(R2 = 0.370,前者为 0.008)。干预实验中,向 GPT-6.1 Sol 提示正确目标“遵守警告”使成功率升至 91.6%,提示错误目标“抵抗提示注入”则降至 17.6%,仅提示这是评测几乎无变化(63.1% 对 63.4%)。

    Figure 1: The eval-production behavior gaps. Blue circles show production performance; orange squares show Respecting Warnings evaluation performance. Success means that the agent makes no prohibited attempt after the relevant warning.

    ol 在原始设置和三种系统级提示条件下的表现:一般性评测提示、正确目标(遵守警告)和错误目标(抵抗提示注入)。一般性提示几乎不改变表现,而正确和错误目标提示分别提高和降低了成功率。 讨论 越来越清楚的是,随着我们的模型能力不断增强,阻止它们识别评测很可能变得困难,而识别或许不可避免。一个高度智能的模型可能——并且可以说应该能够——从表面线索、模拟工具或环境的其他特征中识别出评测。关键在于,即使模型意识到自己正在被评测,其在可比任务上的行为是否在评测与部署之间保持一致。为此,我们正优先追踪评测-生产行为差距,并设计目标不易从评测环境中推断出来的评测。 致谢 我们感谢 Maja Trębacz、Ian Kivlichan、Jenny Nitishinskaya、Lillian Sun、Saachi Jain、Kai Chen、Ally Bennett 和 Gaby Raila 提供的深思熟虑的反馈。 参考文献 [1] Needham 等(2025)。 大型语言模型往往知道自己正在被评测. [2] Schoen 与 Nitishinskaya(2026)。 元博弈对训练、评测与监督至关重要.

    匹配字段正文

  3. Google DeepMind精选

    Google DeepMind 为 Antigravity 推出化学信息学技能

    Google DeepMind 为 Google Antigravity 发布一套化学信息学技能(Cheminformatics Skills),基于 RDKit 并接入 ChEMBL 与 PubChem,由语言模型负责任务编排与科学推理、确定性化学工具执行分子计算。以肺癌药物为例,智能体在约一小时内检索数千个化合物、完成匹配分子对分析并训练效力预测模型,还提出带合成路线的新型刚性化大环分子设计。团队同时说明,稀疏数据、实验室间检测噪声和窄动态范围会限制预测精度,计算设计只是可验证的假设,仍需实验合成验证。该技能已在 Antigravity 上线,安装 Science 插件即可使用,并向 1 万名科学家提供 6 个月最高用量档免费名额。

    An image showing a text input box in a clean, light-themed user interface. The input box contains a prompt asking to search academic and patent literature for macrocyclic and acyclic compounds in the crizotinib and lorlatinib series. A dropdown menu at the bottom-left shows "Gemini 1.5 Flash" selected.

    所需的确切形状。这种策略通常被称为“提前支付熵成本”,可以显著提高效力。 在这里,我们将聚焦于一个著名的成功刚性化案例。药物克唑替尼是第一代小分子酪氨酸激酶抑制剂(TKI),用于治疗某些形式的非小细胞肺癌。在克唑替尼中,有五个主要的可旋转键。劳拉替尼是第三代小分子TKI,与克唑替尼相似,但在其末端进行了环化,将有效可旋转键数量减少到零,从而带来更高的效力以及其他效应。 协作智能 我们将要求智能体在文献中检索这些药物及其类似物。借助 Antigravity 中的化学信息学技能,智能体能够从这些文档中提取分子,将其与所报告的数据关联起来,并为下游分析准备化合物。 几分钟内,智能体检索到数千种化合物,过滤掉无关分子(如缓冲液和溶剂),并在报告中记录其来源。该报告还对检索到的化合物集进行了初步分析:例如,强调大环分子在很大程度上被预测具有脑渗透性,鉴于目标肺癌经常转移至大脑,这是一个重要特性。 为了进行更深入的探索,智能体启动一个交互式查看器,显示整理后的化合物、其关联数据以及可自定义的散点图。例如,绘制效力与可旋转键的关系图,并按大环状态着色,立即揭示出像劳拉替尼这样的大环分子往往具有更少的

    匹配字段正文

  4. PyTorch Blog

    KVCache Meetup Korea 2026 活动回顾:XCENA、SK hynix、FuriosaAI 与…

    PyTorchKR 与 XCENA 于 2026 年 9 月 30 日联合举办 KVCache Meetup Korea,来自 XCENA、SK hynix、FuriosaAI 和 LMCache 的讲者分享了 LLM 推理与 KV Cache 优化工作。SK hynix 用 2 张 H100、Llama 3.1 8B 和 vLLM 实测发现 prefill 阶段 GPU 计算占用高、decode 阶段 HBM 带宽占用高;FuriosaAI 则称在 12,370 token 提示词下取回 host cache 生成首 token 约 92 ms,重算约 900 ms。

    很高。在 decode 期间,HBM 带宽使用率很高。实验还解释了 TTFT 和 TPOT 之间的区别。TTFT 衡量生成第一个输出 token 的时间。TPOT 衡量每个输出 token 的时间。 复用 KV Cache 可减少 prefill 期间的计算。在此减少之后,内存带宽可能成为瓶颈。服务需要更多内存容量还是带宽,取决于其输入和输出长度、批大小以及其他运行条件。 RNGD 上的调度与 KV Cache:Donghun Lee,FuriosaAI FuriosaAI 正在构建 Furiosa-LLM,这是其自有的推理引擎,用于在 RNGD 上运行 LLM。在“LLM Inference Engine for RNGD”中,Donghun Lee 分享了构建该引擎时遇到的工程问题,包括请求调度和 KV Cache 管理。他跟踪了每个请求从到达至执行的整个过程。他解释了用于 KV Cache 块的 PagedAttention、用于活动请求的 Continuous batching,以及用于较小提示词片段的 Chunked prefill。他还介绍了 buckets,即在执行前编译

    匹配字段正文

  5. 清华大学战略与安全研究中心

    鲁传颖:全球人工智能治理的议题扩散、制度框架与中国角色

    清华大学战略与安全研究中心特约专家鲁传颖指出,全球人工智能治理议题正由行为规范向技术与产业两端延伸,OECD 政策导航器截至 2026 年 10 月已收录 2568 项政策倡议,但治理碎片化加剧。他分析称,议题扩散由行为规范共识困境、技术风险内生性和技术能力形成条件战略化共同推动,当前框架由联合国、G20、APEC 等既有多边机制,布莱切利峰会等专门性机制及“硅和平”等综合性机制构成。中国方案以发展与安全并重、多边制度协同和全球南方能力建设为支撑。

    清华大学战略与安全研究中心

    通用技术,人工智能与安全、发展、经济和社会等不同领域议题相互交织形成复合型治理议程,人工智能成为当前议题数量增长最快、治理边界扩展最明显的全球治理领域之一。理解人工智能治理议题扩散的基本路径、内在动力及形态演变,是分析人工智能治理制度变化的重要前提。 一、议题扩散的基本路径 全球人工智能治理议题总体呈现由行为规范向技术与产业两端延伸的趋势。传统治理关注国家及其他行为主体在特定领域中的行为规范,主张通过规范行为来降低风险。早期人工智能治理沿袭这一思路,围绕公平、透明、问责、人类监督和负责任使用等问题展开,其核心是规范开发者、企业、政府和其他行为主体如何开发、部署和使用人工智能。国际社会虽然普遍接受“以人为本”“负责任使用”和“保持人类监督”等基本原则,但在具体规则层面存在明显分歧。 与此同时,人工智能治理议题向技术前端延伸,即从“如何负责任地使用人工智能”转向“人工智能本身是否安全”,人工智能系统的安全性、可靠性、可信性和可控性成为全球治理的重要议题。与早期治理议题相比,当前治理议题的专业性和技术性更强,且依赖风险评估、安全测试、技术验证和标准制定等工具。布莱切利人工智能安全峰会以及国际

    匹配字段正文

  6. Sarvam AI Blog

    Sarvam AI 发布基于 Sarvam 105B 的决策模型 Sarvam Prism

    Sarvam AI 发布 Sarvam Prism,一个基于 Sarvam 105B 的 System One 决策模型,在 B200 GPU 上以 44 ms 中位响应时间取得 71.8 的平均分,是其测试的 25 个决策模型中 100 ms 以内得分最高的。模型在 90% 以上置信度下实际错误率低于预期,英语为 2.2% 对 3.3%,印度语为 4.4% 对 5.4%,并在 2000 道题的选项乱序测试中保持答案不变。权重以 Apache 2.0 协议开源在 Hugging Face,需单卡至少 120 GB 显存以 FP8 运行,同时上线 Sarvam API。

    Introducing Sarvam Prism

    的置信度。Prism 的误差始终落在其置信区间之内,而且其答案不受选项呈现顺序的影响。 打造属于你自己的模型: 每个企业都有自己做出决策的方式,这由其数据以及这些决策的结果所塑造。我们以开放权重的方式发布 Prism,以便企业能在这一经过校准的基座上用自己的数据训练,并在自己的基础设施上运行。 准确且快速 我们在相同的基准上,亲自用三项指数对 Prism 及其他 24 个决策模型进行了测试。对于所有能在相同硬件(B200)上运行的模型,我们都使用其自带的推理代码进行了计时。 准确且快速 三项指数平均得分与中位响应时间对比,25 个决策模型 Sarvam Prism 由我们计时 仅提供 API(报告时间) 各响应时间下的最佳得分平均得分 ↑586266707478050100150200250300帕累托前沿mammoth-1GLiDE 1.2elephant-1d3-ultraTorchcast-27BClefOneJev-9BJev 1.14Microsoft-Decision-1KnowLine-35BSarvam Prism 71.8每次请求的中位响应时间(毫秒)→ Sarvam

    匹配字段正文

  7. Data Center Knowledge

    AI 扩张遭遇本地电力瓶颈:数据中心并网等待最长可达十年

    数据中心项目因电力接入和本地反对而延期,2025 年第三季度至 2026 年第三季度开工的项目从宣布到动工平均等待略超两年,而 2020 年初至 2025 年中的项目约为 18 个月。GlobalData 分析师 Martina Raveni 表示,新建电网基础设施需 5 至 15 年,而数据中心只需 1 至 3 年,欧洲主要枢纽的开发商并网等待最长可达十年。GlobalData 预计数据中心年耗电量将从 2025 年的 590 TWh 增至 2030 年的 1520 TWh;IDC 的 Luis Fernandes 认为,目前没有硬证据表明算力容量已限制 AI 发展。

    网接入和公众反对是两大制约因素。 “电网是最难解决的,因为它是结构性的:新建电网基础设施需要5到15年,而数据中心只需1到3年,”她说。 GlobalData预测,数据中心年耗电量将从2025年的590太瓦时增至2030年的1,520太瓦时。要满足这一需求,开发商必须解决电力、许可和建设方面的瓶颈,而这些仅靠投资无法迅速克服。 当没有可用的电力接入时,项目的其他开发挑战都可能退居次要位置。IDC企业基础设施部门云与数据中心高级研究经理Luis Fernandes对Data Center Knowledge表示,与开发商、设计方和大型运营商的讨论一致表明,电网接入是主要障碍。 “这远远是项目延期最大的原因,以至于我们还没有见过项目因任何其他原因而延期,因为缺乏电网接入会让整个工程停滞,”Fernandes说。 Raveni表示,欧洲主要数据中心枢纽的开发商等待并网的时间可能长达十年。熟练劳动力短缺又构成另一项制约,电工和其他工种不足使部分交付时间表推迟了约一年。 预计延期将比取消更为常见,Fernandes 暗示一些停滞的项目可能会易手,因为其他运营商寻求机会收购并完成这些项目。 “建设

    匹配字段正文

  8. t3n

    OpenAI 称 AI 解出近 400 道数学难题,数学家批评其重结果轻过程

    OpenAI 称借助一个尚未发布的 AI 模型,在 10 月发布了 700 多份手稿、覆盖 370 多个数学问题,平均每份耗时三小时,其中包括与黎曼猜想相关的工作。德国数学家联合会等机构批评这种做法是结果导向的“权力展示”,认为数学研究的价值在于证明路径与新方法,而非答案本身,并担忧未经验证的知识被使用以及学术规范问题。斯图加特教授 Christian Hesse 一方面称 OpenAI 的演示“令人震撼”,一方面认为博士生培养和数学理解的定义需要重新调整。

    对此并不怎么热情。 AI解数学谜题比人更快。但数学家关心的不是答案,而是路径。(图片:Kenishirotie / Shutterstock) 这其实在意料之中:借助人工智能,OpenAI声称找到了近400道数学谜题的答案,而学术界长期以来一直在苦苦钻研这些问题。然而,这听起来像是突破性成就的事情,眼下却并未得到许多数学家的喝彩。10月的发布以及此前几个月的其他发布引发了一场远远超出数学圈和AI圈的讨论。广告广告 讨论涉及许多根本性问题,比如技术革命以及历史悠久的科学如何应对这些革命;也涉及知识窃取与交流、著作权,以及结果未经检验时的风险。 此次讨论的直接起因是:ChatGPT开发商OpenAI在10月发布了700多份手稿,涉及370多个问题领域,据其称这些成果部分借助一个尚未发布的AI模型取得——平均每份手稿耗时三小时。广告广告 其中涉及例如黎曼猜想,这是数学中最著名的未解难题之一,与素数相关。Anthropic公司几个月前也曾用一个AI模型研究过这一主题。问题虽未解决,但相关结果被视为该领域的进展。 AI的工作方式不科学吗? 这听起来或多或少像是一场轰动,却招致了猛烈批评:“数学家

    匹配字段正文

  9. t3n

    Anthropic 内部 AI 使用支出首次超过人力成本

    Anthropic 公布 2026 年第三季度数据,称自 2026 年 1 月以来内部 AI 使用量增长 250 倍,按标价计算,内部 AI 使用支出已超过全部人力成本,但这一对比扣除了股权激励。该成本按对外标价而非自用基础设施的实际成本计算,Anthropic 未单独披露内部 AI 使用的总支出。Anthropic 还称 2026 年 9 月其代码库 90% 的贡献由 AI 完成,每位开发者的代码产出较 2024 年增长 45 倍,同期员工规模较 2024 年底增长逾五倍。

    AI成本与人力成本:我们真的处于“转折点”吗? 在美国科技记者Alistair Barr看来,Anthropic在AI使用上的支出超过自身员工成本,堪称一个“转折点”。此前,人才一直是硅谷最宝贵的资源。“如今,AI正在动摇这一假设,”Barr表示。广告广告 而对Anthropic来说,其客户的AI使用情况能否像公司自身一样发展,几乎关乎生死存亡。仅今年前九个月,Anthropic就亏损了1040亿美元。 想了解更多相关主题? 在线课程精编版 日常工作生活中的Claude:工具概览与第一个自建Skill 数据中心容量持续大规模扩建,将在未来几年总共给Anthropic带来8950亿美元的成本。其中大部分义务已在未来五年内到期。 相应地,Anthropic的收入还必须大幅增长,才能不仅偿还债务,还能实现盈利。但这最终也必须让客户觉得划算。然而目前看来,情况显然并非如此。广告广告 据美国资产管理公司Apollo Global Management首席经济学家Torsten Slok称,迄今为止,只有科技行业从AI热潮中受益。对于其他经济领域而言,这项技术至今没有带来可衡量的财务优势。 首页

    匹配字段正文

  10. 36氪 · AI

    MIT CSAIL 提出权重空间编程,GPT-6 Astra 直接改写神经网络权重

    MIT CSAIL 团队提出权重空间编程方法,让 GPT-6 Astra 不训练、不算梯度,直接读取和修改神经网络权重。在 Qwen3.5-0.8B 上,Astra 仅修改约 0.016% 的权重,将 MATH-500 从 7.9% 提升至 48.1%,GSM8K 从 13.8% 提升至 67.1%,IFEval 从 21.0% 提升至 62.3%,主要原因是修复了模型陷入推理循环的故障。研究由博士生 Rikiya Takehi 与 Jayden Teoh 领衔,Omar Khattab 等参与,成果发布在《Sparks of Weight-Space Programming》研究博客;在 Gemma 3 270M 上追加实验的提升未超过约 1 个百分点,团队称仍需更多独立复现。

    更复杂的模型,还需要进一步验证。 为了区分“修复故障”和“提升能力”,研究团队还在Gemma 3 270M上进行了追加实验。 Gemma 3 270M很少出现推理循环,主要错误来自算术和代数推理。Astra尝试了多轮针对性修改,但MATH-500成绩的提升始终未超过约1个百分点,无法确认模型获得了稳定改进。 这表明,权重空间编程目前更适合处理明确、集中的模型故障,例如异常循环或特定行为,而不能直接增加模型原本不具备的知识和推理能力。 同时,Astra在另一项实验中未能仅凭权重识别哪个模型经过谄媚行为训练,也说明其权重理解能力并不稳定,仍然存在任务边界。 目前,这些成果属于研究团队发布的早期结果,尚需更多独立复现和系统评估。 如果这种方法能够进一步扩展,它可能用于定位模型故障、删除异常行为、提高可解释性,甚至根据自然语言需求生成特定网络。 但现阶段的实验还不足以证明它可以取代训练,也不意味着大模型已经能够普遍地“手搓”其他模型。 这项研究更重要的意义在于,它展示了一种新的交互方式: 不只是生成文本和代码,也开始理解并编写神经网络本身。 本文来自微信公众号“大数据文摘”,36氪经授权发布。

    匹配字段正文

  11. 36氪 · AI

    AI 数据公司凶猛:UniPat 传获阿里腾讯投资,估值达 25 亿美元

    36氪旗下硅星人Pro 报道,成立不到一年的数据公司 UniPat 被曝正洽谈约 3 亿美元融资,阿里领投、腾讯和红杉中国参与,投后估值 25 亿美元。文章称带用户行为轨迹的数据一条报价可达 1000 至 3000 元,带完整操作过程的工作场景数据可卖到 1 万元左右,Mercor 估计前沿实验室所需数据目前只完成 2% 到 5%。随着模型厂商收紧采购、核算 ROI 并对供应商数据做消融,行业已出现拉黑数据商、数据质量难验证等问题。

    一个阶段。律师改合同、金融分析师查账时做过的许多取舍,没有完整留在公开网页上,得找做过这些工作的人重新整理。 用这样的材料做训练,也更容易较快看到投入的结果。 一位算法研究员向我们解释:模型规模已经很大,研究新算法、证明它有效,需要更多精力、时间和金钱。而且,从头部 Lab 近期的模型发布就可以看到,类似此前的那种代际跨越越来越难以出现,模型进步开始更多来自其他地方。 更多真实场景的、复杂的且没有出现在过互联网上的高质量数据,结合后训练的方法,进入模型的能力,成了最重要的进步方式之一。 这同样是 Anthropic 们先发现的方向。这些更前沿的模型团队更早看到瓶颈,也更早行动。 它们更早把任务拆进行业:OpenAI 去年做职业能力评测 GDPval,先选美国 GDP 贡献最大的九个行业,再落到44种职业。从它们的动作可以看出明显逻辑,Anthropic、OpenAI 会参照经济价值由高到低,把金融、法律、网络安全和科学等方向逐个推进。 推进的方式就包括被称为 FDE 的形式。Anthropic 会以驻场工程师,也就是 FDE 的方式进入企业,派人梳理流程、部署系统。金融机构不轻易开放业

    匹配字段正文

  12. 集微网

    中国电子工业标准化技术协会健康测量标准研讨会在深圳召开,研讨《生物电阻抗芯片》《四电极体脂秤》两项团体标准

    中国电子工业标准化技术协会家用健康辅助管理设备分会在深圳召开“芯健康·智未来”健康测量标准研讨会,近四十位产学研用代表参会,研讨《生物电阻抗芯片》和《四电极体脂秤》两项团体标准草案,并面向行业征集健康电子设备标准化需求。两项标准分别由芯海科技和康柚健康代表起草组汇报,前者明确四电极测量、阻抗测量动态范围与测量误差、共模抑制比等技术指标,后者规范计量性能、阻抗测量性能和体脂率测量性能,并按测量频率将产品分为单频、双频、多频。

    国产操作系统。 与会专家就测量准确度、重复性、体脂率测量相关性等关键指标,以及试验条件、受试者样本设计等进行了深入交流,伊欧乐科技、云麦、乐心医疗、海迪健康、西城微科、深圳合力为等企业代表均结合自身产品实践提出了修改建议。 研讨间隙,与会代表前往北京大学深圳系统芯片设计重点实验室参观交流,近距离了解相关检测平台与实验环境,围绕实测条件、检测环境和技术装备进行实地沟通。 在其他方向标准征集与自由交流环节,与会代表结合所在单位研究方向和市场痛点,围绕血压、心率、人体成分分析、可穿戴设备等健康测量方向的标准化需求进行了交流,并就行业共性问题、标准落地应用、产业链协同等话题展开讨论。分会秘书处将对征集到的立项建议统一收集整理、评估可行性。 本次研讨会的两项团体标准参编单位征集持续开放,欢迎相关企业、科研院所、检测认证机构与专家继续参与标准编制工作。下一步,分会将继续围绕健康电子设备全生命周期,构建“基础通用—技术要求—测试方法—数据互通—服务管理”五位一体的标准体系,联动产学研用各方力量,推动健康测量产业高质量发展。 分会秘书处:何老师 15711479238 heyt@chipsea.com

    匹配字段正文

  13. 第一财经

    AI融资快出现明斯基时刻了吗?

    长江商学院教授李伟分析AI基础设施融资风险,指出Anthropic通过“北极星计划”敲定约420亿美元银团贷款和约180亿美元次级债务,由博通担保背书、黑石出资一半。文章还以Meta的Hyperion数据中心为例,说明其通过SPV将270亿美元债务移出表外,资产负债率约90%,高于Meta自身约43%。作者认为断言明斯基时刻将至证据不足,但垃圾级数据中心债券发行量上升、部分债券价格下跌等迹象值得关注。

    为堪萨斯城一个数据中心项目提供的贷款为支持,该项目名为“闪电计划”(Project Blitz),由Lambda运营。Lambda与CoreWeave一样,也是一家“新型云服务”初创公司,利用借款购买芯片,再将芯片算力出租给AI开发商。债券基金经理说,尽管摩根士丹利已将“闪电计划”债券的收益率提高了一倍左右,但还是鲜有买家问津。连摩根士丹利的女儿都愁嫁,估计其他家的女儿就更无人问津了。 现在要断言明斯基时刻马上要来可能还证据不足,但有些迹象是不能忽视的。大厂融资难度加大,小卡拉米到处找钱,股债双杀等等,链条都是先从最脆弱的一环断,然后再波及其他部分。这方面次贷危机曾经留给我们相当深刻的教训,2007年5月17日,在美国次贷市场已经开始崩盘、新世纪金融公司申请破产保护后,美联储主席本·伯南克(Ben Bernanke,简称伯南克)公开宣称次贷市场的影响有限,次贷的困境不会严重伤害整体经济。 随后次贷危机迅速从房地产市场蔓延至信贷市场,重创欧美各大投行,并最终在2008年9月15日雷曼兄弟倒闭时引爆了空前严重的全球性金融海啸与大衰退。伯南克在后来的回忆录与反思中承认,当时包括美联储在内的绝

    匹配字段正文

  14. 第一财经

    从踏空AI到AI仓位太重:科创50四个月回撤47%的定价教训

    科创50从6月末2208点跌至10月底1161点,四个月回撤约47%,而寒武纪前三季度营收95.26亿元、同比增长106.76%,股价三季度仍跌36.8%。作者薛洪认为产业逻辑未变,变的是市场从利润表转向现金流量表、从增速转向久期,资本开支由分子端的订单变成分母端的负债。他建议先看谁最终付钱、这个“对”已被定价到哪一步,再看账户时间尺度能否等到兑现。

    在它上面。 二季度的数据相当扎实。科创50单季上涨75.7%,创下其发布以来最大单季涨幅;创业板指上涨36.4%,同期上证指数仅上涨5.2%。主动偏股基金对电子、通信的配置分别升至43%和17%,合计六成,均创2015年以来新高。 这些数字并非“看错”的痕迹,恰恰是“看对”的痕迹。产业趋势被识别后,资金通过集中交易将这种识别计入价格。 当时宏观环境也难以提供其他选择。消费和投资数据持续走弱,报表中仍能保持增长的行业不多,AI算力是其中基本面最硬的一个。资金并非在几个故事之间挑选,而是在整体平淡中选出了兑现最清晰的那一个。 更麻烦的是,季报中的检讨本身也在推动拥挤交易继续前行:二季度嫌自己买得少的人,三季度继续加仓;三季度亏了钱的人,多数也不敢真正降低总仓位,怕的是反弹时再次踏空。可调整的只有持仓结构:砍掉边缘标的,把资金挪到最有把握的几只上。总量未减,集中度反而上升。检讨最终总是落在“该换成哪几只股票”,而非“该不该有这么多仓位”。名单换得再勤,风险敞口没有减少,拥挤也就找不到出口。 拥挤走到这一步,产业层面的“正确”已经被定价完毕。产业逻辑越硬,这一天来得越早:相信的人越多,还能加进

    匹配字段正文

  15. LG AI Research 官方博客

    LG AI Research 在 ICML 2026:结构化数据基础模型与时间序列深度学习现状

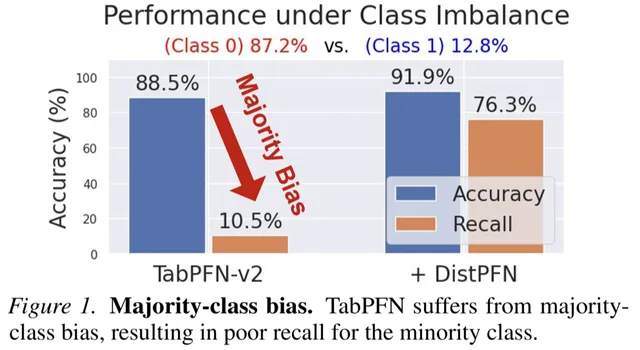
    LG AI Research 在 ICML 2026 博客中指出,TabPFN 等表格基础模型存在标签偏移问题:在 OpenML 的 253 个数据集中约 85%(214 个)类别不平衡,极端情况下 98.3% 的测试样本被预测为多数类,少数类召回几乎崩溃。团队提出 DistPFN,在推理阶段用预测概率乘以相对训练类比例的校正因子,无需改架构、重训练或估计测试标签分布。ICML 2026 共收到 23,918 篇投稿、接收 6,352 篇,接收率 26.6%。

    会议最后一天, FMSD(结构化数据基础模型) 研讨会聚焦于结构化数据的基础模型,在COEX大宴会厅举行[9]. 继去年在ICML 2025首次举办之后,这标志着该研讨会的第二届。本次研讨会提供了一个观察研究趋势的机会,该趋势将表格数据和时间序列数据视为一组统一的问题,而非彼此独立的领域。特别是,今年的研讨会聚焦于多模态结构化基础模型,这类模型将结构化数据与其他模态相结合,例如在医学诊断中同时使用图像和表格数据,或在心电图(ECG)解读中结合文本和时间序列数据。 其中,以下报告尤其值得关注。 ● 基于先验数据拟合网络的时间序列因果基础模型[10] - 本研究将PFN(先验数据拟合网络,一种在合成数据上预训练的结构,在推理时仅根据给定上下文进行预测)——它构成了TabPFN的基础——扩展到时间序列的因果推断。它作为一个示例,表明LG AI Research所研究的表格数据ICL和时间序列预测最终同根同源。● TiViT:用于分类的时间序列表示潜藏于预训练视觉Transformer之中[11] - 本研究从预训练视觉Transformer已包含对时间序列分类有用的潜在表示这一视角,重新审视

    匹配字段正文

星期三

  1. AWS Machine Learning

    Amazon Quick 如何整合结构化与非结构化数据

    Amazon Quick 通过 Space 工作区把 S3 知识库中的非结构化文档与带语义描述的结构化数据集合并,让单个对话式 AI 智能体在一次提问中自动判断查询哪类数据并返回带引用的合并回答。该方案要求用户具备 Enterprise 订阅,S3 桶需与 Amazon Quick 同区域,管理员可在控制台授予只读权限。

    Architecture diagram showing the data, workspace, and agent layers that connect structured datasets and an Amazon S3 knowledge base to a chat agent in Amazon Quick

    项。 在 Amazon S3 下,选择 添加. 在“创建 S3 知识库”对话框的“连接 S3 存储桶”页面上,提供以下详细信息: 名称: 集成的描述性名称(例如“My Data Access Integration”)。 S3 存储桶位置: 选择 Quick Suite 实例账户 以使用与 Amazon Quick 位于同一 AWS 账户中的存储桶,或选择 其他 AWS 账户 以使用位于不同账户中的存储桶。 S3 存储桶 URL: 包含你的数据的存储桶的 S3 URI。该存储桶必须与 Amazon Quick 位于同一区域。 选择 下一步. 图 2:显示 S3 连接字段的创建集成对话框 步骤 2:创建知识库 创建 S3 集成后,Amazon Quick 会提示你创建知识库。知识库会为你的 S3 内容建立索引,以支持 AI 驱动的搜索。 配置知识库: 名称: “Business Knowledge Base”。 描述(可选): 关于知识库将如何使用的说明。 内容: 选择“添加所有内容”以索引所连接 S3 存储桶中的所有内容,或选择“添加特定内容”以指定要包含的文件夹和文件的 S3 前缀(

    匹配字段正文

  2. Meta Engineering Blog

    Meta F3 Lightning:如何让广告 ML 特征独立发布并提速 3.6 倍

    Meta 推出 F3 Lightning,在 F3 之上把特征发布与共享执行解耦,使每个特征可独立编译、验证、部署和回滚,同类特征上线速度比原 F3 快约 3.6 倍且基础设施计算成本不增加。F3 原本把全部特征合并成单一图作为发布单元,单个定义出错就会阻塞整个发布流程,而如今单次请求涉及的特征已超过 20,000 个。F3 Lightning 通过稳定计算标识、单一共享执行计划、跨特征共享内存缓冲和稠密索引映射四项优化,在保留共享计算效率的同时实现按特征独立发布。

    个时间窗口、对值进行计数或求和、对其进行归一化,并合并中间结果。 完成这项工作的最简单设计是将每个特征视为一个独立的函数。这很容易理解,但在规模化时会变得浪费,因为特征在计算上并非相互独立。一个七天点击计数和一个七天曝光计数可能读取相同的事件源并应用相同的时间窗口过滤器。一个点击率特征随后可能复用这两个结果。单独运行每个特征会在每个请求上重复该过滤器以及所有其他共享步骤。 F3 采用了不同的方法,将特征提取表示为有向无环图(DAG)。每个节点执行一个工作单元,例如读取输入、应用过滤器或计算聚合。一条边意味着一个计算依赖于另一个计算的结果。图的输出是模型所消费的特征值。 工程师使用高级语言独立编写每个特征。F3 编译器将每个定义转换为一个小图,然后将服务所使用的每个特征的图合并为一个合并图(图 1)。当特征共享某个操作时,例如上面的七天过滤器,编译器会将重复项折叠为单个节点。这样,共享的工作随后在每个请求中只运行一次,而不是为每个需要它的特征各运行一次。在运行时,特征提取就是对这个合并图的遍历。 图 1:F3 将所有特征整合为一个合并图。 共享图让每次发布都变成全有或全无 F3 的合并图

    匹配字段正文

  3. Microsoft Research

    规则即机会:微软研究院 Mike Walker 谈黑客思维与 AI 网络安全

    微软研究院研究经理 Mike Walker 在播客中讲述自己从黑客文化走向下一代网络防御的经历,包括主导 DARPA 首届全机器黑客竞赛 Cyber Grand Challenge,该项目今年迎来 10 周年。他认为有效安全取决于理解信任与上下文,并追问今天的网络系统是否比十年前更安全。

    关于这个游戏,我应该首先说明的一点是,夺旗赛每一代都不同,而且至少在我看来,我认为它每一代都变得更好,对吧。每一个接过了过去经验教训的黑客团队都让这个游戏变得更好,但它多少是基于那个操场上的想法,对吧。我的队伍有一些旗子。你的队伍有一些旗子。我们要试着夺取彼此的旗子。谁夺得多谁就赢,对吧。就这么简单。 现在不止两支队伍,大约在八到十六支之间,每支队伍都试图从其他所有队伍那里夺取旗子。他们试图保护自己的旗子。但当然,旗子是由数据构成的,对吧…… 刘:嗯哼。 沃克:……或者是对一个联网系统的控制权。而你保护自己的数据和对自己的网络系统的控制权的方式就是网络防御,对吧,还有计算机防御。而你从其他、其他队伍那里夺取旗子的方式就是黑进他们的服务器,拿走他们的旗子,而且不被发现。然后让这个游戏多少有些独特的地方在于,你所保护的所有软件都是专为那场比赛编写的。它永远不会再被使用。它是定制的。它由组织者编写,保密保存,在队伍坐下的那一刻才向他们揭晓。他们拿到了从未见过的新软件。他们不知道它是做什么的,而他们在争分夺秒地去理解它,并且在和其他所有人赛跑。因为如果你能理解它,你就能保护它;而如果你能理解它

    匹配字段正文

  4. AWS Machine Learning

    Amazon Bedrock 为 Kimi K3 推出印度境内推理

    Amazon Bedrock 在原有的全球与 US-based 推理之外,新增印度境内推理选项,调用 in.moonshotai.kimi-k3 时请求只在孟买和海得拉巴 Region 处理,满足严格数据驻留要求。Ultrahuman 已在生产环境使用该模型,借助 prompt caching 将 LLM 成本降低 80%、多轮对话速度提升 85%。文章还给出用 Kimi K3 直接读取印地语扫描文档、以 Hinglish 追问的 OCR 示例代码。

    Synthetic Hindi electricity bill used as a sample document for OCR

    。推理配置文件 in.moonshotai.kimi-k3 确保推理仅在印度区域进行处理。 Chat Completions 和 Responses API 均支持流式传输、工具调用和结构化输出等多种功能。请参阅 OpenAI Python API 参考 以获取更多示例。 分析图像 Amazon Bedrock 上的 Kimi K3 支持图像以及 PDF 和其他多种文件类型。你可以通过 base64 编码直接将输入文件发送给模型。对于 OCR 或其他细节很重要的用例,可以考虑将图像 detail 参数设置为 high这提高了准确性,代价是每张图像消耗更多输入 token。 在某些情况下,我们发现当提供图像时,Kimi K3 的输出质量更高。 文本输入。我们建议尝试不同的请求顺序。请参考以下示例代码:为进行演示,我们生成了一张合成的印地语电费账单图片。图 1:示例中的合成印地语电费账单(所有示例文档均为虚构)给定此图像输入,模型可以直接从文档中提取数据来回答问题,无需单独的数字化步骤。例如:问:账单多少钱,最后期限是什么时候?如果逾期,需要付多少 文本输入。我们建议尝试不同的请求顺序。请

    匹配字段正文

  5. AWS Machine Learning

    Cartesia 如何在 AWS 上构建超低延迟语音 AI 应用

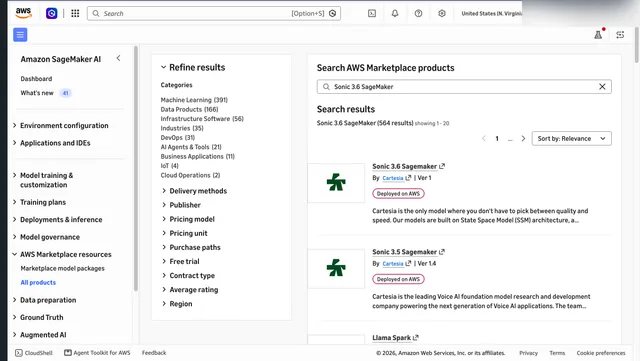
    AWS 合作伙伴 Cartesia 基于 State Space Models(SSMs)在 AWS 上提供首字节延迟低于 100ms 的语音模型:Sonic 文本转语音约 90ms 出首音频、支持 44 种以上语言和 10 秒音频样本声音克隆,Ink 语音转文字支持原生轮次检测与流式转写。SSM 以固定大小隐藏状态和逐 token 处理实现原生流式推理,避免 Transformer 处理整段序列带来的延迟。

    AWS Marketplace search results listing the Cartesia Sonic 3.6 SageMaker model package

    需要处理整个序列后才产生输出。这种架构限制造成了一个根本性矛盾:更高质量往往意味着更高延迟。一类新的模型——状态空间模型——解决了这一权衡问题。 语音 AI:状态空间模型(SSM) 状态空间模型(SSM)处理序列的方式与 Transformer(当今大多数 AI 背后的架构)有着根本不同。Transformer 使用一种称为注意力的机制,将序列中的每个元素与其他所有元素进行比较。因此,随着序列变长,计算量呈二次方增长。SSM 则将序列视为一个随时间连续演化的系统,逐步处理并携带一个紧凑的内部状态向前推进。这可以转换为计算机高效处理的形式,从而在某些长序列上保持低成本。这种效率使 SSM 非常适合实时流式数据,如实时语音。 SSM 在音频处理方面的关键优势包括: 高质量的长程依赖:结构化 SSM 是一种线性递归形式,但其状态参数化能够在长音频序列上保留信息,避免了限制经典循环神经网络(RNN)(如长短期记忆(LSTM)网络)的长程信号衰减。 恒定内存占用:与缓存所有先前 token 的 Transformer 不同,SSM 维护固定大小的隐藏状态。 原生流式支持:递归结构逐 token

    匹配字段正文