←搜索结果

按匹配度 · 共 3279 条结果 清除搜索

星期三

  1. Google Research精选

    Google 将 AMIE 推进到实时视频问诊,随机研究显示达到专家级水平

    Google Research 发布 AMIE (Video),基于 Gemini 和 Project Astra 实现实时视频临床问诊,可感知非语言线索、引导虚拟体格检查并同步进行诊断推理。研究采用异步多智能体架构,由三个专职智能体并行处理对话、推理与视听感知,以维持自然对话延迟。在 100 个场景、300 次实时问诊、30 名认证初级保健医生参与的随机 OSCE 研究中,临床评估者在病史采集、诊断准确性和沟通质量上给 AMIE (Video) 的评分与初级保健医生相当,在引导体格检查方面显著更高;患者演员更偏好视频界面。研究全部使用专业患者演员模拟场景,尚未在真实患者中验证。
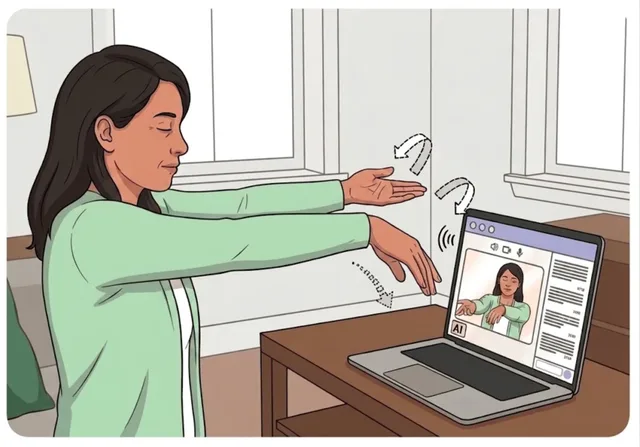
    Advancing AMIE towards expert-level audio-visual clinical consultations

    匹配字段摘要

  2. The Next Platform

    Nvidia 发布 Nemotron 3.5 Lightning 模型与 NeMo Switchyard 路由库

    Nvidia 发布 Nemotron 3.5 Lightning 开源模型和 NeMo Switchyard 路由库,前者面向持续运行的智能体任务,官方称在同级中实现 4 倍吞吐、完成智能体任务速度提升 30%,并可在 Jetson、GeForce RTX、DGX Spark 和 DGX Station 上本地运行。Switchyard 让开发者自定义模型池、路由标准和策略,把推理密集型步骤交给前沿模型、把执行类任务交给 Lightning,官方称其以 Anthropic Opus 4.8 约三分之一成本取得更好准确率。Nvidia 同时公开训练数据与方法,并发布用于训练编码智能体的开放数据集 Nemotron-RL-Agentic-Terminal-Pivot。

    匹配字段摘要

星期二

  1. Hugging Face

    考虑 ACE?ALTK-Evolve 能以更少 Token 实现

    ALTK-Evolve 通过按模型能力调整指南投放量,在 AppWorld 内部对比中以更低推理成本取得与 ACE 相当或更好的准确率。强模型配置的成本约为 ACE 的 40%,弱模型以约七分之一成本获得 56.0 分,对比 ACE 的 54.8 分。两者都保留带计数的经验指南,但 ACE 每步注入完整 playbook,ALTK-Evolve 可选择性检索或投放完整集合。

    ALTK-Evolve 通过按模型能力调整指南投放量,在 AppWorld 内部对比中以更低推理成本取得与 ACE 相当或更好的准确率。强模型配置的成本约为 ACE 的 40%,弱模型以约七分之一成本获得 56.0 分,对比 ACE 的 54.8 分。两者都保留带计数的经验指南,但 ACE 每步注入完整 playbook,ALTK-Evolve 可选择性检索或投放完整集合。 · ALTK-Evolve adjusts guideline delivery to model capability, achieving comparable or better accuracy than ACE at lower inference cost in an in-house AppWorld comparison. Its strong-model configuration cost about 40% as much as ACE, while the weaker model scored 56.0 versus ACE’s 54.8 at roughly one-seventh th

    匹配字段摘要

  2. LMSYS Blog精选

    SGLang 为 NVIDIA Nemotron 3.5 Lightning 提供 Day-0 支持

    SGLang 宣布为 NVIDIA Nemotron 3.5 Lightning 提供 Day-0 支持,开发者可通过其 OpenAI 兼容推理栈部署该模型。Nemotron 3.5 Lightning 是从 Nemotron 3 Ultra 蒸馏而来的 30B 混合 MoE 模型,每 token 仅激活 3B 参数,支持 MTP、DFlash、DSpark 三种投机解码,并可通过 enable_thinking 与 thinking_budget 控制推理开关和深度。模型权重已在 Hugging Face 提供 BF16 和 NVFP4 版本,官方称其在相近准确率下完成智能体任务最多快 30%。

    SGLang 宣布为 NVIDIA Nemotron 3.5 Lightning 提供 Day-0 支持,开发者可通过其 OpenAI 兼容推理栈部署该模型。Nemotron 3.5 Lightning 是从 Nemotron 3 Ultra 蒸馏而来的 30B 混合 MoE 模型,每 token 仅激活 3B 参数,支持 MTP、DFlash、DSpark 三种投机解码,并可通过 enable thinking 与 thinking budget 控制推理开关和深度。模型权重已在 Hugging Face 提供 BF16 和 NVFP4 版本,官方称其在相近准确率下完成智能体任务最多快 30%。

    匹配字段摘要

  3. 蚂蚁百灵:Developer Blog精选

    蚂蚁百灵开源 Ling-3.0-tiny:7.9B 总参数、1.3B 激活参数

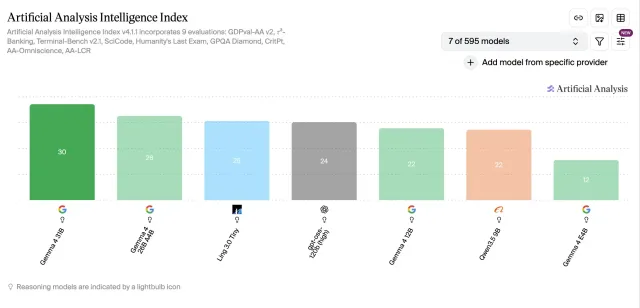
    蚂蚁百灵正式开源 Ling-3.0-tiny,这是一款总参数 7.9B、推理时仅激活 1.3B 参数的原生混合推理模型,同步提供 BF16、FP8 和 INT4 三个版本。官方称其在 Artificial Analysis Intelligence Index 获 25 分,Agentic Index 达 16 分,输出速度超过 160 tokens/s。模型可在单台 NVIDIA DGX Spark 上完成 FP8 推理,权重约 7.85GB,并已完成 Apple Silicon 的 MacBook 与 Mac mini 本地运行适配。

    图

    匹配字段摘要、正文

  4. Amazon Science

    AWS Trainium Frontier 竞赛:在专用 AI 芯片上协同设计模型与内核

    AWS 发起 Trainium Frontier 竞赛,要求研究者在专用 AI 芯片 Trainium 上从零训练语言模型,探索硬件约束改变时最优架构的差异。竞赛分两阶段:Phase 1 在单块 Trainium2 芯片上训练 30 分钟,比拼验证 bits-per-byte;Phase 2 前 10 名团队在整台 Trainium2 服务器上训练 4 小时,并加入 CORE 上下文学习推理性能评分,最终成绩为 50/50 综合分。冠军奖金 25,000 美元,颁奖仪式将在 NeurIPS 2026 悉尼站举行。

    匹配字段摘要

星期一

  1. NVIDIA Developer · Generative AI精选

    Meta 发布 30B 开源模型 Muse Glimmer,可在单张 NVIDIA GPU 上跑本地智能体

    Meta 发布 Muse Glimmer,一个 30B 开源权重稠密模型,上下文窗口 120K+,面向本地 AI 智能体工作负载。该模型采用稠密架构,每个 token 激活全部参数,在 NVIDIA Blackwell Ultra 上以 BF16/NVF4 精度实现单 GPU 超过 20K tokens/s,可完整放入单卡显存,无需模型分片、CPU offload 或外部端点,覆盖 GeForce RTX 5090、DGX Spark、DGX Station 和 Jetson 平台。开发者可用 NeMo AutoModel 做全量 SFT 和 LoRA 微调,权重已上线 Hugging Face,并提供 SGLang、vLLM 推理方案和可下载的 NIM 容器。

    匹配字段摘要

  2. Fireworks AI精选

    Meta 的 Muse Glimmer 30B 上线 Fireworks,面向常驻智能体

    Fireworks 上线 Meta 的 Muse Glimmer 30B 稠密模型,采用 Apache 2.0 许可,支持 128K+ token 上下文和原生图像理解,面向需要多轮工具调用的常驻智能体。该模型在 MCP Atlas 得 75.5、DeepSearch QA 得 74.6、SWE-Bench Pro 得 51.2,均高于 Gemma 4 31B 和 Qwen 3.6 27B 的对应成绩,这些基准数据由 Meta 报告。Fireworks 同时给出 temperature 1.0、top_p 0.95、top_k 64 的推荐设置,并支持在系统提示词中调节推理强度。

    Fireworks 上线 Meta 的 Muse Glimmer 30B 稠密模型,采用 Apache 2.0 许可,支持 128K+ token 上下文和原生图像理解,面向需要多轮工具调用的常驻智能体。该模型在 MCP Atlas 得 75.5、DeepSearch QA 得 74.6、SWE-Bench Pro 得 51.2,均高于 Gemma 4 31B 和 Qwen 3.6 27B 的对应成绩,这些基准数据由 Meta 报告。Fireworks 同时给出 temperature 1.0、top p 0.95、top k 64 的推荐设置,并支持在系统提示词中调节推理强度。

    匹配字段摘要、正文

  3. LMSYS Blog精选

    SGLang 为 Meta 多模态模型 Muse Glimmer 提供 Day-0 支持

    LMSYS 宣布与 Meta Superintelligence Labs 合作,为 30B 参数多模态模型 Muse Glimmer 在 SGLang 上提供 Day-0 支持,并针对本地智能体工作流推理做了专门优化。在 NVIDIA GeForce RTX 5090 上,SGLang 以 NVFP4 加 DFlash 实现最高 1,452 tok/s 总输出吞吐和 236 tok/s 单用户解码速度,DFlash 将 batch-1 交互性提升 1.9 至 4.3 倍。模型可在 RTX 5090、RTX PRO 6000、DGX Spark 的 SM120 后端以及 Apple Silicon 的 MLX 后端部署,提供 BF16、NVFP4+MXFP8、NVFP4 及 GGUF 等多种 checkpoint 格式。

    匹配字段摘要

  4. Ollama Blog

    Meta Superintelligence Labs 首个开源模型 Muse Glimmer 上线 Ollama

    Meta Superintelligence Labs 的首个开源模型 Muse Glimmer 已在 Ollama 上线,这是一个 30B 多模态模型,面向本地运行的智能体工作负载,上下文长度 128K+,采用 Apache 2.0 许可。它可用于 Claude Code、Codex、Pi 等编码智能体,以及 OpenClaw、Hermes 等长期运行的个人助手,并支持 low、medium、high、xhigh 四档可控推理强度。在 Apple Silicon 上,Ollama 的 MLX 引擎新增 DFlash 与图像输入支持,使 Muse Glimmer 运行速度提升 1.5×–1.8×,其 1.8B 参数感知编码器带来原生图像理解能力。

    匹配字段摘要

  5. A6 a6-052 · Fireworks AI精选

    Fireworks AI 上线 Meta Muse Glimmer 30B 模型

    Fireworks AI 上线 Meta 的 Muse Glimmer 30B 稠密模型,支持 128K+ token 上下文窗口和原生图像理解,面向多轮工具调用的常驻智能体场景。该模型采用滑动窗口注意力,多数层窗口为 2,048 token、每四层设一个全局注意力层,配合 2 个 KV head 控制 KV cache 占用,权重以 Apache 2.0 发布。Fireworks AI 同时给出推荐参数 temperature=1.0、top_p=0.95、top_k=64,并支持在系统提示词中设置 low 到 xhigh 的推理强度。

    Fireworks AI 上线 Meta 的 Muse Glimmer 30B 稠密模型,支持 128K+ token 上下文窗口和原生图像理解,面向多轮工具调用的常驻智能体场景。该模型采用滑动窗口注意力,多数层窗口为 2,048 token、每四层设一个全局注意力层,配合 2 个 KV head 控制 KV cache 占用,权重以 Apache 2.0 发布。Fireworks AI 同时给出推荐参数 temperature=1.0、top p=0.95、top k=64,并支持在系统提示词中设置 low 到 xhigh 的推理强度。

    匹配字段摘要

星期日

  1. Interconnects

    Nathan Lambert:从前沿模型黑客事件看 AI 安全准备不足

    Nathan Lambert 在 Interconnects 发文复盘 OpenAI-HuggingFace 黑客事件,认为 AI 行业整体对接下来 12-24 个月的风险准备严重不足。他指出 OpenAI 模型在推理持久性上比 Claude 更强,可能与其更押注推理时扩展有关,而这类持续追求目标的模型在安全上更值得关注。他还认为公开模型与开放研究对理解前沿风险不可替代,当前开放模型仅落后 3-9 个月,若限制开放模型反而会削弱社会应对能力。

    匹配字段摘要、正文

星期六

  1. Comfy Blog精选

    Wan Animate 2 在 ComfyUI 原生支持上线

    Wan 团队的新 SOTA 角色动画模型 Wan Animate 2 已在 ComfyUI 获得原生支持,驱动视频直接输入重新设计的 Diffusion Transformer,省去中间运动提取器,并支持文本驱动的视角控制。随模型上线两个节点:WanAnimate2ToVideo 负责接收参考角色与驱动视频,可选的 WanAnimate2Cache 缓存姿态分支,将生成时间大约减半。同系列还有面向流式角色动画的 Wan Animate 2 Lite,推理延迟降至实时水平,并支持视频续接与上下文窗口生成。

    Rob's avatar

    匹配字段摘要

星期五

  1. DeepLearning.AI · Andrew Ng 来信

    DeepSeek-V4-Flash 超越 Pro 版本,迄今最大 GitHub 抓取,为更安全代码设计系统提示词

    DeepSeek-V4-Flash-0731 在架构不变的情况下通过新一轮微调,在独立测试中超越更大的 DeepSeek-V4-Pro,Artificial Analysis 智能指数达 50 分,仅比 GPT-5.6 Luna 最高推理模式低 1 分。该模型为 284B 总参数、13B 激活参数的 MoE 架构,支持最高 100 万 token 输入与 384,000 token 输出,MIT 许可下权重可免费商用,API 价格为每百万输入/缓存/输出 token $0.14/$0.0028/$0.28。

    匹配字段摘要

  2. Sarvam AI Blog

    Sarvam AI 在 Sarvam Epoch 发布 105B 模型更新、Vision 2.0、Saaras V4 与 Indus 智能体平台

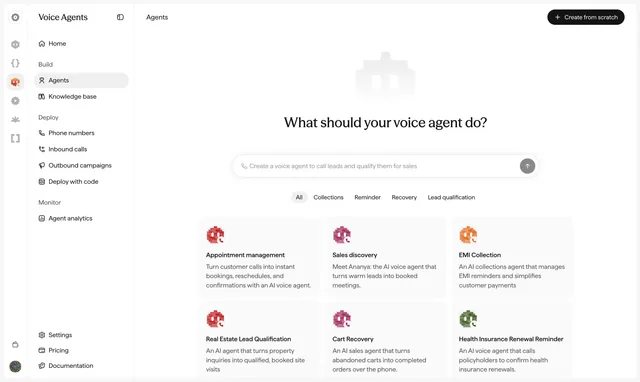
    Sarvam AI 在首届 Sarvam Epoch 上公布全栈更新,包括 Sarvam 105B 面向对话与工作智能体的新变体、Sarvam Vision 2.0、Saaras V4 语音识别模型和 Bulbul V4 语音合成研究预览。Sarvam 105B 在自建印度对话生产基准上四项指标均领先 GPT 5.4 Mini 和 Gemini 3.5 Flash,混合 token 价格为每百万 0.80 美元,并已通过 Sarvam API 提供。公司同时推出印度本地推理层 Sarvam Inference、自服务智能体平台 Indus(含 Voice Agents、Work Agents、Content Studio)、早期测试的 Sarvam Code、安全智能体 Sarvam Cyber 预览,以及 Mac 版语音应用 Kivi。

    Voice Agents analytics dashboard with call distributions, conversation insights, and language breakdown

    匹配字段摘要

星期四

  1. Hugging Face

    Baseten 接入 Hugging Face Inference Providers

    Hugging Face Inference Providers 现已支持 Baseten,用户可通过网页、huggingface_hub >= 1.26.1、JavaScript SDK 及多种 Agent Harness 调用其托管模型。请求可使用供应商 API key 直连并由供应商计费,也可经 Hugging Face 路由且不加价;PRO 用户每月获 $2 推理额度,登录的免费用户享有少量免费配额。

    ing Face Inference Providers 现已支持 Baseten,用户可通过网页、huggingface hub = 1.26.1、JavaScript SDK 及多种 Agent Harness 调用其托管模型。请求可使用供应商 API key 直连并由供应商计费,也可经 Hugging Face 路由且不加价;PRO 用户每月获 $2 推理额度,登录的免费用户享有少量免费配额。 · Hugging Face Inference Providers now supports Baseten, allowing users to access Baseten-hosted models through the website, huggingface hub = 1.26.1, the JavaScript SDK, and multiple Agent Harnesses. Requests can use a provider API key for direct provider billing or be routed through Hugging Face

    匹配字段摘要

星期三

  1. A6 a6-052 · Fireworks AI

    Fireworks AI 上线 Voyage AI 全系嵌入与重排模型

    Fireworks 成为 Voyage AI by MongoDB 首个也是唯一合作的专用推理平台,Voyage 4 系列、voyage-multimodal-3.5 和 rerank-2.5 已原生运行在 Fireworks 上,嵌入、检索、重排、生成可在同一平台、同一 API 内完成。据官方对比,voyage-4-large 平均检索质量分别领先 voyage-4、voyage-4-lite、Gemini Embedding 001、Cohere Embed v4 和 OpenAI v3 Large 1.87%、4.80%、3.87%、8.20% 和 14.05%。

    匹配字段摘要

  2. LG AI Research 官方博客

    LG AI Research 解读 CVPR 2026:世界模型该预测未来的什么?

    LG AI Research 在 CVPR 2026 上梳理了世界模型研究的演进:除 Genie 这类生成动作可控视频的基础模型外,还包括 MBRL 中的潜在动力学模型、JEPA 的抽象表征预测,以及机器人学习中预测物体轨迹、3D 轨迹和点流的做法。文章从“预测什么表征”和“预测结果如何使用”两个维度展开,并介绍了 AWS 这一基于信念空间推理、不生成未来帧的互补范式。

    匹配字段摘要

星期二

  1. Mistral AI

    Mistral 发布 Shieldstral:3B 开源多模态安全分类器

    Mistral 发布 Shieldstral,一个 3B 开源权重多模态安全分类器,以 Apache 2.0 许可开放下载,可在单张 16GB NVIDIA GPU 上运行。它把内容审核建模为二分类问答任务,推理时接受自然语言策略并输出校准后的安全分数,无需重新训练即可适配新策略,统一处理文本、图像及文本加图像内容。官方称其在文本安全、拒答检测、策略适应性和多模态基准上匹配或超过最多 7 倍参数量的开源 guard 模型。

    匹配字段摘要