AI News

按匹配度 · 共 3299 条结果 清除搜索

星期三

  1. Google DeepMind精选

    Google DeepMind 在 Gemini 3.5 Flash 中内置 computer use

    Google DeepMind 将 computer use 作为内置工具集成进 Gemini 3.5 Flash,此前该能力仅以独立的 Gemini 2.5 computer use 模型形式提供。开发者可通过 Gemini API 和 Gemini Enterprise Agent Platform 使用它构建能跨浏览器、移动端和桌面环境感知、推理并执行操作的智能体,面向持续软件测试等长周期与企业自动化任务。为降低实时环境中的提示词注入风险,官方对 computer use 做了针对性对抗训练,并发布两套可选的企业级防护系统。

    匹配字段摘要

星期一

  1. Interconnects

    GLM-5.2 是开源智能体的转折点

    Interconnects 作者认为 GLM-5.2 是首个在编码智能体框架中真正好用的开源权重模型,社区基准显示它是唯一能与 OpenAI、Anthropic 最新模型同场竞争的开源模型。作者实测用 Fireworks API 在 Claude Code 中调用该模型,整体能力立刻感觉可用,但遇到框架向模型发送图片导致 API 会话中断、需手动清空上下文的问题。作者测算 Claude Opus 4.5 发布到 GLM-5.2 发布相隔 204 天,落在常说的 6 至 9 个月开源与闭源性能差距区间内,并认为这会加剧 token 消耗大户的定价压力,利好开源模型推理与微调生态。

    匹配字段摘要、正文

  2. The Next Platform

    HPE 借智能体 AI 浪潮重返数据中心

    HPE 用 GreenLake Intelligence 智能体框架和与 Nvidia 合作的 Private Cloud AI 在本地搭建 AI 优先支持平台,将成本降低逾 30 倍,每月节省近 10 万美元。其 CTO Fidelma Russo 称,智能体让推理变成持续运营负载,每次推理、验证和行动都消耗 token,HPE 由此从 AI 消费者变为智能生产者。Signal65 数据显示,智能体消耗的 token 是普通 AI 对话的 4 至 15 倍。

    匹配字段摘要

  3. Prime Intellect精选

    Prime Intellect 发布 prime-rl 0.6.0,支持万亿参数规模强化学习

    Prime Intellect 发布 prime-rl 0.6.0,可在重智能体负载下训练万亿参数规模模型,并称能在 28 个 H200 节点上以最高 131k 序列长度训练 GLM-5 完成 SWE 任务,步时间低于 5 分钟、批量 256 条 rollout。该版本采用异步 RL,将训练与推理解耦,并给出 FP8 推理、Wide EP、P/D 分离、KV cache 分层卸载、router replay 以及 FSDP、EP、CP 三维并行等优化细节。这些优化同样适用于 Kimi-K2.7-Code、NVIDIA-Nemotron-3-Ultra-550B-A55B-BF16 等其他大型 MoE 模型。

    RL at 1T Scale: prime-rl Performance Deep Dive

    匹配字段摘要

星期日

  1. Sakana AI:Blog精选

    Sakana AI 发布 Fugu 与 Fugu Ultra 多智能体编排模型

    Sakana AI 发布 Sakana Fugu,把多智能体编排系统做成一个基础模型,通过单一 OpenAI 兼容 API 调用,内部自行完成模型选择、任务委派、验证与结果整合。首发包含 Fugu 和 Fugu Ultra 两个版本,前者兼顾性能与低延迟,后者面向多步难题;官方称 Fugu Ultra 在工程、科学与推理基准上可与 Fable 5、Mythos Preview 比肩。其智能体池可替换,官方表示若某家供应商限制访问,Fugu 会动态绕开,并计划后续纳入开放模型与自家模型。

    匹配字段摘要

  2. 电子技术应用

    AI时代CPU与GPU的主角之争:中科曙光发布百核级512线程国产CPU平台

    中科曙光2026年6月15日发布新一代通用高性能计算平台,搭载国产百核级512线程通用CPU,单芯片FP64双精度算力达10T,HPL双精度浮点性能较上一代提升近2倍。该平台是国内首个原生支持AVX-512指令集的国产通用计算平台,现有HPC软件无需重新编译即可运行,实现零迁移成本。文章指出,随着推理与Agentic AI兴起,国内AI集群CPU:GPU配比已从1:8升至1:2,CPU正从配角走向指挥中枢。

    匹配字段摘要、正文

星期四

  1. Amp Chronicle

    Amp Librarian 提速约 3 倍,成本降低 43%

    Amp Librarian 在质量不变的情况下提速约 3 倍、成本降低 43%,现改用无推理的 GPT-5.5、websocket 模式和新版系统提示词。每轮并行工具调用从约 3 次增至约 8 次,搜索由约 15 轮缩至约 5 轮;内部测试耗时从 2 分钟降至 40 秒,成本从 $1.08 降至 $0.47。

    匹配字段摘要

星期三

  1. xAI News精选

    xAI 的 Grok 4.3 在 Amazon Bedrock 正式可用

    xAI 宣布 Grok 4.3 在 Amazon Bedrock 正式可用,开发者可通过 Bedrock 的推理引擎调用该模型。Grok 4.3 支持 100 万 token 上下文窗口,推理强度可配置为 none、low、medium、high,定价为输入 $1.25 / 百万 token、输出 $2.50 / 百万 token。xAI 称其在 Artificial Analysis Omniscience 基准上取得最低幻觉率,并在 Tau2 Telecom、Vals AI Case Law 与 Corporate Finance 基准上排名第一。

    匹配字段摘要

星期日

  1. Sakana AI:Blog

    Sakana AI 推出首个商用产品 Sakana Marlin 自主调研助手

    Sakana AI 发布首个商用产品 Sakana Marlin,这是一款面向企业的自主型调研助手,输入调研主题后可自主研究最长约 8 小时,输出结构化摘要幻灯片和数十页调研报告。该产品基于长期推理技术,整合了 AB-MCTS 与 The AI Scientist 等研究成果,经过 2026 年 4 月启动的封闭测试、约 300 名来自金融机构、咨询公司和智库等行业的测试者参与打磨。产品提供按量付费及 Pro、Team、Enterprise 等套餐,面向企业战略、咨询、智库等日常调研岗位。

    匹配字段摘要

星期五

  1. Zyphra Research精选

    Zyphra 发布 ZONOS2 实时 TTS 模型,采用 MoE 架构并开源

    Zyphra 发布 ZONOS2,一个 Apache 2.0 许可的实时文本转语音模型,具备高保真声音克隆能力,采用 9 亿激活参数、80 亿总参数的稀疏 MoE 架构,是首个开源 MoE TTS 模型。相比 Zonos-v0.1,训练数据从约 20 万小时扩展到超 600 万小时,模型规模从 1.6B 增至 8B,实时吞吐提升 4 倍,并支持最长一分钟的多语言与语码转换音频生成。模型权重已在 Hugging Face 发布,基于 SGLang 的推理代码在 GitHub 开源,同时上线 Zyphra Cloud 并提供 API,发布后促销期内免费。Zyphra 还提出新的 ZTTS1-Eval 评测基准,覆盖 9 种语言的 Clean 集与 17 种语言的 In-The-Wild 集。

    匹配字段摘要

星期四

  1. Redwood Research:Blog

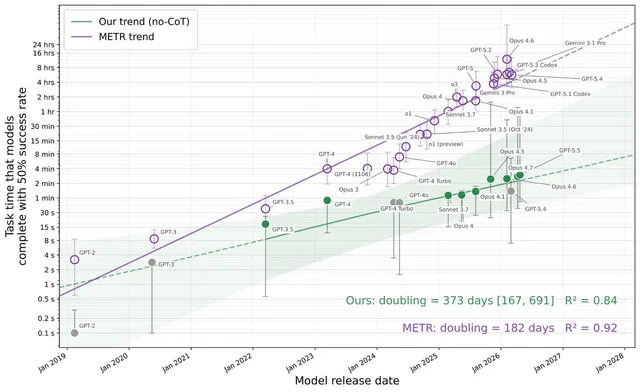
    Redwood Research 测量前沿模型无 CoT 任务完成时长:约每年翻倍

    Redwood Research 发布新论文,测量 14 个前沿模型在 43 个基准上不输出任何 CoT 时的任务完成能力,发现无 CoT 时间跨度约每 373 天翻倍,token 跨度约每 437 天翻倍。GPT-5.5 的 50% 无 CoT 时间跨度为约 3 分钟,对应约 1500 个 o3-mini 推理 token。作者建议 AI 公司开始显式追踪无 CoT 时间跨度,以估计模型在不被 CoT 监控发现的情况下能进行多少推理。

    匹配字段摘要

星期三

  1. Amazon Science

    AWS Graviton5 发布:新 chiplet 架构带来 25% 性能提升

    AWS 发布基于 Graviton5 的 EC2 M9g 和 M9gd 实例,通用计算性能较 Graviton4 提升最高 25%,Web 应用和机器学习推理提升最高 35%,数据库提升最高 30%。Graviton5 采用四 chiplet 架构,核心数从 96 翻倍至 192,配备 192MB L3 缓存,支持 DDR5-8800 内存和 PCIe gen6,并采用 3 纳米工艺。新实例还引入经形式化验证的 Nitro Isolation Engine,用于强化虚拟机隔离。

    匹配字段摘要

  2. Google DeepMind精选

    Google DeepMind 发布 DiffusionGemma 实验性开源模型

    Google DeepMind 发布 DiffusionGemma,一个采用 Apache 2.0 许可的 26B MoE 实验性开源模型,探索文本扩散生成,在 GPU 上文本生成速度最高提升 4 倍。该模型不再逐 token 顺序生成,而是同时生成整块文本,面向内联编辑、快速迭代等速度敏感的本地交互工作流。其加速优势主要体现在单加速器、低到中等批大小的本地低并发推理场景,高 QPS 云端服务下并行解码收益递减。

    匹配字段摘要

星期二

  1. Amazon Science

    Amazon Science:将 AI 智能体锚定物理世界的四种方法

    Amazon Science 提出四种将 AI 智能体锚定物理世界的方法:物理引导深度学习、基于 UQ4CT 框架的不确定性感知推理、adapting-while-learning(AWL)框架和验证器增强锚定。其中 AWL 在物理科学数据集上准确率提升 29%,UQ4CT 在五个基准上保持高准确率并将预期校准误差(ECE)降低超过 25%。这些方法可单独或组合使用,旨在提升 AI 智能体在仓库、工厂等物理环境中的可靠性与安全性。

    匹配字段摘要

  2. Amazon Science

    亚马逊提出 Simple Strands Agent,用 harness 设计缩小智能体意图与执行差距

    亚马逊研究人员提出 Simple Strands Agent(SSA),一种可定制的单智能体 harness,用于缩小模型意图与 harness 执行之间的意图-执行差距,并在多个模型和基准上取得稳定性能提升。论文将这一瓶颈形式化为双向的意图-执行差距,指出工具接口、diff 文件反馈以及内部推理与外部交互的平衡是关键设计原则,并强调不同模型家族在工具使用偏好上存在差异,需要模型与 harness 协同设计。SSA 的智能体逻辑、工具、提示词和模型配置均已开源。

    匹配字段摘要

星期一

  1. Claude Blog

    Anthropic 发布 Swift 包,让 Apple 开发者通过 Foundation Models 框架调用 Claude

    Anthropic 发布新的 Swift 包,为 Apple 的 Foundation Models 框架提供 Claude 支持,开发者可在本地模型处理摘要、抽取等任务后,把需要多步推理、代码生成或联网搜索的请求交给 Claude。该包处理流式输出、工具调用和结构化响应,可直接回填到 SwiftUI 视图,需使用 Anthropic API key,支持 iOS 27、iPadOS 27、macOS 27、visionOS 27 和 watchOS 27。

    匹配字段摘要

星期日

  1. antirez 原创博客

    antirez:AI 智能体正在开启软件测试的新时代

    Redis 作者 antirez 提出用 AI 智能体做 QA 的新方法:编写一个 markdown 文件,让智能体扮演 QA 工程师,先检查新版本相对已发布版本的提交,再据此执行分布式推理、速度回归等手动测试。他在 DwarfStar 和 Redis Arrays 上实践了这一流程,认为自动 QA 有望提升新版本的质量门槛,部分抵消自动编程高速产出代码带来的质量下降。

    匹配字段摘要

星期六

  1. Ahead of AI

    LLM 研究论文清单:2026 年 1 月至 5 月

    作者整理了 2026 年 1 月至 5 月收藏的 LLM 研究论文,并明确表示这不是完整收录,而是基于个人工作兴趣筛选的参考清单。内容侧重推理模型、强化学习和高效推理,同时涵盖 Agent 框架、工具使用、长上下文、扩散语言模型及服务基础设施。

    匹配字段摘要

星期四

  1. Prime Intellect精选

    Prime Intellect Lab 上线 Nemotron 3 Ultra 后训练支持

    Prime Intellect 宣布其托管后训练平台 Lab 对 NVIDIA Nemotron 3 Ultra 提供 day-0 支持,可在 Blackwell B200/B300 上做托管 RL 训练,配合 vLLM 推理、NCCL 权重广播和 Prime-RL 训练器。平台提供 Environments Hub 中 2,500+ 个开放 RL 环境,并支持 SWE-bench Verified、BrowseComp、τ²-Bench Telecom、Terminal-Bench Hard、IFBench、AA-LCR、GPQA Diamond、RULER-1M 等评测,以及 LoRA 与全权重适配器的一键推理。文中称 Ramp 用 Lab 后训练 35B 检索子智能体 FastAsk,在自有财务表格工作流上达到 66.25% 精确匹配,高于 Claude Opus 4.6 的 61.88%。

    Post-Training Nemotron 3 on Lab

    匹配字段摘要

  2. LMSYS Blog精选

    SGLang 与 Miles 首日支持 NVIDIA Nemotron 3 Ultra

    LMSYS 宣布 SGLang 与 Miles 在 Day 0 支持 NVIDIA Nemotron 3 Ultra,这是一款面向长时自主智能体的开源前沿推理模型,总参数 550B、激活参数 55B,上下文最长 1M tokens,支持 NVFP4 与 BF16。SGLang 提供高性能推理服务,Miles 支持在 128 张 H200 上以 GRPO 进行强化学习训练,并已验证 dapo-math-17k 上的端到端流程。官方称该模型在智能体生产力、指令遵循和长上下文任务上领先,成本最多节省 30%。

    匹配字段摘要