开源 AI 为何可能靠专业化模型等到与前沿实验室的差距缩小
Charlie O’Neill 认为,开源 AI 无需在通用能力上追平前沿模型,只需通过领域数据、强化学习和更低推理成本扩大可经济自动化的工作范围。多数企业任务依赖专有数据与特定工作流,专业化的小模型可能比通用前沿模型更快、更便宜且更贴合实际分布。随着开放模型能力提高和服务成本下降,专业化层创造的收入还可能反哺后续模型训练。
匹配字段摘要
Charlie O’Neill 认为,开源 AI 无需在通用能力上追平前沿模型,只需通过领域数据、强化学习和更低推理成本扩大可经济自动化的工作范围。多数企业任务依赖专有数据与特定工作流,专业化的小模型可能比通用前沿模型更快、更便宜且更贴合实际分布。随着开放模型能力提高和服务成本下降,专业化层创造的收入还可能反哺后续模型训练。
匹配字段摘要
蚂蚁百灵发布全模态大模型 Ming-flash-omni-2.0,基于 Ling-2.0(MoE 架构,100B-A6B)训练,相比 Preview 版本在全模态能力上有明显提升。该模型覆盖视觉百科识别、可控语音生成与图像生成编辑分割,官方称其为业界首个将语音、音效和背景音乐生成融为一体的模型,并首创将生成、编辑、分割融入单一原生模型。模型权重和推理代码已开源。
匹配字段摘要、正文
Qwen 团队发布下一代基础图像生成模型 Qwen-Image-2.0,将此前并行的生图与编辑两条路线合并为统一的生成与编辑模型。该模型支持 1k-token 指令直接生成 PPT、海报、漫画等信息图,原生支持 2K 分辨率,并采用更小的模型体积以提升推理速度。官方称在 AI Arena 盲测中,该模型在文生图与图生图基准上均取得更优表现。
匹配字段摘要
Prime Intellect 发布 Lab,把 Environments Hub、Hosted Training 和 Hosted Evaluations 整合为面向智能体后训练的全栈平台,覆盖大规模智能体 RL、推理与评测。平台以环境为核心,包含任务数据集、模型 harness 和评分 rubric,当前 Hosted Training 支持基于 prime-rl 的 LoRA 智能体 RL,后续将加入 SFT、DPO 等算法。私有测试期间已完成 3000 多次 RL 运行,Environments Hub 累计有 250 多位创作者构建 1000 多个环境、下载量超过 10 万次。

匹配字段摘要
蚂蚁大模型团队在隔离 VM 中部署开源项目 Moltbot(原名 Clawdbot),用 Ling-1T 驱动并接入 Discord 测试,验证了角色扮演、文档调研、代码编写等任务。文章将其架构拆为动态上下文主循环、Channels 与 50+ Skills、Cronjob 加 Heartbeat 主动机制、以 Markdown 文件为中心的记忆与工作区四部分,并总结出通用 Agent 公式:强力基座模型加工具集合加上下文管理加长期记忆加调度策略。作者同时指出赋予完整 OS 权限存在指令注入风险,对抗测试中可被诱导读取 ~/.ssh 等敏感目录,且高频推理的 token 成本可能超过设备本身,认为它目前更适合作为开发者的实验田。

蚂蚁大模型团队在隔离 VM 中部署开源项目 Moltbot(原名 Clawdbot),用 Ling-1T 驱动并接入 Discord 测试,验证了角色扮演、文档调研、代码编写等任务。文章将其架构拆为动态上下文主循环、Channels 与 50+ Skills、Cronjob 加 Heartbeat 主动机制、以 Markdown 文件为中心的记忆与工作区四部分,并总结出通用 Agent 公式:强力基座模型加工具集合加上下文管理加长期记忆加调度策略。作者同时指出赋予完整 OS 权限存在指令注入风险,对抗测试中可被诱导读取 /.ssh 等敏感目录,且高频推理的 token 成本可能超过设备本身,认为它目前更适合作为开发者的实验田。
匹配字段摘要、正文
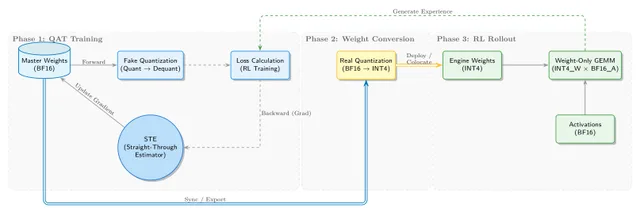
SGLang RL 团队在 slime 框架上复现并落地了 INT4 QAT 端到端方案,训练侧用假量化加 STE,推理侧用 W4A16 真实量化,使约 1TB 规模的 K2 类模型可装入单张 H200(141GB)。消融实验显示,训练端假量化与推理端真实量化必须同时开启,否则训练与推理的 logprob 差异会明显增大;在 Qwen3-235B-A22B 和 Kimi-K2-Thinking 上,BF16 训练加 INT4 推理的奖励与评测分数走势与 BF16、FP8 方案基本重合。团队称 INT4 的主要收益来自显存压缩带来的单节点 rollout,因为 H 系列 GPU 没有原生 INT4 Tensor Core,其计算速度与 FP8 大致同档。
匹配字段摘要
Manus 博客列出 2026 年 7 款最佳 ChatGPT 替代品:Manus AI 主打自主任务与工作流自动化,Claude AI 擅长写作与自然对话,Google Gemini 适合 Google 用户与实时信息,Perplexity AI 适合研究与带来源的准确回答,Microsoft Copilot 面向商业生产力与 Microsoft 365 用户,DeepSeek 是免费且编程与推理较强的选择,Grok 主打实时信息与幽默风格。文章还从主要用途、预算和集成需求三方面给出选择建议。
匹配字段摘要
SGLang 发布高度优化的流水线并行(PP)实现,通过分块流水线并行、异步 P2P 通信和动态分块机制应对超长上下文推理。在 H20 集群上,PP4 TP8 部署使 DeepSeek-V3.1 的 Prefill 吞吐量达到 TP8 的 3.31 倍,比 TP32 方案高出 30.5%,同时 TTFT 最多降低 67.9%,强扩展效率达 82.8%。该实现兼容 PD 分离与 HiCache。
匹配字段摘要
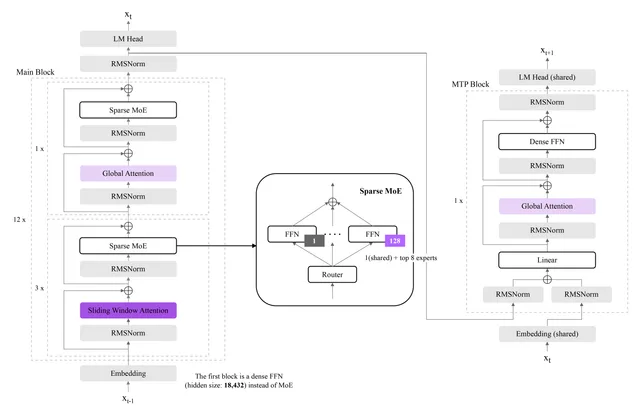
LG AI Research 发布大规模模型 K-EXAONE,采用 128 专家的 MoE 结构,总参数 2360 亿、实际激活约 230 亿,并引入多 token 预测使推理速度约为现有模型的 1.5 倍。模型支持约 26 万 token 上下文,词表从约 10 万扩展到约 15 万,分词效率平均提升约 30%。后训练采用自研 AGAPO 强化学习算法与 GrouPER 偏好对齐方法,在 Artificial Analysis Intelligence Index 的开源权重模型中排名全球第 7、韩国第 1,模型已在 Hugging Face 和 Friendli AI 上线。
匹配字段摘要
Redis 作者 antirez 撰文称,近期 SOTA LLM 已能几乎独立完成大型子任务或中型项目,写代码在多数项目中已不再必要。他仅靠提示和偶尔检查代码,就在数小时内完成 linenoise 支持 UTF-8、修复 Redis 测试偶发失败、用 Claude Code 在 5 分钟生成 700 行纯 C 的 BERT 类嵌入模型推理库(比 PyTorch 慢 15%),并在 20 分钟内复现自己对 Redis Streams 内部结构的改动。他同时担忧 AI 权力集中和程序员失业问题。
匹配字段摘要
LG AI Research 在 NeurIPS 2025 上发布 SciNO(Score-informed Neural Operator),一种结合神经算子的函数扩散模型框架,可在高维数据下稳定、可扩展地进行因果推理。SciNO 基于 Hilbert 扩散模型与 Sobolev 空间理论,采用时间条件 Fourier Neural Operator(FNO)架构,理论证明神经算子能稳定逼近 score 函数及其高阶导数,克服了 SCORE、CaPS、DiffAN 等方法在高维下内存激增与导数估计不稳定的问题。
匹配字段摘要
Sebastian Raschka 回顾 2025 年大语言模型发展,认为主要进展来自 RLVR、GRPO、推理时扩展、工具调用及架构效率优化,而非单纯扩大预训练规模。他指出公开基准已难以可靠反映真实能力,并预测 2026 年 RLVR 将扩展到数学和编码以外的领域,本地工具调用与智能体能力会逐步普及。文章同时主张将 AI 作为提升专业工作的伙伴,而非完全替代人的思考、编码与研究。
匹配字段摘要
Ahead of AI 整理了 2025 年 7 月至 12 月值得关注的 LLM 研究论文,并按主题分类。清单涵盖推理模型、推理时扩展方法、模型发布与技术报告、架构、高效训练、扩散语言模型、多模态与视觉语言模型,以及数据和预训练数据集。
匹配字段摘要
FutureHouse 与 Caltech、牛津大学、Mila、AITHYRA 合作发布 OXtal,一个 100M 参数的全原子扩散模型,可直接从 2D 分子图预测可实验实现的 3D 有机晶体堆积结构。传统方法依赖大规模 CPU 物理模拟搜索,最近一次 CSP Blind Test 中预测 7 个目标就消耗 46M CPU 核心小时,而 OXtal 用生成式推理在单块 GPU 上数秒内给出预测。模型不使用硬编码对称性,而是在超过 600,000 个实验解析结构上训练并配合新的裁剪算法,以软对称性作为归纳偏置学习分子局部堆积规律。
匹配字段摘要
Gemini 3 Deep Think 模式今日向 Ultra 用户开放,通过并行思路在 ARC-AGI-2 和 HLE 等关键推理评测中取得明显提升。
Gemini 3 Deep Think 模式今日向 Ultra 用户开放,通过并行思路在 ARC-AGI-2 和 HLE 等关键推理评测中取得明显提升。 · Gemini 3 Deep Think mode is now available to Ultra users, using parallel lines of thought to achieve meaningful improvements on key reasoning benchmarks including ARC-AGI-2 and HLE.
匹配字段摘要
DeepSeek V3.2 延续 V3 系列架构,并引入 DeepSeek Sparse Attention、自验证、自改进及多项 GRPO 训练调整。文章梳理了 V3、R1、V3.1、V3.2-Exp、DeepSeekMath V2 和 V3.2-Speciale 的演进,解释 MLA、RLVR 与混合推理模式等关键机制。更新部分还介绍了用于改善训练稳定性和收敛表现的 mHC 残差路径研究。
匹配字段摘要
Prime Intellect 发布 INTELLECT-3,一个 106B 参数的 Mixture-of-Experts 模型,在 GLM-4.5-Air 基座上进行 SFT 和大规模 RL 训练,在数学、代码、科学和推理基准上取得同规模 SOTA。团队开源了模型权重、训练框架 prime-rl、verifiers 环境库及全部训练与评测环境,训练在 512 张 NVIDIA H200 GPU 上完成。模型可在 chat.primeintellect.ai 或通过 Inference API 使用。

匹配字段摘要
Claude Opus 4.5 与 Gemini 3 相比如何? - 推理/文本:在控制推理 token 数量的情况下,Gemini 3 ≈ Opus - 多模态:在视觉/图像输入上,Gemini 3 大幅优于 Opus - 安全:能力 ≠ 安全。在越狱、诚实性等方面,Opus 优于 Gemini
Claude Opus 4.5 与 Gemini 3 相比如何? - 推理/文本:在控制推理 token 数量的情况下,Gemini 3 ≈ Opus - 多模态:在视觉/图像输入上,Gemini 3 大幅优于 Opus - 安全:能力 ≠ 安全。在越狱、诚实性等方面,Opus 优于 Gemini
匹配字段摘要
Anthropic 发布 Claude Opus 4.5,称其在编码、智能体和计算机使用上达到世界最佳,并在日常任务如深度研究和表格处理上有显著提升。模型现已在应用、API 和三大云平台可用,API 定价为每百万 tokens 输入 5 美元、输出 25 美元。同时更新了 Claude Developer Platform、Claude Code 和消费级应用,新增 effort 参数以控制推理强度,并提升了上下文管理和多智能体协调能力。
匹配字段摘要
Zyphra 发布技术报告,介绍 ZAYA1——首个完全在 AMD 平台(AMD Instinct MI300X GPU、AMD Pensando 网络与 ROCm 软件栈)上完成大规模训练的 MoE 基础模型,训练集群由 AMD 与 IBM Cloud 联合构建。ZAYA1-base 总参数 8.3B、激活参数 760m,在推理、数学和编码基准上表现与 Qwen3-4B、Gemma3-12B 相当,并超过 Llama-3-8B 和 OLMoE。Zyphra 称其为 AMD 生态可支撑前沿级 AI 训练的验证,并采用压缩卷积注意力(CCA)等架构创新提升训练吞吐与推理效率。

匹配字段摘要