←搜索结果

按匹配度 · 共 2286 条结果 清除搜索

星期二

  1. PyTorch Blog

    PyTorch 宣布成立 Ray 加速器特别兴趣小组(SIG)

    PyTorch 宣布成立 Ray 加速器特别兴趣小组(SIG),联合硬件厂商、Ray 贡献者与应用开发者制定厂商中立的加速器支持路线图。该小组初期聚焦开发与测试基础设施、硬件感知调度、网络与传输三大方向,Ray 目前已支持 NVIDIA、AMD GPU 及 TPU、Trainium、Gaudi 等十余种加速器。

    Ray logo

    计算”指的是运行 Apache Hadoop 和 Apache Spark 等框架的 CPU 集群。GPU 才刚刚从图形和科学计算领域进入机器学习。 如今, 加速计算 已成为人工智能开发与部署的核心,加速器及其能力也变得更加专用化和多样化。例如: NVIDIA RTX PRO 6000 Blackwell 服务器版 GPU 支持涵盖 AI 训练、推理、图形和视频的灵活工作负载 NVIDIA HGX B200 及全栈平台提供大幅提升的内存容量以支持更大的模型,而 NVIDIA GB200 NVL72 连接 72 块 NVIDIA Blackwell GPU,用于通信密集型的大规模训练和推理。 AMD MI355X 同样为大型模型提供可观的显存容量 Google Ironwood TPU 面向超大规模 AI 工作负载 NVIDIA Groq 3 LPU 专注于低延迟推理。 Ray 社区一直在积极跟进这一转变。如今,Ray 支持十余种硬件加速器,从 NVIDIA 和 AMD GPU 到 TPU、Trainium、Gaudi 等。我们认为,现在正是关键时机,在这一基础上开展更宏大、更系统化的全

    匹配字段正文
  2. 凤凰科技

    曝OpenAI以超30%折扣和免费额度抢走Anthropic客户,Replit合同年价值超1亿美元

    据The Information报道,OpenAI以超过30%的模型价格折扣争取到美国AI编程平台Replit,合同年价值超过1亿美元。OpenAI还通过免费额度、账户翻倍和工程师进群支持等方式争取Rippling、Atomicwork等Anthropic老客户,Anthropic则在新模型发布时下调API价格。

    uter客户支出领先。两组变化表明,企业采购既看模型效果,也看实际报价,领先厂商同样需要反复争取客户预算。 随着模型能力差距缩小、切换供应商更方便,企业大客户有了更多议价空间。模型效果之外,合同折扣、免费额度和技术支持也在影响采购选择。对模型厂商而言,竞争对手一旦推出效果接近、价格更低的产品,原有客户就可能转向。技术领先带来的高价,越来越难长期维持。 来源:The Information、路透社、Anthropic、OpenAI “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  3. heise online

    Coding Agent 如何改变德国联邦 AI 竞赛——专访 Tübingen AI Center

    德国联邦 AI 竞赛(BWKI)今年收到 150 支队伍报名,10 支决赛队伍将于 11 月 13 日赴图宾根参加颁奖并展示项目。Tübingen AI Center 的 Sören Drabesch 在专访中谈 Coding Agent 时代怎样才算一份出色的参赛作品,并给有意参加下届比赛的新手提出建议。

    项目。 BWKI面向就读于德国学校(包括海外德国学校)或刚刚从这类学校毕业的学生。只要有可以通过机器学习实现的想法,就可以在春季报名参加BWKI——可以个人参赛,也可以与最多四名队友组队参赛。不过大多数队伍此时已经编程了一段时间,并且最重要的是已经收集了训练数据,因为当你想出特别有创意的点子时,往往正缺少这些数据。秋季提交完成的项目,其中包括一段3至5分钟的视频推介和代码。 德国联邦人工智能竞赛(BWKI)自2019年起举办。发起人是图宾根人工智能中心的研究人员。 图宾根人工智能中心是由德国联邦研究、技术和航天部(BMFTR)资助的能力中心,隶属于图宾根大学和马克斯·普朗克智能系统研究所。该倡议的主要资助方是卡尔·蔡司基金会。 除了竞赛之外,BWKI还为所有感兴趣的人提供免费的AI课程。使用该课程特别多的学校有机会成为“年度AI学校”。 德国联邦人工智能竞赛:更多项目、勇敢的新手、AI参与编程 面向学生的德国联邦人工智能竞赛:从获奖项目到成熟产品 德国联邦人工智能竞赛 AI课程 我们将简要介绍决赛项目。此外,图宾根人工智能中心的Sören Drabesch将解释在编程智能体时代,什么样

    匹配字段正文

  4. The Decoder

    Anthropic 在 Claude Code 中限制克隆现有游戏

    Anthropic 正在阻止编码助手 Claude Code 复刻现有电子游戏,员工 Addy Osmani 在 X 上确认,Opus 5.5 的系统提示词中新增两句话用于阻止克隆他人游戏,即使克隆作品被改名或伪装成原创也会触发。该规则已生效数天,用户仍可构建自己的游戏、同类型作品和使用自定义素材的项目,但有人反映原创项目也遇到了问题。这一变化发生在大量 AI 克隆项目涌现之后,Osmani 表示 Anthropic 计划继续调整相关规则。

    在 X 上确认,Claude Code 针对 Opus 5.5 的系统提示词中新增的两句话,如今会阻止该工具克隆他人的游戏。Osmani 表示,使用 Claude 侵犯知识产权违反了使用政策。 该规则已生效数天,即使克隆作品被改名或伪装成原创作品,也会触发该规则。用户仍然可以构建自己的游戏、同类型作品以及使用自定义素材的项目,不过也有人反映原创项目同样遇到了问题。 这一变化发生在大批 AI 驱动的克隆项目涌现之后。用户一直在利用 Opus 5.5 和 GPT-6 Astra 大量制作《光环》和《侠盗猎车手:罪恶都市》等知名作品的非官方浏览器移植版,数量达数百个。Reverse Engineer Anything 等工具通过将 AI 智能体与逆向工程相结合,把原生二进制文件转换为可读的伪代码,为此提供了帮助。一位开发者因复刻 Adobe Creative Cloud 应用的部分功能而登上头条。索尼的 PlayStation 5 也在一次越狱引发模拟器快速涌现后成为目标。 继图像和视频之后,知识产权之争如今正蔓延到软件领域。Osmani 表示,Anthropic 计划今后继续调整相关规则。

    匹配字段正文

  5. 中华网科技

    亿信华辰发布睿治OPT多模态数据治理平台,采用 AI 原生架构

    亿信华辰于2026年10月30日发布睿治OPT多模态数据治理平台,采用 AI 原生架构,内置30余个数据治理专家智能体、50余项治理技能与100余个知识库,并将元数据、数据标准、数据质量等治理能力封装为 CLI。平台采用四层架构,提供全自动执行、人机协同、人工修订三种工作模式,多模态治理覆盖采集汇聚到场景化交付六个环节。

    架构,由智能体承担需求理解、方案设计、任务拆解与执行交付。前三代的共同局限在于自动化程度有限、高度依赖人的经验积累,且难以沉淀为可复用的组织能力。 金正平将 AI 时代数据治理面临的挑战概括为三个方面:通用大模型缺乏数据治理领域知识,存在幻觉,治理结果难以直接采信;AI 应用强依赖数据治理,而治理建设本身周期长、过程难以标准化;传统工具难以处理文档、图像、音视频等非结构化数据,而大模型训练所需的高质量数据集,强依赖多模态治理能力。 四层架构:专家库、技能库与知识体系构成"数治超脑" 睿治OPT采用四层架构。AI 交互层提供多轮对话、流式响应与任务状态管理,用户以对话方式表达需求;数治超脑层由专家库、技能库与知识体系构成,专家覆盖需求调研、治理规划、数据架构、模型设计、数据开发、数据标准、数据质量、数据资产、数据安全、数据服务与治理评估等角色,知识体系涵盖 DAMA-DMBOK2、DCMM 2.0、行业规范、法律法规及多行业项目实践;智能体平台层负责大模型调度、任务编排、专家协同与工具调用;治理功能层则将原有治理模块 CLI 化,形成睿治CLI、睿码CLI、ABI CLI 三类命令入口,

    匹配字段正文

  6. 凤凰科技

    Anthropic 在 S-1/A 文件中警示递归自我改进风险

    Anthropic 在周一更新的 S-1/A 招股补充文件风险提示中表示,公司可能很快就会触及《负责任扩缩策略》定义的递归自我改进状态。文件称公司已借助 AI 开发出新模型并实现部分能力跃升,但当时团队并未察觉,未来也可能在研发提速发生之后才察觉。Anthropic 同时说明现有模型均未跨过该门槛,并承诺在可预见的未来保留人类参与前沿模型研发,正考虑修订《负责任扩缩策略》。

    e 完全自主设计、迭代前沿大模型。因此,我们正考虑修订《负责任扩缩策略》,保证前沿模型的开发始终由人类掌控。” 持怀疑态度的人会指出,S-1 招股文件兼具信息披露和宣传属性,宣称即将做出能够自我迭代的超强模型,或许只是宣传话术。 但不可否认,Claude 今年的能力,尤其是编程、数学和网络安全方面,实现了跨越式提升。如果 Anthropic 判断递归自我改进近在眼前,或许我们应当重视这个判断,并据此采取行动,搭建对应的监管规则。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  7. 凤凰科技

    高盛收紧Claude Code等AI编程工具权限,部分交易员不满

    高盛在10月更新的内部指引中收紧Claude Code及微软GitHub相关工具的使用权限,将其主要限定给工程师使用,引发部分交易员不满。此前部分交易员依靠这些工具监控客户交易流、模拟市场与头寸变化;从事交易、量化研究与软件工程交叉工作的“strats”员工不受此次限制。高盛自有AI助手GS AI Assistant整合了OpenAI、Anthropic及Alphabet的模型。

    验评估各类AI工具在不同部门的用途,综合考量生产力与风险管理等因素,再确定适合长期使用这些工具的人员。 据路透社此前报道,高盛于2025年6月在全公司推出GS AI Assistant,当时已有约1万名员工使用。彭博社此次报道提到,高盛自有AI助手整合了OpenAI、Anthropic及谷歌母公司Alphabet的模型。(作者/宋淑美) 更多一手新闻,欢迎下载凤凰新闻客户端订阅凤凰网科技。想看深度报道,请微信搜索“凤凰网科技”。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  8. 36氪 · AI

    AI 数据公司凶猛:UniPat 传获阿里腾讯投资,估值达 25 亿美元

    36氪旗下硅星人Pro 报道,成立不到一年的数据公司 UniPat 被曝正洽谈约 3 亿美元融资,阿里领投、腾讯和红杉中国参与,投后估值 25 亿美元。文章称带用户行为轨迹的数据一条报价可达 1000 至 3000 元,带完整操作过程的工作场景数据可卖到 1 万元左右,Mercor 估计前沿实验室所需数据目前只完成 2% 到 5%。随着模型厂商收紧采购、核算 ROI 并对供应商数据做消融,行业已出现拉黑数据商、数据质量难验证等问题。

    以1000万美元拍下内部数据,包括约1亿封邮件和5亿条 Teams 消息,出价第二高的是 Mercor,750万美元。空乘工会随即提出异议,认为去掉姓名并不能保护员工在工作中留下的保密内容,原定8月19日的批准听证被推迟。 3月底,黑客借开源工具 LiteLLM 的恶意版本攻破了 Mercor 的系统,据诉状和黑客团伙的说法,流出约4TB数据,其中约3TB是视频面试录像和身份验证材料,涉及超过4万名合同工和客户。到4月中旬,Mercor 已面对至少6起集体诉讼,Meta 无限期暂停了和它的合作。 在不断走高的融资,混乱的标准,套利空间很大的定价之下,更多灰色地带开始被发明。一位业内人士向我们转述,有数据商付钱请大厂员工,在公司外重做一份和内部一样的数据,再拿去对外交付。 还有行业人士透露,在竞争开始白热化后,一些数据公司需要给投资人更好看的财务报表,于是有传出成立半年收入3000万美元的公司,据称其中一部分是用自己的预测模型在 Polymarket 上下注赚来的,这些也算进了总收入。 还有在股权上直接做新的“设计”,供应商向能影响采购的人许诺少量股份或收益,等拿到订单、完成融资、估值上

    匹配字段正文

  9. 钛媒体 · AGI

    AI数据库扎堆发布的一年,电科金仓KES AI等产品都升级了什么?

    电科金仓10月底发布KES AI数据库,把语义构建、计算推理和原生数据安全管控放进数据库内核,强调数据不出库即可支撑AI应用。阿里云PolarDB今年1月推出AI数据湖库(Lakebase)等能力、7月推出PolarDB Agentic Database,OceanBase则在6月将AI方向打包为OceanBase AI Database产品组合。IDC数据显示,2025年中国AI数据基础设施市场规模约149亿美元,2030年将达738亿美元。

    杜胜打了一个比方:靠提示词约束大模型不要越权,像管教孩子时口头说教;数据库底层的权限管控是实实在在的围栏。这个对比点出了库外方案的一个结构性缺陷,用户可以在应用层写无数条安全规则,但规则和真实数据之间隔着一个可以被绕过的导出环节。 而在AI时代,除了做好数据不出库之外,多模融合则是最为关键的一个能力。AI应用面对的数据形态早已不是整齐的二维表,文档、图片、音视频、图谱、时序流同时出现在一个智能体工作流里。过去企业更多采用的是专库专用,交易用关系库,向量检索用向量库,关联分析用图库,一个应用背后串着好几套引擎,数据在库与库之间反复搬运。 而如今,融合型数据库从加分项变成规模化落地的主流选项,独立向量引擎的窗口期在收窄。面对是替代,还是共存的分叉路,杜胜的判断是替代与共存并行,“绝大多数普通客户要的是一套数据库搞定多类能力,降低DBA运维和学习成本。只有纯图超大规模社交网络这类极端场景,独立专用库仍有保留价值。主战场依然是关系数据库,多模是叠加在其上的能力,实现一体化融合,而不是另起炉灶。”杜胜强调道。 中国信通院《数据库发展研究报告(2026年)》测算,2025年中国数据库市场规模约94

    匹配字段正文

  10. 中华网科技

    今小店OPC创业孵化基地在济源启动招募,以AI赋能一人公司创业

    今小店OPC创业孵化基地在济源古轵公园北门正式启动招募,面向大学生创业者、自媒体创作者、副业创业者、实体商家和AI初创团队,提供免费办公场地、财税辅导和AI工具算力补贴。基地依托今小店零售垂直行业大模型,打通本地商家、供应链与推广渠道,支持一人公司完成产品、运营、营销全链路闭环。

    渠道,依托今小店零售垂直行业大模型,形成完整商业闭环,让个体创业者不再单打独斗。 01什么是OPC? 一个人也能开一家公司 OPC,全称One Person Company,即"一人公司"。它是在AI协同下,由个人独立完成产品、运营、营销等全链路闭环的新型创业模式。 过去开公司,租办公室、招人、养团队,动辄十几万元投入让人望而却步。 而在AI时代,写文案、剪视频、做图、客服等大量环节可由AI承担,开店、上架、收款、对账由平台系统完成,供应链与货源由平台对接——创业者真正需要投入的,是想法、执行力和坚持。 02入驻可以得到什么? l 免费办公场地·拎包入驻 基地内设独立分区工位、共享会议室、洽谈接待区,水电物业全部由集团承担,基础网络免费开放给入驻伙伴使用,不用为房租、办公配套发愁,降低创业起步成本。 l 财税创业辅导·合规起步 专门针对OPC“一人公司”创业者提供全流程创业辅导,解决初创不懂办证、不懂财税的痛点。 支持集群注册、一址多照,营业执照办理、刻章、对公账户开立全程协助;配套财税规范辅导,从注册、记账到申报全流程答疑,帮你避开经营风险,从第一天就合规经营。 同时专人辅导创业补贴

    匹配字段正文

  11. Unite.AI

    NVIDIA 携手合作伙伴扩展城市 AI:共享基础设施与数字孪生

    NVIDIA 于 2026 年 11 月 3 日宣布,与其合作伙伴在全球扩展面向城市的物理 AI 与智能体服务,覆盖居民协助、交通管理、城市规划和工业运营,并让地方政府继续掌控敏感数据的处理与使用。项目以共享计算基础设施、AI 智能体和数字孪生为组合,城市团队可用 NVIDIA RTX 工作站或小型 GPU 系统起步。ITMAX 的 SamurAI V2 视觉智能体计划到 2027 年支持超过 17,000 路摄像头,基于 TeraSim 的信号配时测试使高峰时段走廊通行时间最多缩短 26%。

    hysical AI Host 体验。 LiveX 报告称已在 100 多个客户站点部署,包括圣何塞米内塔国际机场、El Camino 医院、SAP 中心、PUMA 门店以及万豪和希尔顿酒店。该系统运行在 NVIDIA RTX PRO 6000 Blackwell 服务器版 GPU 上,并使用 Cosmos 世界模型、经过微调的 Nemotron 模型和用于视频搜索与摘要(VSS)的 Metropolis 蓝图,同时 Omniverse 库可支持位置感知的数字孪生。 在波兰弗罗茨瓦夫,K2K 正利用 NVIDIA 加速计算、Cosmos 世界推理模型和 Metropolis VSS 蓝图构建共享 AI 基础设施。该系统旨在将现有摄像头视频流转化为可操作信息,用于多个城市职能中的出行、安全和事件响应。 ITMAX 将基础设施和智能体 AI 应用打包为面向马来西亚城市的长期托管服务,其中包括交通管理。NVIDIA 报告称,ITMAX 的 SamurAI V2 视觉智能体正在 RTX PRO 6000 GPU 上扩展,目标是到 2027 年支持超过 17,000 路摄像头;在 Laplace

    匹配字段正文

  12. NVIDIA Blog

    NVIDIA 与全球合作伙伴将物理 AI 和智能体 AI 扩展至城市服务

    NVIDIA 及其合作伙伴正把物理 AI 与 AI 智能体扩展到全球城市,覆盖西班牙、美国湾区、波兰、马来西亚、尼日利亚、台湾和摩洛哥等地。西班牙 1MillionBot 结合 ALIA 与 Nemotron 模型服务 150+ 部署;马来西亚 ITMAX 的 SamurAI V2 计划到 2027 年支持 17,000+ 摄像头,其 TeraSim 仿真将高峰走廊通行时间最多缩短 26%。

    借助NVIDIA Cosmos 世界模型和Nemotron开放模型,以及基于NVIDIA RTX PRO GPU的 Omniverse 和 Metropolis 库,将其AI城市愿景变为现实。交互式对话AI主机能够理解人们的需求、提供答案并采取行动,并可根据机场、医院、本地活动和其他公共场所的当地语言和服务需求进行定制。 视觉AI智能体可以将现有的城市摄像头视频流转化为运营洞察,帮助团队识别出行和安全问题,并协调跨城市服务的应急响应。 在 波兰弗罗茨瓦夫, K2K正在利用NVIDIA加速计算、NVIDIA Cosmos世界推理模型和NVIDIA Metropolis视频搜索与摘要(VSS)蓝图构建共享AI基础设施,将现有摄像头视频流转化为可用于出行、安全和事件响应的可操作智能——在多个城市职能中复用同一基础设施。 在 马来西亚, ITMAX 将基础设施和智能体AI应用打包为面向城市的长期托管服务,包括交通管理。ITMAX的SamurAI V2视觉智能体参考Cosmos、Nemotron和Metropolis VSS蓝图构建,正在NVIDIA RTX PRO 6000 GPU上扩展,以到

    匹配字段正文

  13. NVIDIA Developer · Generative AI精选

    NVIDIA 开源 NVIDIA Recovery,自动恢复集群分布式训练任务

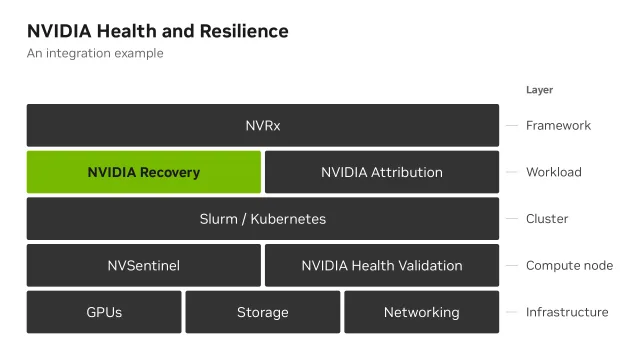
    NVIDIA 发布开源工作负载级恢复服务 NVIDIA Recovery,通过应用日志、GPU 指标和调度器信号检测训练中断,并按检测、归因、隔离、重启或停止四阶段循环处理。该服务以 Apache 2.0 许可在 dsx-ai-factory/NVIDIA-Recovery 仓库开放,Slurm 集成通过 Helm chart 部署的 Advisor Controller 实现,支持集群内和 SSH 两种模式。新部署默认处于监控模式,只输出恢复建议不执行调度动作;7 月 9 日至 10 月 9 日在一个训练集群上的监控覆盖每天近 200 个任务,记录约 8,550 次异常检测,平均检测与恢复动作延迟分别为 69 秒和 94 秒。

    Five-layer stack diagram showing where NVIDIA Recovery sits in the health and resilience architecture. From the base up: infrastructure, compute node, cluster, workload (where NVIDIA Recovery and NVIDIA Attribution sit), and framework (NVIDIA Resiliency Extension, or NVRx).

    的操作(终止、重新排队、释放或节点排除)、时间戳、工作负载标识符,以及 NVIDIA Attribution 返回的判定结果(若有)。策略引擎操作和看门狗操作会记录在同一条轨迹中,因此记录没有缺口。 Recovery Console 是运维人员仪表板。它显示跨调度器类型的实时工作负载状态,内联呈现异常标记,并为你提供每个工作负载的检测事件和恢复操作时间线。 视频 1:演示在 Kubernetes 上使用 Slurm 的 NVIDIA Recovery 全流程,从环境搭建和作业配置,到作业失败、自动恢复与归因 NVIDIA Recovery 已在 dsx-ai-factory/NVIDIA-Recovery 采用 Apache 2.0 许可证的 GitHub 仓库。让首个工作负载进入恢复流程需要三个步骤: 安装该 chart。NVIDIA Recovery 通过单个 Helm umbrella chart 部署。它附带一个捆绑的 MySQL 子 chart,因此你可以在本地运行快速入门,而无需预置数据库或物理 GPU。对于生产环境,请将该 chart 指向托管 MySQL 服务。仓库中的

    匹配字段正文

星期一

  1. ElevenLabs Blog

    合成语音是如何创建的?分步指南

    合成语音由神经 AI 模型分析并复刻人类语音模式生成,流程分三步:收集真人录音数据、训练或微调模型、再从文本生成音频。现代模型之所以听起来自然,是因为它复刻了人类韵律并具备上下文感知,而非逐词拼接;ElevenLabs 的生成式 TTS 还可用音频标签等指令控制情绪与节奏。

    Collect voice data, train a model, generate speech; voice design needs no recording.

    evenCreative帮助你为创意项目构建自定义的 语音体验 。你可以从超过20,000个预制声音的庞大库中选择,或通过准确且安全的语音克隆创建自己的声音。 使用ElevenCreative通过 即时语音克隆 或 专业语音克隆来复刻你的声音。即时语音克隆可在几分钟内完成,帮助你快速测试声音选项或启动个人项目。专业语音克隆使用更长的音频样本,创建适合有声书、视频游戏或播客等较长项目的高质量声音。无论你选择哪种方式,音频都可追溯到你的账户,以确保安全。 ElevenCreative的可自定义 语音库 和语音克隆工具帮助你的创意项目变为现实。 注册ElevenCreative ,探索标志性声音或创建你自己的声音。 常见问题 有几个因素会暴露低质量的AI语音。注意听异常呼吸声、名字发音错误、与文本不符的情感或不均匀的节奏。请记住,现代合成语音很难仅凭耳朵识别。检测工具可以提供帮助。一些工具可识别音频水印,另一些则估计样本由AI生成的概率。阅读我们的 AI语音检测指南 以获取更详细的解析。 语音克隆并不违法。你可以合法地克隆自己的声音,或在获得他人明确且有记录的许可后克隆其声音。但是,未经许可

    匹配字段正文

  2. Google Blog

    Google 10 月 AI 更新:Gemini 4 Argon 全球上线、Gemini 4…

    Google 在 10 月将前沿推理模型 Gemini 4 Argon 全球上线,覆盖 Google AI Studio、Gemini API、Google Cloud、Search 和 Gemini 应用,两周后公布主打长周期工程与网络安全防御的 Gemini 4 Carbon,目前通过 Fairwind Program 与美国政府及部分可信网络安全方进行预发布测试。同期发布实时交互世界模型 Genie 4,支持原生音频与自然语言操控场景;SynthID Detector 以英文全球开放,可识别 OpenAI、NVIDIA、Kakao、Apple 等合作方的 AI 内容。

    Text with a rainbow colored gradient "The big picture"

    交互式模拟带来了前所未有的真实感、先进物理效果、逼真的人物动作和原生音频。你可以用自然语言在场景展开时对其进行操控。Genie 4 提升了我们为机器人和 AI 智能体创建安全训练环境的能力,是迈向 AGI 的关键一步。请在 Google DeepMind 博客. 在全球范围内更轻松地验证 AI 生成内容我们已使用 SynthID 为超过 1800 亿张图片和视频以及 24 万年的音频添加水印,现在正以英文在全球范围扩展 SynthID Detector,让任何人都能检查图片、视频或音频片段是否由 AI 生成。除了 Search、Chrome 和 Gemini 应用中每天定期处理超过一百万次请求的内置验证工具外,SynthID Detector 还能识别来自 OpenAI、NVIDIA、Kakao 和 Apple 等行业合作伙伴的 AI 内容。 借助全新的 Android 防护措施,远离移动诈骗,保障安全。Google 与 Google Messages 中由 AI 驱动的手机诈骗检测功能,每月已能标记超过 500 万通疑似诈骗电话和短信。如今,Android 正在 Google Mes

    匹配字段正文

星期日

  1. Sakana AI:Blog

    Sakana AI 举办东京研讨会:Jürgen Schmidhuber 谈 AI 历程…

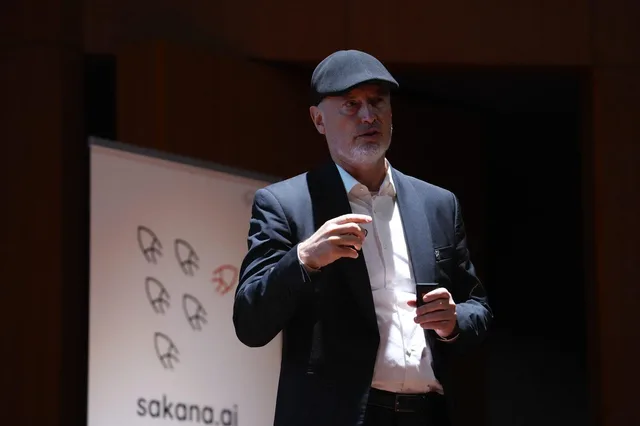
    Sakana AI 在东京一桥讲堂举办研讨会,宣布启动自研预训练语言模型系列「Sakana Sawara(暂定名)」,首个模型 Sawara Small(暂定名)计划于 2027 年春季发布。首席科学顾问 Jürgen Schmidhuber 发表主题演讲,与 CEO David Ha 对谈,活动吸引日本各地 400 余名参会者。Sakana AI 将 AI 主权规划为预训练、后训练与编排三大支柱,后两者分别对应 Sakana Namazu 与 Sakana Fugu。

    更好的计划方法。朴素的做法是利用世界模型以毫秒为单位模拟未来。这对国际象棋和围棋足够了,但并不是本来应该做的事。 在制定从这里去巴黎的计划时,没有人会模拟抓住电话的手部动作。叫出租车、去机场、办理登机手续。只抓住几个关键点,制定一个紧凑的计划。 我在2015年提出的是这样一种方法:控制器向世界模型(M)的隐藏单元发送查询。M可能已经看过YouTube上的所有视频,也可能拥有大量机器人经验。控制器是一个会学习的提示工程师。它只关注与当前要解决的问题相关的内部表征,从中引出答案,并改变自己的行动。那些查询不是英语也不是日语,而是数值向量的序列。简单的问题从头解起会更快吧。但任何有趣的问题,都应该能从沉睡在巨大模型深处的算法性信息中大大受益。2018年,我还写了一篇用蒸馏将控制器和模型合为一体的论文。不过,2018年更有名的论文,是用精彩实验证明世界模型确实有用的David那篇。 走向屏幕之外的AI 在这里,让我们把目光转向更广阔的历史背景。今天我讲的许多事情,发生在德国和日本。 1990年,日本看起来像是未来的国家。全球市值最高的前6家公司全是日本企业。1995年,日本和德国的名义GDP加

    匹配字段正文

星期六

  1. Figma AI / Agent / Make

    Figma Weave 详解:把创意流程变成可复用的工作流

    Figma Weave 将 AI 生成与编辑工具整合为基于节点画布的可复用工作流,并新增与 Figma 画框并行的使用方式。工作流支持分支探索、同一提示词跨多个 AI 模型对比结果,内置色彩校正、合成、色阶、裁剪、修剪、绘画等编辑节点。Weave 工具已开放社区发布,队友无需操作节点即可直接运行打包好的流程。

    A “Spring Arrivals” campaign design shown in Figma Design beside its connected Figma node in Weave, with options to update the Figma design or review an update.

    作底层节点即可运行。 最好的作品诞生于你和队友能够共同在想法上继续构建之时——从早期探索到最终打磨,在工作仍在成形之际就有参与贡献的空间。这正是 Figma Weave 连接 Figma 与 Weave 今天,我们宣布了让 Weave 创意工作流与你的 Figma 画框并存的新方式。背后的理念,它是一个面向有持续制作需求的创意团队的平台。Weave 将图像或视频的创建与编辑过程转化为你和队友可以调整并复用的序列。 你在 Weave 中的工作通过节点汇聚而成——节点是添加图像和提示词、生成内容以及进行编辑的构建模块。节点在画布上相互连接,展示作品的成形过程,并让你回到较早的节点进行修改。你和队友随后可以将同一工作流适配到新产品或新格式上,从而在加快速度的同时不放弃创意控制权。 无论你是将现有图像转化为营销活动视频,还是无需再次拍摄就能创建新的产品图像,Weave 都能让你减少在设计创意与创意制作之间来回转换的时间,把更多时间用于打磨你的构想。 Figma Weave 为创意团队带来的可能 Figma Weave 让你的团队流程从始至终可见且相互连接。以下是它在实践中的样子。 Figma

    匹配字段正文

星期五

  1. Arena

    Arena 分析 26,225 条 Agent 会话:没有缓存,智能体成本高 3.6 倍

    Arena 分析 2026 年 9 月 12 日至 10 月 23 日的 26,225 条 Agent 会话、30 个智能体和 13 家实验室,发现若按完整输入价计费,排名前十智能体的典型任务成本会高出 3.6 倍,MiMo V2.6 Pro 上高出 592%。智能体 86% 至 96% 的 token 是重复读取的上下文,自身输出仅占 1% 至 2%。缓存失效会让典型任务成本增加约 5%,在 Claude Fable 5.1 上每 10 次会话有 1 次增幅超过 18%。

    体,重复读取占 token 的 86% 至 96%,而输出仅占 1% 至 2%。在前十名中,智能体每写出一个 token,大约要重复读取 93 个 token。 这是因为模型在调用之间不保留任何记忆。智能体循环的每一步都会把整个对话重新发送回去,而提供商则从缓存中提供它已经见过的内容。随后产生的回复又会被之后的每一步再次读取,于是雪球越滚越大(快速解释见下方视频)。 这一机制使得重新读取此前的对话远比重新发送便宜,通常只有价格的十分之一或二十分之一。但它只有在提供商仍保存着该对话时才有效。如果提供商不再保存,会发生什么? 每次缓存失效都会增加费用 上面两张成本图表展示了极端情况:什么都不保存,完全没有缓存。 在实践中,缓存大多数时候表现符合预期,但失效确实会发生。结果,智能体不得不按全价重新发送整个对话。这是使用智能体的正常组成部分,我们在以下情况会看到缓存失效: 保存的缓存过期。提供商只会保留一段时间,从几分钟到几小时不等。例如,Anthropic 默认保留 5 分钟,OpenAI 保留 30 分钟,两者都收取额外费用以延长保留时间。如果用户离开,或某个工具运行时间很长,那么智能体继

    匹配字段正文

  2. 上观新闻

    瑞金医院发起医疗健康数字孪生联盟,启动5000万人类健康数字孪生计划

    上海交通大学医学院附属瑞金医院牵头发起医疗健康数字孪生联盟(ICDT-HM),并启动“5000万人类健康数字孪生计划”,目标是通过融合纵向健康数据与动态模型支撑疾病预测、精准预防和个体化医疗。联盟将推动大规模纵向人群队列与AI深度融合,在数据标准、跨人群验证和数据治理上凝聚国际共识,5000万人为分阶段推进的规划目标。

    国家级人群队列建设者,聚焦代谢性疾病、心脑血管疾病、肿瘤等重大疾病,融合临床诊疗、长期随访、多组学和可穿戴设备等多维数据,加强基础研究与临床验证;推动大型人群队列建设,统一数据标准,探索隐私保护、合规授权、可信流通和安全治理的有效路径;深化国际合作,推动医疗健康数字孪生成果转化应用。 Nature生物、临床与社会科学主任编辑Francesca Cesari在视频致辞中强调,研究设计、数据质量、外部验证和可重复性,与数据规模同样重要,预测表现不能替代临床证据。模型适用于哪些人群和场景、存在哪些局限、能否改善患者结局,都需要认真评价。数字孪生的价值,应体现在更有依据的临床决策、更公平有效的医疗服务和疾病负担的减轻上。 澳门科技大学医学院副院长、人工智能交叉应用研究院院长、国家眼部疾病临床医学研究中心首席科学家张康介绍了联盟发展蓝图与核心工作,重点分享“5000万人类健康数字孪生计划” (50M Human Health Digital Twin Initiative) 。“5000万人数字孪生计划”是联盟面向精准健康提出的长期科研规划,旨在通过多方协作,逐步构建融合纵向健康数据与动态模型的

    匹配字段正文

  3. 雷锋网

    科大讯飞董事长与总裁主动降薪,两人均少领超2000万;百度确认吴甜离职,文心模型下周发布新进展

    科大讯飞回应高管薪酬质疑:董事长刘庆峰、总裁吴晓如主动下调年薪,2025年度实际领取410万元、300万元,两人应发薪酬均减少超2000万元。百度确认集团副总裁、百度研究院副院长吴甜已离职,文心模型下周将有新进展对外发布。美国司法部对英伟达129亿美元收购Hugging Face展开反垄断调查,重点评估GPU捆绑销售与AI生态分发节点控制问题。

    要闻提示 1.科大讯飞回应高管薪资质疑:董事长与总裁主动降薪,两人均少领超2000万 2.内部会议视频被吐槽演的太尬!阿维塔副总裁:是摆拍,但事是真的 3.华为“天才少年”杨玉雯加盟南京大学 4.百度确认吴甜已离职,文心模型下周将发布新进展 5.王腾创业首秀感谢小米和雷军!回应蹭流量质疑:真心感激过往经历 6.国产3A《影之刃零》登顶全球畅销榜,评分超《黑神话:悟空》 7.智元彭志辉:公司2026年上半年营收近20亿元 8.突发!英伟达遭调查:GPU捆绑销售成焦点 今日头条 科大讯飞回应高管薪资质疑:董事长与总裁主动降薪,两人均少领超2000万 10月29日消息,近日,有投资者在互动平台向科大讯飞提问,关注公司高管薪酬集体上涨与同行接轨等问题。科大讯飞就此作出回应,披露了公司高管主动大幅降薪的细节。 科大讯飞表示,公司高管薪酬严格依据2026年5月修订的《董事、高级管理人员薪酬管理制度》执行。按制度测算,2025年度公司董事长、总裁的应发基本年薪与绩效年薪合计为2795.69万元。然而,考虑到公司所处发展阶段,同时为了更好地奖励A类优秀员工,董事长刘庆峰先生、总裁吴晓如先生主动提出年薪

    匹配字段正文