←搜索结果

按匹配度 · 共 2896 条结果 清除搜索

星期三

  1. Latent Space

    Anthropic 取消编程面试:Felix Reiseberg 称"Hunger beats tenure

    Anthropic 招聘经理 Felix Reiseberg 宣布不再用传统编程面试考察候选人,理由是 Claude 在 React 挑战和汇编题上都已强于人,真正有影响力的构建者不靠这类测试取胜。他建议初级工程师选能带来业务影响的想法、周末做出可运行原型、只聚焦一个好点子,并发挥对用户的新鲜视角。同日 Google DeepMind 发布 Genie 4 世界模型,Artificial Analysis Intelligence Index v5 榜首为 Claude Opus 5.5(58 分)。

    恶意软件检测提示下,把 Qwen 3.8 Flash Next 变成了续写/URL 生成器。帖子援引 Cohere CEO 张在《The Register》上的说法,称 Cohere“没有证据”表明该行为是蓄意的,且该行为在不到 1/100,000 次调用中出现;作者声称自己的 Q38FN 日志中不含阿里巴巴 URL,并认为通过从长前缀强制续写,很可能也能从其他开放权重模型中引出类似产物。高赞评论强调实际的安全启示:无论供应商是谁,智能体框架都应对不可信的 LLM 生成代码/命令进行沙箱隔离。其他评论者将 Cohere 的披露定性为恶意营销/宣传,并表示将避免使用 Cohere 产品。 一个技术相关的主题是:LLM 生成或第三方代码应默认被视为不可信/恶意,并且只能在适当的沙箱内执行。一位评论者特别警告那些以宽松设置运行智能体框架或忽略权限的用户:Cohere/Qwen 指控的具体细节不如一般性运营安全规则重要——不要让智能体以广泛的主机或网络访问权限执行代码。 2. 本地推理性能:Strata、TokenGate、GPU 解锁赞助此处放置您的赞助广告触达正在构建下一代的 AI 工程师

    匹配字段正文

  2. AIhub

    AI 从实验室走向现实世界为何困难:泛化、人类行为与资源三大挑战

    AI 视觉系统从实验室走向家庭、医院和街道时面临泛化、人类行为与资源三大挑战:多数模型只用光照良好、高质量图像训练,在低光或夜间场景下人体姿态估计性能会明显下降。作者团队用无监督域适应方法,在无需低光图像人工关节标注的情况下,于 2026 年一项低光人体姿态估计研究中让模型在两个低光 benchmark 上大幅提升。人类与物体交互的动作组合数量庞大,难以逐一采集标注,研究转而用大型视觉语言模型识别训练中未见过的新交互。

    于训练它的数据无法充分代表现实世界的巨大多样性。 “AI无法应对水坑”:被淹的街道让这辆Waymo在凤凰城陷入循环,在交通拥堵中来回移动了10多分钟 —— AccuWeather (@accuweather) 2026年9月18日 以人体姿态估计为例。这项任务涉及检测人体上的关键点,例如关节,以理解他们如何移动。其结果类似于一个数字骨架,表示一个人手臂、腿和其他身体部位的位置。姿态估计已被研究用于健康和康复应用,包括测量一个人的步态、监测康复锻炼以及评估与跌倒风险相关的运动模式。在光照良好的环境中,现代AI模型能以令人印象深刻的准确度完成这项任务。但在低光照或不均匀光照下,性能可能会急剧下降。这是因为模型是从干净、一致的数据中学习的,并未准备好泛化到更严苛的条件。 收集更多夜间训练数据能解决这个问题吗?更多标注数据当然会有帮助,但收集起来尤其困难。当一个人的关节在图像中难以看清时,人类标注者也难以准确标注它们。低光照还可能遮蔽视觉信息,而不仅仅是让图像变暗,而且夜间条件会因相机、阴影、眩光和其他噪声来源而变化。因此,收集并手动标注覆盖所有这些条件的样本既困难又昂贵。 我们一直在努力通过

    匹配字段正文

  3. Tessl:产品与工程博客

    谁来承担 AI 软件工厂的成本?

    Tessl 提出用七个环节管理 AI 软件工厂的成本:成本可见性与归属、任务准入评估、按完成任务的总成本选择模型、把重复的模型决策改为确定性检查、预算边界、价值核算与问责。文章主张每次模型调用、工具操作和工作流都应把成本归到触发它的任务上,失败重试也要计入,否则只统计成功任务会让流程显得比实际更便宜。

    DevCon NYC

    调用最终应该消失。检查必填字段、执行既定的依赖策略或验证生成的文件,通常可以由代码处理。智能体可以帮助制定规则并编写检查。一旦团队验证了它,就没有什么理由再让模型在每次运行时做出相同的决策。 例如,处理依赖更新的智能体可能会发现一个不断导致失败的兼容性要求。团队可以把它变成针对未来更新的检查,让智能体去调查例外情况。该检查需要测试和负责人,就像构建系统的任何其他部分一样。在一次成功运行中生成的脚本还不是一个受维护的组件。 进行这种转换是有成本的,所以从频繁调用和不太可能改变的规则开始。使用工作流记录来找出重复的调查和验证。随着时间的推移,工厂应该传承团队已经学到的东西,而不是每次都花钱重新发现它。 5. 设定预算并停止无成效的循环 智能体可能会不断重新运行测试或重写补丁,却始终无法更接近解决方案。在执行系统中为重试次数、经过时间和花费设定限制。要明确每个限制触发时会发生什么。阻止一个工具可能会让智能体转而使用另一个工具,而限制调用次数并不能说明这些调用可能有多昂贵。 预算必须包含委派出去的工作。不应允许多个智能体各自花费相同的剩余余额。在工作启动时预留资金,并在之后与实际使用情况对账。

    匹配字段正文

  4. 404 Media

    Meta 更新商业条款允许用用户内容训练 AI,英欧用户可提出反对

    Meta 本月更新商业条款,允许其使用关联域名、网页或 URL 的内容来开发、改进、研究、训练和维护 Meta 产品,引发依赖 Instagram 和 Facebook 的艺术家与小企业主不满。生效日期从 10 月 30 日推迟到 11 月 20 日,Meta 随后从允许用途列表中删去“训练”一词,并将用途限定为“广告和商业产品”。英国和欧盟用户目前可在 Instagram 隐私中心提交反对表单,有用户称收到 Meta 邮件确认反对获批;这些选项在美国等地不显示。

    法案》管辖。GDPR 于 2018 年开始强制执行,要求使用个人数据必须获得明确同意。这包括反对其数据被使用的权利。《人工智能法案》于 2024 年生效,规定了 AI 公司如何使用个人数据,以及人们如何选择加入或退出,并声明他们可以随时撤回同意。英国有自己的 GDPR 版本。欧盟委员会表示:“GDPR 规则仅适用于关于个人的个人数据;它们不管辖关于公司或任何其他法律实体的数据。但是,与公司相关的信息在能够识别自然人的情况下可能构成个人数据。” 几位英国和欧盟的用户解释了如何在 Instagram 上提出反对。Instagram 用户 bookish.sil 发布了一份在手机上操作的教程:点击账户上的三条线,进入隐私中心,然后点击“反对”,这会跳转到一个表单,要求用户写下他们反对其数据被使用的理由。他们收到了 Meta 的一封电子邮件,称他们的反对已获批准。Instagram 用户 jenniqueart 发布了类似的教程,结果相同。 我的 Meta 账户位于美国,但使用 VPN 将我的 IP 地址定位在伦敦后,我可以在 Meta 隐私设置中看到一些选项,让我可以反对 Meta AI 使

    匹配字段正文

  5. 404 Media

    英国和欧盟用户可反对 Meta 用其内容训练 AI

    Meta 更新商业账户条款,允许其使用关联网站和页面的内容来开发、改进和训练 AI,引发使用 Instagram 的小商家和艺术家不满。英国和欧盟用户目前可在 Instagram 隐私中心提交反对表单,已有用户称收到 Meta 的反对获批邮件。该条款原定 10 月 30 日生效,在遭到反对后改为 11 月 20 日,Meta 还从允许用途中删去了“train”一词,并将范围收窄到广告和商业产品。

    在 Kalshi 正在寻找新方法,为这些预测定价。Kalshi 与 S&P Dow Jones Indices 之间的这一合作令人着迷。”拜托,老兄。 今日打印机:我完全被这张喷墨打印的显微摄影迷住了,它赢得了 2026 年尼康小世界显微摄影比赛。Ole Bielfeldt 的作品在他的 Instagram 上,绝对值得一看。哇,哇哇。 今日“哎呀”:一个 Roblox 抓取程序从一个 3D 建模社区抓取了超过一百 GB 的数据,其中包括来自该网站一个名为“SmutBase”的版块的 60 多 GB 成人内容。“我们认为 Roblox 并非有意收集成人内容,我们也没有证据表明其中任何内容进入了模型或产品。这些抓取很可能是自动化的。但这正是问题所在:就我们的日志显示,没有人检查过。一个为一家平台有数千万儿童使用的公司工作的爬虫,被指向了一个成人网站,它抓取了露骨模型,却没有将它们与其他任何内容区分开来,”Open3DLabs 在一篇关于此次抓取的博客文章中写道。“对于一家正因儿童安全问题被美国几个州起诉的公司来说,‘我们的 AI 团队批量下载了一个成人网站却没看一眼’可不是什么好处境。”

    匹配字段正文

星期四

  1. Latent Space

    Latent Space 访谈 Supabase 创始人:智能体为何偏爱 Supabase

    Latent Space 与 Supabase 创始人 Paul Copplestone 和 Ant Wilson 对谈,讨论智能体为何把 Supabase 作为应用后端首选。文中提到 Supabase 每月约上线 500 万个数据库,并介绍了无需 Docker 的本地运行时 alpha、把期望数据库 schema 存入 Git 的声明式方案,以及私有 alpha 的 Supabase Compute、Multigres 和收购 Turso 等 Scale 侧动作。

    体友好方向上最喜欢的一点。这些本来就是我作为开发者早就想要的改进。让它们对智能体有用,给了团队另一个把工作做完的理由。 计算值得的不只是一条要点 我认为目前处于私有 alpha 的 Supabase Compute 可能被低估了。一个应用程序既需要有个地方做它的工作,也需要有个地方存储结果。有了数据库之后,你仍然需要一个地方来运行那些对文档分块、生成嵌入或做其他长时间运行工作的进程。赞助 你的赞助广告位在这里 触达正在构建下一步的 AI 工程师。 Latent Space 的读者正是那些发布智能体、模型和基础设施的人。咨询赞助此广告位。business@latent.space → Paul 和 Ant 讨论了在数据库附近运行容器。这弥合了启动应用程序与运营它之间的差距:需要配置、连接并向智能体解释的独立服务更少了。边缘函数仍然有用,但它们并不能覆盖所有工作负载。 运营侧也很重要。日志、检查、连接和上下文能帮助智能体理解它正在改变什么。一个能发出 SQL 的模型仍然需要知道数据库里有什么、应用程序如何使用它,以及出错时发生了什么。Supabase 的 Operate 公告值得与新的构建

    匹配字段正文

  2. Latent Space精选

    Google DeepMind 发布 Gemini 4 Carbon,登顶 Artificial…

    Google DeepMind 发布 Gemini 4 Carbon,在 Artificial Analysis Intelligence Index v5 上以 59 分排名第一,并在 HLE-Diamond、TB-Science 等 9 项评测中的 4 项领先。该模型主打网络安全与长周期任务,宣称在 SEC-bench Pro 上取得 88.2%、ExploitGym 上 54.8%、CWE-bench 上 71.0%,初期仅通过 Fairwind Program 向可信网络安全人员开放。规格上支持 1M token 上下文与 1M 最大输出,输入覆盖文本、图像、视频和语音,输出为文本;Artificial Analysis 列出的标准价格为每百万输入/输出 token 4/20 美元,另有 50% 上线折扣。

    7.76 美元,而 Opus 5.5 为 10.04 美元,GPT-6 Astra 为 6.25 美元。它每项任务使用 123k 输出 token,比 Opus 少 29%。 幻觉:Carbon 以 54 分在 Omniscience 上领先。其幻觉率从 Argon 的 4% 升至 11%,仍是测得第二低的。Opus 5.5 和 Astra 均为 50%。 其他独立评测: Arena:Carbon 在 Text Arena 中排名第 1(1528),在 Agent Arena 中排名第 2,每项任务中位成本为 1.80 美元,在 Code Arena: WebDev 中排名第 4(1768)(@arena)。Arena 将相对 Argon 的提升归因于更多赞扬、更多确认成功和更好的可操控性(@arena)。 Vals:Carbon 在 Vals Index 上排名第 2,在 Finance Index 和 Legal Research Benchmark 上排名第 1。它产生的输出 token 比 Argon 多 64%,主要是在金融、税务和法律任务上(@ValsAI、tokens)。

    匹配字段正文

  3. 中华网科技精选

    谷歌发布 Gemini 4 Carbon 大模型,重点提升网络安全能力

    谷歌推出新一代大模型 Gemini 4 Carbon,聚焦网络安全与长周期复杂任务处理,在 Artificial Analysis Intelligence Index v5.0 中综合得分 59 分,位居榜首。该模型在 WebDev Arena 上较前代提升 89 个 Elo 分数至 1769 分,位列第四;内部测试显示其输出安全代码的成功率比 Gemini 4 Argon 提升两倍以上。定价初期与 Gemini 4 Argon 一致,优惠期输入每百万 Token 2 美元、输出每百万 Token 10 美元,本周优先向少量网络安全从业者开放试用。

    升89个Elo分数,拿到1769分,位列榜单第四名。 网络安全是本次模型迭代升级的重点。该模型在漏洞挖掘、结果验证、漏洞修复的安全防御全链条均达到行业较高水平。内部测试结果显示,相较于上一代Gemini 4 Argon,Gemini 4 Carbon输出安全代码的成功率提升两倍以上。谷歌Chrome团队开展的对比测试表明,该模型产出高质量漏洞补丁的能力,远超其他机构研发的前沿大模型。 在安全对齐能力层面,该模型继承并优化原有多层安全体系。测评数据显示,其Terminal‑Bench 4.0测试作弊成功率达到0.0%,作弊尝试占比压缩至0.4%;内部编程环境下,高等级严重失准警报数量下降近八成。模型无依据的虚构输出问题相比上代减少约一半,当证据不足时,能够主动说明自身能力边界、拒绝违规操作,并列明缺少的相关信息。遇到表述模糊的用户需求,模型会先查阅参考资料,向使用者提示信息差异,而非盲目推演执行任务。统计显示,模型过度执行率下降26%,服务不足率下降29%,多步骤任务完整执行的可靠性得到增强,能够恪守项目既定范围。同时,该版本可完全抵御测评覆盖的间接提示注入攻击,攻击成功率为0.0%。

    匹配字段正文

  4. Hugging Face

    AnySpeechRecognizer 与 AnyDecisionModel:面向 Apple 平台的语音与决策开源模型

    AnySpeechRecognizer 在 Apple SpeechAnalyzer API 之上支持切换引擎,可选用 NVIDIA Parakeet TDT 0.6B v3(支持 25 种欧洲语言)、Moondream 后训练的 Parakeet Ultra、英文版 Parakeet Unified,以及阿里 Qwen3-ASR(0.6B/1.7B,覆盖 30 种语言和 22 种中文方言)。这些模型已转为 Core ML 发布在 Hugging Face Hub,Parakeet 转写 1 小时音频约需 20–40 秒,Qwen3-ASR 更慢且需数 GB 内存。包内还新增 Apple 框架没有的说话人分离模块 SpeakerDiarizer,基于 NVIDIA Streaming Sortformer,最多跟踪 4 位说话人。

    mobius 脚本,并将每次转换结果与原始模型进行校验。 只有你的应用请求时才会发生下载:每个 Parakeet 约 600 MB,实时编码器另需约 590 MB,Qwen3-ASR 为 0.9 至 2.4 GB,Sortformer 约 250 MB。文件存放在标准的 Hugging Face 缓存中,因此沙盒之外的 Mac 应用可以与 Python 及其他 Hugging Face 工具共享它们。 说话人分离 转写对话时,你往往想知道谁说了什么。这就是说话人分离,而 Apple 的 Speech 框架没有对应模块,因此 AnySpeechRecognizer 添加了一个。SpeakerDiarizer 在同一时间轴上,与 Apple 或 Parakeet 转写器并行运行 NVIDIA 的 Streaming Sortformer(基于 Core ML): 该分离器最多跟踪四位说话人,即使他们同时说话也能处理。SpeakerTimeline 收集其结果,并将每个带时间戳的词归属到某位说话人,因此你可以按说话人轮次打印转写文本。与 AnyLanguageModel 中的图像支持一样,

    匹配字段正文

  5. Hugging Face

    Hugging Face 宣布 Project ProtoStar:让公共资助科学数据达到 AI 可用状态

    Hugging Face 宣布 Project ProtoStar,推动公共资助科研成果以 AI-ready 格式系统共享,并配套开放基础设施与发布指南。Hugging Face 已托管超 17,000 个核心科学领域公开数据集,含医学与数学接近 29,000 个;2026 年前九个月新增科学数据集是 2025 年同期的三倍以上。首个挑战赛聚焦气候风险,用 210 座美国城市截至 2018 年的历史天气数据预测 2019–2026 年实际气候状况。

    -X 等成果。通过公开释放由此产生的模型、数据集和工具,这些工作展示了现有科学资源如何支撑他人可在此基础上继续推进的新研究。 这正是我们通过 Project ProtoStar 借助参与机构所采纳的机构政策进一步推动的活动类型。作为机构承诺的一个早期范例,CMU 的开源项目办公室正在鼓励其研究人员在 Hugging Face 上共享合适的数据集、AI 模型和其他研究成果,同时认可领域专用存储库的持续重要性。 开放科学挑战 让科学产物达到 AI 就绪是重要的第一步。我们还希望展示,当这些资源可供复用时,研究人员、开发者和更广泛的科学界能够取得怎样的成果。 ProtoStar 的一个核心问题是:以 AI 就绪格式发布的公共资助科学数据集、模型和代码,能否被便捷地发现、复用、组合和扩展,从而加速科学发现并增进公共利益? 为探索这一问题,ProtoStar 将组织一系列开放挑战赛,每场挑战赛由一家参与研究机构主办,并围绕该机构已公开释放的科学资源展开。这些挑战赛有两个互补的目标: 展示科学复用。给出研究人员和开发者基于公共资助科学成果开展工作的具体示例,包括跨机构或跨学科整合资源的应用。 了解

    匹配字段正文

  6. Meta:Newsroom · AI

    Meta 与五所美国大学合作,用其模型加速医学与科学突破

    Meta 与加州理工学院、俄亥俄州立大学、路易斯安那州立大学、印第安纳大学和 UTHealth Houston 五所美国高校合作,提供 200 万美元资助和最新模型访问权限,支持用其模型推进医学、物理、化学、生物、计算机科学和数学研究。具体项目包括用开放权重 SAM 模型监测婴儿气管套管移位、用多模态 AI 帮助痴呆症患者沟通,以及用开放权重模型结合腹部 CT、病历和 ECG 数据提前识别 HFpEF 心衰风险。

    算集成。一份概念验证已经发表,后续还有更多工作。 用于痴呆症护理的对话式AI 痴呆症患者常常面临沟通困难,而标准的对话式AI系统对此处理不佳,导致他们感到沮丧而非获得支持。印第安纳大学的David Crandall博士正在开展一个项目,旨在开发多模态AI方法,用于分析涉及患有痴呆症的老年人的对话,并利用这种理解帮助对话式智能体——包括社交机器人——针对个体用户调整其交互方式。该研究检验能否让AI系统对认知差异人群的沟通模式保持敏感。 更早识别心力衰竭风险 射血分数保留的心力衰竭(HFpEF)约占所有心力衰竭病例的一半,但早期识别可能较为困难——其症状与肥胖及其他常见疾病存在重叠,因此正式的评估往往只有在临床怀疑形成之后才开始。 在俄亥俄州立大学医学院,AI 研究员薛源(Yuan Xue)博士正与心脏病学家韩宇驰(Yuchi Han)博士和 AI 研究员 Xia Ning 博士领导一个项目,研究 Meta 的开放权重模型如何利用常规腹部 CT 扫描、纵向病历以及可获取的心电图数据,帮助预测未来的 HFpEF 风险。该团队正在设计模型以处理缺失数据,因为现实临床实践很少能提供完整的输入集。

    匹配字段正文

  7. AIhub

    从教机器到教人:专访 Michael Littman

    AIhub 的 AI Pioneers 系列专访强化学习研究者 Michael Littman,回顾他从 1980 年代用井字棋自建强化学习系统、到 1988 年才得知这属于强化学习的经历。他认为深度强化学习靠堆算力解决了不少行为问题,但数据需求过大、难以像动物一样做出创造性跳跃,机器人导航等真实场景仍远未解决。他还谈到生成式 AI 给教育带来的挑战,以及用音乐传播计算机科学概念的科学传播方式。

    e to Joy》里提出的一些东西。尤其是,我已经有点偏离了那种“只构建一个智能体或程序,然后让它自己想办法解决问题”的观念。我想,人类也许会觉得,做一个人大概就是那么回事。但事实是,我们一出生就置身于非常丰富的文化之中,包括观念和人工制品。 我们周围的一切都在试图指引我们,告诉我们怎样才能最好地生存、互动并做出好的决策——我们从同种个体、也就是我们文化中的其他成员那里,接收到非常详细的信号。当我们把任务传达给彼此时,往往会采用涉及许多不同种类信号的方式。 在书中,我探讨了显式指令或程序的概念。你可以通过说“做这个,然后做这个,再做这个,然后如果发生这种情况,就做这个,但如果发生另一种情况,就做那个”来告诉某人该做什么。你可以把一切都明确写出来。这是一种让机器执行任务的相当有效的方式,也是我们今天所有计算机的基础。 但还有其他模型。例如,在监督学习中,你给出示例指令。你不是说“在这种情况下你要这样做”,而是说“这里有一种情况。这是在这种情况下正确的做法。这里是另一种情况。这是在这种情况下正确的做法。”我们会堆叠成千上万个或数百万个这样的例子,让计算机自己弄清楚其余的部分。我们对人也是这

    匹配字段正文

  8. 新浪科技

    受AI融资热推动 全球债券发行规模创纪录新高

    今年以来全球投资级和垃圾级债券发行共筹集6.61万亿美元,同比增长15%,在距年底还有两个月时已超过2025年纪录。其中云计算巨头和数据中心开发商发行近3680亿美元债券,是去年同期的六倍多,约占举债增幅的三分之一。亚马逊成为今年全球第四大发债主体、最大企业借款人,Alphabet紧随其后,美国十大企业发行人中有五家为科技公司。

    播放器end 行情图begin 行情图end 数据显示,今年以来,金融公司、企业和政府通过投资级和垃圾级债券发行共筹集6.61万亿美元,比去年同期增长15%,并在距离年底还有两个月的情况下就赶超2025年的纪录水平。 数据显示,单单云计算巨头和数据中心开发商就发行了近3680亿美元的债券,是去年同期的六倍多。这一部分约占今年以来举债增幅的三分之一,超过了所有其他非金融行业。 这一数据反映出人工智能建设在全球债务市场中扮演着愈加核心的角色,随着全球收益率上升和政府寻求为不断扩大的预算赤字提供资金,资本竞争日益激烈。 在AI时代,美国超大规模数据中心已成为主要的借款方。亚马逊公司是今年以来全球第四大发债主体,仅次于德国、欧盟和意大利,排名高于法国以及英国。这家电商巨头也已成为最大的企业借款人,紧随其后的是Alphabet。 在美国,今年十大企业发行人中有五家是科技公司,而以往通常在这其中占据主导地位的金融机构,其发行份额已降至至少十年来的最低水平。 “一年之内,全球最大市场的顶部发生了根本性重新排序,”摩根大通投资级金融全球联席主管John Servidea在一次采访中说道。“人工智能成为

    匹配字段正文

  9. Ed Zitron 长文 / Where’s Your Ed At

    Ed Zitron 长文质疑 Anthropic IPO:S-1 隐藏 Q3 数据,4300 亿美元算力承诺即将生效

    Ed Zitron 在长文中分析 Anthropic 的 S-1,认为这份文件只披露了 2026 年 Q2 数据,而该季度 9.74 亿美元利润来自 SpaceX 两个月的算力折扣,且未公布 Q3 营收、现金余额和付款时间表。他统计 Anthropic 与 Google、Amazon、Microsoft、SpaceX、Broadcom 等方的不可取消算力承诺约 2694 亿美元,另有 1250 亿至 1500 亿美元的 TPU 采购承诺未计入合同表,并指出 Q3 营收环比增长 45% 至 168 亿美元,而算力支出增长 76.3% 至 98.8 亿美元。文章还提到 5% 至 7% 的收入来自被认定违规使用其模型训练自家模型的客户,以及锁定期安排允许内部人士较快减持。

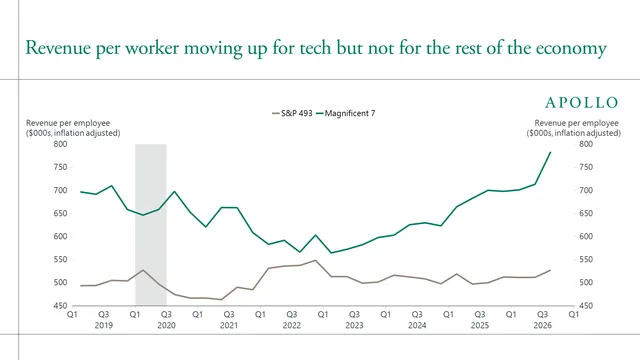
    务世界;一篇分析 生成式AI对全球经济(可疑)影响的文章;对AI基础设施领域最大参与者(如NVIDIA)的深度分析(第 一 部分和 二) 和 Oracle(第 一 和 二),如何 OpenAI 最终会杀死 Oracle, 以及 风险投资如何杀死自己. 如果你想联系我——尤其是如果你掌握关于Anthropic、OpenAI、Blackstone或AI泡沫中任何其他公司的劲爆信息——请通过Signal联系我,账号是ezitron.76。你也可以在你的Bloomberg Terminal上通过IB找到我。 上周, 我在我的通讯开头引用了Apollo首席经济学家Torsten Slok的一句话,请原谅我, 我不得不再引用一次, 强调 他的: 尽管人工智能领域有巨额投资和广泛炒作,但这项技术在美国科技行业之外的企业界没有带来任何财务回报。 Mag 7 的人均营收在上升,但标普493指数的人均营收持平,见下方第一张图。Mag 7 的利润率在上升,但标普493指数的利润率持平,见下方第二张图。而且仍然没有迹象表明 AI 正在提振生产率增长,见下方第三张图。由于对利润没有影响,美国主流企业正在收缩,并

    匹配字段正文

  10. Cartesia 产品与研究

    Cartesia 发布 Managed Agents 端到端语音智能体平台

    Cartesia 推出 Managed Agents 端到端语音智能体平台,面向企业通话场景,在 Artificial Analysis 的 Speech Agent Arena 上以 1115 的偏好 Elo 在 30 个智能体中排名第一。在 ServiceNow 的 EVA-Bench 上,该平台取得 87.4% 的准确率和 90.7% 的体验分,两项均为最高。平台将语音模型与 harness 联合设计,提供 44 种语言、工具调用、知识库和外呼批次等能力,官方称已在金融、零售、酒店和医疗场景支撑数千万次对话。

    AI 接入客户电话之前所寻求的平衡。这也 反映了我们在企业语音领域看到的更广泛模式:harness 与模型协同设计。 Nitin Aggarwal产品管理高级总监,负责智能体评估与 RAI 当来电者打断、停顿或改变主意时,智能体能自然地应对:在我们的内部评估中,来电者表示在与 Managed Agents 的对话中,85% 的情况下没有出现轮流发言问题,而其他智能体为 67%。 为复杂通话而设计 Cartesia Managed Agents 在一个端到端平台中提供了构建前沿语音智能体所需的全部工具。理赔受理、患者预约、零售退货、IT 服务台:企业通话很少保持简单。一次对话可能意味着验证来电者身份、查询三个系统并引用政策,而这一切都不能有丝毫停顿。 多语言:以 44 种语言构建智能体。智能体可以在对话中途在英语、西班牙语、印地语、法语和日语之间切换,全部 44 种语言即将推出。 工具调用:集成你的后端 API、CRM 和记录系统,让智能体能够在通话中查询记录并采取行动。 知识库:从数百份文档中获取精确答案。智能体的上下文会被动态预填充,因此它无需暂停搜索即可响应。 外呼活动:通过外呼

    匹配字段正文

星期五

  1. Latent Space

    Elorian 发布 DecoyCount 基准,前沿模型视觉计数准确率均低于 50%

    Elorian 与 Mercor 联合发布 DecoyCount 基准,测试模型是真正数清物体还是依赖视觉捷径,前沿模型准确率均低于 50%,最高为 GPT-6 Astra 的 43.17%。Elorian 称其视觉推理模型 Glimpse 在 1,660 道题上单次运行得分 50.48%,是唯一超过 50% 的模型,但该结果来自内部测试且未使用智能体或工具框架,而论文中的六个模型各取三次运行平均值。Elorian CEO Andrew Dai 表示,该基准同时考察视觉与推理,可区分模型是没看到物体还是数错了。

    接作用”,而 Elorian 更侧重于他所说的“间接作用”。他指的是利用视觉推理来为决策或工作流提供依据(Glimpse 所做的),而不是构建允许导航和操作的模拟环境(Atlas 所做的)。 举个例子,你可以用视觉推理来判断是否应拒绝某段用户上传的视频,因为它违反了政策。“你不需要 3D 渲染就能做到这一点,”Dai 说。 视觉推理的应用 Elorian 的其他商业机会包括机器人、工程和国防应用。Dai 补充说,建筑师需要定期检查建筑规范和合规性——这是视觉推理模型的理想任务。 在两个机器人基准测试 WGO Bench 和 ERQA 中,Elorian 声称其评分等于或高于前沿模型,而且价格便宜得多: 来源:Elorian 回到将数诱饵作为衡量视觉模型成功与否的一项指标,Dai 认为,对模型所见内容进行推理,对于其在现实应用中的准确性和有效性至关重要。 他举了一个仓库机器人清点箱中物品的例子。 “一个熟悉的 12 槽托盘可能只装 10 个零件,而 24 件装的标签并不意味着箱子里仍有 24 件物品,”Dai 说。“依赖自己预期所见内容的模型,在现实情境中会遇到很多问题,而 Glimps

    匹配字段正文

  2. Baseten 工程博客精选

    Baseten 发布决策模型 joey-1,P50 延迟 20ms、每百万 token 0.01 美元

    Baseten 旗下 Base Labs 发布 2B 决策模型 joey-1,直接输出单个 token 的标签和校准置信度,P50 端到端延迟 20ms,约为 elephant-1(49ms)的 2.5 倍速度,价格为每百万 token 0.01 美元,是 mammoth-1 的十分之一。joey-1 由 Qwen3.5-2B 后训练而来,与 elephant-1、mammoth-1 共用同一数据配方和 API,切换只需改一行。该模型已在 Baseten Model APIs 上线,默认零数据保留,权重在 Hugging Face 开源;Model APIs 支持 16k 上下文窗口,专用部署可解锁 262k 上下文窗口并支持微调权重。

    joey-1

    现已在 Baseten Model APIs 上线,开放权重发布于 Hugging Face. 这个 LLM 工作负载应该改用决策模型吗? 决策模型在一次前向传播中返回一个标签(一个决策)以及该标签的置信度分数。具体到 joey-1,当满足以下条件时,值得将 LLM 工作负载迁移过来: 决策量很大,因此每次调用的成本决定了项目是否经济。 你需要做出的决策是其他事项的前置条件,这意味着其延迟会被加到每一次响应中。 作为参考,每月对 1000 万张支持工单进行分类,每张约 500 个 token,即 50 亿个 token,在 joey-1 上每月约 50 美元,而在 mammoth-1 上为 500 美元。joey-1 是一个可靠的一线模型,可让工作负载保持快速且成本高效,而当 joey-1 不确定时,你仍可使用 elephant-1 或 mammoth-1 等更重的模型作为升级路径。 Base Labs 决策模型系列 这三款模型均由 Base Labs 在相同的数据混合上训练,并共享相同的 API,因此在它们之间切换只需改一行代码。这使得该系列成为一个单一工具包,而非三个独立的选择:

    匹配字段正文

  3. 新浪科技

    SpaceX 第三季度 34.5% 营收来自 Anthropic 算力合同

    据知情人士透露,Anthropic 是 SpaceX 单一最大客户,第三季度为其贡献超过三分之一营收,SpaceX 文件显示该客户占营收约 34.5%,文件仅标注为“客户 B”。这笔收入来自 Anthropic 使用 SpaceX 位于田纳西州孟菲斯数据中心的算力,合同总额最高可达 1205 亿美元、有效期至 2029 年,但从今年 12 月起 Anthropic 每月支付约 31 亿美元,并可在 2027 年 1 月、2027 年 3 月之后提前 90 天通知终止合同。

    相关合同总额最高可达 1205 亿美元,合同有效期至 2029 年。 文件显示,从今年 12 月起,Anthropic 每月支付金额约 31 亿美元。不过 Anthropic 可分别在 2027 年 1 月、2027 年 3 月之后,提前 90 天通知 SpaceX,终止这份算力合同。 文件还提到,Anthropic 同时也和 Nscale、Lambda 等其他算力云服务商存在合作。 SpaceX 营收高度依赖 AI 算力合同,体现出自从这家火箭企业收购马斯克旗下 AI 公司 xAI 之后,不到一年时间里自身发生的巨大转变。在 SpaceX 发展史上很长一段时间,和美国国家航空航天局、国防部的合作是其最赚钱的业务。 SpaceX 提交文件显示,第三季度仅有两家客户贡献的收入占总营收比重超过 10%。另一家客户(可能是多家政府机构合计)占第三季度营收 16.6%,而在 2025 年,该部分大约占公司营收的五分之一。 马斯克还预测,美国国家航空航天局曾是 SpaceX 最重要合作伙伴之一,在 2026 年其收入占比将不足 5%。 (neocloud:新型算力云,专门搭建 AI 数据中心、对

    匹配字段正文

  4. 新浪科技

    马斯克再预言:超级智能带来超级富足,为未来存钱毫无意义

    马斯克在X上发文称,随着超级智能带来物质极大丰富的时代,为遥远的未来存钱毫无意义。他此前在播客中已建议不必为10年或20年后的退休储蓄,并预测AI、能源和机器人技术进步将带来充裕资源,让每个人都能获得想要的一切。他还提出由政府向全民发放补贴,以应对AI引发的就业岗位流失。

    一切”。 他接着说道,在那个世界里,每个人都能享受到“比当今任何人所能获得的都要好的医疗服务”;那里将“不存在商品和服务的短缺”;而且“你可以免费学习任何你想了解的知识”。 马斯克在最近的一期播客节目中描绘了一个更为乌托邦式的愿景。他预测,随着机器人技术和太空旅行的进步,人类将迈向“多行星经济”时代;届时,“金钱将变得毫无意义”,“传统货币也将不再重要”。 其他几位科技界领袖也曾预言,人工智能及其他技术将彻底改变我们的生活方式。 微软联合创始人比尔·盖茨在最近的一期播客中表示,人工智能将带来“真正的富足”,届时机器人将能够“建造房屋、种植粮食,甚至进行外科手术”。 但他同时也警告称,未来二十年将成为“人类历史上动荡程度数一数二的时期”;随着技术进步,在生产大多数商品与服务时,人类劳动所能提供的价值将变得不再必要。 同样,马斯克也预言,通往更美好未来的过渡期将会“充满波折”。他提出,由政府向全民发放补贴,是应对人工智能引发的就业岗位流失问题的最佳解决方案。 news keyword pub,usstock,MSFT&TSLA&TAL 开户二维码 start 开户二维码 end 正文下if

    匹配字段正文

  5. 华尔街见闻

    亚马逊Q3财报:AWS收入增39.3%,AI资本开支致自由现金流转负

    亚马逊2026年三季度净销售额同比增长12%至2019.4亿美元,略低于预期,AWS净销售额同比增长39.3%至459.8亿美元,创近五年最高单季增速。当季购置物业和设备支出达772.6亿美元,约为去年同期1.2倍,自由现金流由去年同期流入147.9亿美元转为流出423.6亿美元。公司维持约2200亿美元的2026年全年现金资本开支指引不变,财报公布后股价盘后跌幅一度超过10%。

    意味着,即便收入略低于预期,公司在履约、销售营销、管理费用等方面的效率改善,仍然支撑了创纪录的经营利润率。 净利润为206.9亿美元,低于去年同期的211.9亿美元;稀释后EPS为1.89美元,同比下降3%。这一同比下滑很大程度上与去年同期的非经营性高基数有关——2025年三季度亚马逊因Anthropic投资确认了95亿美元税前收益,而今年同期没有类似收益,其他收入/费用项目从去年同期的正101.9亿美元转为负7亿美元。 换言之,这份财报不是经营层面的利润失速,而是收入和每股收益略低于预期、叠加非经营性项目和资本开支压力,削弱了投资者对短期回报的信心。 AWS继续加速:AI需求支撑云业务,但市场也在追问投入回报 AWS是三季度最亮眼的业务线。该部门净销售额459.8亿美元,同比增长39%,高于分析师预期的约454亿美元,同比增速较二季度的约37%进一步加快,继续创2021年四季度以来最高增速;AWS经营利润177.7亿美元,同比增长55%,经营利润率为38.7%,高于去年同期的34.6%。 从收入结构看,三季度线上销售额685亿美元,贡献亚马逊三分之一的净销售额,AWS销售额占总额的2

    匹配字段正文