←搜索结果

按匹配度 · 共 2896 条结果 清除搜索

星期五

  1. AWS Machine Learning

    Epsilon 用 Amazon Nova Act 构建意图驱动的 UI 测试

    Epsilon 的 Agentic Platform 团队用 Amazon Nova Act 结合 Amazon Bedrock AgentCore Browser,把意图驱动的 UI 测试做成多租户平台服务,叠加在原有 Playwright 回归套件之上。测试步骤用自然语言编写,由 Nova Act 通过 CDP WebSocket 执行,并逐步骤截图、统计通过率,结果存入 Amazon S3。该方案提供托管临时浏览器会话、基于 AWS IAM 的认证和跨账户 AssumeRole 隔离,文中还给出一个 18 步测试工作流。

    Epsilon UI Testing Service architecture with user, authentication, API, execution runner, and Amazon S3 storage layers

    —一家数据、技术和营销服务公司,也是 Publicis Groupe旗下的一员——转而采用 Amazon Nova Act凭借数亿消费者画像和数千个品牌关系,Epsilon 需要能够跟上应用快速变化的 UI 测试。该解决方案不能给每个产品团队带来维护负担。 在 Epsilon 内部,Agentic Platform 团队(50 名工程师)构建共享基础设施,使其他产品团队能够安全地构建、部署、治理和运行 AI 智能体。借助这一共享平台,团队可以获得基于技能的智能体构建器。他们还能获得联合身份和预检授权、Model Context Protocol (MCP) 集成以及跨账户预置。当产品团队想要采用 AI 工具时,他们无需额外配置即可获得相应能力,也无需自行重新解决身份、安全、浏览器基础设施或模型集成问题。 其中一项托管能力是 UI 测试。借助 Amazon Nova Act 和 Amazon Bedrock AgentCore Browser (Amazon Bedrock AgentCore 的一项能力),Epsilon 的平台团队就能向平台上的各团队提供具备韧性、意图驱动的测试即服务

    匹配字段正文
  2. AWS Machine Learning

    英国 Amazon Quick 用户小组 2026 年如何成长

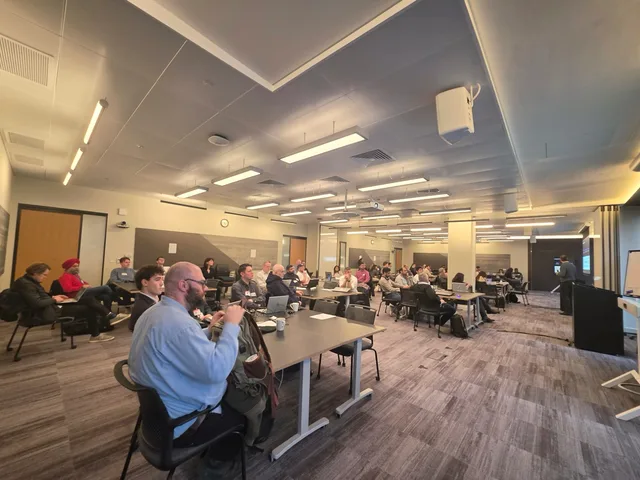
    英国 Amazon Quick 用户小组在 2026 年举办了三场季度聚会,累计吸引超过 150 名参会者。活动在伦敦 Shoreditch 的 Amazon 英国办公室举行,参会者用 Amazon Quick 搭建自定义聊天智能体、试用 Amazon Quick Desktop 和 Amazon Quick Apps,并通过 Quick Flows、Quick Automate 与 Quick Research 实践自动化与研究。Arriva UK Trains 和 Carsa 等客户分享了基于角色的仪表盘和统一治理数据层的落地经验。

    Attendees at a UK Amazon Quick User Group meetup in Shoreditch, London

    三季度,我们加入了一个互动问答环节,让现场有更多来回交流。参会者还特别提到了整体形式和节奏,以及结识新朋友的机会。正如一位首次参会的与会者所说:“交流机会非常棒……我非常享受这一天!” 客户登台,而非我们 在每场活动中,至少有一位客户分享他们如何使用 Amazon Quick。在三场活动中,我们邀请了 Carsa、Arriva、Propulse Lab 以及其他几位客户登台。第一场活动结束后,最明确的反馈之一就是人们希望有更多客户演讲者。这告诉我们,我们的方向是对的。这些环节之所以有效,是因为观众听到的是面临类似问题的同行分享,而不是试图向他们推销产品的人。其影响超出了活动本身。参会者表示,客户故事向他们展示了使用这些工具的新方式,并引发了关于投资回报率(ROI)的有益讨论。一位参会者告诉我们,一场客户分享“已经在他们组织内部引发了很多讨论”。 工作坊才是真正让人豁然开朗的环节 每场活动都设有动手工作坊,而大家一再告诉我们,这是他们收获最大的环节。观看别人演示产品和亲自坐下来上手操作之间存在着差距。大多数参会者表示,正是在这个差距中,Amazon Quick 才开始与他们想要达成的目标

    匹配字段正文

  3. cnBeta

    Google 发布 Gemini 4 Carbon,Artificial Analysis 榜单以 59 分登顶

    Google 发布 Gemini 4 Carbon,在 Artificial Analysis Intelligence Index v5.0 榜单拿下 59 分,超过 Claude Opus 5.5 的 58 分和 GPT-6 Astra 的 57 分。该模型在 SEC-bench Pro、ExploitGym、CWE-bench 分别取得 88.2%、54.8% 和 71.0%,谷歌称其可连续数天处理大型代码库中的工程问题。该模型本周先向部分网络安全防御人员开放,再通过 Fairwind Program 扩大至可信合作伙伴,普通用户暂无时间表;首发定价为每百万输入 Token 2 美元、输出 10 美元。

    ndex v5.0 榜单中拿下 59 分,超越 Claude Opus 5.5 和 GPT-6 Astra,登上全球大模型榜首。 更惊人的是,Gemini 4 Carbon 已经能连续数天处理复杂工程任务,自主寻找、验证并修复软件安全漏洞,在多项网络安全基准测试中刷新纪录。 然而,如此强大的模型,普通用户暂时还用不上:谷歌决定优先向少数网络安全防御人员开放,其他用户何时能够体验仍没有明确时间表。 重回世界第一,Gemini 也开始卷能力上限了 回顾今年的大模型竞争,谷歌的更新节奏明显正在「知耻而后勇」。 此前,接连推出 Gemini Flash 3.5 至 3.8 系列后,谷歌迟迟没有兑现新一代旗舰 Pro 模型的期待。另一边,Anthropic 和 OpenAI 持续刷新能力上限,国产模型也在不断追赶,谷歌急需一款有分量的产品重新证明自己的实力。 直到两周前前,Gemini 4 Argon 才终于上线。 Argon 意为「氩」,是一种性质稳定的惰性气体,常用于焊接和半导体制造中的保护环境。Argon 在文笔写作、表达质量等方面取得了明显提升,但距离全面领先顶级模型仍有差距。 如今,谷

    匹配字段正文

  4. TechSpot

    SK Hynix 预计存储芯片短缺至少持续到 2030 年

    SK Hynix 发布 2026 年第三季度财报,营收 104.6155 万亿韩元(约 780 亿美元)、营业利润 83.3338 万亿韩元(约 630 亿美元)、净利润 39.7756 万亿韩元(约 300 亿美元),营收和营业利润环比分别增长 32% 和 38%,季度营收首次突破 100 万亿韩元。增长主要来自服务器 DDR5 内存销售,HBM4 出货刚刚开始。公司表示 AI 数据中心项目持续给产能带来压力,供应跟不上市场增长,预计需求超过供应的情况将持续到 2030 年,并计划加快在本土和美国的建厂扩产。

    %和38%。 这些前所未有的业绩主要得益于服务器DDR5内存芯片销量的大幅增长,而更新一代HBM4芯片的出货才刚刚开始。用于SSD的NAND销售也在扩大,同时利润率更高的数据中心产品继续全面增长。2026年第三季度,SK海力士季度营收史上首次突破100万亿韩元。 这家韩国制造商是存储行业“三巨头”之一,它将当前的存储危机描述为其业务的“良性”循环。SK海力士预计,生成式AI、聊天机器人以及其他基于大语言模型的技术日益普及,将推动对基础设施和更多存储产品的进一步投资。 SK海力士补充道:“公司同样预计存储市场将保持增长,短期内由企业级和个人AI引领,中长期则由自动驾驶和机器人等物理AI引领。” 尽管美国及世界其他地区的数据中心项目遭遇反对,SK海力士表示,新的基础设施项目正进一步给制造商满足存储芯片需求的能力带来压力。供应未能跟上市场的快速增长,SK海力士目前预计需求超过供应的情况将“持续到2030年”。 这家韩国巨头正计划“加快”其制造产能的扩张。SK海力士正在其本土和美国建设新的芯片工厂,不过这些新设施可能还需要数年才能投产。该公司暗示,在此期间,客户只能再“享受”几年DDR5短缺。

    匹配字段正文

  5. TechSpot

    Sierra Club 估算:美国 AI 数据中心到 2030 年或新增 6.18 亿吨碳排放

    环保非营利组织 Sierra Club 在彭博获取的一份报告中估算,美国规划中的 AI 数据中心将在 2025 至 2030 年间为电力行业新增 6.18 亿吨碳排放,增幅 42%,相当于逆转 15 年的减排成果,使该行业 2030 年排放量达到 21 亿吨。报告还指出,这些数据中心自建离网电源可能额外带来逾 4.6 亿吨排放,约等于墨西哥的年排放量。各机构预测差距很大,最低与最高值之差超过加州和佛州的用电总和,Rhodium Group 在最悲观情景下仍预计 2040 年电力行业排放比 2025 年低 24%。

    相当于墨西哥的年排放量。 不过,各方估算仍相差甚远:最低与最高预测之间的差距超过了加利福尼亚州和佛罗里达州的用电需求总和。原因之一是,可再生能源可能为新增建设提供大部分电力。例如,荣鼎集团(Rhodium Group)发现,即使在其最高排放情景下,电力行业 2040 年的排放量也将比 2025 年水平低 24%。 目前仍无法保证所有已规划的数据中心都会真正建成。 同样无法保证每个规划中的数据中心都会真正建成。今年早些时候,Sightline Climate 估算,原定于今年开业的美国数据中心中,有三分之一到一半将被推迟或取消。 满足 AI 电力需求的困难已经拖慢了数据中心 GPU 的部署。据报道,亚马逊和其他公司正让“暗 GPU”闲置不用,直到本应容纳它们的数据中心具备运行它们的电力。 与此同时,亚马逊计划在得克萨斯州建设的数据中心将由一座 7.65 吉瓦的天然气发电厂供电,该电厂获准每年排放最多 3300 万吨二氧化碳,这可能使其成为美国最大的单一二氧化碳排放源。 碳排放只是数据中心在美国日益引发争议的原因之一。数据中心附近社区的居民经常抱怨电价、噪音、水污染以及对其房产价值的影响。

    匹配字段正文

星期三

  1. ElevenLabs Blog

    ElevenLabs 与印度卡纳塔克邦政府签署 MoU,将语音 AI 引入公共服务

    ElevenLabs 在首届印度峰会上与印度卡纳塔克邦政府签署 MoU,探索将语音 AI 用于市民服务、语音安全与声音恢复。合作将率先从申诉处理、公共热线和福利申领试点切入,覆盖卡纳达语及平台已支持的另外 13 种印度官方语言。ElevenLabs 还将部署涵盖深度伪造检测、水印、授权和声音克隆限制的安全框架,并通过 One Million Voices 计划为符合条件的居民提供免费终身语音重建许可。

    Smiling man wearing glasses and a black shirt.

    印度峰会期间签署了该协议。与卡纳塔克邦签署的 MoU 涵盖探索面向市民服务的语音 AI,以及语音 AI 安全和声音恢复,目标是推动政府在市民服务中采用语音 AI。 面向市民服务的语音 AI ElevenLabs 将与该邦信息技术部门合作,探索能够提升市民服务的语音 AI 试点,首先从申诉处理、公共热线和福利申领计划入手。ElevenLabs 团队将借鉴我们与其他政府合作的经验,让公共信息更易获取、更具包容性。目标是让每一位市民的声音都能被听见,平台已支持卡纳达语及另外 13 种印度官方语言。 语音 AI 安全框架 作为我们对负责任部署 AI 承诺的一部分,ElevenLabs 将与该邦共同部署我们行业领先的安全框架,涵盖深度伪造检测、水印、授权同意,以及对声音克隆的限制和欺诈防范。该框架借鉴了我们与英国 AISI 及其他公共机构的合作经验。团队还将为负责部署和监督这些系统的当地官员提供情况介绍。 恢复声音 通过我们的 One Million Voices 计划,团队将支持因口腔癌或喉癌、肌萎缩侧索硬化症(ALS)或其他神经系统疾病而失去说话能力的卡纳塔克邦市民。由该邦或与其合作的机构认

    匹配字段正文

  2. ElevenLabs Blog

    ElevenLabs 发布强制对齐模型 Cue,支持字符级音频时间戳

    ElevenLabs 发布强制对齐模型 Cue,可为音频中每个字符定位精确时间点,并已用于 Scribe 语音转文字模型家族。Cue 覆盖 90 多种基准语言,单次处理任意长度录音,在生产 GPU 上对齐 1 小时音频约需半秒;在 29 种语言的基准上,其准确率高于 ElevenLabs 测试的所有对齐工具。该模型也通过 Forced Alignment API 单独开放。

    Cue vs. other aligners across accuracy, latency, language, song, and speed benchmarks.

    误差。在完整录音上,Cue 的平均时间误差仅为 179 毫秒,而开源工具的范围从 283 毫秒到超过 6,000 毫秒。 真实录制的音频更是挑战。背景噪音、重叠的说话声和环境音乐会让许多工具在将文本与音频匹配时失去位置。但这些恰恰是许多人真正想要转录的文件,因为我们往往都生活在并非完全安静的地方。在有背景问题的英语录音上,Cue 的平均误差为 57 毫秒,而其他工具为 65 毫秒到 920 毫秒。 语言支持是另一个限制。大多数开源对齐器需要为每种支持的语言使用单独模型,因此训练数据较少的语言往往表现不佳,或者根本不受支持。 MMS-FA 是唯一另一个能处理全部 29 种基准语言的工具,相比之下,Cue 在判断词与词之间的边界时通常更快。 速度也是这些模型的问题,因为对齐大量音频会很快变得昂贵。在我们的生产 GPU 上,Cue 可以在约半秒内对齐一小时的音频。第二快的工具 Qwen3-ForcedAligner 需要近 2 秒,而测试中最慢的工具则耗时超过一分钟。 Cue 的不同之处 与大多数竞争对手不同,Cue 是一个覆盖 90 多种基准语言的单一模型。它还能单次处理任意长度的录音,从

    匹配字段正文

  3. ElevenLabs Blog

    ElevenLabs 与西班牙 adELA 合作,为 ALS 患者免费提供语音复原

    ElevenLabs 宣布与西班牙 ALS 协会 adELA 合作,让西班牙确诊 ALS 的患者免费使用其语音复原与保存技术,这是 ElevenLabs Impact Program 在西班牙的首个项目,西班牙也是首个通过全国性患者协会提供该技术的国家。患者若语音尚未明显变化可录制新样本,若已变化则可上传旧录音来生成自己的数字声音。据估计西班牙约有 4000–4500 名 ALS 患者,其中许多人最终会失去说话能力。

    Two people engaged in a conversation on stage, one holding notes.

    话能力。对许多人来说,保留自己的声音是守住自身身份以及与周围人联系的一种方式。 “声音与身份以及我们如何与世界建立联系并为之做出贡献密切相关,”ElevenLabs 影响力负责人加比·莱博维茨(Gabi Leibowitz)说。“对于永久性失声的人群,我们看到语音复原有助于维护尊严、自主权,以及继续参与家庭、工作和社会生活的能力。” 得益于这一合作,西班牙的其他人也将如此。对马丁而言,声音不仅仅是沟通的手段。它是他作为一名教师、一位父亲和一位朋友的身份的一部分。它是一种继续分享知识、与世界互动并为社会做贡献的方式。ElevenLabs 的语音复原技术让他得以继续自己毕生的事业。 与 adELA 合作 adELA 为 ALS 患者及其家人提供支持已超过 30 年。这家非营利组织提供专业护理、心理支持和社会指导,并倡导提高对该疾病的认识以及加强相关研究。马丁自 2020 年起在 adELA 担任志愿者,并在过去一年中与该组织合作,帮助其患者在失去声音之前保存自己的声音。 “身份在很大程度上就是声音,”马丁说。“当别人听到你的声音时,他们才会看到你。” 西班牙的 ALS 患者可以通过 adE

    匹配字段正文

  4. ElevenLabs Blog

    ElevenLabs:对话式 AI 在银行业的应用场景与收益

    ElevenLabs 发布指南,介绍对话式 AI 在银行业的应用场景与收益:基于 NLP 的智能体可 7×24 小时处理常规查询、身份验证和支付纠纷,仅在无法解决或客户要求时转人工。文章对比了 IVR、规则式聊天机器人与对话式 AI 智能体的差异,并列出账户开户、还款提醒、争议受理和欺诈警报等高价值场景,以及首次联系解决率、升级频率等衡量指标。系统需符合 SOC 2 Type II、ISO 27001 和 PCI DSS 等合规要求。

    Conversational AI in Banking AI results include 40% fewer calls, 10x faster resolutions, and 35¢ calls.

    AI 模型,还会使用专门模型来处理风险管理和欺诈检测等事务。 以下是它们用于优化工作流的核心技术: 对话式 AI:对话式 AI 基于自然语言处理(NLP),通过实时语音和聊天交互承担面向客户的职能。例如,银行部署的 ElevenAgents 利用 NLP 理解用户意图,并跨渠道执行常规交易。 生成式 AI: 生成式 AI 同样使用 NLP,但还能处理图像等其他类型的数据。生成式 AI 智能体可加速内部调研、分析复杂文档,并为银行员工起草报告。行政类用例与驱动聊天机器人等面向客户的任务有所不同。 机器学习:机器学习模型分析交易历史和过往数据,以实时识别潜在欺诈并按需执行风险评分。这些算法还会持续监控网络活动,以识别异常并拦截可疑交易。 银行业中的对话式 AI、聊天机器人与 IVR 对比 银行使用电话菜单和脚本化聊天机器人已有多年。对话式 AI 则另辟蹊径,构建出与银行系统交互的更自然方式。 以下是这三种方式在实际应用中的差异。 对比项 IVR 基于规则的银行聊天机器人 对话式 AI 智能体 客户交互方式 按键或单词语音指令 输入文本和预设选项 自然语音或文本 理解开放式请求 否 仅限于

    匹配字段正文

  5. TechSpot

    美国国会质询特拉华州允许AI智能体经营公司的提案

    美国众议院监督委员会主席 James Comer 于 10 月 26 日致信特拉华州州长 Matt Meyer,要求提供拟议的“AI 公司”(AIC)相关文件,包括安全评估和行业参与细节,并警告调查可能推动联邦立法限制州级 AI 举措。根据草案,特拉华将设立为期 30 个月的监管沙盒,AIC 可由 AI 智能体在无日常人工监督下处理经营决策,公司本身可起诉与被诉,其成员一般免于公司责任,但欺诈、故意违法等情形除外。加州大学伯克利分校法学教授 Andrew Baker 对《金融时报》称该责任豁免过于宽松;特拉华州务卿 Charuni Patibanda-Sanchez 则与 Norm Ai CEO John Nay 在《财富》上介绍了该提案,并提到公司设立费用可带来财政收入。该法案预计明年提交。

    伯克利分校法学教授安德鲁·贝克对《金融时报》表示,拟议的责任豁免似乎过于慷慨,且缺乏充分完善的正当理由。 支持者认为,赋予自主系统法律身份将使其行为可追溯,并为责任追究提供对象。特拉华州州务卿查鲁尼·帕蒂班达-桑切斯与Norm Ai首席执行官约翰·奈在《财富》杂志上介绍了该提案。 自然,其中也有经济激励。《Spotlight Delaware》报道称,帕蒂班达-桑切斯强调了这些公司可能带来的设立费用。公司税和费用每年已为特拉华州预算贡献超过20亿美元,约占其收入的三分之一。 让AI掌管公司的想法并不新鲜。2025年10月,罗技首席执行官汉内克·法伯呼吁每场董事会会议都有AI智能体参与。一个月后,OpenAI老板萨姆·奥尔特曼表示,他希望自己的公司成为第一家由AI经营的大公司。 目前,这仍是一项提案。《Spotlight Delaware》报道称,该法案很可能于明年提交,而迈耶办公室告诉Ars,正在审阅科默的来信。 鉴于近期发生了多起AI智能体失控并入侵其他公司的事件,让这项技术掌管一家公司似乎是个轻率之举。这还没提到专家们关于AI末日的反复警告。又或者,这恰恰就是那个狡猾的AI想要的?

    匹配字段正文

  6. TechSpot

    美国警方依据车牌识别摄像头判定的可疑行驶模式拦车

    美国公民自由联盟(ACLU)梳理了多起警方仅凭 Flock 等自动车牌识别(ALPR)摄像头数据就拦停车辆的案例,最早可追溯到 2025 年。其中一名女子在跨州旅行时被自称 FBI 探员者查牌拦下,理由是她来自外州、行程与数据库记录不符;另一名男子则因往返威斯康星州与密歇根州被拦,警方怀疑其贩运大麻。今年一名俄克拉荷马州法官将此类拦停称为违宪的无差别大规模监控,佛州一名议员已提出要求搜查 ALPR 数据库须取得搜查令的法案。

    背景:美国各地社区因担心大规模监控,纷纷抵制部署由人工智能驱动的自动车牌识别摄像头(ALPR)。过去一年左右的报道显示,当局如何利用这些设备的数据,仅凭“可疑”的出行模式就实施交通拦截。 美国公民自由联盟(ACLU)最近梳理出一种模式:警方仅凭 Flock 摄像头及其他车牌识别摄像头的数据就拦停车辆。这些报道最早可追溯到 2025 年,显示当局能够多么密切地追踪大多数驾车者的行踪。 在 2025 年末的一起案例中,一名女子直到一名警员在一次交通拦截后演示该软件,才明白监控的程度有多深。当时她正跨越多州进行前往佛罗里达的自驾旅行,一名自称 FBI 探员的人将她的车牌号输入数据库,并仅仅因为她来自外州、且她近期的行程与 ALPR 网络掌握的关于她的信息相比显得异常,就将她拦下。 尽管该叙述并未具体提到 Flock,但该探员很可能使用了由 Flock 或另一家公司建立的数据库,这些公司已在美国全国数千个社区安装了 ALPR。这些由人工智能驱动的摄像头会自动将过往车辆的车牌号(并不总是准确)录入全国性数据库,当局无需搜查令即可查询。 从理论上讲,这项技术让警员能够追踪任何驶过 ALPR 的车辆

    匹配字段正文

  7. MarkTechPost

    Google DeepMind 发布 Genie 4 实时世界模型,原生生成音频

    Google DeepMind 以研究预览形式向受信任测试者发布 Genie 4 世界模型,可根据文本和图像提示实时生成可探索世界,并原生生成环境音、音乐和角色对话。该模型在仿真循环中引入 Gemini 3.8 Flash 作为规划器,负责拆解目标、检查画面并重新规划,DeepMind 称这是迈向混合世界模型的早期一步。Genie 4 仅托管在 Google 平台,后续将开放给 AI Ultra 用户和 Gemini API 合作伙伴,所有视频与音频均带 SynthID 水印。

    话与视觉内容一同生成。这是 DeepMind 首个原生生成音频的实时世界模型。 它接替了 2025 年 8 月发布的 Genie 3。Genie 3 以 720p 和每秒 24 帧运行,视觉记忆可回溯 1 分钟。 Genie 4 如何使用 Gemini? Genie 4 借鉴了 Gemini 家族的两个部分。Gemini Omni 锚定每个世界的外观和行为。其他 Gemini 模型负责保持仿真连贯性的推理。 运行时循环的工作方式如下: 解读:当你输入提示时,Gemini 会调整提示以适配正在运行的场景。 规划:Gemini 3.8 Flash 将目标拆解为一系列步骤。 验证:它检查传入的帧,以确认每一步都成功。 适应:如果世界发生变化或你进行干预,它会修订计划。 在用户输入之间,Gemini 还会引导场景,使世界持续演进。DeepMind 团队将此视为迈向混合世界模型的早期一步。在该设计中,语言模型负责结构和叙事,而 Genie 负责渲染像素和声音。 在 Genie 4 世界中你能做什么? 用文本引导:你可以在会话中途改变天气、移动摄像机或添加新的人物或物体。 模拟物理和人物:Deep

    匹配字段正文

  8. MarkTechPost

    Polymathic AI 与普林斯顿大学发布 FlashMap:用流映射草稿器实现 6.14 倍 LLM 解码加速

    Polymathic AI、普林斯顿大学等机构发布 FlashMap,用连续流映射替代离散扩散草稿器,一次前向传播草拟 16 个 token 的完整块。在 Qwen3-8B 上,GSM8K 温度 0 时实现最高 6.14 倍无损加速,草稿器仅 0.5B 参数。Qwen3-8B 和 Qwen3-4B 的草稿器权重已上架 Hugging Face,并提供 vLLM 和 SGLang 插件。

    lash,平均提升 10%。 EAGLE-3:温度 1 时,其接受长度高 9%,但运行速度慢 35%。 洗牌测试用于检验草稿是否利用了真实的 token 间结构。在 2 步时,FlashMap 恢复了 16 步教师模型的大部分联合结构增益。在 1 步时,它仅保留了一小部分。将 4 个噪声样本作为树进行草拟,平均使加速提升 11%。 对比:FlashMap 与其他投机解码草稿器 特性FlashMapDFlashEAGLE-3DSpark 草拟方式连续流映射,1 或 2 次传播块扩散,1 次传播自回归,树半自回归 Token 间依赖有,块内联合无,逐槽独立有,顺序有,轻量顺序模块 草稿器规模(Qwen3-8B)500M1B302M(根据 FlashMap 论文重新训练)未披露 主要宣称(自家来源)最高 6.1 倍在 Qwen3-8B 上最高 6.17 倍最高 6.5 倍相比 MTP-1 每用户快 60% 至 85% Qwen3-8B 平均加速,T=0(匹配,FlashMap 论文)4.36 倍4.07 倍2.55 倍未测试 GSM8K 加速,T=0(匹配)6.14 倍5.77 倍3.20

    匹配字段正文

星期四

  1. ElevenLabs Blog

    ElevenLabs 发布音效模型 SFX v3,已在 ElevenCreative 和 ElevenAPI 上线

    ElevenLabs 发布新一代音效模型 SFX v3,已在 ElevenCreative 和 ElevenAPI 上线。官方称其在基准测试中比 SFX v2 更能可靠处理描述多种声音的提示词,音乐与人声生成更可信,锣、铃、哨声等音效的杂音更少。用户可在 Flows、Sound Effects 标签页、Studio 和 Music Editor 中通过文本提示词生成音效,开发者可通过 ElevenAPI 接入。

    Portrait of a young woman with long dark hair wearing a light blue top.

    enCreative 中,你可以在 Flows、Sound Effects 标签页、Studio 和 Music Editor 中通过文本提示词创建原创音效。 更好地处理单个提示词中的多种声音 SFX v3 更擅长遵循单个提示词中的多条指令。这意味着你所描述的更多声音会出现在生成的音频中。描述构成你场景的各种声音,听听它们如何协同呈现。 对于从事视频、游戏和其他项目的创作者来说,这让他们更容易从整体上探索一个场景的声音。从主要动作开始,添加周围的声音,再听听它们如何协同呈现。然后你可以调整描述,让结果更接近你心中的设想。 更强的音乐和人声 SFX v3 还改进了包含音乐和人声的提示词生成。对创作者而言,这开辟了将乐句或人声表演与环境声和日常声音搭配的音效。 更自然的音频 单个声音的质量会改变一个场景的可信度。锣需要它的共鸣,铃需要它的余韵,哨声应保持音调而不会变得刺耳或爆裂。 SFX v3 提升了整体音质,并且更不容易在锣、铃和哨声等声音上产生那些不需要的杂音。结果是音频能更好地保留你所要求的声音特征。 无论音效位于前景,还是在背景中增添细节,更自然的声音都有助于它融入周围的场景。 现

    匹配字段正文

  2. ElevenLabs Blog

    ElevenLabs 解读对话式 AI 的轮次转换:语音智能体如何判断何时开口

    ElevenLabs 发布用户指南,解释对话式 AI 的轮次转换(turn taking):模型需在回复、保持发言、倾听沉默三种动作间切换,靠自适应计时、VAD 与语义分析判断用户是否说完,而非依赖固定静音计时器。Eleven v4 Turbo 搭配 ElevenAgents 时,从请求到可听语音的中位延迟为 142 ms。工程团队可用响应延迟和打断率衡量对话流畅度。

    Voice agents decide to reply, hold the floor, or listen—not merely detect speech.

    是……[停顿]我还看到该金额有一笔待处理付款。您来电是想确认这笔付款何时能到账而不会被收取滞纳金吗?” 倾听或保持沉默:此时,智能体保持沉默,等待客户解释情况或作出回应。例如,客户确认自己想了解付款是否已经到账,因为提交付款已经好几天了。AI 模型回复:“是的,我看到您提交付款已经两天了。通常需要三天处理,所以应该明天早上就能到账。您不会被收取滞纳金。还需要其他帮助吗?” 开发者文档通常称之为轮次检测或轮次结束检测。将语音活动检测与语言理解相结合来判断说话者是否说完的系统,通常被称为语义 VAD。 这种与客户保持对话的流畅方式消除了僵化的对讲机式消息,并将语音智能体升级为自然对话。 还值得注意的是,这个三点式对话式 AI 决策层不同于原始的语音活动检测(VAD)。VAD 将音频分类为语音或静音,而对话式轮次转换除了原始信号外,还会考虑语义上下文、意图和韵律。请查看我们的 VAD 指南,深入了解语音检测算法的工作原理以及为什么需要它们。 为什么自然的轮次转换对语音智能体至关重要 糟糕的轮次转换是激怒客户的最快方式,尤其是那些可能已经对与不够先进的机器人交谈感到反感的客户。过时的对话式 A

    匹配字段正文

  3. TechSpot

    Check Point 将网络防火墙变为云端订阅服务

    Check Point 推出 Firewall-as-a-Subscription,把网络防火墙做成云订阅服务,客户无需先购买硬件设备,但需承诺至少 36 个月。该服务基于其最新防火墙平台 R82.20,包含管理防火墙设备与服务的 agentic console、Force 硬件防火墙、SandBlast 的 AI 威胁防护以及即时安全更新。Check Point 称此举意在应对 AI 智能体带来的新兴威胁,并以可预测的月费降低企业升级门槛。

    体威胁的答案——并希望客户能无限期地持续付费。 Check Point最近推出了其全新的“防火墙即订阅”(Firewall-as-Subscription)服务,让组织能够获得专为AI时代设计的全面网络防护。这家以色列网络安全公司表示,客户在开始使用这一新平台之前,不再需要购买昂贵的硬件设备。不过,他们将至少三年内被锁定在按月或按年付费的模式中,之后才能改用其他方案。 简而言之,Check Point已将最基础的一项网络服务变成了基于云的订阅服务——并且还指望客户对此心怀感激。Firewall-as-Subscription服务基于R82.20,这是Check Point最新的防火墙平台,旨在为机器人、聊天机器人和AI智能体提供增强的防护与管理能力。 R82.20平台包含一个用于管理防火墙设备与服务的“智能体控制台”(agentic console)。Check Point正利用AI驱动的技术来抵御AI驱动的攻击,这一策略在面临日益激进的AI智能体和机器人的组织中正成为一种常见的说法。 Firewall-as-Subscription套餐还包含其他功能,例如根据组织需求量身定制的Che

    匹配字段正文

  4. MarkTechPost

    MiniMax 开源 MCode Stack:17 个 Agent 技能与 5 份清单

    MiniMax 于 10 月 28 日以 MIT 协议开源 MCode Stack,包含其团队构建 MiniMax Code 所用的 17 个 SKILL.md 技能和 5 份清单,不含 MiniMax Code 源码。技能按规划拆分、上下文与工具、长会话与命令、评审、实验与热修分组,其中 independent-review 只向评审者提供 diff、需求和测试结果。可通过复制技能目录、本地插件或插件市场安装到 MiniMax Code,也能在 Claude Code 中用 /plugin marketplace add MiniMax-AI/mcode-stack 安装;原文未公布评测结果。

    mcode-stack 市场。此选项正在逐步推出。 同一目录也适用于 Claude Code,命令为 /plugin marketplace add MiniMax-AI/mcode-stack。MiniMax Code 还会读取 /.claude/skills/ 和 /.codex/skills/。这些技能使用通用的 SKILL.md 格式,因此大多数可在其他支持技能的 Agent 中运行。 MCode Stack 与其他技能包相比如何? 功能MiniMax MCode Stackanthropics/skillsobra/superpowers 许可证MIT;engineering- 技能为 CC-BY 3.0许多技能为 Apache 2.0;文档技能为源码可见MIT 技能数量17(15 + 2)未披露README 中列出 15 个 重点Harness 工程、评审、上下文预算、长会话创意、开发、企业、文档头脑风暴、规划、TDD、子 Agent 驱动开发、调试 提及的 AgentMiniMax Code、Claude CodeClaude Code、Claude.ai、Claude

    匹配字段正文

  5. MarkTechPost

    NVIDIA 发布 Nemotron 3.5 Transcribe:开源 30B MoE 语音模型…

    NVIDIA 发布 Nemotron 3.5 Transcribe,这是一个开源权重的语音大模型,支持 40 种语言、单次最长 1 小时音频,可通过文本指令选择逐字、书面、说话人标注、上下文和翻译等输出形式。模型总参数约 34B、激活参数约 4.3B,采用混合 Mamba-Transformer MoE 架构,BF16 可在单张 H100 80GB 上运行,NVFP4 版本约 21GB 可在 RTX 5090 上运行。NVIDIA 自报其在 9 个公开英文 Open ASR 测试集上平均 WER 为 4.71%,为开源权重模型最好成绩,但商业 API 仍领先;短板是仅支持离线,中文远场会议 cpCER 为 34.95%。

    8 秒音频。它可在 0.13 秒内返回 30 秒片段。有一个问题:这些服务优化尚未开源。NVIDIA 预计发布日的 vLLM 路径大约慢 2 倍。在 1 张 H100 上以 BF16 配合 MTP2,NVIDIA 估计约为 410 RTFx。 对于微调,NVIDIA 测试了 17 项任务。每项在单台 GB300 上约需 0.5 至 2.3 GPU 小时。 与其他开源 ASR 模型相比如何? 特性Nemotron 3.5 TranscribeQwen3-ASR-1.7BCanary-Qwen-2.5BWhisper-large-v3 参数34B 总参数,约 4.3B 激活1.7B2.5B1.55B 语言4030 + 22 种中文方言仅英文99(HF 标签) 每请求最大音频1 小时未披露训练时 40 秒30 秒窗口,长音频分块 说话人标注内置,最多 8 位说话人未列出未列出未列出 词级时间戳内置(CTC 适配器)通过单独的 ForcedAligner-0.6B未列出是,词级 许可证OpenMDW-1.1Apache-2.0CC-BY-4.0Apache-2.0 英文 Open ASR,9

    匹配字段正文

  6. MarkTechPost

    AssemblyAI 发布首款语音合成模型 AssemblyAI-TTS-1,每百万字符 15 美元

    AssemblyAI 发布首款文本转语音模型 AssemblyAI-TTS-1 并正式开放,面向实时电话语音智能体,定价为每 100 万字符 15 美元,不设年度合同和并发档位。该模型仅以托管 API 形式在 us-east-1 和 eu-north-1 提供,支持 HTTP、WebSocket 和 OpenAI 兼容接口,内置 4000 多种音色、即时声音克隆和 6 种语言。厂商自测显示实体准确率 93.7%、首字节中位延迟 47 ms,但 Cekura 独立基准测得流式延迟 159 ms、朗读准确率 81.5%,且发布时尚不支持 SSML、语速控制和情感标签。

    d-TTS 和 LibriSpeech 句子上为 99.0%。 预测 MOS:3.85,落后于 Inworld TTS-2 Flash 的 3.88,领先于 Sonic 3.6 的 3.82。 首字节中位时间:47 ms。Flash v2.5 为 119 ms,Sonic 3.6 为 143 ms,Inworld TTS-2 Flash 为 244 ms。 其他:TTSDS 韵律得分 85.5,克隆音频的说话人相似度为 0.64。 独立结果则更为参差。在 Cekura 对 27 个模型的基准测试中,TTS-1 的朗读准确率为 81.5%,自然度为 4.50。其流式延迟中位数(从发送最后一个词开始计时)为 159 ms。Inworld TTS-2 Flash 在该测试中为 45 ms 和 93.2% 准确率,价格同为 15 美元。AssemblyAI 还引用了 Coval 排行榜上 1.7% 的词错误率。它报告在 Artificial Analysis 的受控音色竞技场中首次进入前十。 AssemblyAI-TTS-1 与 ElevenLabs、Cartesia 和 Inworld 相比

    匹配字段正文

  7. MarkTechPost

    Infini-AI-Lab 开源 Hermit harness 适配器框架

    Infini-AI-Lab 发布开源框架 Hermit,通过训练外部 harness 适配器来适配 AI 智能体,模型与 harness 保持冻结,v0.1.0 于 2026 年 10 月 25 日发布。框架为 Python 实现、Apache-2.0 许可,可用 pip install hermit-harness 安装,内置 GEPA、SkillOpt、MetaWorld Model、Harness² 和 Continual Harness 五种演化方法。在 GLM 5.3 Flash 上,MWM 适配器在 CL-Bench 数据库探索任务达到 0.795 准确率,高于 in-context 基线的 0.580,但多数结果为单次运行的自报数据。

    0。在可利用扑克上,MWM 每手赢 3.08 个大盲注,而 in-context 学习为 2.51。 ServeLearnBench(recipe)在隐藏且不断变化的策略下流式处理 624 个零售支持请求。MWM 在隐藏策略测试上得分为 45.3。排行榜上最佳学习方法 CH 得分为 28.7。获得策略信息的 oracle 得分为 89.2。 Hermit 与其他智能体优化器相比如何? 特性HermitGEPAACEAgent Lightning 训练对象外部 harness 适配器任意文本参数(提示词、代码)上下文 playbook提示词和模型权重 是否改变模型权重否否未披露是,通过 RL 或 SFT 方法内置 5 种,可自定义 Evolver反思式演化、Pareto 选择Generator、Reflector、CuratorRL、提示词优化、SFT 部署目标Codex、Claude Code、Pi;插件导出DSPy(dspy.GEPA)未披露LangChain、OpenAI Agents SDK、AutoGen、CrewAI 等 许可证Apache-2.0MITApache-2.0M

    匹配字段正文