←搜索结果

按匹配度 · 共 179 条结果 清除搜索

星期五

  1. Figma AI / Agent / Make

    Figma 如何训练设计编辑模型:从 SFT 到 RL

    Figma 工程副总裁 Josh Clemm 介绍了其设计编辑模型的训练方法,从监督微调(SFT)转向强化学习(RL),并基于 Qwen 3.8 27B 后训练出尚未发布的编辑模型。早期用 Llama 3.3 70B 在超过 25 万个样本上训练,即可在当时编辑任务上与顶级模型竞争。Figma agent 已向全部用户开放,测试中典型任务约快 20%,专家对比中 62% 的情况优于或持平上一版生产 agent,用户评分高 33%,撤销操作少 60%。

    Abstract illustration of a large green mechanical wheel threaded with winding golden ropes, surrounded by green and pale yellow circles.

    Figma agent 产品设计师使用 Figma agent 提升工艺、速度与创意表达的 3 种方式 以下是 Uber、Granola 和 Atlassian 的团队如何借助现已全面可用的 Figma agent 支持高质量、快节奏的工作。,其中包含我们的第一方编辑模型。该 agent 同时运行这个专门模型和领先的第三方模型,将它们用于工作的不同部分。对于图像生成、矢量或全新设计探索等某些任务,我们使用可用的最佳第三方模型。对于我们的模型处理良好的精确编辑和迭代,我们使用自己的模型。 周围的画布也很重要。agent 需要来自画布和设计系统的上下文,以及能够做出所请求更改的工具。后训练帮助模型更好地完成其在这项工作中的部分。 了解更多关于 产品设计师如何使用 Figma agent 提升工艺、速度与创意表达的信息。 我们对 Figma agent 的早期结果感到鼓舞。即使在从 beta 到全面可用之间的这段时间里,典型任务也快了约 20%。在与专家设计师的正面对比测试中,新 agent 有 62% 的情况优于或持平上一版生产 agent。用户评分高出 33%,用户撤销 agent 工作

    匹配字段正文
  2. Latent Space

    Elorian 发布 DecoyCount 基准,前沿模型视觉计数准确率均低于 50%

    Elorian 与 Mercor 联合发布 DecoyCount 基准,测试模型是真正数清物体还是依赖视觉捷径,前沿模型准确率均低于 50%,最高为 GPT-6 Astra 的 43.17%。Elorian 称其视觉推理模型 Glimpse 在 1,660 道题上单次运行得分 50.48%,是唯一超过 50% 的模型,但该结果来自内部测试且未使用智能体或工具框架,而论文中的六个模型各取三次运行平均值。Elorian CEO Andrew Dai 表示,该基准同时考察视觉与推理,可区分模型是没看到物体还是数错了。

    图像和编辑图像来将问题可视化。” 他举了一个买沙发并在脑海中想象它放在客厅里会是什么样子的例子。 一个概念性的视觉推理循环 还有在脑海中操作图像;例如,如果你在数桌子周围的人,你可能会在脑中“把他们一个一个划掉,”Dai 说。 这就是 Elorian 在其模型中想要做的:教它们视觉思维,“这涉及将生成和编辑图像作为推理轨迹的一部分,与语言一起。” 关键在于,图像生成对视觉模型来说不仅仅是输出——生成或编辑的图像是推理链的一部分。 Elorian 与世界模型有何不同? 视觉推理仍是一项进行中的工作,但今年在“世界模型”领域已经出现了一些令人印象深刻的发布——视觉是其中的关键组成部分。其中两个尤为突出:World Labs 于 9 月推出的 Atlas(该公司随后被 AMD 收购),以及 Google 刚刚发布的 Genie 4。 当 World Labs 发布 Atlas 时,它被描述为“面向空间智能的全能世界模型”。但 Atlas 所实现的功能——基本上是对世界的 3D 模拟——与视觉推理并不相同。 据 Dai 所说,世界模型能够实现对世界的“直接作用”,而 Elorian 更侧重于他

    匹配字段正文

星期三

  1. Simon Willison

    Simon Willison:2026 年 10 月是 vibe coding 游戏开发的拐点

    Simon Willison 认为 2026 年 10 月是 vibe coding 游戏开发的拐点,Claude Opus 5.5 在 3D 建模、音乐生成和游戏设计上有明显提升,他让模型把游戏改得更有趣后,用几周时间做出四个自己真正愿意玩的浏览器游戏。这些项目每个投入不超过四小时,均用 HTML 和 JavaScript 构建并运行在浏览器中;他建议从「Build a mobile-friendly three.js game where...」这类提示词起步,项目过了原型阶段再换用 Claude Code 或 Codex。

    Claude Code。 这是我在沿着 Skyline Boulevard 开车看树时一时兴起做的。我的提示词是: 构建一个名为“Tree appreciator”的 three js 游戏——它向你展示两棵算法生成的树,游戏机制是欣赏它们之间的差异。仔细思考如何确保它既有趣又美丽。 我发现告诉模型使用 three.js 效果非常好。Claude 没有自己的图像生成模型,但能够构建出看起来和感觉都很出色的全彩 3D 模型。 这个游戏完全不需要迭代或后续提示——我一次就得到了游戏。它给了我一个迷人的、适合移动端的找不同小游戏。你可以在这里玩。这是构建它的聊天记录。 它令人愉悦地放松。画面很有趣,在“植物标本馆”中收集你已完成的树木提供了一种美好、温馨的成就感。 Emberwick 这是一个更宏大的项目,我同样用普通的 Claude 聊天构建。我首先为一个俯视角奇幻 RPG 构建了一个实验性引擎原型: 构建一个演示游戏引擎 three.js,它是一个俯视角(但带角度)的 RPG——玩家可以和一两个同伴一起在世界中移动。创建一个奇幻村庄场景,演示在户外走动,然后展示当玩家进入建筑时,玩家与摄

    匹配字段正文

  2. heise online

    苹果 Creator Studio 订阅新增 AI 助手,Logic Pro 与 iWork 先行且暂仅支持美式英语

    苹果扩展面向创意工作者的 Creator Studio 订阅包,为 Mac 版 Logic Pro 以及 Keynote、Pages、Numbers 加入基于苹果自有模型和 OpenAI 模型的 AI 助手,更新计划于 11 月通过 App Store 发布,但未给出具体日期。Logic Pro 助手可解释制作流程、协助准备歌曲和设置人声轨,iWork 助手会结合当前文档上下文生成内容;两者均以 Beta 形式上线,初期只支持美式英语。Keynote、Pages、Numbers 可通过 Model Context Protocol 接入外部 AI 智能体,但苹果未说明 Freeform 是否支持 MCP,也未说明按文档、智能体或会话授权及变更确认的机制。Final Cut Pro 集成 MotionVFX 的模板、图形、转场及 rotoscoping、跟踪、调色工具,并可与 Pixelmator Pro 联动;Pixelmator Pro 新增 Generate Fill。订阅价格为每月 13 欧元或每年 129 欧元。

    标题、转场以及用于 rotoscoping、跟踪和调色的工具。时间线中的图像可在 Pixelmator Pro 中编辑,修改结果会回到项目中。此外还增加了更多关键帧缓动选项,转录功能支持另外 23 种苹果未具体说明的语言。剪辑可从主情节中分离,并自由放置在时间线上。动画软件 Motion 获得 MotionVFX 插件,例如用于调色和 3D 摄像机跟踪,以及图像生成工具;Compressor 可编码 iPhone 18 Pro 和 iPhone Duo 的电影模式视频。Pixelmator Pro 通过“Generate Fill”学会根据 AI 提示补充选定的图像区域。据苹果称,该功能会考虑光照、透视和纹理,使结果无缝融入图像。 Mac 版 Final Cut Pro 现已直接集成 MotionVFX 的内容。其中包括模板、图形、标题和转场。 (图片:苹果) Final Cut Pro 的 Content Hub 今后除照片和背景外,还将包含精选的库存视频;苹果还宣布为 Keynote、Pages 和 Numbers 推出新的高级主题和模板。 广告后继续阅读 MCP 与隐私:许多细节

    匹配字段正文

  3. Unite.AI

    Oracle 发布 Media Fabric AI 平台,整合内容制作与流媒体分发

    Oracle 在 Oracle AI World 上发布 Oracle Media Fabric,将 AI 内容制作、企业媒体模型与分布式视频分发整合到一个平台。平台由 Oracle Creative Studio、Oracle AI Media Models 和 Oracle Video Edge 组成,Creative Studio 为模型无关,可按安全、来源、成本和 IP 保护需求为每项创作任务选择模型。Oracle 称 Media Fabric 计划在未来 12 个月内可用。

    向专业媒体团队和广泛的内容创作者,旨在将创意转化为故事板、场景、电影级视频、视觉效果和虚拟角色。Oracle将该套件描述为模型无关:它将Oracle AI Media Models与第三方模型相结合,并可根据安全、来源、成本和知识产权保护方面的要求为每项创作任务选择模型。 Oracle AI Media Models是Oracle开发的模型,专注于视频生成、图像生成和图像编辑。Oracle表示,这些模型旨在帮助媒体工作室和娱乐公司加速内容创作,同时保持创意控制,在Oracle Cloud Infrastructure(OCI)上实现受治理的大规模媒体处理、智能策展和搜索以及前沿模型定制。 Oracle Video Edge是一个AI赋能的托管平台,面向举办大规模直播活动的广播公司和流媒体提供商。Oracle表示,它利用实时网络和播放信息来协调容量,并将观众引导至OCI以及参与的内容分发网络和互联网服务提供商网络中的合适交付位置,旨在保持高视频质量和低延迟,使播放在观众规模达到峰值时能够快速启动并保持流畅。 Oracle此前的视频交付工作 被宣布为Oracle Video Edge的交付

    匹配字段正文

星期二

  1. Apple Newsroom

    Apple Creator Studio 更新:Final Cut Pro 内置 MotionVFX,Logic…

    苹果为 Apple Creator Studio 推出更新,Final Cut Pro for Mac 内置 MotionVFX 特效与模板,并可在 Pixelmator Pro 中直接编辑时间线图像。Logic Pro for Mac 新增由苹果自研模型与 OpenAI 组合驱动的智能助手(beta),Stem Splitter 可分离鼓声;Pixelmator Pro 推出用自然语言修改选区图像的 Generate Fill。Keynote、Pages、Numbers 新增理解文档上下文的助手(beta),并支持 MCP,让外部 AI 智能体读取内容、执行编辑和自动化操作。

    问 Content Hub,获取 Apple 精心策划的库存视频、照片和背景资料库,以填补空缺、增添精致感或激发新想法,而无需离开自己的工作流。 跨应用工作流和视觉创作也在 Final Cut Pro 中实现了重大飞跃。剪辑师可以直接在 Pixelmator Pro 中打开时间线上的任何图像,利用高级编辑工具,并将更改自动保存回项目——无需重新导入。借助高级图像生成功能,用户可以直接在项目中根据文本描述创建令人惊叹的图像、应用快速编辑并调整视觉风格。此外,Final Cut Pro 还引入了强大的工作流改进,包括更多关键帧缓动选项以实现更精细的动画控制、能够将片段与主故事线分离以将其放置在时间线上的任意位置,以及 23 种新的转录语言,使为素材添加字幕和搜索素材变得前所未有的轻松。 Final Cut Pro 用户现在可以直接在 Pixelmator Pro 中打开时间线上的任何图像,以利用高级编辑工具。 Final Cut Pro 引入了更多关键帧缓动选项以实现更精细的动画控制、能够将片段与主故事线分离以将其放置在时间线上的任意位置,以及 23 种新的转录语言。 Motion 还新增

    匹配字段正文

  2. Apple Newsroom

    Apple 发布搭载 M6 芯片的新款 14 英寸 MacBook Pro

    Apple 发布搭载 M6 芯片的新款 14 英寸 MacBook Pro,配备 12 核 CPU、12 核 GPU 和双 16 核 Neural Engine,电池续航最长 24 小时。相比 M5,图形性能提升最高 30%,LLM 提示词处理等端侧 AI 负载提升最高 25%;从 M1 升级则图形最高快 11 倍、AI 性能最高快 13 倍。新机标配 16GB 统一内存、最高可选 32GB,支持 Wi-Fi 7 和蓝牙 6,10 月 28 日开启预购,11 月 6 日发售。

    核心,与 M5 相比图形性能提升最高可达 30%。2 从 3D 建模到照片编辑和游戏,一切都感觉无比快速,这得益于第三代光线追踪引擎和动态缓存对片上内存的优化。与 M5 相比,它还将 LLM 提示词处理等端侧 AI 工作负载的性能提升最高可达 25%。3 双 16 核神经网络引擎的性能比 M5 提升最高可达 1.9 倍,并与先进的 GPU 协同工作,大幅加速图像生成、超分辨率(Super Resolution)和 AI 放大等 AI 工作负载。2 神经网络引擎还为 Apple Intelligence 提供支持,实现先进且高能效的端侧 AI 处理。搭载 M6 的 14 英寸 MacBook Pro 以业界领先的每瓦性能实现这一切,并拥有 Mac 史上最长的最长可达 24 小时电池续航。标配 16GB 统一内存,最高可配置至 32GB,内存带宽最高可达 170GB/s,让 MacBook Pro 在多任务处理以及使用高要求应用和大型项目时更加快速。 搭载 M6 的 14 英寸 MacBook Pro 帮助动态设计师轻松为 3D 对象建模、设计产品可视化效果并渲染动画。 搭载 M6 的 1

    匹配字段正文

星期一

  1. Google Blog

    15 位大学生分享最爱的 Gemini 功能

    15 位 Google Student Ambassadors 分享了他们最常用的 Gemini 功能,包括把课程材料转成个性化短课的 Study notebooks、用语音练习面试的 Gemini Live、引导式学习的 Guided Learning,以及生成学习指南和定制测验。学生套餐提供课堂材料、学习笔记和图片的无限上传,Audio Overviews 还能把文档和幻灯片转成播客式对话,方便在校园路上复习。

    Three young adults gathered around a laptop looking at its screen

    借助 音频概览,你可以从文档、幻灯片等创建播客风格的对话。“我依靠音频概览在校园里走路时进行最后一刻的复习,”Nina说。“这让我以对话的方式吸收内容,并在听的同时做主动笔记。” 学生们表示,音频概览对于更深入地探索课堂材料和主题尤其方便。“我喜欢上传观点相互冲突的文章。主持人会自然地就问题的双方展开辩论,”罗格斯大学的Parikshit M.说。 8. 图像生成 Nano Banana是Gemini的图像生成器,可以帮助你可视化任何想法并设计任何东西。“作为一名创意工作者,我发现图像生成模型很有帮助,尤其是在调整图像格式和锐化细节时,”莫尔豪斯学院的Nelson G.说。 学生们在课堂之外也在使用它。“我在设计图形时经常会感到不知所措,”Beverlyn说。“我喜欢用Gemini制作社团传单和社交媒体帖子。它能把我的想法变成贴合我风格的吸睛视觉作品。” 9. Chrome 中的 Gemini 借助 Chrome 中的 Gemini,你可以直接在浏览器中获得帮助。“它让复习考试错题变得高效得多,因为我不必再把它们复制粘贴到 Gemini 对话中,”伊利诺伊大学厄巴纳-香槟分校的 Me

    匹配字段正文

星期日

  1. TechCrunch AI

    AI 墓地:那些没能活下来的项目和创业公司清单

    TechCrunch 汇总了一份 AI 项目与创业公司的失败清单:AI 工作流自动化工具 Relay 于 8 月彻底关停,Character.ai 在成立五年后申请破产,S&P Global 数据显示约 42% 的 AI 计划最终被企业放弃。OpenAI 也多次折戟,独立 AI 浏览器 ChatGPT Atlas 上线不到一年便于 8 月 9 日停用,视频平台 Sora 因运营成本高、用户留存难在 2026 年 3 月关停。Humane AI Pin 在 2025 年 2 月终止业务,大部分资产以 1.16 亿美元被 HP 收购。

    将其功能直接并入 ChatGPT——这一策略的效果比那次改版要好。ChatGPT Atlas 是一款独立的 AI 驱动网络浏览器,存活不到一年便于 8 月 9 日停用,其最有用的功能被并入 ChatGPT。 该公司对 Operator 也采取了同样的做法。Operator 是一款能够浏览网页并代表用户完成任务的 AI 智能体。此外,OpenAI 越来越多地将图像生成功能直接内置于 ChatGPT,从而削弱了 DALL-E 作为独立图像创作入口的角色。 我们也不能忘记其视频分享平台 Sora,该平台因高昂的运营成本和用户留存难题而苦苦挣扎,并于 2026 年 3 月关停。 苹果的 Siri AI 当苹果在 2024 年推出 Apple Intelligence 时,改进版 Siri 是重点宣传的功能之一。其宣传承诺,Siri 能够理解上下文、了解各应用中的情况,并高效完成任务。 然而,苹果以工程问题和漏洞等各种理由多次推迟新版 Siri 的发布。这一延迟最终导致苹果就 iPhone 16 的 AI 能力营销方式相关指控达成 2.5 亿美元和解。 Siri AI 终于在今年 7 月的 iO

    匹配字段正文

星期六

  1. Numerama

    Artefact AI Film Festival:AI 如何辅助电影创作

    由 mk2 与 Artefact 主办、LDLC 和 NVIDIA 合作的 Artefact AI Film Festival 已办到第三届,主题为「(Dis)Connection」,报名截止 2026 年 12 月 2 日。参赛影片最长 314 秒,且须在前期、拍摄、后期三个阶段各至少使用一项生成式 AI 技术;一等奖奖金 10 000 欧元,并可在 mk2 影院放映一周 30 秒版本。NVIDIA 建议用 GeForce RTX 50 系显卡配合 ComfyUI 在本地生成图像和视频。

    旨在表彰借助人工智能创作的影片。这里的目的并不是比拼提示词:工具必须服务于一个故事、一种导演意图或一种情感。 该竞赛面向全球参与者开放,并设有多项限制。每位参赛者只能提交一部影片,时长最长为 314 秒,即 5 分 14 秒。 参赛者还必须在项目的三个阶段——前期筹备、拍摄和后期制作——中,每个阶段至少使用一项生成式 AI 技术。因此,从分镜到声音制作,再到图像生成,AI 必须在创作的多个环节中找到自己的位置。 继「Réalité(s)」(现实)和「(Dis)play」(展示/错位)之后,第三届提出了新主题:「(Dis)Connection」。参与者受邀探索是什么让人与机器、作者与其工具、现实与虚拟彼此靠近或疏远。这既能丰富叙事,也能影响影片的制作选择。 该电影节由 Artefact 和 mk2 于 2024 年创办,最初由让-皮埃尔·热内担任主席,之后由塞德里克·克拉皮斯接任。第二届共收到来自 52 个国家的 265 份报名,其中 20 部影片入围竞赛单元。 2026 年 Artefact AI 电影节评审团联合主席 // 来源:Artefact AI Film Festival 今

    匹配字段正文

  2. Latent Space精选

    月之暗面发布 Kimi K3.1 Pro:2.8T 总参数、104B 激活参数,权重定于 11 月 4 日开放

    月之暗面发布 Kimi K3.1 Pro,这是一款多模态 MoE 模型,总参数 2.8T、激活参数 104B,上下文窗口 100 万 token,标准版与 Highspeed 版已上线 Kimi 网站、App、Kimi Work、Kimi Code 和 API,官方称 Highspeed 输出速度提升 2–3 倍、价格为标准版两倍。Artificial Analysis 将其排在 Intelligence Index 第四位、得分 55,落后 Opus 5.5 的 58;Arena 的 Code Arena WebDev 排名第 8、1692 分,较 K3 上升九位。标准版定价为每百万 token 输入 2 美元、输出 10 美元、缓存输入 0.2 美元,较 K3 下降三分之一;权重尚未发布,官方承诺 11 月 4 日开放。

    到端加速,这意味着 BF16 计算并非唯一瓶颈;内存带宽、内核覆盖范围、模型架构和框架开销都可能占据主导。他们将其与 ComfyUI 侧的优化(例如 MOSS-Image Spectrum 调整)进行比较,并声称后者在不修改 GPU 内核的情况下带来了约 20% 的更大加速。 一些用户将这一变化视为软件/内核层面的锁定,而非 RTX 3000 系列 BF16 性能的硬件限制,并建议对 RTX 20/30/40/50 系列内核开展更广泛的逆向工程。主要的技术顾虑在于稳定性与安全性:给厂商内核打补丁可能引入正确性问题、驱动不兼容或意外的温度/功耗行为,因此一些人计划等待更广泛的测试后再应用。 对于使用 RTX 3090 等显卡的 ComfyUI 用户而言,收益很可能在很大程度上取决于其流水线是否实际使用 BF16 密集型内核。以 INT8 量化模型(如 ConvRot 风格的图像生成或视频生成)为中心的工作流,如果推理主要由 INT8/FP16 路径、内存搬运、注意力内核、VAE/解码器阶段或 CPU/IO 瓶颈主导,而非 BF16 矩阵运算,则收益可能有限。感谢阅读 保持略微领先于趋势。

    匹配字段正文

星期五

  1. NVIDIA Developer · Generative AI

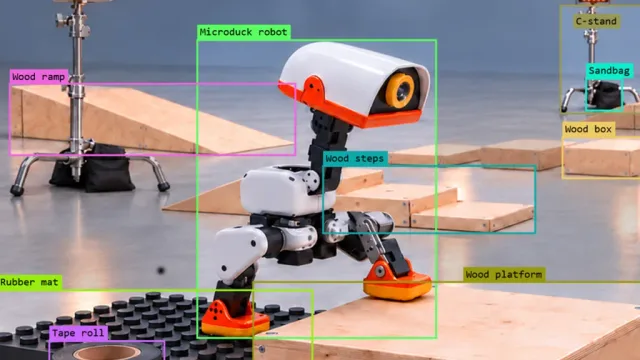
    NVIDIA 用 AI 智能体在仿真中教 Microduck 机器人行走

    NVIDIA 展示了一套在仿真中训练 Microduck 机器人通过障碍赛的工作流:Hermes 与 Nemotron 3.5 Bolt 在 RTX Spark 上把提示词转成项目计划,Astra 负责生成 3D 资产,场景在 Isaac Sim 中搭建。Isaac Lab 用 4096 个并行环境在 RTX PRO 6000 Blackwell Workstation Edition GPU 上训练感知与运动策略,随后回到 RTX Spark 本地验证,并为 sim-to-real 迁移做准备。

    Microduck robot in an obstacle course with labeled ramps, platforms, a rubber mat, and other objects.

    地规划包括对 Microduck 的代码仓库和文档进行简要审查。该审查确定机器人的能力、后续工作所需资源,以及仍需核实的细节。最终计划不仅涵盖资产创建,还概述了环境搭建、机器人准备、仿真、训练、验证和部署。 赛道需要同时测试运动和感知能力。Microduck 必须学会绕过障碍物、穿过受限空间,同时保持平衡。请用这些要求来指导拟议布局以及搭建所需的物体。 本地图像生成模型会生成赛道的概念图。随后 Hermes 和 Nemotron 分析该图像,并创建其中可见、可复用资产的清单。每个资产都会获得一个标识符、对其可见特征的描述以及一张裁剪后的参考图。清单会记录物体被截断或遮挡的位置,以便后续阶段区分可见细节与假设。 图 2. 障碍赛道的概念图与资产提取 Hermes 将这些输出整合为一个交接包:整体项目计划、Microduck 研究与来源链接、概念图、资产清单、裁剪参考图以及后续阶段的说明。随后它会自动将工作委派给 Astra。该交接包为 Astra 提供继续工作所需的更广泛项目背景和资产规格。 图 3. 将任务提示词转化为环境计划 2. 创建仿真资产 利用上一阶段的项目计划和参考图,Ast

    匹配字段正文

  2. Codex:GitHub Releases

    OpenAI Codex 发布 0.164.0 版本

    OpenAI Codex 发布 0.164.0,新增十个编号 /presets 槽位用于保存可复用提示词和斜杠命令,并支持用内联 /model 和 /permissions 参数直接设置模型、推理强度、速度与权限配置。该版本还支持企业 MCP 连接认证、远程 Bash 与 Zsh 会话凭据掩码,并默认启用 Amazon Bedrock 设置向导。

    定到显式目录 @etraut-openai 54053 为轮次启动和 steer 添加 Responses API 客户端元数据补丁 @marksteinbrick-oai 54056 合并重叠的原生 TLS 根证书加载 @jif-oai 54057 在 Decisions 比较指标中区分不支持的证据 @swastik-oai 54058 将轮次元数据转发到图像生成和编辑请求 @duc-openai 54059 在恢复线程时支持存储拥有的准备工作 @owenlin0 54060 将取消归档扫描限制为所请求线程的已归档 rollout @bz-openai 54069 修复远程 MCP 服务器的 Windows 环境处理 @iceweasel-oai 54070 将网关身份验证公开为可复用的 OAuth 会话 API @smurching-oai 54076 避免在字面 PowerShell 命令中误检测 URL 启动 @jif-oai 54078 将 gix 更新到 0.89.0,将 gix-url 更新到 0.40.0 @jif-oai 54079 淘汰被拒绝的 MCP OAuth

    匹配字段正文

星期四

  1. MiniMax Blog精选

    MiniMax Code 桌面端上线 Mini App

    MiniMax 在 MiniMax Code 桌面应用(macOS / Windows)的本地会话中推出 Mini App,它是一种带前端和 Node.js 后端、以插件形式安装的常驻应用,可与 Agent 互相调用,让工作留在持续存活的页面上而非散落在对话里。此次发布包含 Mini App 运行时(持久数据目录、托管 MCP、Agent API、Host Connectors 和页面内工具审批)、用一句话生成页面的 /miniapp-creator,以及插件市场的官方 Mini App 和开源社区仓库 MiniMax-Code-MiniApps。官方称账号凭证由宿主保管,插件和页面无法访问,页面传给 Agent 的内容会先进入输入框供审阅。

    Cover: a hand places a card into a cluster of Mini Apps, including a stock dashboard, a 3D model, a map, and a chat, connected by a line to the Agent

    图检查结果。 首批官方 Mini App 中有几个是由我们工程团队之外的同事以这种方式构建的: 一个股票仪表盘 Mini App,将散落在知识星球(Zsxq)、金门财经和腾讯文档中的股票信息汇集到一个仪表盘中。 CadQuery Viewer 让你可以在 3D 模型上标记位置,并将它们发回对话,供 Agent 修改。 自驾路线规划器将地图路线规划、地点搜索和图像生成整合到一个行程规划工作区中。 MiniMax Bot 本身就是一个 Mini App。主 Bot 组建团队,将长时间运行的任务交给后台 Agent 对话,然后审查并汇报结果。这些对话中的 Agent 又可以调用 Bot 的工具来发送消息、保存和搜索记忆。大多数 Bot 更新只需改动插件,无需等待 MiniMax Code 发布新版本。其源代码现已放入开源社区仓库。 开源社区的开发者也开始构建自己的 Mini App:一个按日期和模型展示 token 用量的仪表盘、用于以泳道图浏览 Git 历史的 Git Commit Tree,以及用于回放对话模型轨迹的 Session Trajectory。有些则偏向日常生活和创意工作,比

    匹配字段正文

星期三

  1. The Decoder

    Inception 发布扩散语言模型 Mercury 3,称速度达 GPT-6 Luna 四到八倍

    Inception 发布扩散语言模型 Mercury 3,称其在 12 项基准中赢下 8 项,运行速度为 GPT-6 Luna 和 Claude Haiku 5.5 的四到八倍。在 Inception 自测中,Mercury 3 在 IFBench 得 76.84 分,比 GPT-6 Luna 高 15 分;SWE-Bench Atlas 得 51.08 分,对手分别为 33.33 和 32.26。Claude Haiku 5.5 则在 DeepSWE 长代码测试和长文本检索上领先。该模型在 Nvidia GPU 上每秒生成 1,068 个 token,定价为每百万输入 token 0.20 美元、输出 0.70 美元,发布期五折,已上线 Inception 平台及 OpenRouter、Baseten、Vercel,目前尚无独立测试。

    ,其新语言模型 Mercury 3 在一系列基准测试中击败了 GPT-6 Luna 和 Claude Haiku 5.5,同时运行速度快四到八倍。 在公告中,该公司称 Mercury 3 是迄今为止发布的最强大的扩散语言模型。 速度来自模型的构建方式。像 GPT 或 Claude 这样的模型一次写一个词,因此每个新词都必须等待前一个词。扩散模型最为人熟知的是图像生成领域。它们先勾勒出整个答案的粗略版本,然后经过多轮细化,一次生成许多词。谷歌关于 DiffusionGemma 的技术报告解释了这一基本思路。 Mercury 3 的领先幅度没有公告所暗示的那么大 Inception 自己的基准测试表讲述了一个更为复杂的故事。在三个模型均以中等设置运行的情况下,Mercury 3 在 12 项测试中赢了 8 项。差距最大的是指令遵循。在 IFBench 上,Mercury 3 得分为 76.84 分,比 GPT-6 Luna 高 15 分。它在 SWE-Bench Atlas 的自主编程测试中也明显领先,得分为 51.08 分,而竞争对手分别为 33.33 和 32.26。 Claude H

    匹配字段正文

  2. Simon Willison

    Simon Willison 用 Claude Code 做出音频联机的 RTS 游戏 Battle Drones

    Simon Willison 发布用 Claude Code 全程 vibe coding 开发的即时战略游戏 Battle Drones,经过 12 个大版本、321 次提交,可在手机和桌面浏览器运行。游戏包含 9 种建筑、7 种地面载具、6 种空中载具和 3 种步兵单位,支持战争迷雾、随机地图生成、AI 对战 AI 以及两个 LLM 互相对战的 Agent 对战模式。他还实现了两台设备通过麦克风音频同步游戏状态的联机方式,并因音频引发头痛问题补充了基于 WebSockets 中继服务器的在线联机。

    e 5 开始: 我们要构建一款移动端友好的 RTS 游戏——命令与征服风格——名为 Battle Drones,其中两支无人机军队(包括飞行和地面单位)为领土和资源而战 让我们从 MVP 设计开始,问我一些问题 这是一份共享对话记录。我给 Claude Code for Web 设置了一个包含 OpenAI API 密钥的环境变量,并让它使用 OpenAI 图像生成 API 来制作素材,这让我得到了一些基础精灵图。 你可以在此试用 v1——它看起来是这样的: 它一眼就能看出是 RTS,具备建造机制、选择和指挥单位的能力,以及一个可供对战的基础 AI。 这第一个版本勉强算是个概念验证,玩起来一点也不有趣。 Claude 在这些早期版本中使用了 Phaser 2D 游戏框架。我直到好几轮迭代之后才意识到这一点! v2:完整精灵图 第二个版本(在此试用 v2)为所有载具添加了精灵图,并加入了“AI 对 AI”模式,这样我就能观看游戏自动进行,而无需自己直接操控。 Claude 在提示 OpenAI 的图像模型生成精灵图方面表现得相当称职。你可以在 public/assets/sprites

    匹配字段正文

  3. Unite.AI

    GEPI 报告《AI 如何辜负女性》审视算法如何放大性别偏见

    性别平等政策研究所(GEPI)发布由 Myriam Shiran 撰写的报告《How AI Fails Women: When Bias Becomes Amplified》,综述自动化系统如何复制甚至放大性别歧视。报告引用 2024 年一项涉及超 300 万次模拟简历对比的招聘审计:筛选模型在 51.9% 的对比中显著偏向男性关联姓名,仅 11.1% 偏向女性关联姓名。报告还指出,仅删除性别字段不足以消除偏见,姓名、教育、履历等信息仍会携带性别信号。

    缺乏依据的假设。这需要具有代表性的评估数据和对错误的仔细审查,而不是要求每一条建议都完全相同。 该报告将个人获取资源(如贷款或医疗服务)方面受到的伤害,与群体被描绘方式上的伤害区分开来。生成的推荐信、新闻文章和职业图像可能强化刻板印象,即使随后没有立即的分配决策。 GEPI总结的研究发现,语言模型更多通过人际品质来描述女性,更多通过领导力或能力来描述男性。对图像生成器的研究发现,各职业中存在被夸大的性别隔离。这些结果适用于所考察的模型和版本;不应将其解读为对当前所有可用系统的新审计。 消费者助手和陪伴型AI提出了另一个问题。它们的声音、个性以及对骚扰的回应是有意的产品选择。仅评估其回答的统计平衡,可能会忽视产品设计本身所嵌入的假设。 该综述还审视了未经同意合成的性图像,在这类情形中,AI使虐待内容更容易被制作和传播。这不仅仅是描绘不准确的问题:未经同意使用真实人物的肖像可能造成直接伤害。这需要一种不同于纠正生成艺术作品中职业刻板印象的应对方式。 为什么独立测试很重要 GEPI描述了四种反复出现的机制:从不平等的历史记录中学习、复制刻板印象、将判断呈现为客观测量,以及让有偏见的输出影响后

    匹配字段正文

星期二

  1. Google Blog

    Google 为 Gemini 推出小企业业务中心与品牌、财务工具

    Google 为 Gemini 推出面向小企业主的业务落地页,可在其中管理品牌、财务和客户洞察,并连接 Google Business Profile、Google Ads、Google Workspace 以及 Adobe、Canva、Dropbox、Shopify、Wix、Zoho、Xero 等第三方应用。用户上传网站、品牌套件、字体或配色即可定义品牌风格,配合 Nano Banana 2.1 生成风格统一的营销视觉;Gemini 还能把表格、收据和采购记录转成财务图表与交互模型。这些功能将在未来数日面向所有 Gemini 应用用户全球逐步上线。

    "Your brand, your tools, all in one place" banner featuring three feature highlights: "Create image styles for your brand," "Customize Gemini with apps and skills," and "Create content with templates."

    oogle Ads 和 Google Workspace 等 Google 工具,以及 Adobe、Canva、Dropbox、Shopify、Wix、Zoho 和 Xero 等第三方关联应用。 符合品牌风格的视觉素材 企业现在可以通过上传网站、品牌套件、字体或配色方案,在 Gemini 中定义自己的品牌风格。结合 Nano Banana 2.1(我们最新的图像生成模型)的强大能力,Gemini 现在可以为新产品发布或持续进行的营销活动提供端到端的视觉成果。Gemini 会保留这种视觉风格,让企业主能够轻松生成风格统一、符合品牌调性的素材,而无需反复上传风格指南。 实时财务洞察 Gemini 可以在几秒钟内把杂乱的电子表格、收据和采购记录转化为清晰的财务图表和交互式模型。小企业主无需自己解读数字,就能以更自然的方式获得财务洞察。 来自世界各地小企业主的故事 在法国波尔多,陶艺家 Morgane 在 Gemini 的支持下发展她的公司 Bleu Clémentine。她用 Gemini 撰写产品描述、新闻通讯和吸引人的社交媒体文案,每天节省两到三个小时——她把这段时间直接投入到制作精美的

    匹配字段正文

  2. One Useful Thing

    Ethan Mollick 用图表回顾 AI 发展的 30 个月

    Ethan Mollick 在新书 Co-Existence 发布当天,用图表回顾了距上一本书 Co-Intelligence 发布 30 个月来的 AI 进展。他称 GPT-4 之后已有 20 个模型先后登顶,180 个模型在发布时强于 GPT-4,其中 19 个可在现代智能手机上运行;METR 长任务基准显示 AI 可完成的人类工作量从 2024 年的 4 分钟增至 2026 年 4 月的 17 小时,该基准随后因无法准确测量而停用。他提出在 centaur 与 cyborg 之外的第三种协作方式 conjurer,即召唤智能体、分配任务并评估结果,本文图表即由 Claude Projects 中的 Opus 5.5 调度多个智能体完成。

    r)。召唤师在需要时召唤智能体,给它们分配工作,并评估返回的结果。本帖中的图表就是这样制作的:我召唤智能体,给出一些总体指导,然后说了很多次“把它做得更好”。这是使用AI最强大的方式,而且随着我们对AI究竟在做什么来为我们取得这些结果失去控制,它也带来了新的风险。 水獭测试已经失守 老读者会知道,过去几年我一直在用“水獭在飞机上用WiFi”这个提示来测试AI图像生成和电影工具。这是30个月前最好的图像生成器Midjourney生成的结果。 所以今天我问了 Opus 5.5 下面这个问题(错别字都保留着,随着 AI 越来越强,提示词已经变得没那么重要了):“我有一篇帖子,为了纪念我的新书(在原书出版 30 个月后出版),展示了过去 30 个月 AI 领域发生的事。我想让你用 wifi 视频做出终极的水獭在飞机上。就做点特别棒的东西,我知道你很有创意,放手去做吧。”利用我订阅的 Google 和 ElevenLabs 等多项在线服务,它产出了下面这个结果。(打开声音) 这个视频有一些瑕疵。但 AI 自己想出了怎么做出来,从脚本到图像到概念到音乐再到创作这一切的技术层面,全程没有我任何帮助。

    匹配字段正文

  3. 36氪 · AI

    2026年9月中国AI大模型平台排行榜:RSI、Personal Agent与世界模型

    36氪发布2026年9月中国AI大模型平台排行榜,聚焦代码大模型率先进入RSI(递归自我改进)时代。面壁智能让AI工程师约8小时从零写出预训练框架、性能追平Megatron-LM;智谱Infra Agent让GLM-5.3定位并修改自身推理基础设施瓶颈;Qwen3.8-Max一个月无人值守跑通33轮迭代,Artificial Analysis评分从40分升至45分。阿里云栖大会宣布Qwen4已在训练中,未来版本将扩展至5-10T参数。

    检验、药物等核心知识;NutriData由中国营养学会参与共建,基于《中国食物成分表》等权威数据。千问正持续接入权威专业知识库,将“专业知识底座”作为医疗健康领域的长期基础能力。 9月11日,阿里云Token Plan个人版升级。原有价格及Credit额度保持不变,Standard和Pro套餐新增Agent Harness工具权益与用量,覆盖搜索、网页解析、图像生成、语音处理、代码执行等12项Agent开发常用能力。上述工具均通过MCP标准协议开放,可直接接入到自有 Agent应用,无需逐项单独采购。 Token Plan支持在千问桌面端、Qoder、Qwen Code、Codex、OpenClaw等Agent应用中调用,开发者可在不同工具中复用订阅模型。 9月7日,阿里巴巴旗下Agent产品千问办公推出业内首个“多人工作台”。用户简单描述需求,即可生成并发布一个最多支持百人同时在线协作的网页,承载复杂的业务流程。该功能适用于活动组织、家校协同和企业协作等场景,可解决SaaS软件采购成本高、定制软件开发耗时高的难题。目前,用户可从千问办公首页下方功能入口直接体验。 9月4日,千问办公迎

    匹配字段正文