←搜索结果

按匹配度 · 共 2286 条结果 清除搜索

星期五

  1. 华尔街见闻

    稚晖君回应 GPT-6 Astra:大模型越强,机器人本体越重要

    在智元第四届创新日上,联合创始人彭志辉(稚晖君)回应 GPT-6 Astra 可直接控制机器人带来的疑问,认为无论基模能否通吃具身能力,可规模化、低成本、高一致性的本体厂商都更占优。他给出智元 2025 年出货 5000 多台、2026 年上半年出货 9700 台的数据,并称 100 台真机组网后训练可把任务成功率从约 50% 提到 98%。智元同时提出以 Worken 度量机器人有效智能工时,并指出运维人机比是规模化的关键瓶颈。

    。 在彭志辉看来,模型是必选题。不做模型,最后就会像传统自动驾驶方案公司一样,被自研模型的主机厂取代。 这套逻辑有一个前提。Astra的慢,来自参数规模和云端推理,彭志辉自己也列了解法,分层设计、模型蒸馏、缓存系统。这些问题如果先被大模型公司解决,本体厂商的窗口期会比预想的短。 02 从参数表到工时表 客户的问题已经变了。 过去看机器人,看参数,看跑跳打拳的视频。现在客户问的是,它能稳定干多少活,干一次要花多少钱。 智元给的答案是Worken,Work和Token的组合,中文名就叫智元,度量机器人的有效智能工时。计算拆成三个乘数,在岗活跃台数、自主工作时间、产出能效比。一台机器人每工作10分钟就要人接管一次,自主工时就很有限。 收费方式上,彭志辉没有给单一答案。卖本体、卖服务、和客户共创运营都可以,看客户要的是设备还是结果。 真正卡规模的是运维。 彭志辉的原话是,「每卖一台机器还要给机器人配一个保姆,这是永远不会到那一天的。」客户愿意大规模买单,要等他的问题从「能不能造得出来」变成「能不能养得起」。 龙旗是目前最完整的样本。这条3C产线2026年3月规模化投产,已稳定运行7个多月,6天

    匹配字段正文
  2. 财联社

    亚马逊财报会:AWS季度营收460亿美元,2027年资本开支将继续提升

    亚马逊2026年第三季度财报显示,AWS营收460亿美元、同比增长39.3%,待执行订单5780亿美元,AI推理收入占AWS AI收入过半。管理层预计2027至2028年AWS年增速高于40%、5至10年内冲击万亿美元营收,但2026年资本开支约2200亿美元且2027年还将显著提升,公司股价盘后下跌7.3%。财报会还提到Bedrock上财富500强企业支出同比增长近7倍、token调用量增长近17倍,Trainium计划2027年末对外销售。

    完成购物的用户很少,体验不如直接访问零售商平台搜索或者一键下单。广告团队 Q3 完成多项创新,预计未来数月逐步释放效果。核心产品 Amazon Ads Agent,整套广告能力全部整合进 AI 优先的统一平台。依托万亿级购物、浏览、流媒体行为信号,为广告主全流程输出洞察、回答问题,自动完成优化与执行。我们还在该产品中上线全漏斗广告活动,把赞助广告、展示广告、视频、流媒体电视广告整合至同一个活动。 广告主输入预算、周期等基础信息,亚马逊 AI 自动规划、执行并且持续优化。其他多条业务线同样势头向好。Prime Video 已经成长为数百亿年化营收的重要业务板块,现已实现独立盈利。爆款剧集包括《凯莉》《我变美的那个夏天》《黑袍纠察队》《校外》《侠探杰克》《辐射》;电影《挽救计划》票房亮眼;体育内容包括周四橄榄球夜赛(2026 年开局表现史上最佳)、Prime 转播 NBA、纳斯卡赛车、美国大师赛、欧冠足球赛事。我们刚刚发布史上最强硬件产品矩阵,Echo、Kindle、Alexa 平板、Fire TV、Ring、Bee 合计推出 34 款新品。 业务尚处于起步阶段,但开局表现强劲,我们期待在

    匹配字段正文

  3. 凤凰科技

    零一万物获数亿元融资,总部将落地杭州临平区

    零一万物与杭州市、临平区达成合作,由市区两级国资联动投资数亿元,总部将落地杭州临平区并打造产业AI转型基地。零一万物已从大模型研发转向企业产业AI落地,产品体系覆盖基础大模型、企业Ontology、多智能体应用,并推出老板AI、销冠AI、投资官AI等智能体。杭州将输出本地产业场景资源,双方计划在经营管理、生产运营、供应链协同等场景落地AI项目。

    销冠AI、投资官AI等;同时设置前沿部署工程师(FDE)岗位,派驻人员深入企业一线对接业务需求,完成技术落地。 杭州也是DeepSeek、阿里巴巴的所在地,当地正在推进人工智能产业建设,目标打造国内人工智能创新高地,推动AI技术和产业融合。 按照本次合作规划,杭州将输出本地产业场景资源,零一万物输出企业AI技术、产品与交付能力。双方计划在经营管理、生产运营、供应链协同等企业核心业务场景落地AI项目,探索可复制的产业AI转型模式。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  4. 凤凰科技

    星巴克考虑在得来速引入AI,测试后台模型辅助录入订单

    星巴克CEO布莱恩·尼科尔表示,公司准备测试在后台运行的人工智能模型,帮助咖啡师在与顾客沟通时更准确、高效地录入订单,目标是让员工专心交流并提升出餐速度。星巴克还在研究一套识别技术,在参与该服务的顾客抵达门店时识别身份,随后展示个性化数字菜单并简化支付流程。尼科尔称这项工作尚处早期阶段,会先测试、总结经验再推广可行方案。

    作尚处在早期阶段,我们会先测试、总结经验,再把可行的方案推广开来。” IT之家注意到,大型连锁餐饮企业已经在得来速场景测试人工智能多年,但这项技术还没有在行业内大规模普及。汉堡王不打算大范围落地其正在试点的 AI 点餐系统,称顾客更愿意和人工交流。麦当劳则在测试自研方案,该公司表示这套系统能让每家门店每周省下数十小时人力,调配到其他工作上。 星巴克周四公布的财报业绩超出市场预期,其围绕门店升级、服务体验和新品研发的战略持续见效。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  5. 凤凰科技

    闪迪称 AI 推理推高 NAND 需求,长期订单排至 2030 年

    闪迪在 2027 财年第一财季财报电话会议上表示,AI 推理正在重塑 NAND 闪存供需格局,客户低估了运行 AI 基础设施所需的 NAND 容量,新型商业模式订单管道已延伸至 2030 年甚至更远。2027 财年约 50% 的位元出货已被 NBM 协议锁定,2028 财年预计升至约三分之二。闪迪同时宣布首款高带宽闪存 HBF 存储晶粒完成流片并进入制造阶段,面向 AI 推理提供接近 HBM 的读取带宽和 NAND 级容量,首批样品计划于下一个日历年交付。

    元人民币),均高于市场预期;同时宣布 1 拆 8 股票拆分,拆分将于 11 月 19 日生效。 财报发布后,闪迪股价一度上涨,但随后回落。截至美东时间 10 月 29 日晚间,盘后价约 1,282.50 美元至 1,295.05 美元(现汇率约合 8,563 元至 8,647 元人民币),较当日收盘再跌约 2.6% 至 3.6%;若以前收盘价 1,404.77 美元(现汇率约合 9,379 元人民币)计算,累计跌幅约 7.8%。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  6. 凤凰科技

    先问AI再看医生:患者信了,医生愁了

    中国青年报社调查显示,92.0%的受访者用AI查询过病情,69.7%会带着AI诊疗建议与医生沟通。牛津大学近1300人实验发现,同一病例由医生输入时AI识别率达94.9%,由普通人自行描述症状时降至不足34.5%。文章还提到AI的讨好倾向,以及千问接入药品说明书等医学资源、腾讯AI临床助手接入医院信息系统等产品进展。

    到了诊室,这些信息可以帮医生更快地进入状态。 事实上,市场上已经有一批AI产品选择在医疗健康这条道上深耕。例如,千问接入国家药监局药品说明书、中国营养学会知识库、临床指南等五大医学资源,并上线“健康档案”功能,允许用户授权接入智能手表、血糖仪等设备数据;此外,腾讯的“AI临床助手”也接入了医院信息系统,疾病预测准确率能达到96.39%,其中所有的输出必须经医师审核确认。该系统也明确表明,“AI作为辅助参考,不替代医生最终诊断”。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  7. 凤凰科技

    Anthropic 升级 Claude 移动应用:iPhone 语音模式接入 Apple CarPlay

    Anthropic 升级 Claude 移动应用,iPhone 版语音模式现已支持 Apple CarPlay,用户可在驾驶途中直接向 Claude 提问。此次更新还让 iOS 与 Android 版支持多账号同时登录并直接切换,Claude 新增 24 种语言、累计支持 33 种语言,语音模式响应更快、嘈杂环境识别更准确。

    备可调整大小的侧边栏、触控板与右键操作,并支持与 Claude Desktop 相同的键盘快捷键。 语言与语音能力也同步扩展。Claude 在网页、桌面、iOS 和 Android 端新增 24 种语言,累计支持 33 种语言,包括孟加拉语、丹麦语、斯瓦希里语、泰语、土耳其语、乌克兰语和越南语等。 语音模式则实现了更快响应,在嘈杂环境或用户轻声说话时识别更准确;非英语语音听起来更自然,且语音功能已覆盖更多 Android 手机。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  8. 凤凰科技

    美国科技巨头 7500 亿美元 AI 投入遇挑战,核心业务增速放缓

    据彭博社报道,支撑美国科技巨头今年合计 7500 亿美元 AI 投入的广告、消费与零售业务已显现增长放缓迹象。Alphabet 搜索广告收入创五个季度最低增速,亚马逊广告业务同比增长 11% 为 2022 年单独披露以来最慢,线上商店仅增长 2%。谷歌首席商务官菲利普·辛德勒承认 AI 模式下的搜索查询变现水平更低,Alphabet 股价创史上最大跌幅,市值蒸发近 5000 亿美元。

    人吉恩 · 芒斯特(Gene Munster)在谈及谷歌 AI 模式变现偏弱的问题时表示,新广告形式上线初期利润率偏低、之后逐步抬升,本就是常态。谷歌更大的挑战,是打造可以替用户完成采购、从中抽取交易分成的 AI 智能体。硅谷很多从业者认为,在 Meta 的 Muse 个人助手取得成功之后,这套商业模式已经具备落地条件。 芒斯特说:“过去的方式是依靠文字链接或者展示广告去影响消费者行为;而新的问题变成,该如何去影响智能机器人。” “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  9. 凤凰科技

    百度AI收入首超广告,但利润腰斩:百度还能撑多久

    2026年第二季度百度总营收313亿、同比降4%,归母净利润23.19亿、同比下滑68.33%,财报当晚美股跌12.73%;此前一季度AI相关收入占总营收比重首次突破50%,超过广告。文章认为百度正用高毛利广告收入换低毛利AI云收入,真正的挑战是从卖广告位转向卖算力或智能体代办的身份转型。

    经超过1700万次。海外车队超过一千辆,3月底在迪拜启动全无人商业化运营,8月还接进了Uber。这些不是PPT,是真东西。 所以百度的问题从来不是看不见。它的模式是:每次都比别人早看见三到五年,然后在这三到五年里,等着市场成熟。 而它的问题也一直在这里:它熬不到。 移动互联网那一次,它看见了,被微信和字节截了胡。O2O那一次,它看见了,烧了几百亿然后关掉。短视频、直播、外卖,每一个它都比别人早开口,每一个都没等到收割那天。 百度真正的组织能力,是"发现机会"的能力。它的短板,是"把机会熬成现金"的能力。 还有一个旁证。有报道统计,百度这几年内部的贪腐查处人数累积到了七百多人。这件事和商业模式没有直接关系,但它反映的机制是一样的:当主营业务不再增长,组织内部的分配逻辑就会从"一起把蛋糕做大",悄悄变成"抢现有蛋糕"。 而且这一轮周期的形状对百度是有利的。云的合同是三到五年起签,芯片的产线要十年才回本,Robotaxi的牌照是城市级的长期授权。这些都是慢生意,而慢生意最怕的从来不是亏损,是中途换赛道。 四、三条破局路,哪条最靠谱 现在说到怎么办。我不打算给一堆正确但没用的建议,就说三条,并

    匹配字段正文

  10. MarkTechPost

    Baseten 发布 2B 决策模型 joey-1,每百万 token 定价 0.01 美元

    Baseten 旗下 Base Labs 发布 2B 决策模型 joey-1,基于 Qwen3.5-2B 后训练,直接返回标签和校准概率而非生成文本,面向高并发路由、分类和护栏检查。模型在 Jev Decision Index 0.4 公开集得分 63.30,为 4B 以下最高,但比 9B 的 elephant-1 低 8.94 分。Model APIs 定价每百万输入 token 0.01 美元,平均 2000 token 请求 P50 延迟 20 ms,权重以 MIT 协议开源在 Hugging Face,可单张 CUDA GPU 自托管。

    oey-1elephant-1Perplexity Decider Flash v1.2Cloudflare Clef-Flash 参数2B9B4B9B 基础模型Qwen3.5-2BQwen3.5-9BQwen3.5-4BQwen3.5-9B 许可证MITMITApache-2.0Apache-2.0 输入文本、图像文本、图像文本、图像文本、JSON、图像、视频 最大上下文16,384(Model APIs);专用部署 262k16k(Model APIs);专用部署 262k262,144(训练至约 32k)默认 16,384 API 价格(每 100 万输入 token)0.01 美元0.035 美元0.01 美元未披露 Jev Decision Index 0.4(公开) 63.3072.2460.06未披露 报告延迟 20 ms P5049 ms P50未披露中位数 38.8 ms 自托管硬件1 张 CUDA GPU未披露CUDA GPU 上约 9 GiB BF16 权重在 1 张 H200 上测试 权重获取公开公开私有仓库,需要 token公开 所有模型的 Jev 0.4 分

    匹配字段正文

星期三

  1. 凤凰科技

    分子之心MMDesign技术报告:19个项目18个成功,6个GPCR靶点全命中

    分子之心发布AI蛋白质从头设计平台MMDesign的技术报告,覆盖18个靶点、纳米抗体和大环肽两类模态共19个项目,18个获得实验确认的结合分子,项目成功率94.7%,453个受测候选中139个命中,候选命中率30.7%。六个GPCR靶点全部成功,最优亲和力均达纳摩尔级,GPR68最优KD低至12.1纳摩尔,NK3R的30个候选全部确认结合。报告还显示对6个已有结合分子的靶点再设计时5个获得提升,并给出结构预测模型MMFold在FoldBench抗体-抗原界面基准上的结果。

    题的技术基础设施。 从单点命中到跨靶点、跨模态的系统性验证,从底层模型突破到可复用的研发工作流,MMDesign的最新报告把“AI能不能设计出分子”的问题,推进到了“AI能不能稳定、可复用地产出可用分子”。 少量候选、稳定命中的设计效率;亲和力、可开发性与新颖性并重的分子质量;不依赖“参考答案”、从功能需求直接给出分子、成功拿下高难度靶点的突破价值。三者共同支撑起“可复用”能力,让AI分子设计可以被产业持续用于解决真实研发需求。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”

    匹配字段正文

  2. 量子位

    逐际动力发布 FluxVLA Engine V2 技术报告,新增在线强化学习与真机部署验证

    逐际动力更新开源工程底座 FluxVLA Engine 的第二版技术报告,相较 9 月首版新增在线强化学习后训练实验,并扩展仿真评测与真机部署覆盖范围。报告显示,14 种策略接入同一套 LIBERO 闭环评测,8 组模型与设备组合的推理频率提升至 2.31–9.64 倍;SmolVLA 经在线强化学习后,在 LIBERO-10 和 RoboTwin Clean 十项任务上的成功率分别提升 10.0 和 15.4 个百分点。部署链路已在 ALOHA、双臂 Franka、Rebot 和 LimX Oli 等平台验证。

    底座。它打通“训、评、部署”全链路,保障已有的工程积累不归零。 至于如何做到的,我们可以从三个关键切面来看。 第一是数据与模型。 想让风格、特性各不相同的模型共用同一条流水线,第一步就得把底层的“粮草”和接口先标准化。 在数据层面,来自不同机器人、不同仿真环境的原始轨迹,会先做显式转换、标准化清洗,整理成兼容LeRobot规范的结构(包含Parquet文件、视频以及配套元数据)。 同时,相机顺序、动作表达、归一化统计这类约定,也会做好对齐匹配。 处理之后的这批数据,可以放到同一条管线里混训,也支持按分组保留各自独有的预处理、归一化规则。不管是训练还是推理,都会通过独立的数据入口,遵循同一套模型输入、动作处理语义。 像数据这样的核心资产,在具身智能研发过程中成本最高。 减少资产贬值、提升复用效率,本身就是具备行业价值的降本方案。 同样的逻辑也体现在模型层面。 平台目前已深度集成Qwen-VL、GR00T、π系列以及DreamZero等主流VLM、VLA和WAM架构。 不同模型完全可以保留各自的原生骨骼,同时通过统一接口丝滑接入训练、评测和部署流程。 这种设计有多爽呢?报告里的14种策略同

    匹配字段正文

  3. 量子位

    逐际动力更新FluxVLA Engine V2技术报告,补充在线强化学习与真机部署评测

    逐际动力更新开源具身工程底座FluxVLA Engine的第二版技术报告,相较9月首版新增在线强化学习后训练实验,并扩展仿真评测与真机部署覆盖范围。报告显示,SmolVLA经在线强化学习后,在LIBERO-10和RoboTwin Clean十项任务上的成功率分别提升10.0和15.4个百分点;8组模型与设备组合的推理频率提升至2.31–9.64倍。真机侧在ALOHA、双臂Franka、Rebot和自研人形机器人LimX Oli上验证了从模型checkpoint到闭环执行的部署链路。

    底座。它打通“训、评、部署”全链路,保障已有的工程积累不归零。 至于如何做到的,我们可以从三个关键切面来看。 第一是数据与模型。 想让风格、特性各不相同的模型共用同一条流水线,第一步就得把底层的“粮草”和接口先标准化。 在数据层面,来自不同机器人、不同仿真环境的原始轨迹,会先做显式转换、标准化清洗,整理成兼容LeRobot规范的结构(包含Parquet文件、视频以及配套元数据)。 同时,相机顺序、动作表达、归一化统计这类约定,也会做好对齐匹配。 处理之后的这批数据,可以放到同一条管线里混训,也支持按分组保留各自独有的预处理、归一化规则。不管是训练还是推理,都会通过独立的数据入口,遵循同一套模型输入、动作处理语义。 像数据这样的核心资产,在具身智能研发过程中成本最高。 减少资产贬值、提升复用效率,本身就是具备行业价值的降本方案。 同样的逻辑也体现在模型层面。 平台目前已深度集成Qwen-VL、GR00T、π系列以及DreamZero等主流VLM、VLA和WAM架构。 不同模型完全可以保留各自的原生骨骼,同时通过统一接口丝滑接入训练、评测和部署流程。 这种设计有多爽呢?报告里的14种策略同

    匹配字段正文

  4. NVIDIA Blog

    NVIDIA RTX Spark 笔记本更新:新增 Nemotron 3.5 Transcribe 与本地智能体工具

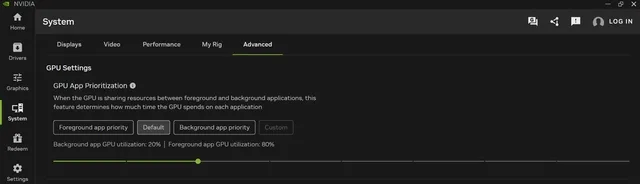
    NVIDIA 公布 RTX Spark 轻薄笔记本的多项更新,包括开放权重语音模型 Nemotron 3.5 Transcribe、Liquid AI 的 LFM3 模型家族支持,以及 NVIDIA App 中可在前台应用与后台智能体之间分配 GPU 资源的控制项。Nemotron 3.5 Transcribe 支持 40 种语言的转写、说话人标注和翻译,约 43 亿活跃参数,已在 Hugging Face 上线。RTX Spark 笔记本现由 ASUS、Dell、HP、Lenovo、Microsoft 和 MSI 出货,起售价 2599 美元。

    ,也能承担过去需要台式工作站才能完成的工作。 这对以下人群意味着什么: AI 开发者: 在本地运行模型和智能体,使用 NVIDIA CUDA ——与在云端为 AI 提供支持的平台相同——并具备在超过 1.5 亿台 NVIDIA RTX AI PC 以及云端 NVIDIA GPU 上部署的路径。 创作者: RTX Spark 可原生编辑相机拍摄的 4:2:2 视频,并渲染最高 90GB 的 3D 场景。Adobe Photoshop 和 Premiere 通过测试版提供对 RTX Spark 的原生支持。 玩家: 数百款游戏可在 RTX Spark 上运行,NVIDIA DLSS、光线追踪、Reflex 和 G-SYNC 带来更锐利的画面以及更流畅、更灵敏的游戏体验。 RTX Spark 笔记本现已由 ASUS、Dell、HP、Lenovo、Microsoft 和 MSI 出货,起售价 2599 美元,128GB 配置已上架。请在 RTX Spark 产品页面. ICYMI:来自 NVIDIA 本地 AI 的更多更新 🦆Microducks 在 RTX Spark 的帮助下学习行走: 在

    匹配字段正文

  5. ElevenLabs Blog

    ElevenLabs 发布强制对齐模型 Cue,支持字符级音频时间戳

    ElevenLabs 发布强制对齐模型 Cue,可为音频中每个字符定位精确时间点,并已用于 Scribe 语音转文字模型家族。Cue 覆盖 90 多种基准语言,单次处理任意长度录音,在生产 GPU 上对齐 1 小时音频约需半秒;在 29 种语言的基准上,其准确率高于 ElevenLabs 测试的所有对齐工具。该模型也通过 Forced Alignment API 单独开放。

    Cue vs. other aligners across accuracy, latency, language, song, and speed benchmarks.

    隆重推出 Eleven v4,这是我们迄今为止最具情感表现力的模型。探索跳至内容登录注册联系销售登录 阅读文档 了解更多 如果你曾在电视上看过一部播出信号出问题的电影,演员的对白与字幕完全对不上,你就知道这有多让人分心,会把你的注意力从故事中拉走。使用语音模型的视频和软件也有同样的问题:晚出现一秒的字幕,或者高亮了错误单词的转录文本,都会让人觉得同样糟糕。 “人类很擅长对齐媒体内容,至少能做到词级对齐,”ElevenLabs 从事对齐研究的研究员 Danila Kozlov 说。“我们通常能本能地感觉到一个词从哪里开始,但要做到字符级、亚毫秒级的精度,就难得多。” 今天,ElevenLabs 进一步介绍了 Cue,这是一种强制对齐模型,能把音频文件中的每个字符放到精确的时间线上。Cue 为 ElevenLabs 的 Scribe 模型家族提供支持,在真实录音上,它在基准测试的全部 29 种语言中都比 ElevenLabs 测试过的所有对齐器更准确。它还能单次处理任意长度的录音,并在不到一秒内对齐一小时的音频。 什么是强制对齐? 想象有人递给你一段视频和一份转录文本,让你把每个词匹配到它

    匹配字段正文

  6. 智慧城市行业分析

    河北省发布支持OPC赋能产业集群高质量发展工作举措,2028年出海服务OPC将达100家以上

    河北省工信厅印发《河北省支持OPC赋能产业集群高质量发展工作举措》,提出通过OPC+产业集群出海、OPC+智改数转网联等八项举措培育OPC服务主体。到2028年,全省参与产业集群出海服务的OPC达到100家以上,服务集群数智化转型的OPC超过50家,并在10个县(市、区)开展OPC+产业集群出海模式创新。

    设,参与打造“模数共振”空间。鼓励OPC参与“百模赋百景”揭榜挂帅,推动模型在细分场景的研发和应用落地。支持OPC与集群企业联合申报省级“人工智能+制造”典型案例,树立人工智能应用典型标杆。 数字营销是数字经济时代企业的重要营销方式之一。河北鼓励OPC+营销贸易,推动营销贸易类OPC依托人工智能技术,深度赋能产业集群市场开拓与品牌建设,重点发展数字人直播、短视频制作、智能客服、精准客流分析、供需智能匹配、营销服务外包等新业态、新模式。组织营销贸易类OPC和大型电商平台、短视频平台开展对接,建立本地化营销贸易矩阵,帮助集群企业开展立体化营销。遴选一批OPC+营销贸易典型案例,培育一批成熟的营销模式。 产业大脑是推动产业集群数字化转型、催生新质生产力的核心载体。在支持OPC+产业大脑方面,河北鼓励OPC入驻产业大脑,帮助产业大脑完善原料集采、产品集销、数智转型、公共服务等服务功能,在人员培训、研发设计、检验检测、营销贸易等方面延伸服务,加快产业大脑在集群的规模化应用。依托产业大脑数据、算力、客户等优势,帮助OPC提高模型、智能体研发能力,促进软件产品迭代更新。建立“产业大脑+OPC”服务生

    匹配字段正文

星期四

  1. Google Blog精选

    Gemini 应用支持直接生成、预览和编辑文档

    Gemini 应用新增在对话内生成、预览和编辑文件的能力,可全屏直接输入修改、选中文本提问或让 Gemini 改写文件。PDF 预览与编辑在网页端和移动端均支持,Google Docs、Google Sheets、幻灯片、Markdown、TXT 和代码等其他格式仅在网页端支持。该功能已向 Gemini 应用覆盖的所有语言的全部用户开放。

    现在,你可以直接在 Gemini 中生成、预览和编辑文档、PDF、演示文稿、电子表格等。 2026年10月29日 我们正在 Gemini 应用中推出创建和优化文档、PDF、演示文稿、电子表格、代码等内容的新方式。 现在,你可以直接在聊天中生成、预览和编辑文件——展开至全屏即可直接输入修改,选中文本即可提问,或让 Gemini 优化你的文件。PDF 预览和编辑在网页端和移动端均受支持,而所有其他格式(Google Docs、Google Sheets、幻灯片、Markdown 文件、TXT 文件和代码)仅在网页端受支持。 如下方视频所示,你现在可以让 Gemini 根据你上传的手写课堂笔记创建 PDF 学习指南,然后可以轻松手动编辑、选中特定部分让 Gemini 修改文本或视觉内容,甚至进一步提问。 这些功能现已向 Gemini 应用覆盖的所有语言的全部用户开放。 发布于:

    匹配字段正文

  2. 量子位

    扩散智能发布350亿参数扩散语言模型Clover-35B-A3B-Preview

    扩散智能发布扩散语言模型Clover-35B-A3B-Preview,采用MoE架构,总参数350亿、每token激活约30亿,支持思考模式。在网页Agent评测WindTunnel的49个任务中,其中位执行时间1.52秒,低于Jev+Mercury 2.5组合的3.21秒,成功率分别为98.6%和95.9%。代码评测上SWE-bench Verified得73.6、Terminal-Bench 2.1得51.7,团队称后续将推出多模态版本并推进端侧适配。

    谁能想到,印象中用来生成图像、生成视频的“扩散模型”,竟然也能写代码、生成网页、调用工具,当Agent了! 就在刚刚,扩散智能发布了全新的扩散语言模型—— Clover-35B-A3B-Preview。 虽然名字里多了“扩散”两个字,但实际体验下来,无论是写代码、操作网页、调用工具,还是生成HTML,用法都和我们熟悉的大语言模型差不多。 我个人用下来的第一感受就是一个字:“快”。 比如,让它生成一个太阳系模拟器,Clover就思考了约1秒,然后也就4-5秒,一个能交互的太阳系模拟器就出来了。 再比如,我给它丢了一堆简历信息,让它整理成LaTeX格式的简历代码,也就十来秒,搞定~ 有一说一,用过GPT的朋友,应该都懂盯着“正在思考”等半天是什么感觉,要不然最近也不会有主打快速决策的Jev什么事儿~ 而说到Jev,Clover这次还真和它比了一把速度。 在网页Agent评测WindTunnel的49个任务中,每个任务尝试3次,Clover的中位执行时间为1.52秒,Jev+Mercury 2.5组合为3.21秒,用时少了一半多。 尝试成功率也略高,分别为98.6%和95.9%。 对比同表中

    匹配字段正文

  3. TechCrunch AI

    Deepgram 收购 Pipecat 开发商 Daily,并推出实时上下文标准 RCS

    Deepgram 宣布收购开源语音 AI 框架 Pipecat 的开发商 Daily,交易金额未披露,双方承诺 Pipecat 将继续保持开源。Daily 此前累计融资超过 6200 万美元,Deepgram 今年早些时候以 1.3 亿美元 C 轮融资成为独角兽。Deepgram 同时发布与 Pipecat 团队共同开发的开放协议 Real-Time Context Standard(RCS),用于定义语音智能体中的音频上下文、模型指令和回复语气等元数据。

    涨,随着更多商业模式通过合作与收购涌现,头部玩家正试图巩固自身地位。Deepgram 是最新采取此类行动的公司:该公司周四表示,将收购 Daily——后者是最受欢迎的开源语音 AI 基础设施之一 Pipecat 的开发者和维护者。 两家公司未披露交易金额,但表示将继续保持 Pipecat 开源。 对于不了解的人来说,Pipecat 是一个框架,负责管理语音和视频流以及流水线中的其他环节,如语音转文本(STT)、大语言模型(LLM)和文本转语音(TTS)模型,同时降低延迟。其开发者 Daily 为各类语音和视频通话提供托管基础设施。 借助 Pipecat,Deepgram 很可能将更深入地理解实时语音和视频基础设施。 根据 PitchBook 数据,Daily 迄今已从 Tiger Global、Highfield Capital、Nat Friedman、Lachy Groom 和 Kevin Weil 等投资者处筹集了超过 6200 万美元资金。今年早些时候,Deepgram 通过 1.3 亿美元 C 轮融资跻身独角兽行列。巧合的是,两家公司都曾是 2016 年同一批 Y Combi

    匹配字段正文

  4. ElevenLabs Blog

    ElevenLabs 发布音效模型 SFX v3,已在 ElevenCreative 和 ElevenAPI 上线

    ElevenLabs 发布新一代音效模型 SFX v3,已在 ElevenCreative 和 ElevenAPI 上线。官方称其在基准测试中比 SFX v2 更能可靠处理描述多种声音的提示词,音乐与人声生成更可信,锣、铃、哨声等音效的杂音更少。用户可在 Flows、Sound Effects 标签页、Studio 和 Music Editor 中通过文本提示词生成音效,开发者可通过 ElevenAPI 接入。

    Portrait of a young woman with long dark hair wearing a light blue top.

    隆重推出 Eleven v4,这是我们迄今为止最具情感表现力的模型。探索跳至内容登录注册联系销售登录 注册 宏大的场景很少只靠一种声音。一段足球视频可能需要人群欢呼、足球落地,以及几秒后同一群人的嘘声。在此之前,仅凭一个提示词获得所有这些声音需要反复试错。 在 ElevenCreative 和 ElevenAPI 中推出 SFX v3 SFX v3 是 ElevenLabs 最新的音效模型,正是为此而打造。它能更可靠地处理描述多种声音的提示词,更逼真地生成音乐和人声,并且在基准测试中比 SFX v2 生成更干净、更自然的音频。它现已在 ElevenCreative 中提供,并可通过 ElevenAPI 使用。 在 ElevenCreative 中,你可以在 Flows、Sound Effects 标签页、Studio 和 Music Editor 中通过文本提示词创建原创音效。 更好地处理单个提示词中的多种声音 SFX v3 更擅长遵循单个提示词中的多条指令。这意味着你所描述的更多声音会出现在生成的音频中。描述构成你场景的各种声音,听听它们如何协同呈现。 对于从事视频、游戏和其他项目的

    匹配字段正文