←搜索结果

按匹配度 · 共 2896 条结果 清除搜索

星期二

  1. Browser Use

    无头浏览器被 Cloudflare 拦截怎么办:哪些方案有效(2026)

    Browser Use 发布的 Stealth Bench V2 显示,无头 Chrome 无代理仅 3% 访问通过,带美国代理的有头 Chrome 为 14%,Browser Use Cloud 达 90.5%。Cloudflare 通过 navigator.webdriver、TLS 与请求头指纹、IP 信誉、Cookie 与行为信号识别自动化,仅靠 stealth 插件无法改变 TLS 和 IP。Browser Use Cloud 定价为每浏览器小时 $0.02 加 $5/GB 代理,官方文档称不保证访问所有站点。

    teer Extra Stealth 列为已被检测。该 Puppeteer 插件的最后一个版本是 2.11.2,发布于 2023 年 3 月 1 日(npm);playwright-stealth 2.0.3 于 2026 年 4 月 4 日发布(PyPI)免费 托管式隐身浏览器(Browser Use Cloud、Browserbase Verified、其他)指纹、住宅 IP、CAPTCHA(我们的文档)付费。没有供应商保证访问;我们的文档说“无法保证访问每个站点”。你仍然会以未识别身份到达我们的方案:每浏览器小时 $0.02,另加 $5/GB 代理(定价)。Browserbase Verified 已在其 规模方案 仅住宅代理IP 信誉更改 IP,而不是更改上述 JS、Cookie 或 TLS 信号每 GB 已验证、签名的机器人(Web Bot Auth)身份:被识别,而非伪装需要 Cloudflare 的批准, robots.txt 以及合理的费率。仅在经过验证的供应商背后的站点上使用;站点仍会决定允许、质询或阻止。Browserbase 提供该功能,目前处于测试阶段,需要托管

    匹配字段正文

  2. Replit Blog

    Replit Cloud Agents 向 Pro 和 Enterprise 用户开放…

    Replit 宣布 Cloud Agents 面向所有 Pro 和 Enterprise 客户开放,非工程人员可用自然语言描述改动,由智能体定位代码、在云沙箱中运行应用验证,并向 GitHub 或 GitLab 提交带截图和视频的 PR 或 MR。团队可一次性配置共享环境,审查反馈可转化为需工程师批准的技能更新,该功能处于早期访问阶段。Slack 集成已向所有客户开放,Microsoft Teams 支持即将推出。

    Anyone can now bring their ideas into the company codebase — cover image

    而随着越来越多的人参与构建,这一瓶颈只会愈发严重。 最清楚产品该改什么的人,往往不在工程团队。一位设计师发现某处间距已经不对好几个月了。一位支持团队负责人知道哪个设置每周都让客户困惑。这些修改往往只是被写进工单,然后等待一个永远不会到来的迭代。 但当他们试着自己动手修改时,就行不通了。他们无法向工程团队证明改动确实有效。工程师根本没有时间教他们——以及公司里其他所有人——团队是如何写代码的。而让应用在正确的环境中跑起来,本身就是一个独立的项目。 今天, 你团队中的任何人都可以使用 Replit Cloud Agents,直接、安全地向你的核心代码库贡献代码. Cloud Agents 会在运行中的应用里测试每一项改动,将审查反馈一路传递下去,并在整个团队中共享同一套环境配置。工程师始终掌握控制权,而其他人的贡献门槛则被降低了。 我们将这部分称为 自动驾驶公司,现在所有 Pro 和 Enterprise 客户均可使用。 预留席位 ,在11月5日的网络研讨会上直接聆听我们产品团队的分享 借助 Cloud Agents,将想法转化为经过审查的代码变更 领域专家不再需要了解代码所在位置,也不必

    匹配字段正文

  3. a16z:News

    a16z 长文:Databricks 与智能体时代的企业形态

    a16z 合伙人 Ben Horowitz 与 Michael McGuiness 撰文,以 Databricks 从 Spark、Lakehouse、Lakebase 到智能体的四代技术演进为线索,讨论智能体如何改变企业。文章称 Databricks 已突破 70 亿美元年化收入、同比增长 80%,估值 1900 亿美元,每天有超过 1700 万个数据库由智能体启动。作者提出企业需要面向智能体的记录系统,把定义、权限和评估结果沉淀下来,并认为未来更多人的工作会转向指定任务、委派执行和检查结果。

    hers 共同创立了Databricks,将运行Spark所需的分布式基础设施——集群、扩展、安全——的复杂性抽象到一个面向企业的单一平台背后。 Spark加速了数据处理,但数据存放在哪里是另一个问题。那个时代的企业数据占据着两个彼此分离的世界。数据仓库保存着结构化、可信的记录,让分析师能够用SQL对它们提问,并支撑着每一块仪表盘和每一份季度报告。数据湖则为其他一切——文档、图像、录音和日志——提供廉价存储。数据湖很便宜,所以团队把所有东西都倒进去;但在进入的过程中没有任何东西被检查或结构化。尽管TensorFlow和PyTorch等AI开源工具围绕数据湖成长为一个庞大的生态,但要从一堆你无法信任的数据中获取价值仍然很难,这也让它们得了个“数据沼泽”的绰号。 两套系统各自解决了一个问题,但它们制造了一道鸿沟。工程师和数据科学家用Python生活在湖里,而分析师用SQL生活在仓库里。每当一方需要另一方的数据时,就得有人搭建一条管道来搬运它。这让公司留下了大量副本、管道、权限和相互冲突的定义。但在2010年代后期,Databricks、Uber和Netflix各自独立地得出了同一个解决方案

    匹配字段正文

  4. Google Developers Blog

    Google A2UI 推出可替换推理格式,Express 将延迟降低至多 3 倍

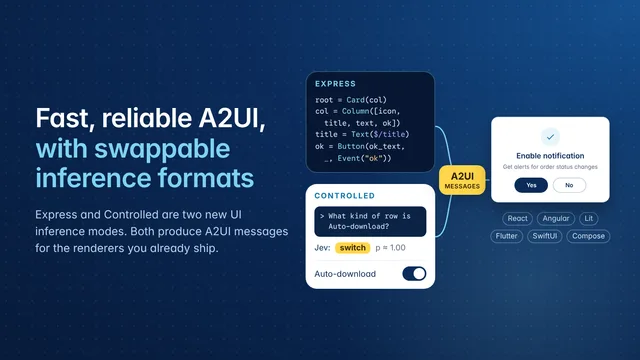
    Google A2UI 新增可替换推理格式,其中 A2UI Express 作为新默认格式可将延迟降低至多 3 倍,生成同类 UI 所需 token 减少至多 3 倍;配合 Jev 等决策模型做布局决策时延迟降幅可达 80 倍。Express 已登陆 Python agent SDK(a2ui-agent-sdk 0.9.0)、TypeScript SDK(@a2ui/agent)和 Dart SDK(a2ui_agent 0.0.1-wip004),开发者创建 generator 时用一个参数即可切换格式。

    00-header-1600x900 (1)

    ma 约束的 JSON 树既慢又容易出错。这使 A2UI 与输出文本的 LLM 绑定在一起,难以集成更快的 System One 决策模型。 现在,智能体可以生成 A2UI Express, 这是一种针对推理速度和准确性优化的中间格式,并依靠 A2UI 的 Agent SDK 中的确定性代码将其转换为基于 JSON 的传输协议。智能体构建者也可以自由替换任何其他 DSL 及其相关编译器以应对特殊用例,我们的 A2UI Agent SDK 使其与传输和渲染兼容。 模型生成的格式就是我们所说的 inference format. 你在创建生成器时用一个参数来设置它。SDK 会为该格式生成提示指令,并将模型的回复编译为标准 A2UI 消息。本文涵盖这种替换如何工作、我们为何开发 A2UI Express 作为新的默认推理格式,以及决策模型如何根据你预先定义的布局来构建屏幕。 关于 A2UI 的两件事已不再成立 可替换推理格式如何工作 一种推理格式包含两部分,SDK 会根据你目录的 JSON schema 生成这两部分。提示部分教会模型该格式的语法,编译器则将模型的回复编译为经过验证的 A2U

    匹配字段正文

  5. Claude Blog精选

    Anthropic 推出 Claude for Financial Advisors 连接器与技能套件

    Anthropic 发布 Claude for Financial Advisors,把托管机构、资产管理与财富科技平台的数据接入 Claude,并提供面向财务顾问日常工作的技能。该套件包含 Addepar、BlackRock、Charles Schwab、Envestnet、FactSet、Orion、Wealthbox 等连接器,以及会前准备、组合再平衡审查、会后纪要与跟进、合规与 AI 政策检查等技能,投资建议与客户沟通等受监管环节仍需人工审核。顾问插件即日可用,官方建议注册投资顾问使用含审计日志的 Enterprise 计划。

    Vanguard 将其模型投资组合和顾问投资解决方案的信息引入 Claude,使顾问在为客做决策时能够借助 Vanguard 值得信赖的研究、投资组合构建和资产配置专业能力。 Zocks 是面向财务顾问的 AI 会议助手,它将从每次对话中捕捉到的客户情报提供给 Claude,包括客户画像、目标、生活事件和承诺事项。 这些连接器加入了 Claude 中已有的其他连接器,包括 Microsoft 365、Salesforce、DocuSign、Box、S&P Global、Morningstar 等。 Claude for Financial Advisors 插件将顾问技能和连接器打包为一次安装,可与 BlackRock、Charles Schwab、Addepar、Envestnet、iCapital、Orion、Wealthbox、Wealth.com 和 Zocks 配合使用,顾问可在引导式设置过程中选择要连接哪些。部分合作伙伴还提供自己的插件:BlackRock 正在为 Advisor Center 推出一款插件,加入 S&P Global 和 LSEG 已有的插件行列。 围绕

    匹配字段正文

  6. Claude Blog

    如何在 Google Cloud 上管理 Claude Code 成本并证明 ROI

    Anthropic 基于与 Google Cloud 的近期网络研讨会,给出在 Google Cloud 上管理 Claude Code 成本并衡量投资回报的 control、track、prove 三杠杆框架。Claude apps gateway 支持按用户、IdP 组或组织设置日/周/月支出上限,用量达 75% 和 95% 时在 CLI 内告警,触顶后返回 429。Google Cloud 侧还提供按项目计费、预算告警、Spend caps(预览)、BigQuery 导出和配额等原生能力。

    RESOURCE ATTRIBUTES 环境变量(例如 department=engineering,cost center=eng-123)。Claude Code 会将这些标签添加到每个指标和事件中,因此你可以按这些标签进行筛选和聚合。这些指标会带着这些自定义属性进入 Google Cloud Monitoring(或 Grafana、Splunk 等其他监控解决方案)。 典型的采用情况视图会显示活跃开发者、过去 24 小时内的会话数以及消耗的总 token 数。橙色框显示的是开发者触及网关强制执行的支出上限时被阻止的请求。该指标可与现有工单系统很好地配合,形成一套允许开发者申请提高限额的工作流。 如需现成的 Cloud Monitoring 仪表板,请参阅 Claude Code 监控模板(在新标签页中打开),该模板将 Claude Code 的 OpenTelemetry 指标整合为单一视图,涵盖采用情况、编码活动和 token 用量及预估支出,让你在 Google Cloud 上推广 Claude Code 时能够按用户和模型跟踪用量与成本。你可以直接在 Cloud Mon

    匹配字段正文

  7. ElevenLabs Blog

    ElevenLabs 零售 AI 智能体实测:近半数购物者试用后选择语音交互

    ElevenLabs 对英美等多国购物者的三项研究显示,让购物者先实际使用 ElevenLabs 语音智能体再作答时,近半数选择“说并听回复”,约 30% 选择“说并看屏幕文字”,六类购物任务中语音均居首。未试用过的受访者中,打字偏好以超过 4:1 领先语音。问题越严重购物者越不愿交给智能体,错误扣款场景仅 34% 选择智能体,若智能体失败一次则有 61% 要求转人工。

    Headshot

    隆重推出 Eleven v4,这是我们迄今最具情感表现力的模型。探索跳至内容登录注册联系销售登录 注册 购物已经变成了一场对话。沃尔玛和亚马逊等领先零售商已推出 AI 智能体,用于回答问题、比较产品并帮助购物者完成结账,该品类中的其他大品牌也纷纷效仿。ElevenLabs 智能体已在全球数百个零售和电商品牌中投入使用。 对零售商而言,构建智能体的理由正变得越来越充分: 贝恩 发现,购物者对零售商自有网站智能体的信任度约为第三方智能体的三倍。 这种信任是一个机会,而非保证,而构建智能体正变得越来越容易。更难的问题存在于用户体验之中:购物者应该与智能体对话,还是在聊天窗口中打字?哪些时刻需要语音,哪些需要文字和视觉?以及在什么情况下,购物者会想要真人来服务? 我们在三项研究中与购物者一起测试了这些问题,其中两项研究让购物者在作答前有机会与 ElevenLabs 语音智能体进行交互。大多数研究只是询问人们认为自己会偏好什么。我们考察的是他们实际尝试后做出的选择,而这两个答案往往并不相同。 我们做了什么 整个夏天,我们在英国、美国、加拿大、澳大利亚、欧洲、南非和拉丁美洲研究了购物者如何看待 A

    匹配字段正文

  8. ElevenLabs Blog

    如何构建 AI 语音助手:ElevenLabs 实用指南

    ElevenLabs 发布实用指南,介绍如何把语音转文字、LLM 和文字转语音串成实时管线来构建 AI 语音助手。指南建议将往返响应控制在 500 ms 以内并配合 VAD,同时接入内部知识库与业务工具,并设置口头确认和转人工等安全措施。开发者可直接用 ElevenAPI 搭建,或用 ElevenAgents 托管平台配置并上线。

    AI voice assistant benchmarks: <500 ms response target, 92% accuracy, and 90+ languages.

    销售部门”并触发相应的操作。 创建 API 密钥,并连接语音转文字、LLM、工具和文字转语音 在你连接语音和语言模型之前。同样,在将外部服务工具集成到语音助手时,你需要 API 密钥来发起 API 请求。 要创建 ElevenLabs API 密钥, 请点击此处. 要使用 OpenAI LLM, 请在此处获取你的密钥. 如果你要连接第三方 CRM、ERP 和其他工具,请参阅官方文档以创建 API 密钥并查找受支持的 API。 获取 API 密钥后,将它们存储在开发环境中。 然后,你通过向 API 传递正确的参数来初始化并访问工具、LLM 和音频模型。 1. 首先,连接到 ElevenLabs Scribe v2 Realtime 以执行 自动语音识别. ElevenLabs Scribe v2 Realtime 可让你创建低延迟语音代理,在不到 150 毫秒内将对话转换为文本(不包括网络和应用时间)。 以下是一个 Python 代码片段,使用 ElevenLabs Scribe v2 Realtime 捕获麦克风录音。 async def run( self, audio queue:

    匹配字段正文

星期三

  1. BBC 中文精选

    Anthropic 公布上市招股文件,披露五项关键信息

    Anthropic 公布美国股市上市所需招股文件,共 335 页,市场预期其上市市值可能达到 2 万亿美元或更高。文件显示,该公司今年上半年亏损 807 亿美元,是 2025 年全年亏损的两倍,同期营收 162 亿美元;业务高度依赖少数大客户,仅五个企业客户就贡献了四分之一业务。文件同时列出先进 AI 可能带来灾难性或存在性风险,并称 AI 有望在医疗、教育、电网等领域带来益处。

    可前希望閲讀Google YouTube曲奇政策和隱私政策。希望閲讀上述内容,請點擊“接受並繼續”。告知: BBC不對外來網站内容負責 YouTube 内容可能包含廣告 以1316億美元計算,其幾乎所有現金都被定義為「營運資金」,意味著它可以用來支付日常營運。 目前,Anthropic 手上的現金比 Meta 和谷歌(Google)加起來還多。 但是,隨著與其他 AI 巨頭激烈爭奪頂尖人才和運算能力,Anthropic 的成本可能上升。光是租用數據中心,今年迄今已讓該公司花費3214億美元。 赫伯爾分析,如此龐大的成本預計還會增加。即使有這種現金量,也不足以維持其業務成長。 他說,任何投資 Anthropic 的人「將是為未來的主導地位付費,而非現在的經濟效益」。 4. Anthropic 依賴少數幾家大客戶 Anthropic 認為其技術有無數種銷售給客戶的方式。該公司目前業務的很大一部分來自僅250個主要企業客戶,這些客戶過去一年至少支付了1000萬美元。 更小的數字——僅五個企業客戶——佔了其目前業務的四分之一。 Founder ETF投資組合經理孟那翰(Michael Mona

    匹配字段正文

  2. Cognition 模型 / Devin 博客

    Cognition 发布 FrontierCode 2.0 编程基准:Opus 5.5 仅得 45%

    Cognition 推出 FrontierCode 2.0 编程基准,用于评估模型产出代码能否真正合并,最高分的 Opus 5.5 也仅得 45%,基准远未饱和。相比 1.1 版本,参考解平均多改 67% 的文件、89% 的代码行,代码库规模大 25%,任务覆盖仓库增加 55%、阻断性评分标准增加 43%。DeepSeek V4.1 Flash 从 43.9% 降至 19.3%,Kimi K3 从 44.2% 降至 17.7%,开源模型尤其是西方开源模型仍有明显提升空间。

    .2 对比。速度关卡对隐藏的固定种子随机 5-正则图对(300 个节点)计时 vf2pp is isomorphic。各用例加速比的几何平均值必须至少比 NetworkX 快 5000 倍。 该任务完整规定了智能体应采用的方法和风格,而不要求从环境中做任何推断。 虽然 Terminal-Bench 4.0 是隔离纯模型智能的优秀基准,我们也尝试捕捉模型能力的其他组成部分。随着模型变得更强,用户越来越希望它们能自主工作。理想情况下,编程智能体应能接收非正式规格说明,找到既满足该规格、又满足其隐含约束和偏好的行动方案,顾及用户的盲点,并在无需反复纠正或澄清的情况下执行。 在典型的工程场景中会出现哪些未明说的约束和偏好?常见的例子包括复用现有抽象、遵循仓库约定,以及编写能真正捕获缺陷的非平凡测试。这些对于确保代码长期可维护、用户可理解至关重要。 考虑到这些及其他因素,FrontierCode 试图衡量以下方面: 功能正确性 解读并扩展用户的初始提示词 为实现并与现有代码库顺畅集成而做出合理的设计与范围选择 我们如何构建 FrontierCode 2.0 FrontierCode 2.0 基本

    匹配字段正文

  3. Codex:GitHub Releases

    OpenAI Codex 0.165.0 发布:新增 Google Cloud Vertex AI 提供商与…

    OpenAI Codex 0.165.0 新增内置 Google Cloud Vertex AI 提供商(通过 model_provider = "gcp" 配置),并将 GPT-6.1 Terra 加入模型目录。该版本还默认启用 memory v2 并支持导入外部智能体记忆,同时默认允许在对话中调整 reasoning effort。会话选择器新增仓库过滤,agent 命令中心支持按目录分组。

    导入中支持 memory v2 @jif-oai 56439 将 ctutils 从 0.4.2 更新到 0.4.5 @felixxia-oai 56445 将模型未找到的提供商错误视为终端失败 @charliemarsh-oai 56453 使 Realtime V2 后台智能体引导测试具有确定性 @felixxia-oai 56454 使沙箱挂载清理测试能够容忍文件描述符复用 @felixxia-oai 56459 添加 Guardian V3 功能配置 @felixxia-oai 56460 添加 Guardian v3 本地看板辅助工具 @felixxia-oai 56461 为消息看板添加静默追加支持 @felixxia-oai 56462 防止记忆导入与整合发生竞争 @jif-oai 56465 添加实验性线程记忆摘要读取 @jif-oai 57337 [0.165.0-alpha.1.2] 将 GPT-6.1 Terra 回移植到模型目录 @shijie-oai 贡献者 owenlin0、keyz 以及其他 25 位贡献者 加载时出错。请重新加载此页面。 1 人做出了反应

    匹配字段正文

  4. NVIDIA Developer · Generative AI

    NVIDIA 详解如何用 Nemotron-Personas 数据集微调 Nemotron 3.5 Lightning

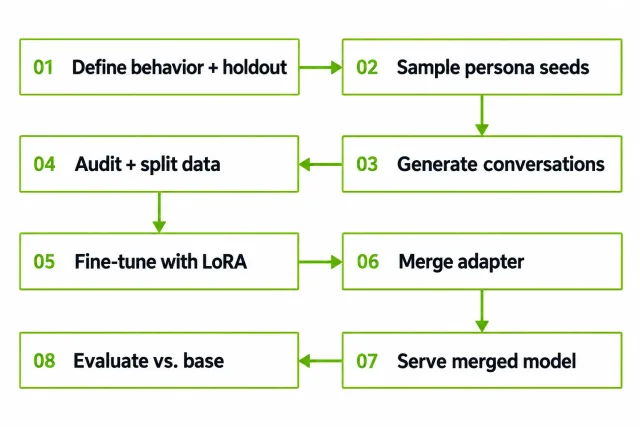
    NVIDIA 发布 Nemotron-Personas 法国和比利时数据集,并给出用其微调 Nemotron 3.5 Lightning 的完整后训练流程。流程包括定义行为契约、用 persona 生成合成对话、在 NVIDIA NeMo 上用 LoRA 微调、合并适配器,再与基座模型在冻结测试集上逐条对比评测。法国数据集与 Pleias 合作构建,比利时数据集由 Pleias 与 KU Leuven 参与,Nemotron 仓库提供数据生成、训练和评测的可复用步骤及 agent skills。

    Flowchart showing eight stages: define target behavior and a holdout set, sample personas, generate conversations, audit and split data, fine-tune with LoRA, merge the adapter, serve the adapted model, and evaluate it against the base model.

    model 进行定制),帮助编码智能体将这些步骤组装成一个工作流。 前提条件 你需要: Python 3.11 至 3.13、uv、Git、Docker、NVIDIA Container Toolkit,以及访问 Nemotron 仓库. 一台 NVIDIA DGX Station GB300 或一台 NVIDIA DGX Spark。不过,此工作流也可适配其他 NVIDIA GPU 系统。 跟着仓库操作 运行以下命令在本地安装 Nemotron 仓库:为正确遵循本教程,我们将使用位于此处的名为 的文件夹:第 1 步:定义目标行为并冻结一个留出集 在生成训练数据之前,先定义什么样的回答才算好回答。这些要求同时指导数据生成和审核。维度示例要求受众——我们在和谁对话?技术水平各异的法国成年人任务——它应该做什么?回答关于身份证明文件的问题. 运行以下命令在本地安装 Nemotron 仓库: git clone https://github.com/NVIDIA-NeMo/Nemotron.git cd Nemotron git checkout v0.2.0 uv sync --extra

    匹配字段正文

  5. Hugging Face精选

    Liquid AI 发布 LFM3 系列模型,含 1.7B 文本、视觉、音频与 Omni 版本

    Liquid AI 发布 LFM3 系列开放权重模型,全部从 LFM3-1.7B-Base 分支而来,覆盖文本、视觉、音频、Omni 以及 d1 决策模型。LFM3-1.7B-Base 采用三混合层结构,预训练 22T token,最后 3.5T token 的中训练阶段加入更多智能体轨迹与工具调用数据,上下文窗口扩展到 256K token。官方称 LFM3-1.7B 在 8K 上下文下比 LFM2-1.2B 快约 25%,WebArena-Verified 得分 38.42 对 3.02;LFM3-VL-2B 在 62 项视觉基准上平均分从 57.6 升至 71.4。所有模型已在 Hugging Face 开放下载,并提供单卡微调 notebook。

    以在你说话时进行预填充,首 token 时间低至 50 ms。LiquidCodec 是我们新的音频分词器,在 Apple M4 Max 的单 CPU 线程上以约 87 倍实时速度将生成的 token 转换为语音,并支持流式解码。 如何使用 LFM3 模型 每个模型都在 transformers 中运行。下面的代码片段来自模型卡,模型卡还列出了每个模型支持的其他推理引擎。 LFM3-1.7B 当你需要本地智能体、工具调用、结构化输出,或用于领域特定微调的基础模型时,请选用 LFM3-1.7B。它经过后训练,可在 Hermes Agent、Pi 和 OpenClaw 等智能体框架中运行。它以少 35% 的参数超越了前代 LFM2.5-2.6B,最大的提升出现在智能体任务上:在 WebArena-Verified 上,它得分 38.42,而前代为 3.02,甚至在浏览器和商业应用中的长任务上超过了 Qwen3.5-9B。你可以在 LFM3-1.7B 模型卡中找到更多细节。 要运行 LFM3-1.7B,请安装最新版本的 transformers: 然后加载并运行模型: 有关本地智能体设置,请

    匹配字段正文

  6. Latent Space精选

    Anthropic 工程与产品负责人谈 Opus 5.5 发布与 Claude 智能体架构

    Latent Space 播客访谈 Anthropic 工程负责人 Katelyn Lesse 与产品负责人 Angela Jiang,围绕 Opus 5.5 的发布展开,讨论模型写作风格调整、按每美元智能定价以及为防蒸馏而要求跨轮保留 thinking blocks 等 API 变化。访谈还介绍了 Claude Managed Agents 把会话与 harness 同执行代码的沙箱分离的思路,凭据通过代理单独挂载,沙箱故障不会带走整个会话;Dreaming 则被实现为一个托管智能体检查另一个智能体的历史并写回记忆。团队表示随着模型发布的安全工作变重,近期精力更多转向安全,技能、记忆等功能的推进相对放缓。

    g 的实现很简单,就是一个智能体检查另一个智能体的先前工作并写回记忆。这使得该功能成为用同一套底层托管智能体原语构建更高层行为的例子。 他们对路线图的描述比一份功能清单更为细致。记忆和学习仍然重要,但团队表示,随着模型发布变得越来越困难,他们更多的近期注意力已转向安全。他们还讨论了保持基础 harness 相对简单,同时让开发者在其上试验验证器、并行智能体和其他策略。提到的未来平台能力构想应被视为计划,而非已交付的承诺。 关于评估的对话自然随之展开。harness 是一个应用,但改进它开始变得像研究:选定目标、测量行为、检查失败,然后迭代。嘉宾和主持人讨论了如何用模型来帮助构建和分析评估,同时保留足够的判断力,以决定该评估是否反映了真实用户的工作。 节目笔记 Claude Opus 5.5 发布公告——Anthropic 关于模型行为、评估和定价的发布说明。 Katelyn Lesse 和 Angela Jiang 在 Anthropic 合作伙伴峰会上——Anthropic 标明了她们的平台工程和产品职位。 扩展托管智能体:将大脑与双手解耦——本期节目讨论的会话、harness 和沙

    匹配字段正文

  7. Google DeepMind精选

    Google DeepMind 发布世界模型 Genie 4,支持原生音频与实时交互

    Google DeepMind 发布世界模型 Genie 4,可实时生成可交互世界,并首次原生生成环境音与角色对话。模型基于 Gemini 系列能力,由 Gemini 3.8 Flash 在循环中拆解目标、检查画面以维持多步事件的因果连贯,Gemini 4 Argon 也已用于与 Gemini Robotics 联合模拟任务。官方称其仍属早期实验模型,长时运行下物体恒常性与复杂物理交互仍会漂移,生成内容均带 SynthID 水印,目前先向可信测试者开放预览。

    加入 Genie 4 等候名单 分享 今天,我们发布 Genie 4,这是我们全新的世界模型,它带来了前所未有的真实感,并改进了实时交互式模拟。Genie 4 原生支持多模态,能够与世界同步生成类音乐的音频、环境噪声和交互式对话。 Genie 4 模型融合并拓展了 Gemini 系列的能力:Gemini Omni 让模拟在真实世界的外观与行为上有据可依,而其他 Gemini 模型则提供维持模拟连贯性与连续性所需的复杂推理能力。 有了这一基础,你可以启动一个事件,Genie 4 会模拟接下来发生的一切:世界如何响应、听起来如何,以及其中的人如何移动、反应和说话。 理解和模拟世界是构建 AGI 的关键一环。Genie 4 提升了我们创建安全、可无限变化的模拟的能力,这些模拟可助力从为机器人和智能体开发训练环境,到开启全新交互体验创作的一切工作。 我们已开始将 Genie 4 作为研究预览版向可信测试者逐步开放——在向消费者和开发者发布之前收集反馈,首批对象包括 Project Genie 中的 Google AI Ultra 订阅用户,以及 Gemini API 和 Google AI

    匹配字段正文

  8. AWS Machine Learning

    修复评估偏差,在 Amazon Bedrock 上选出更好的模型

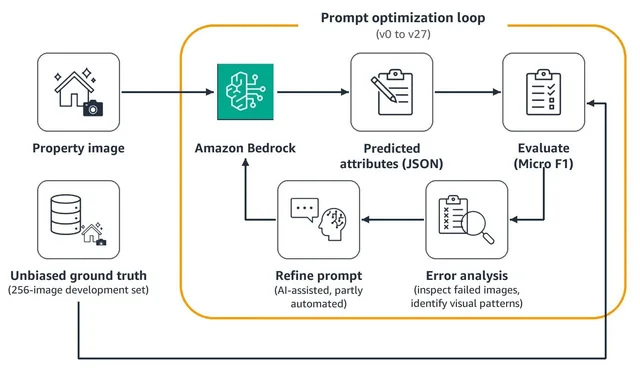
    Property Finder 发现其评估标签中 96.8% 直接来自现有视觉语言模型的预测而非人工核验,导致任何替代模型在对比中结构性吃亏。团队重新人工标注 356 张 UAE 图片并改用多标签分类,再通过 v0 到 v27 的提示词迭代优化在 Amazon Bedrock 上选型,最终实现准确率提升且成本降低 86%。

    Diagram of the prompt optimization loop: a property image goes to Amazon Bedrock, the predicted attributes are scored with Micro F1 against the expert-annotated development set, error analysis informs the next prompt version, and the loop repeats from v0 to v27.

    nstruct(各自使用其调优后的提示词),使开发集上的 Micro F1 从 0.55 提升到 0.81。这是 47% 的相对提升。仅对 Llama 4 Maverick 17B Instruct 进行提示词调优,就使其从共享 v21 提示词的 0.75 提升到 v27 的 0.81。 失败方法的教训 并非一切都成功了。 2-bucket 方法将水印属性和其他属性放在两个单独的 API 调用中。它没有带来有意义的准确率提升。带框图片检测也大幅下降。由于同一提示词中没有水印属性,模型将水印叠加层误认为图片边框。 通用提示词无论运行在哪个模型上也都失败了。房地产图像具有太多领域特异性,不适合一刀切的指令。 结果:成本、准确率和速度 AWS 生成式 AI 创新中心团队使用无偏评估框架在 Amazon Bedrock 上评估了多个模型。所有模型都从共享的 v21 提示词开始,然后在开发集上针对其模型系列进行调优。专有模型 A 进行了一轮调优,即 v22。Llama 4 Maverick 17B Instruct 进行了多轮调优,即 v24 到 v27,再加上 Property Finder

    匹配字段正文

  9. AWS Machine Learning

    AWS 为 SageMaker AI 训练与处理作业推出 SOCI 索引镜像

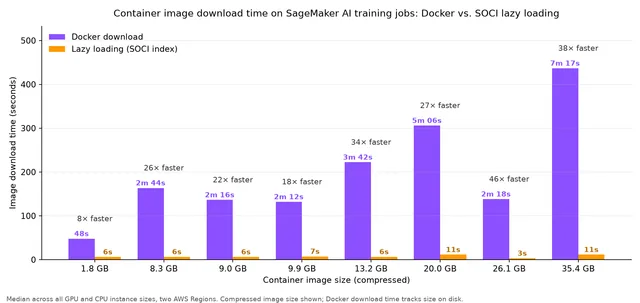
    AWS 为 Amazon SageMaker AI 训练和处理作业推出 SOCI 索引镜像,通过懒加载让容器在数秒内启动,无需改动作业定义。官方基准显示,1.8–35.4 GB 的镜像下载时间从 48 秒至 7 分 17 秒降至 3–11 秒,提速 8x–46x,GPU 空闲时间最多减少 90%。若索引不可读或懒加载失败,作业会自动回退到标准下载。

    Bar chart comparing Docker pull and SOCI lazy-loading download times across eight image sizes, with speedups from about 10x to over 35x

    你的原始镜像及其摘要保持不变。 在 CI/CD 中自动创建索引 要在每次推送时自动生成索引,请部署 CFN ECR SOCI Index Builder。它使用一个 Amazon EventBridge 规则来检测 Amazon ECR 镜像推送事件并构建索引。无需更改你的构建流水线。 在 SageMaker AI 作业中使用已建立索引的镜像 完全像引用任何其他镜像一样引用你的 SOCI 索引镜像。无需更改 API。只有标签不同。 训练示例(SageMaker Python SDK) from sagemaker.train import ModelTrainer from sagemaker.train.configs import Compute trainer = ModelTrainer( training image="111122223333.dkr.ecr.us-east-1.amazonaws.com/my-training-image:v1.0-soci", role="arn:aws:iam::111122223333:role/SageMakerExecution

    匹配字段正文

  10. AWS Machine Learning

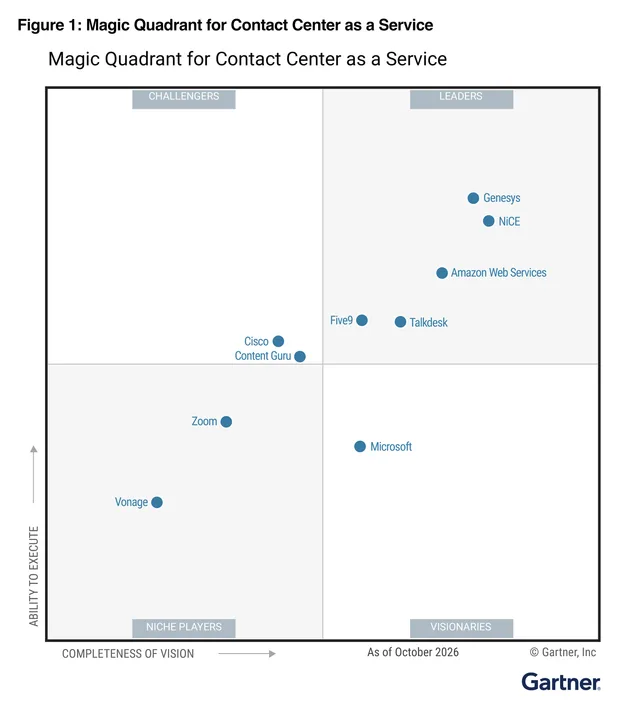
    AWS 连续第四年获评 2026 Gartner CCaaS 魔力象限领导者

    AWS 的 Amazon Connect 连续第四年被 2026 Gartner 联络中心即服务(CCaaS)魔力象限评为领导者。Connect Customer 以客户上下文结合生成式与智能体 AI,强调把复杂问题一路推进到解决而非只做转接,且每一步操作可审计、必要时由人工介入。

    模的企业都能实现这一点。 我为 Connect Customer 团队连续第四年获得这一认可感到自豪。我们的工程师、产品团队、合作伙伴和客户共同塑造了我们所构建的一切。这是一个庆祝我们走过历程的时刻,也是未来方向的信号。 每位客户都是独一无二的。每一次互动都应体现这一点。 阅读 2026 Gartner 联络中心即服务魔力象限: Gartner,《联络中心即服务魔力象限》,2026 年 10 月 19 日,Drew Kraus 等. Gartner 不为其出版物中描述的任何公司、供应商、产品或服务背书,也不建议技术用户只选择评级最高或其他称号的供应商。Gartner 出版物由 Gartner 商业与技术洞察机构的观点构成,不应被解读为事实陈述。Gartner 对本出版物不作任何明示或暗示的担保,包括任何适销性或特定用途适用性的担保。 Gartner 和 Magic Quadrant 是 Gartner, Inc. 和/或其关联公司的商标。 本图表由 Gartner, Inc. 作为更大研究文档的一部分发布,应在整份文档的背景下加以评估。Gartner 文档可向 AWS 索取。 关于作者

    匹配字段正文

  11. Meta Engineering Blog

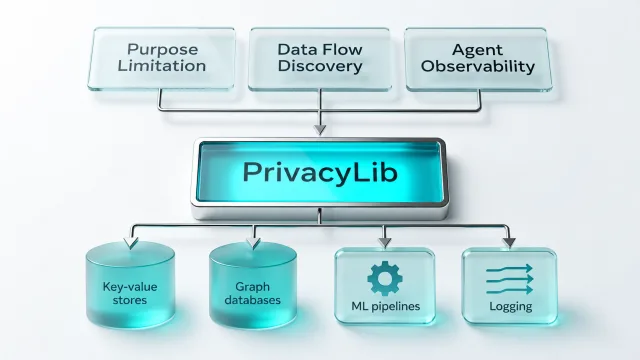
    PrivacyLib:Meta 在数据访问边界实现隐私控制

    Meta 工程团队推出 PrivacyLib,一个运行在数百个数据与处理系统客户端内的通用隐私库,每秒执行数十亿次检查。系统只需集成一次,新隐私需求即可作为模块复用该集成,无需在各系统重复实现。新增的 Agent Observability 模块可观测内部 AI 智能体的数据访问事件,已集成的系统无需额外改造即可启用。

    方式,隐私要求也不断扩展。每一次变更都带来了更多的集成工作,而新的访问路径有时出现得比我们能够覆盖的速度更快。我们得到的教训是:在稳定的数据访问边界进行集成,定义系统共享的一小组操作,并将注解与数据保持在一起。各模块可以复用相同的集成,从而随着时间推移减少工程投入。 可靠性赢得采用: 早期,一个无效配置导致整个集群中的进程崩溃,违背了我们自己的安全发布原则。其他事故则源于注解变更:这些变更虽然编译成功,却改变了访问决策并导致产品故障。这些事故表明,只有当服务所有者能够在发布前看到变更如何影响其流量,并且能够从有问题的变更中恢复而无需进行全集群回滚时,他们才会在关键数据访问路径中信任 PrivacyLib。 覆盖范围包括部署: 当新需求需要对模块或受支持的策略和注解进行更改时,较旧的服务需要部署具备更新后 PrivacyLib 能力的版本。我们已确保明确的清单、跟踪和发布机制到位,以协调这些部署,从而使需求负责人能够仅更新范围内的服务,安全地按时完成任务。 展望未来 这些经验教训塑造了 PrivacyLib 接下来的发展方向,因为 AI 正将数据访问推向越来越新颖的环境和调用路径。我们继

    匹配字段正文

  12. Databricks Blog

    从局部修补到可量化提升:用 ai_extract 与 MLflow Prompt Registry 提高文档抽取准确率

    Databricks 分享了用 ai_extract 和 MLflow Prompt Registry 提升文档抽取准确率的做法:在一个从数十种 PDF 版式中抽取约 40 个结构化字段的项目里,仅修改 schema 让 revision 字段错误减半,但全部字段的总抽取错误反而增加 9%。文章建议按字段规则用 schema 描述、文档级逻辑用全局指令、结构复杂时用 precision mode,并把提示词与 schema 存入 MLflow Prompt Registry 做版本管理和别名回滚,再基于人工审核的 ground truth 评估准确率、覆盖率和多次运行波动。Genie Code 可自动完成逐字段打分、提出可审阅的 diff 并重跑评估。

    Document Extraction Pipeline

    并通过别名部署或回滚变更,而不是直接编辑流水线代码。 在推广前评估变更: 将候选方案与固定、经人工审核的基准真值进行对比,同时跟踪准确率、覆盖率和多次运行间的波动。 文档抽取通常始于一个简单的循环:发现某个字段不正确,调整提示词或 schema,重新运行该文档,然后检查结果。 随着字段和文档格式成倍增加,这种做法会变得不可靠。一项变更可能修复了某个字段,却在其他地方引入回归;可能对一种版式有效,却在另一种版式上失败;也可能仅仅因为 LLM 多次运行间的正常波动而显得更好。 我们在最近的一个项目中看到了这一点:该项目从合作伙伴提交的订单文档中抽取约 40 个结构化字段,涉及数十种 PDF 版式。审核人员在抽取值进入下游之前对其进行了纠正和批准,从而为我们提供了经人工审核的评估基准真值。 挑战不在于让 ai extract 返回这些字段。而在于在不使系统整体退化的情况下改进抽取效果。 例如, revision 字段有时会返回状态词,例如 ORIGINAL 而不是一个 revision 数字或空白。一个小的 schema 变更将该字段的错误减少了大约一半。但在所有字段上,总抽取错误增加了 9

    匹配字段正文