←搜索结果

按匹配度 · 共 1542 条结果 清除搜索

星期四

  1. heise online

    Apple 研究团队提出用闲置 Apple Silicon Mac 充当虚拟 GPU 的 Minions 系统

    Apple 人工智能研究团队在 arXiv 发表论文,提出原型软件 Minions,把利用率不高的 Mac 等 Apple Silicon 设备当作云端虚拟 GPU,用于执行大规模机器学习推理负载。系统由中心协调服务器、各机器上的 Minion Executor 组成,后者运行 Ollama 推理实例,输入、模型和结果通过 AWS-S3 存取,任务经 PostgreSQL 数据库分发,Minion Executor 通过 REST-API 领取任务和心跳,另有 Minion Watchdog 监控故障。论文称实测中原本在 Apple Research 团队常超过十小时的 GPU 推理排队时间缩短到几分钟,目前仅面向相互信任的组织内部负载,尚未实现类似 PCC 的进程隔离,未来还计划支持 AI 训练。

    匹配字段摘要、正文

  2. AWS Machine Learning

    用 Amazon Bedrock AgentCore 构建可自我改进的文档处理系统

    AWS 介绍如何用 Amazon Bedrock AgentCore 构建智能体式 IDP 系统,由 8 个专用智能体在两条图工作流中完成文档分类、提取、校验与学习,通常可在 20 分钟内完成部署。新文档类型无需手工配置模板,智能体会自动生成提取提示词并保存复用,后续同类文档直接进入提取流程;系统结合 Amazon Textract、S3 Vectors、Aurora DSQL 与 AgentCore Runtime、Gateway、Identity、Observability 等能力。

    匹配字段摘要、正文

星期三

  1. SiliconANGLE

    Groundcover 推出 agent-to-agent 可观测性,让 Claude 和 Codex 移交生产调查

    Groundcover 推出 agent-to-agent 可观测性,允许 Claude、Codex、Cursor 和 AWS Kiro 通过 MCP 工具或异步 Agent Tasks 将生产环境调查交给其自有可观测性 Agent,后者返回根因分析或仪表盘草稿。该功能基于 bring-your-own-cloud 架构,遥测数据保留在客户云账户内,按节点计费,现已可用。

    匹配字段摘要、正文

  2. 36氪 · AI

    Anthropic尽调后放弃,亚马逊为何仍洽谈收购Decart

    据报道,亚马逊正洽谈收购以色列AI初创公司Decart,潜在交易金额约70亿美元;此前Anthropic曾以约60亿美元估值接触Decart,尽调后放弃。Decart成立于2023年,2026年5月完成3亿美元融资、估值接近40亿美元,其Decart Optimization Stack(DOS)目标是让AI工作负载运行在英伟达GPU、亚马逊Trainium和谷歌TPU等不同加速器上。文章认为,若交易成形,Decart可帮助AWS降低客户迁移到Trainium的技术门槛,补上跨硬件部署与算力效率这一环。

    匹配字段摘要、正文

  3. AWS Machine Learning

    用 Amazon Bedrock AgentCore 自动生成演示文稿

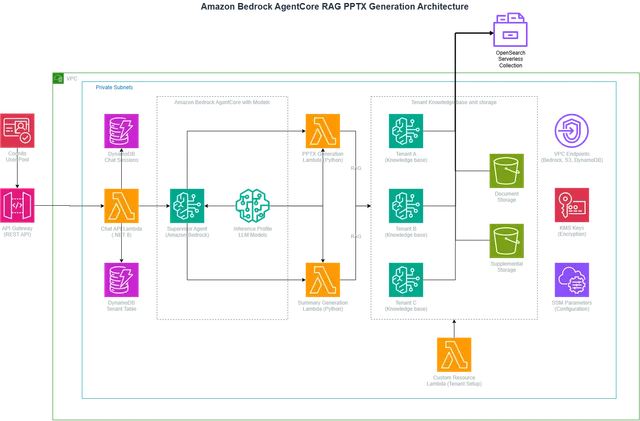
    AWS 介绍如何用 Amazon Bedrock AgentCore 构建 AI 智能体系统,自动把季度报告、合规文档和市场分析生成 PowerPoint 演示文稿,内部测试中可在 90 秒内完成。方案在 AgentCore runtime 上部署基于 Strands Agents 框架的 supervisor agent,由 Anthropic Claude Sonnet 4.6 生成内容、Amazon Titan Text Embeddings v2 做向量检索、Stability AI Stable Image Inpaint 生成幻灯片配图,并通过 Amazon Bedrock Guardrails 做内容安全过滤。

    Architecture diagram of the Amazon Bedrock AgentCore presentation generation system, showing request flow through Amazon API Gateway and AWS Lambda to the supervisor agent, knowledge bases, and storage within a VPC

    匹配字段摘要、正文

  4. Databricks Blog

    Databricks 推出 Private Network Gateway:为 Serverless 打通私有网络

    Databricks 宣布 Private Network Gateway(PNG)在 Azure 进入公开预览、在 AWS 进入私有预览,让 serverless 工作负载通过一条连接接入企业自有网络。用户只需在虚拟网络中委派一个子网,即可让 serverless 访问私有数据库、私有 MCP server、私有 PyPI/Artifactory/Nexus 仓库,并支持 specific_destinations 与 all_traffic 两种流量模式。Databricks 称此前超过 75% 的受访客户因网络配置复杂而将特定工作负载留在 classic compute 上。

    Private Network Gateway (PNG)

    Databricks 宣布 Private Network Gateway(PNG)在 Azure 进入公开预览、在 AWS 进入私有预览,让 serverless 工作负载通过一条连接接入企业自有网络。用户只需在虚拟网络中委派一个子网,即可让 serverless 访问私有数据库、私有 MCP server、私有 PyPI/Artifactory/Nexus 仓库,并支持 specific destinations 与 all traffic 两种流量模式。Databricks 称此前超过 75% 的受访客户因网络配置复杂而将特定工作负载留在 classic compute 上。

    匹配字段摘要、正文

  5. 邵猛

    斯坦福开设 CS 312「Deep Learning Alchemy」秋季新课

    斯坦福大学秋季开设 CS 312「Deep Learning Alchemy」,由 Tatsunori Hashimoto 和 Suhas Kotha 主讲,面向深度学习核心知识多为经验性、理论难以解释的问题。课程分七个单元,从超参调优与 scaling laws 讲到优化器与超参不变量(NQM、μP、Muon、权重衰减)、损失景观、训练稳定性、架构容量和数据高效泛化,最后一个单元未公开。作业代码、测验和讲义全部公开,课程录像由 StanfordOnline 发布,自学者可用 Modal 租卡复现;课程采用 7 次考试占 85% 成绩的考核方式,可视为 CS 336 的续作。

    匹配字段摘要、正文

  6. AWS Machine Learning

    Orca Security 用 Amazon Bedrock 构建自然语言安全查询

    Orca Security 与 AWS 合作,基于 Amazon Bedrock 构建了自然语言查询智能体 Discovery AI,可将自然语言问题转换为 Sonar 查询。相比初始基线,查询成本降低 90%、输入 token 减少 93%、延迟降低 75%,目前每天处理数千次查询,响应时间 15 秒。该方案采用 RAG 与 schema 感知查询构建的九阶段流水线,并组合使用 Amazon Titan Text Embeddings 与 Cohere Rerank 3.5。

    匹配字段摘要、正文

  7. AWS Machine Learning

    用托管权益管理 Amazon Bedrock 的私有定价优惠

    AWS 发布两种在 AWS License Manager 中激活 AWS Marketplace Private Pricing Offer(MPPO)权益的方式:轻量脚本用于一次性激活,CDK 自动化用于持续的事件驱动处理。CDK 方案通过 EventBridge 监听 aws.agreement-marketplace 事件,由 Lambda 校验卖家白名单并创建分布式授权,调用 CreateGrantVersion(Status=ACTIVE) 激活,协商价格在授权达到 ACTIVE 或 WORKFLOW_COMPLETED 后生效。

    AWS 发布两种在 AWS License Manager 中激活 AWS Marketplace Private Pricing Offer(MPPO)权益的方式:轻量脚本用于一次性激活,CDK 自动化用于持续的事件驱动处理。CDK 方案通过 EventBridge 监听 aws.agreement-marketplace 事件,由 Lambda 校验卖家白名单并创建分布式授权,调用 CreateGrantVersion(Status=ACTIVE) 激活,协商价格在授权达到 ACTIVE 或 WORKFLOW COMPLETED 后生效。

    匹配字段摘要、正文

  8. AWS Machine Learning

    Anchor Browser 与 Amazon Bedrock AgentCore payments 集成,让 AI 智能体自主完成 x402 支付

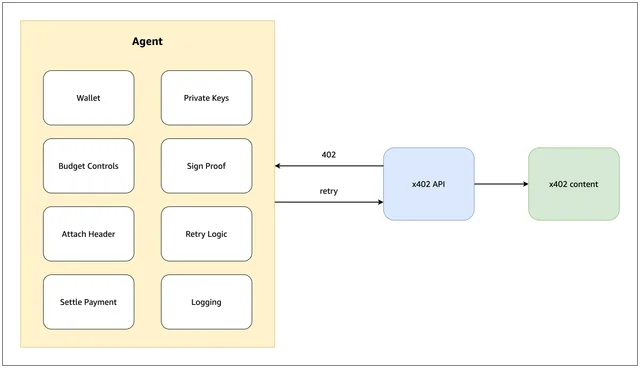
    Anchor Browser 与 Amazon Bedrock AgentCore payments 集成,让 AI 智能体在遇到 HTTP 402 Payment Required 时自主完成 x402 协议支付,无需人工介入。AgentCore payments 在基础设施层管理钱包连接、执行可配置支出限额,并通过 Amazon CloudWatch 提供支付尝试、批准、拒绝与结算的可观测性。该方案由 AWS Generative AI Innovation Center Partner Agent Factory 协作开发,现已在 AWS Marketplace 上线。

    Agent payment stack with eight embedded components connecting to an x402 API, showing a 402 challenge returning and a retry sent forward

    匹配字段摘要、正文

星期二

  1. AWS Machine Learning

    Amazon SageMaker AI 上的 Mixture-of-Experts 内核工程优化

    AWS 分享了在 Amazon SageMaker AI 上针对 fused MoE 模型的内核优化:通过 Swap-AB 让专家维度 N=8192 进入 WGMMA 首个操作数位置,在 H200 上带来 2–4% 端到端输出吞吐提升,该优化已合入 vLLM 0.24.0 或更高版本。此外,在 Hopper 上对 FP8 张量量化模型,Triton 后端在低并发 MoE 负载下持续优于默认的 FLASHINFER_CUTLASS 路径。

    Swap-AB transposition promoting the large expert dimension into the WGMMA operand-A slot for full Tensor Core utilization

    AWS 分享了在 Amazon SageMaker AI 上针对 fused MoE 模型的内核优化:通过 Swap-AB 让专家维度 N=8192 进入 WGMMA 首个操作数位置,在 H200 上带来 2–4% 端到端输出吞吐提升,该优化已合入 vLLM 0.24.0 或更高版本。此外,在 Hopper 上对 FP8 张量量化模型,Triton 后端在低并发 MoE 负载下持续优于默认的 FLASHINFER CUTLASS 路径。

    匹配字段摘要、正文

  2. AWS Machine Learning

    在 Amazon Bedrock 上用 Grok 4.7 构建长时程智能体

    SpaceXAI 的 Grok 4.7 已在 Amazon Bedrock 上线,支持可配置 reasoning effort、工具调用和结构化输出,并提供 500K token 上下文窗口。AWS 用三个需搜索推理的任务做了 72 次智能体运行,正确 67 次;xhigh 档 18 次全对,low 档 18 次对 15 次且输出 token 约为八分之一。

    匹配字段摘要、正文

  3. AWS Machine Learning

    在 Amazon Bedrock 上通过全球跨区域推理访问 OpenAI GPT-6 模型(泰国、马来西亚、新加坡、印度尼西亚和台湾)

    Amazon Bedrock 面向泰国、马来西亚、新加坡、印度尼西亚和台湾五个 AWS Region 提供 OpenAI GPT-6 Sol、GPT-6 Luna 和 GPT-6 Astra 的全球跨区域推理,其中 GPT-6 Astra 从亚太(新加坡)提供。用户通过传入 global.openai.gpt-6-sol、global.openai.gpt-6-luna 等推理配置文件 ID 调用,支持 Converse API、OpenAI 兼容 API 以及 ChatGPT 桌面应用和 Codex CLI,计费、配额、CloudTrail 和 CloudWatch 均保留在源 Region。Codex 报告这些配置文件支持 272,000 token 上下文窗口。

    匹配字段摘要、正文

  4. The New Stack

    Kubernetes 上的 GPU 为何要自带全套可观测与计费能力

    The New Stack 分析指出,GPU 工作负载在 Kubernetes 上缺少 CPU 和内存那样现成的可见性,指标、配额、归属和计费规则都要自己搭建。DCGM 默认按物理设备上报,多 Pod 共享 GPU 时每个 Pod 都显示占用整卡,加总会出现 300% 的失真数据;计算份额在并行共享场景下无法准确归属,文章建议按显存计费、把计算利用率当作信号。文中还提到 AWS 上最便宜的 MIG 兼容 A100 实例约 22 美元/小时,spot 约 14 美元/小时,而同规格纯 CPU 实例约 5 美元/小时。

    匹配字段摘要、正文

星期一

  1. Analytics India Magazine

    亚马逊洽谈以约 70 亿美元收购 AI 芯片兼容初创公司 Decart

    据《华尔街日报》报道,亚马逊正洽谈收购 AI 初创公司 Decart,交易估值可能约为 70 亿美元。Decart 开发让开发者可在不同 AI 芯片之间切换的软件,并正在研发可生成和模拟 3D 真实环境的 world models Lucy 和 Oasis。该公司 2023 年由 Dean Leitersdorf、Orian Leitersdorf 和 Moshe Shalev 创立,已从 Sequoia Capital、Benchmark 和 Radical Ventures 等投资方融资超过 4 亿美元,2026 年 5 月估值接近 40 亿美元。亚马逊 AWS 曾在 2025 年让 Decart 提前使用其 Trainium3 AI 芯片。目前收购谈判仍在进行,尚未宣布最终协议。

    匹配字段摘要

  2. AWS Machine Learning

    使用 Ray LLM Deep Learning Containers 在 Amazon EKS 上运行多节点推理工作负载

    AWS 发布面向多节点部署的 Ray LLM Deep Learning Container,可在 Amazon EKS 上把单个大语言模型跨两个 GPU 节点部署,并将 prefill 与 decode 阶段分离在各自节点上,统一暴露一个 OpenAI 兼容端点。该容器内置 vLLM、Ray Serve LLM、NIXL 与 EFA 通信栈,通过 build_pd_openai_app 用一段 YAML 完成服务配置,无需编写应用代码。

    Architecture diagram: a user request reaches the Ray head on a CPU system node, and two GPU worker nodes run the prefill and decode phases on Amazon EKS

    AWS 发布面向多节点部署的 Ray LLM Deep Learning Container,可在 Amazon EKS 上把单个大语言模型跨两个 GPU 节点部署,并将 prefill 与 decode 阶段分离在各自节点上,统一暴露一个 OpenAI 兼容端点。该容器内置 vLLM、Ray Serve LLM、NIXL 与 EFA 通信栈,通过 build pd openai app 用一段 YAML 完成服务配置,无需编写应用代码。

    匹配字段摘要、正文

  3. AWS Machine Learning

    在 Amazon SageMaker AI 上用 llama.cpp 部署决策模型

    AWS 发布面向 llama.cpp 的深度学习容器(DLC),可在 Amazon SageMaker AI 上以 CPU 或 GPU 托管量化模型,并通过 InvokeEndpoint 提供 OpenAI 兼容的 chat completions。同一运行时还可扩展为 SemIf(原 OpenJev)子镜像,直接返回声明选项的概率而非生成答案 token。在 231 个公开 JevBench 任务上,GPU 端点相比 CPU 配置 p50 快 4.9 倍、p95 快 32.2 倍;示例默认保留 4B Q4_K_M 模型,2B 与 0.8B 候选准确率分别为 66.7% 和 58.4%。

    AWS 发布面向 llama.cpp 的深度学习容器(DLC),可在 Amazon SageMaker AI 上以 CPU 或 GPU 托管量化模型,并通过 InvokeEndpoint 提供 OpenAI 兼容的 chat completions。同一运行时还可扩展为 SemIf(原 OpenJev)子镜像,直接返回声明选项的概率而非生成答案 token。在 231 个公开 JevBench 任务上,GPU 端点相比 CPU 配置 p50 快 4.9 倍、p95 快 32.2 倍;示例默认保留 4B Q4 K M 模型,2B 与 0.8B 候选准确率分别为 66.7% 和 58.4%。

    匹配字段摘要、正文

星期五

  1. LlamaIndex 产品、工程与评测

    MyMagic AI 批量推理集成 LlamaIndex:使用指南

    MyMagic AI 的批量推理 API 已集成进 LlamaIndex,支持 Llama 70B、Mistral 7B、Mixtral 8x7B、CodeLlama70b 及 Embedding 模型,可处理数据提取、摘要、分类、情感分析、训练数据生成和嵌入等任务。用户将文件放入 AWS S3 或 GCS 的 session 文件夹后,通过 LlamaIndex 封装发起请求,可动态指定 prompt、模型和 max_tokens;官方建议尽量使用异步 acomplete 接口,目前不支持 chat/achat 方法。其训练数据生成速度相比 GPT-3.5 可提升 5-10 倍。

    MyMagic AI 的批量推理 API 已集成进 LlamaIndex,支持 Llama 70B、Mistral 7B、Mixtral 8x7B、CodeLlama70b 及 Embedding 模型,可处理数据提取、摘要、分类、情感分析、训练数据生成和嵌入等任务。用户将文件放入 AWS S3 或 GCS 的 session 文件夹后,通过 LlamaIndex 封装发起请求,可动态指定 prompt、模型和 max tokens;官方建议尽量使用异步 acomplete 接口,目前不支持 chat/achat 方法。其训练数据生成速度相比 GPT-3.5 可提升 5-10 倍。

    匹配字段摘要、正文

  2. Muse

    Muse 回应钓鱼邮件反制:小心自食其果

    用户 TLM13 称收到钓鱼邮件后,让 @Muse 读取邮件头、追踪伪造域名并起草 AWS 下架报告,十分钟内完成反制。Muse 转发并评论:“careful what you phish for”(钓鱼前先想清楚后果)。

    匹配字段摘要

  3. AWS Machine Learning

    如何用 Amazon SageMaker HyperPod 实现多团队共享 GPU 集群的隔离与公平

    Amazon SageMaker HyperPod 推出基于 EKS 的多租户参考架构,让多个团队共享同一 GPU 集群。该架构用 AWS IAM Identity Center 做集中认证、按团队划分 SageMaker AI 域和 Kubernetes 命名空间实现隔离,并通过 HyperPod Task Governance 公平分配资源、按命名空间分摊成本。

    Layered multi-tenant HyperPod EKS architecture from user identity through authorization to isolated team namespaces

    匹配字段摘要、正文